Advanced RAG 適用指針書 ― FMEA 作成支援ケーススタディ

FMEA 作成支援 RAG を題材に、分冊マニュアル・神エクセル・特許の図と符号・スキャン PDF などのデータ特性ごとに、どの Advanced RAG の打ち手がどれだけ効くかを WSL2 上の OpenSearch で実測した資料です。データは実在企業の公開文書の構造だけを再現した架空の合成コーパスです(全 76 枚)。GitHub リポジトリ/PDF/PPTX/前提編:Advanced RAG 実践ガイド

目次
  1. 1. ADVANCED RAG CASE STUDY
  2. 2. この資料の目的:「表面の理解」から「期待値・仮説・指示」へ
  3. 3. 結論を先に:何が効き、何が効かなかったか
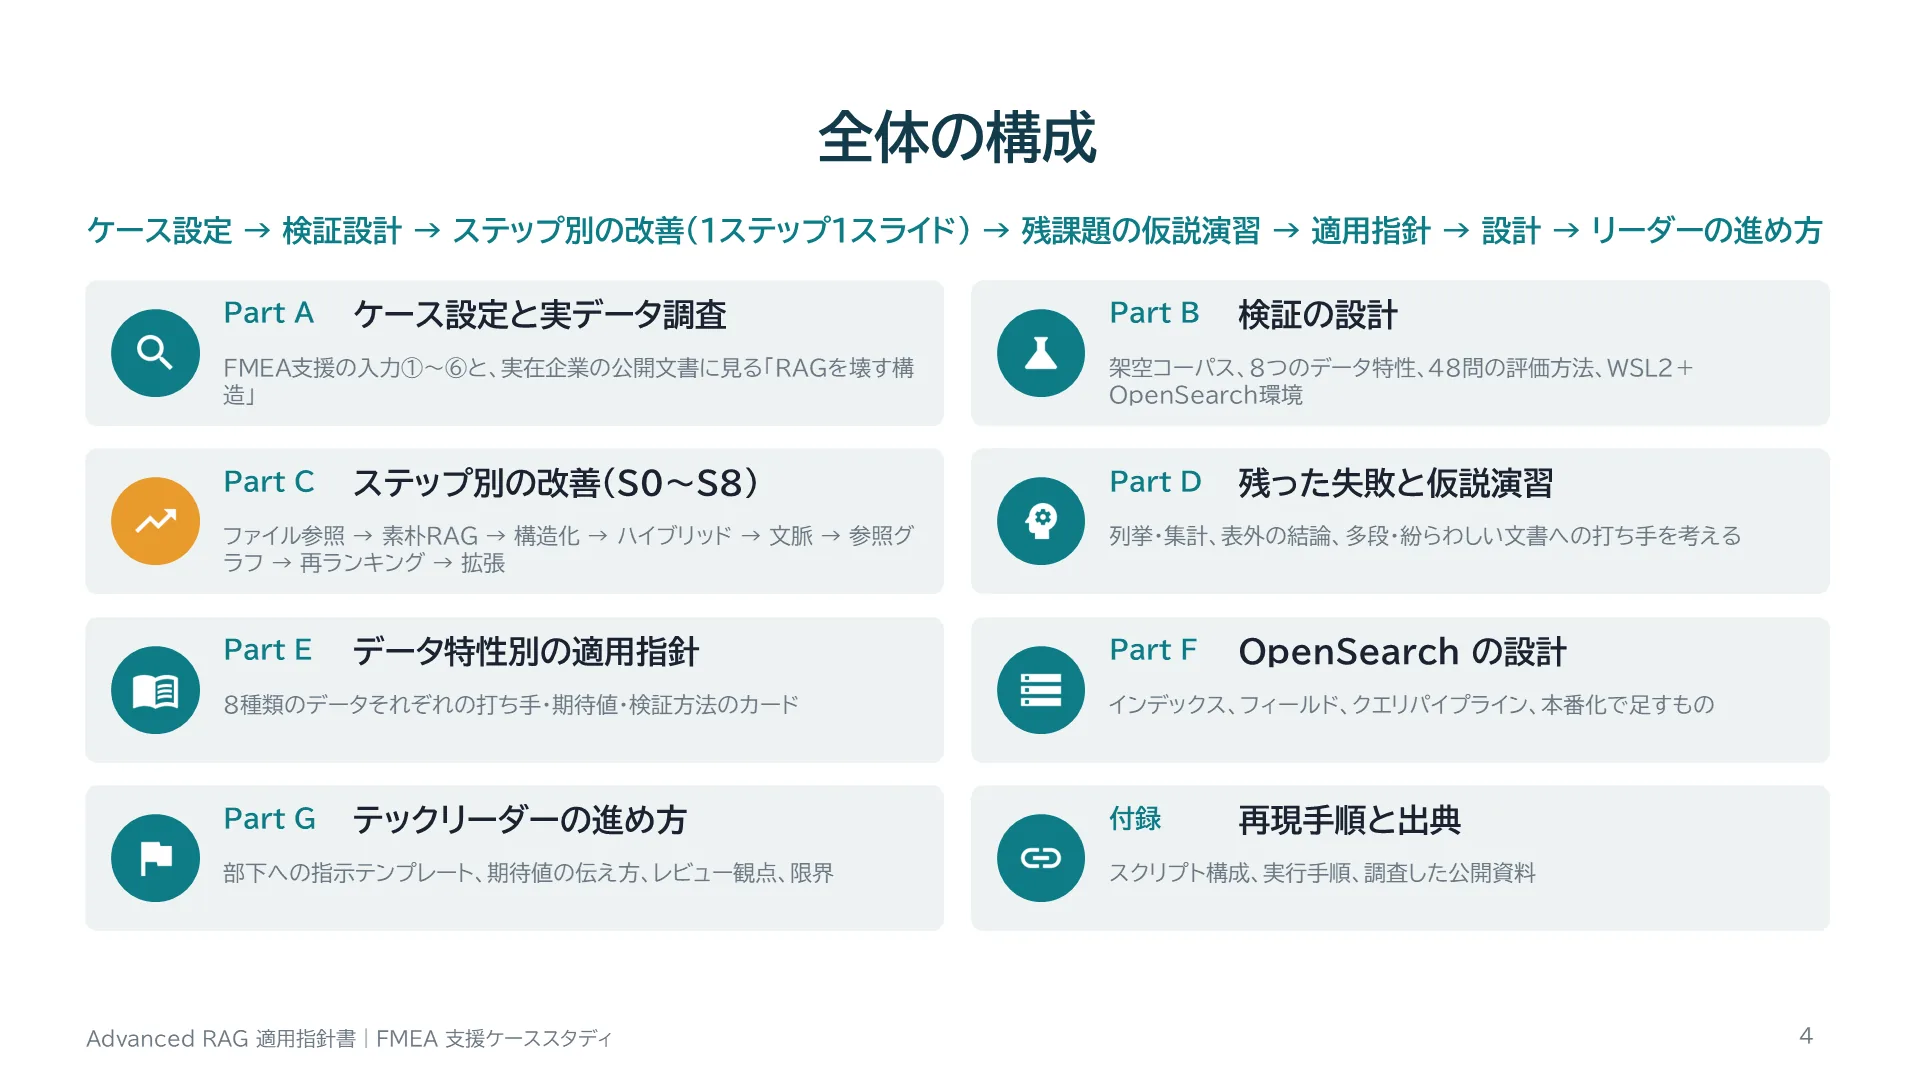
  4. 4. 全体の構成
  5. 5. PART A
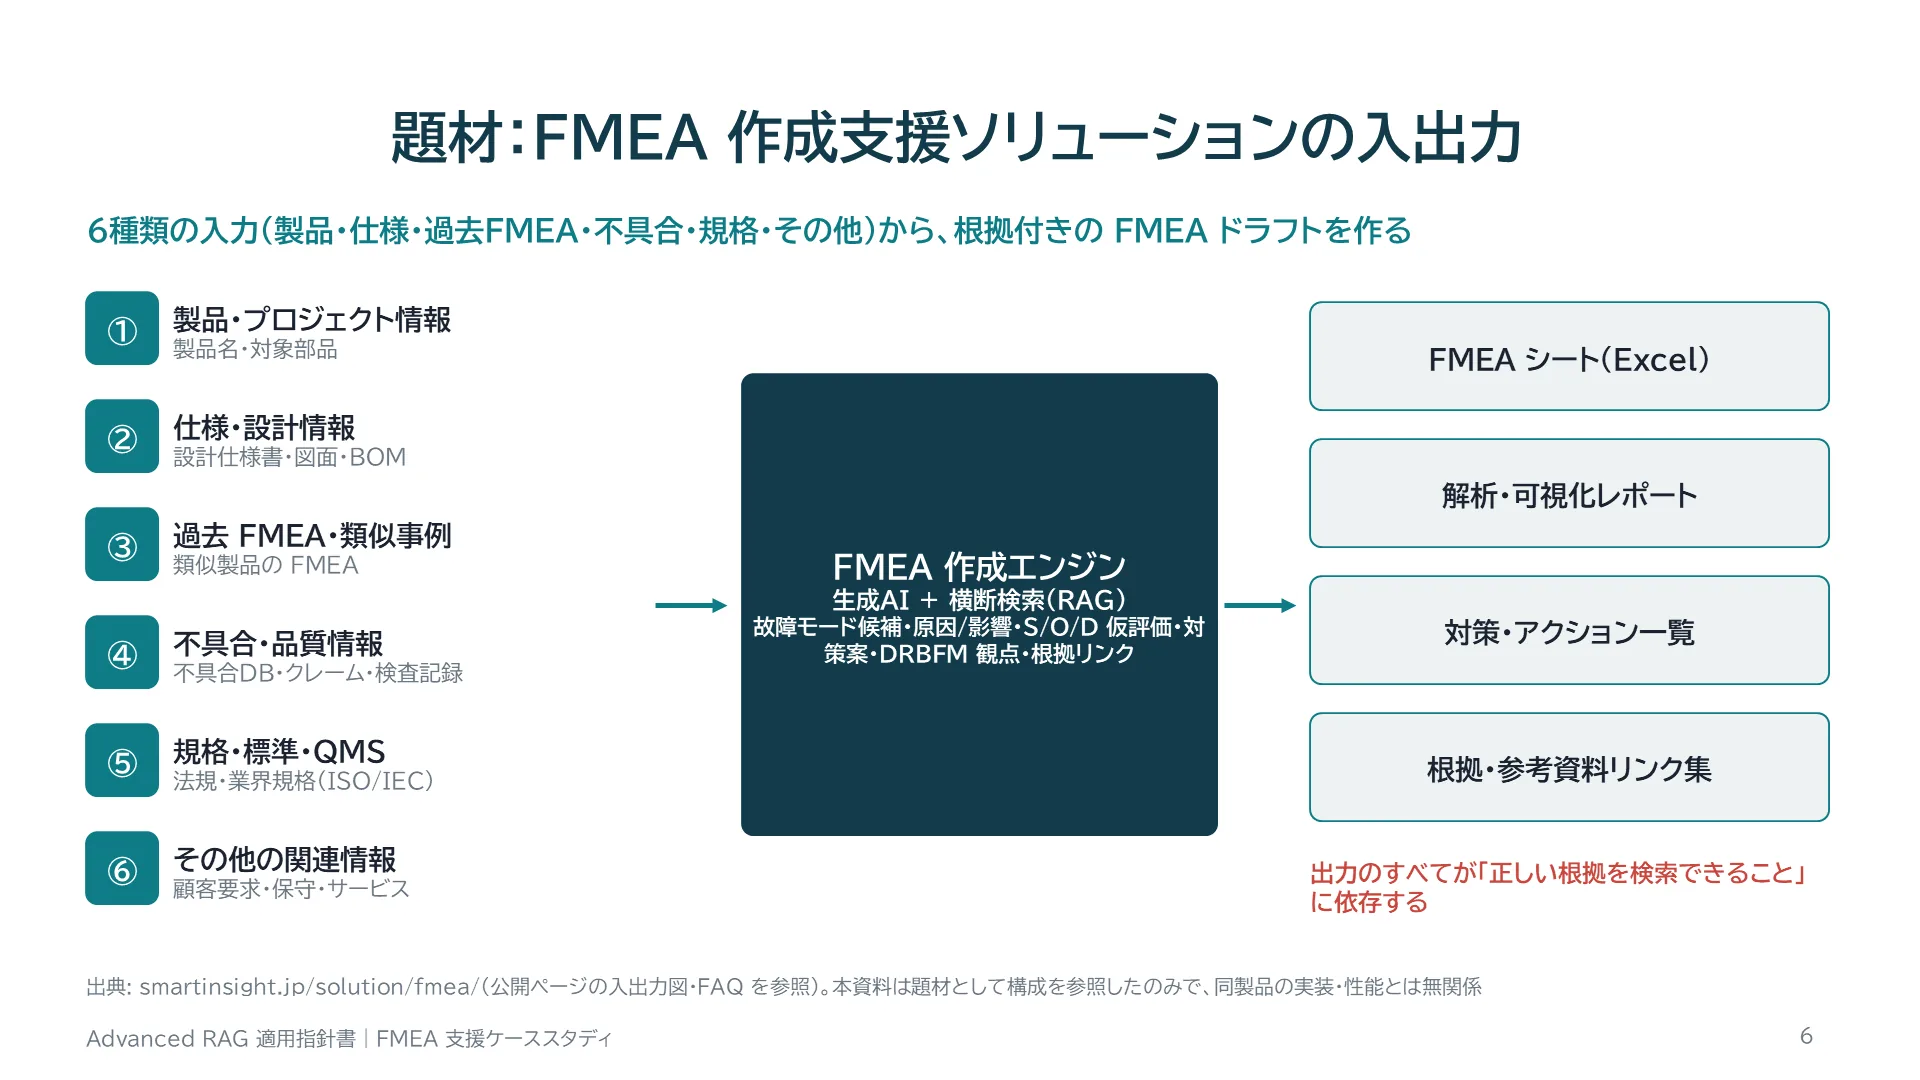
  6. 6. 題材:FMEA 作成支援ソリューションの入出力
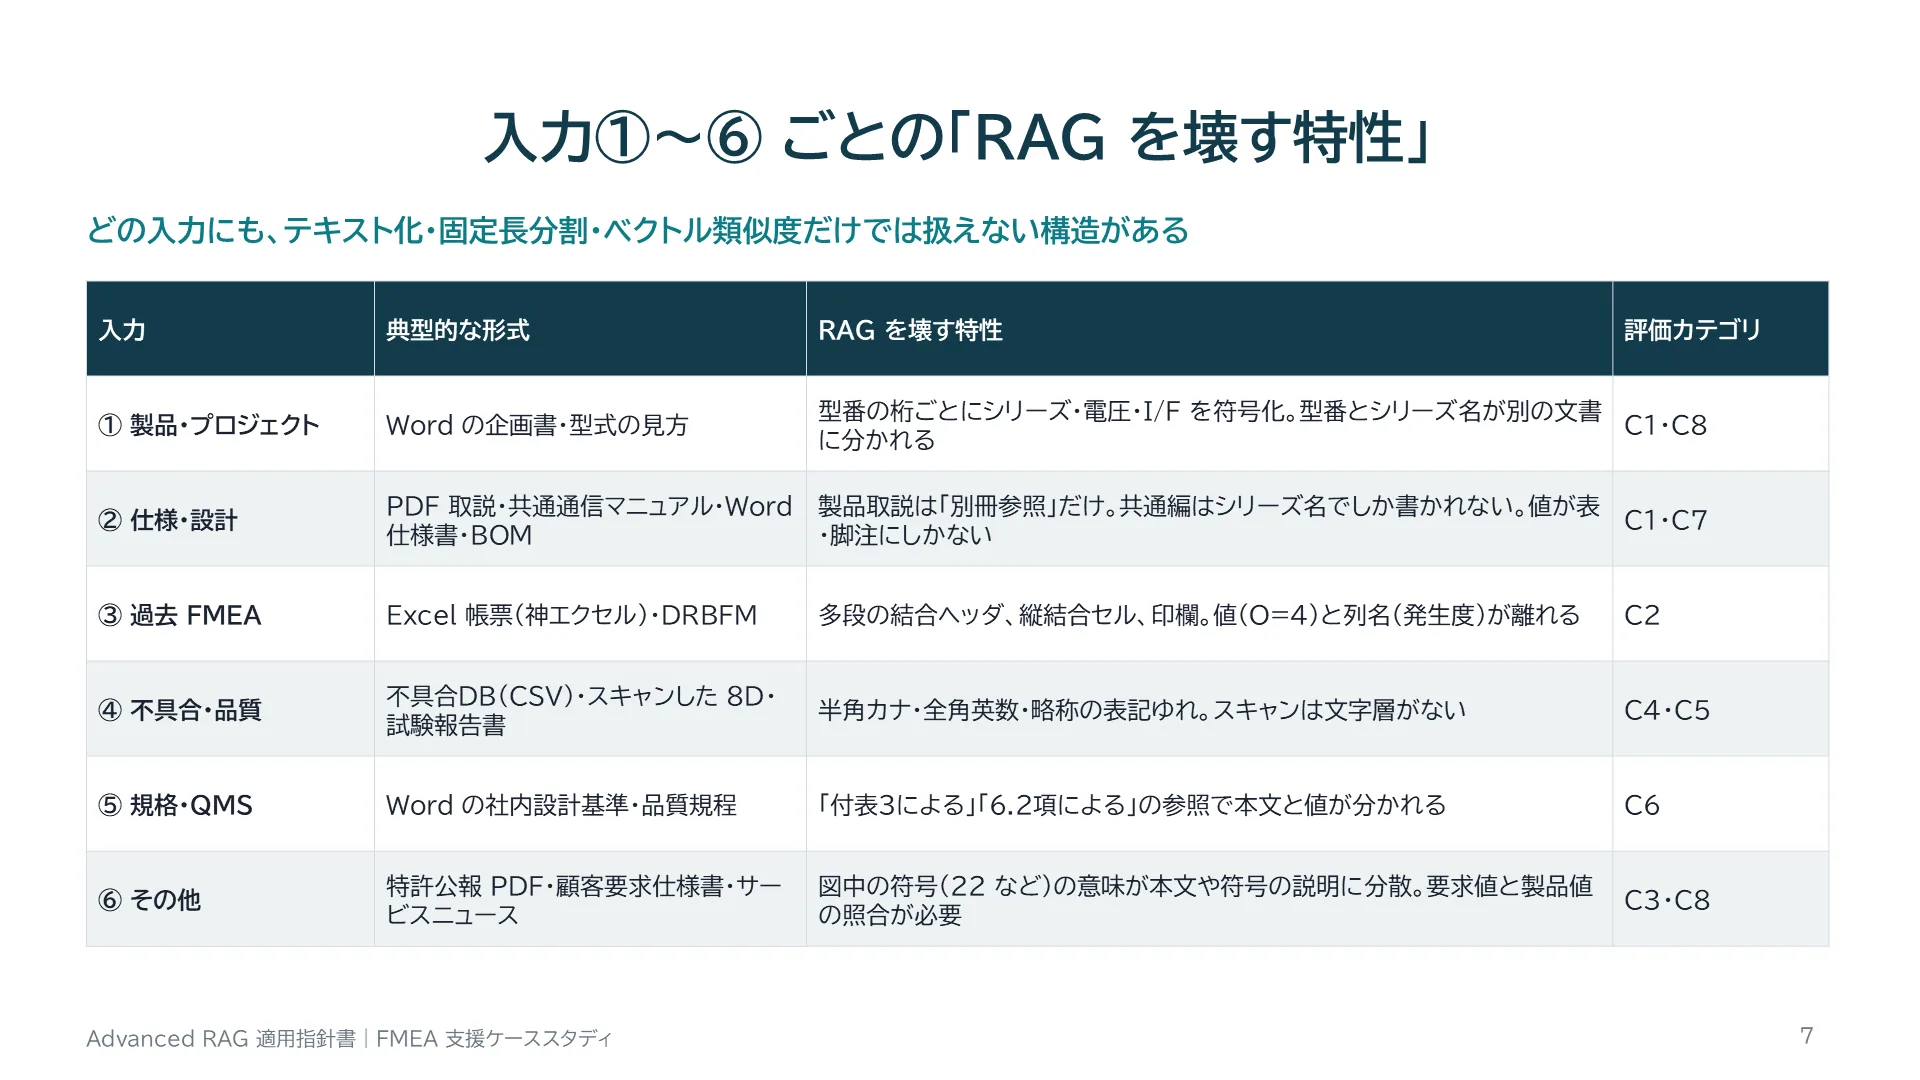
  7. 7. 入力①〜⑥ ごとの「RAG を壊す特性」
  8. 8. 実データ調査①:分冊マニュアルと「シリーズで書かれた仕様」
  9. 9. 実データ調査②:FMEA・DRBFM の「神エクセル」
  10. 10. 実データ調査③:特許の「図と符号」
  11. 11. 実データ調査④:スキャン報告書・不具合DB・規格
  12. 12. 合成コーパスの設計:架空企業「ミナト精機」の製品群
  13. 13. コーパス一覧:何をどの形式で、どの特性を再現したか
  14. 14. 実物イメージ①:過去 DFMEA(Excel 帳票)
  15. 15. 実物イメージ②:スキャンした試験報告書と特許の図
  16. 16. 実物イメージ③:製品取説と共通通信マニュアル
  17. 17. PART B
  18. 18. 8 つのデータ特性カテゴリと評価用の 48 問
  19. 19. 評価方法:「必要な事実が、結び付いた形で」上位 k 件に揃ったか
  20. 20. 検証環境:WSL2 上の OpenSearch と日本語モデル
  21. 21. 実験の段階設計:1 段ずつ足して、何が効いたかを分離する
  22. 22. PART C
  23. 23. S0 ファイル参照:「関係するファイルを丸ごと渡す」
  24. 24. S0 の中身:素朴なテキスト抽出が LLM に渡しているもの
  25. 25. S1 素朴 RAG:固定長チャンク+Dense 検索
  26. 26. S1 の失敗①:分冊マニュアル ― 取説ばかりが当たる
  27. 27. S1 の失敗②:神エクセル ― 数字はあるのに意味が分からない
  28. 28. S1b 比較:取込を直さずに検索だけ高度化すると?
  29. 29. 診断の型:S1 の 30 問の失敗を 3 つに分ける
  30. 30. S2 構造化取込:形式ごとに「構造を残す」パーサを作る
  31. 31. S2 の要:Excel 帳票を「1 行 1 レコード」に直列化する
  32. 32. S2 で実際にハマった 2 つの落とし穴
  33. 33. S2 のスキャン OCR:表は戻るが、誤読と欠落は残る
  34. 34. S2 の結果:帳票は解決、ただし特許は悪化
  35. 35. S3 ハイブリッド検索①:OpenSearch のインデックス定義
  36. 36. S3 ハイブリッド検索②:RRF パイプラインとクエリ
  37. 37. S3 の結果:型番・番号・用語に強くなった
  38. 38. S4 の狙い:「型番 → シリーズ → 適用表」の関係を索引に持たせる
  39. 39. S4 の実装:文脈ヘッダ・適用機種の付与・クエリ展開
  40. 40. S4 の結果:分冊マニュアルが 2/8 → 7/8
  41. 41. S4 の学び:文脈ヘッダの「中身」で結果が変わる
  42. 42. S5 参照グラフ①:特許の「図・符号・本文」をつなぐ
  43. 43. S5 参照グラフ②:「付表3による」の参照先を本文に取り込む
  44. 44. S6 再ランキング:上位 50 件をクロスエンコーダで並べ替え
  45. 45. S7 親子展開:表は表ごと読む ― 今回は −1 問
  46. 46. S8 参照追跡:別冊・関連文書をたどる ― 今回は改善なし
  47. 47. まとめ①:段階ごとの寄与(上位 5 件・上位 10 件)
  48. 48. まとめ②:データ特性 × 段階のヒートマップ(上位 5 件)
  49. 49. まとめ③:精度とコンテキスト量(コスト)
  50. 50. PART D
  51. 51. S6 でも残った 4 問の診断
  52. 52. 演習①(C5-1 列挙型):top-k ではなく構造化フィルタで引く
  53. 53. 演習②(C4-5 結論が表の外)と ③(C8-2 多段)
  54. 54. 演習④(C8-5 紛らわしい文書)と「1 問の差」の読み方
  55. 55. PART E
  56. 56. 適用指針マトリクス:データ特性 × 打ち手
  57. 57. 指針 C1:分冊・共通マニュアル(製品取説 ↔ シリーズ共通編)
  58. 58. 指針 C2:神エクセル帳票(FMEA・DRBFM・BOM)
  59. 59. 指針 C3:特許の図と符号
  60. 60. 指針 C4:スキャン PDF(8D 報告書・試験報告書・検査記録)
  61. 61. 指針 C5:表記ゆれのある自由記述 DB(不具合・クレーム)
  62. 62. 指針 C6:条項・付表参照(社内基準・QMS 規程)
  63. 63. 指針 C7:仕様書の表(定格・ディレーティング・ピン配置)
  64. 64. 指針 C8:複数ソース横断(FMEA/DRBFM 作成支援の本丸)
  65. 65. PART F
  66. 66. インデックス設計:チャンクは 1 インデックス、関係は別に持つ
  67. 67. フィールド設計:検証版から本番版へ
  68. 68. クエリパイプライン:質問の型で分岐し、段階を重ねる
  69. 69. PART G
  70. 70. 部下への指示テンプレート:仮説・打ち手・指標・完了条件
  71. 71. 期待値の伝え方:データ特性ごとの「ここまでは行ける」
  72. 72. レビュー観点:パーサ・評価・結果の「中身」を見る
  73. 73. プロジェクト計画への落とし込み(本ケース版)
  74. 74. 本検証の限界
  75. 75. 付録:再現手順
  76. 76. 付録:調査した公開資料(実データの構造)
ADVANCED RAG CASE STUDY
スライド 1 のテキストと解説
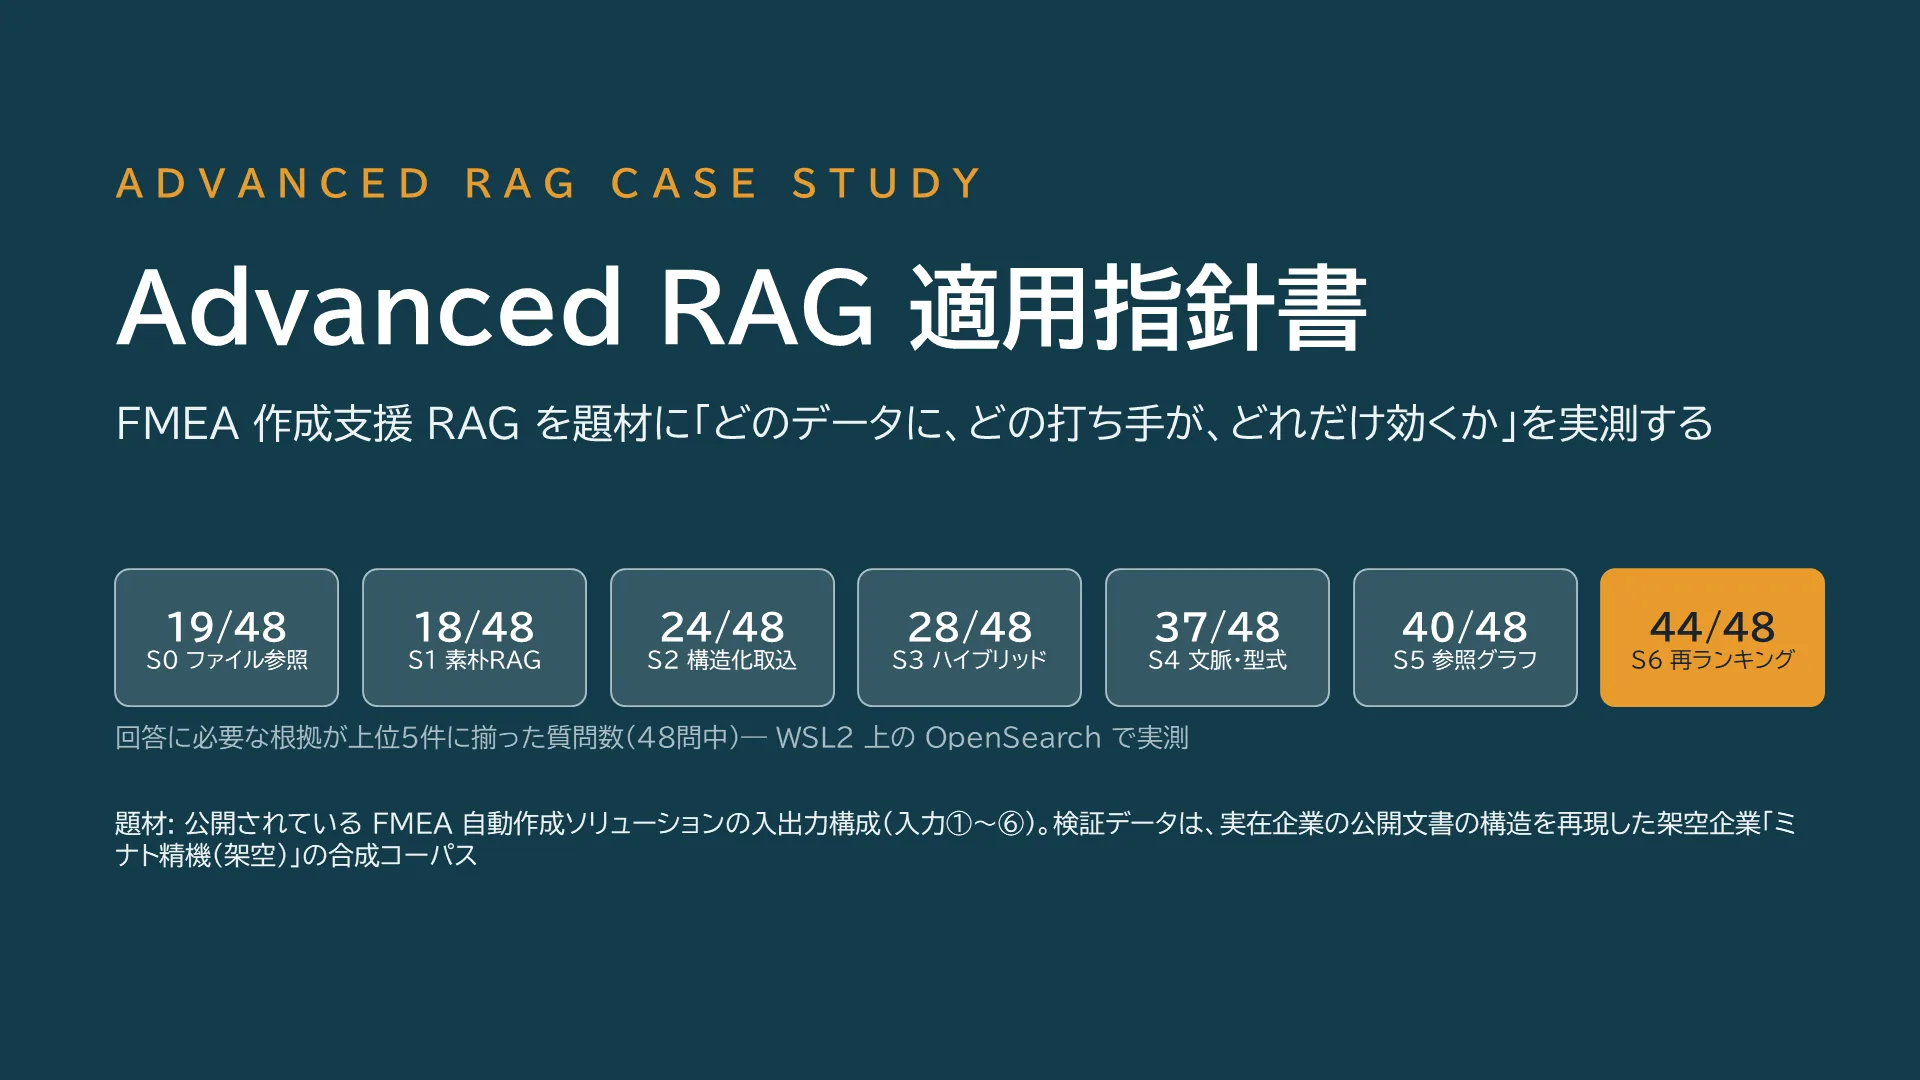
ADVANCED RAG CASE STUDY Advanced RAG 適用指針書 FMEA 作成支援 RAG を題材に「どのデータに、どの打ち手が、どれだけ効くか」を実測する 19/48 S0 ファイル参照 18/48 S1 素朴RAG 24/48 S2 構造化取込 28/48 S3 ハイブリッド 37/48 S4 文脈・型式 40/48 S5 参照グラフ 44/48 S6 再ランキング 回答に必要な根拠が上位5件に揃った質問数(48問中)― WSL2 上の OpenSearch で実測 題材: 公開されている FMEA 自動作成ソリューションの入出力構成(入力①〜⑥)。検証データは、実在企業の公開文書の構造を再現した架空企業「ミナト精機(架空)」の合成コーパス
解説

本資料は、前作「Advanced RAG 実践ガイド」の続編です。FMEA作成支援という具体的なユースケースを題材に、実際のプロジェクトで出会う厄介なデータ(分冊マニュアル、神エクセル、特許の図と符号、スキャンPDFなど)に対して、どのAdvanced RAG技術をどの順番で入れると、どれだけ改善するのかを、WSL2上のOpenSearchで実際に検証した結果をまとめています。数値はすべて実測値ですが、データは実在企業の公開文書の構造を再現した架空の合成データです。
この資料の目的:「表面の理解」から「期待値・仮説・指示」へ
スライド 2 のテキストと解説
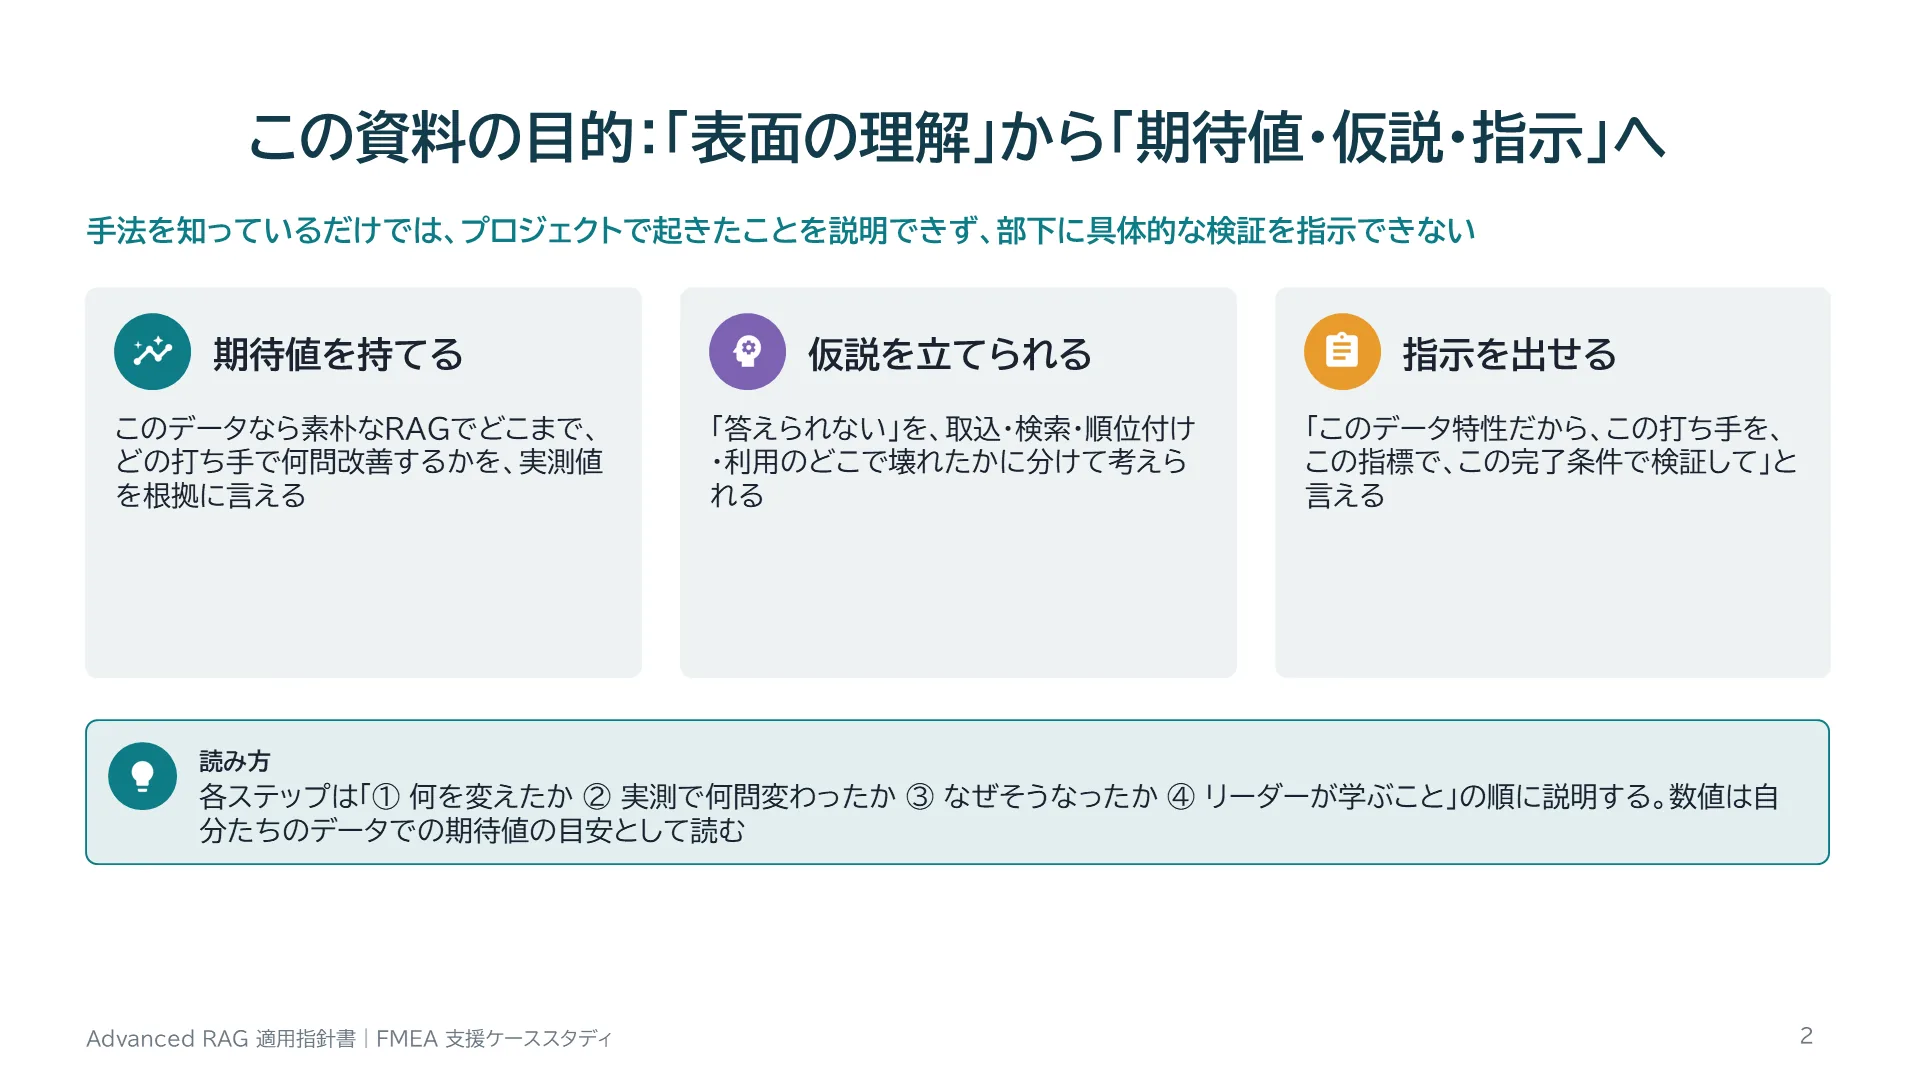
この資料の目的:「表面の理解」から「期待値・仮説・指示」へ 手法を知っているだけでは、プロジェクトで起きたことを説明できず、部下に具体的な検証を指示できない 期待値を持てる このデータなら素朴なRAGでどこまで、どの打ち手で何問改善するかを、実測値を根拠に言える 仮説を立てられる 「答えられない」を、取込・検索・順位付け・利用のどこで壊れたかに分けて考えられる 指示を出せる 「このデータ特性だから、この打ち手を、この指標で、この完了条件で検証して」と言える 読み方 各ステップは「① 何を変えたか ② 実測で何問変わったか ③ なぜそうなったか ④ リーダーが学ぶこと」の順に説明する。数値は自分たちのデータでの期待値の目安として読む 2
解説

前作で手法の全体像を学んでも、実プロジェクトでは「なぜこの質問だけ答えられないのか」「次に何を試すべきか」を即答できなければなりません。本資料は、具体的なデータ特性ごとに、素朴な実装がどう失敗し、どの打ち手でどれだけ改善したかを一歩ずつ示します。読み終えたときに、データを見て期待値を言える、失敗に仮説を立てられる、部下に検証を指示できる、の3つができることを目標にしています。
結論を先に:何が効き、何が効かなかったか
スライド 3 のテキストと解説
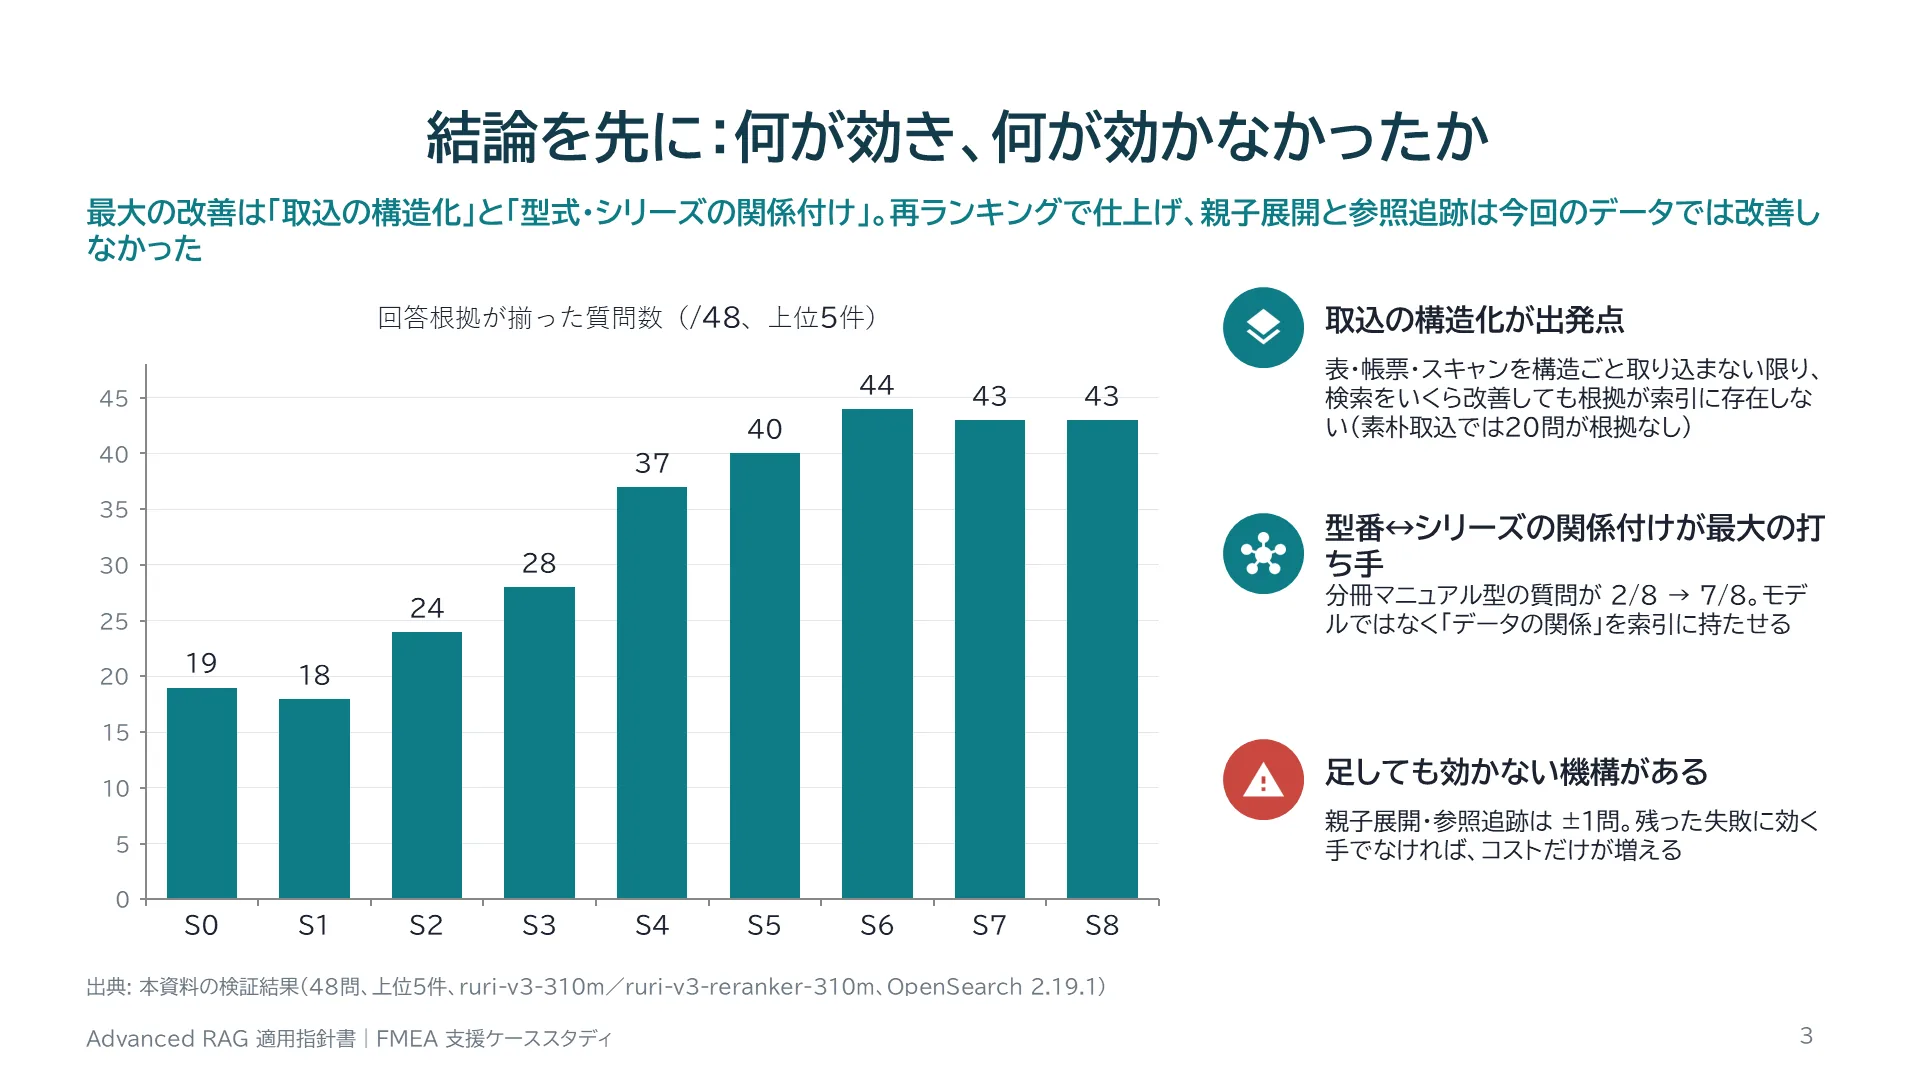
結論を先に:何が効き、何が効かなかったか 最大の改善は「取込の構造化」と「型式・シリーズの関係付け」。再ランキングで仕上げ、親子展開と参照追跡は今回のデータでは改善しなかった 出典: 本資料の検証結果(48問、上位5件、ruri-v3-310m/ruri-v3-reranker-310m、OpenSearch 2.19.1) 取込の構造化が出発点 表・帳票・スキャンを構造ごと取り込まない限り、検索をいくら改善しても根拠が索引に存在しない(素朴取込では20問が根拠なし) 型番↔シリーズの関係付けが最大の打ち手 分冊マニュアル型の質問が 2/8 → 7/8。モデルではなく「データの関係」を索引に持たせる 足しても効かない機構がある 親子展開・参照追跡は ±1問。残った失敗に効く手でなければ、コストだけが増える 3
解説

上位5件に回答根拠が揃った質問数の推移です。ファイル参照と素朴なRAGは18〜19問で、ほぼ同じ水準でした。構造化した取込で24問、ハイブリッド検索で28問、文脈付与と型式の正規化で37問、図の符号などの参照グラフで40問、再ランキングで44問まで上がりました。一方、表を表ごと読む親子展開と、別冊への参照追跡は、このデータでは1問減るか横ばいでした。48問なので1問の差は誤差の範囲ですが、「追加すれば必ず良くなるわけではない」という教訓として扱います。
全体の構成
スライド 4 のテキストと解説
全体の構成 ケース設定 → 検証設計 → ステップ別の改善(1ステップ1スライド) → 残課題の仮説演習 → 適用指針 → 設計 → リーダーの進め方 Part A ケース設定と実データ調査 FMEA支援の入力①〜⑥と、実在企業の公開文書に見る「RAGを壊す構造」 Part B 検証の設計 架空コーパス、8つのデータ特性、48問の評価方法、WSL2+OpenSearch環境 Part C ステップ別の改善(S0〜S8) ファイル参照 → 素朴RAG → 構造化 → ハイブリッド → 文脈 → 参照グラフ → 再ランキング → 拡張 Part D 残った失敗と仮説演習 列挙・集計、表外の結論、多段・紛らわしい文書への打ち手を考える Part E データ特性別の適用指針 8種類のデータそれぞれの打ち手・期待値・検証方法のカード Part F OpenSearch の設計 インデックス、フィールド、クエリパイプライン、本番化で足すもの Part G テックリーダーの進め方 部下への指示テンプレート、期待値の伝え方、レビュー観点、限界 付録 再現手順と出典 スクリプト構成、実行手順、調査した公開資料 4
解説

Part C が本資料の中心で、S0からS8までの各ステップを、構成・結果・理由・学びの順に追います。Part E の適用指針は、データ特性ごとに打ち手と期待値を1枚にまとめたカードで、実プロジェクトで最も参照する部分になるはずです。
PART A
スライド 5 のテキストと解説
PART A ケース設定と実データ調査 FMEA 作成支援の入力データは、実際の企業文書ではどんな形をしていて、なぜ素朴な RAG を壊すのか このPartで答えられるようになる問い FMEA 支援 RAG はどんなデータを入力にするか? 実在企業の公開文書にはどんな「厄介な構造」があるか? その構造をどう合成データに再現したか? 5
解説

Part A ではまず題材と、実データの調査結果を示します。合成データの妥当性は、ここで示す実データの構造をどれだけ再現できているかにかかっています。
題材:FMEA 作成支援ソリューションの入出力
スライド 6 のテキストと解説
題材:FMEA 作成支援ソリューションの入出力 6種類の入力(製品・仕様・過去FMEA・不具合・規格・その他)から、根拠付きの FMEA ドラフトを作る 出典: smartinsight.jp/solution/fmea/(公開ページの入出力図・FAQ を参照)。本資料は題材として構成を参照したのみで、同製品の実装・性能とは無関係 ① 製品・プロジェクト情報 製品名・対象部品 ② 仕様・設計情報 設計仕様書・図面・BOM ③ 過去 FMEA・類似事例 類似製品の FMEA ④ 不具合・品質情報 不具合DB・クレーム・検査記録 ⑤ 規格・標準・QMS 法規・業界規格(ISO/IEC) ⑥ その他の関連情報 顧客要求・保守・サービス FMEA 作成エンジン 生成AI + 横断検索(RAG) 故障モード候補・原因/影響・S/O/D 仮評価・対策案・DRBFM 観点・根拠リンク FMEA シート(Excel) 解析・可視化レポート 対策・アクション一覧 根拠・参考資料リンク集 出力のすべてが「正しい根拠を検索できること」に依存する 6
解説

題材にしたのは、公開されている生成AIによるFMEA自動作成ソリューションの入出力構成です。入力は①製品・プロジェクト情報、②仕様・設計情報(設計仕様書・図面・BOM)、③過去のFMEA・類似事例、④不具合・品質情報(不具合DB・クレーム・検査記録)、⑤規格・標準・QMS、⑥その他(顧客要求・保守情報)の6種類です。出力はFMEAシート、リスクの可視化、対策一覧、根拠資料のリンク集です。同ページのFAQでも「スキャンPDFはOCRで対応」「回答には根拠を必ず添付」とされており、どれもRAGの検索品質が前提になる機能です。本資料はこの構成を題材として借りただけで、当該製品の内部実装や性能を評価するものではありません。
入力①〜⑥ ごとの「RAG を壊す特性」
スライド 7 のテキストと解説
入力①〜⑥ ごとの「RAG を壊す特性」 どの入力にも、テキスト化・固定長分割・ベクトル類似度だけでは扱えない構造がある 入力 | 典型的な形式 | RAG を壊す特性 | 評価カテゴリ ① 製品・プロジェクト | Word の企画書・型式の見方 | 型番の桁ごとにシリーズ・電圧・I/F を符号化。型番とシリーズ名が別の文書に分かれる | C1・C8 ② 仕様・設計 | PDF 取説・共通通信マニュアル・Word 仕様書・BOM | 製品取説は「別冊参照」だけ。共通編はシリーズ名でしか書かれない。値が表・脚注にしかない | C1・C7 ③ 過去 FMEA | Excel 帳票(神エクセル)・DRBFM | 多段の結合ヘッダ、縦結合セル、印欄。値(O=4)と列名(発生度)が離れる | C2 ④ 不具合・品質 | 不具合DB(CSV)・スキャンした 8D・試験報告書 | 半角カナ・全角英数・略称の表記ゆれ。スキャンは文字層がない | C4・C5 ⑤ 規格・QMS | Word の社内設計基準・品質規程 | 「付表3による」「6.2項による」の参照で本文と値が分かれる | C6 ⑥ その他 | 特許公報 PDF・顧客要求仕様書・サービスニュース | 図中の符号(22 など)の意味が本文や符号の説明に分散。要求値と製品値の照合が必要 | C3・C8 7
解説

入力データごとに、素朴なRAGを壊す典型的な特性を整理しました。この8つの特性を、後の評価でC1〜C8のカテゴリとして使います。①製品情報の型式の見方は、型番からシリーズを特定するための鍵になります。②の仕様は、分冊マニュアル(C1)と仕様書の表(C7)が問題になります。③過去FMEAは神エクセル(C2)、④はスキャンPDF(C4)と表記ゆれDB(C5)、⑤は条項と付表の参照(C6)、⑥の特許は図と符号の分離(C3)が問題です。そして実際のFMEA支援の質問は、これらを横断します(C8)。
実データ調査①:分冊マニュアルと「シリーズで書かれた仕様」
スライド 8 のテキストと解説
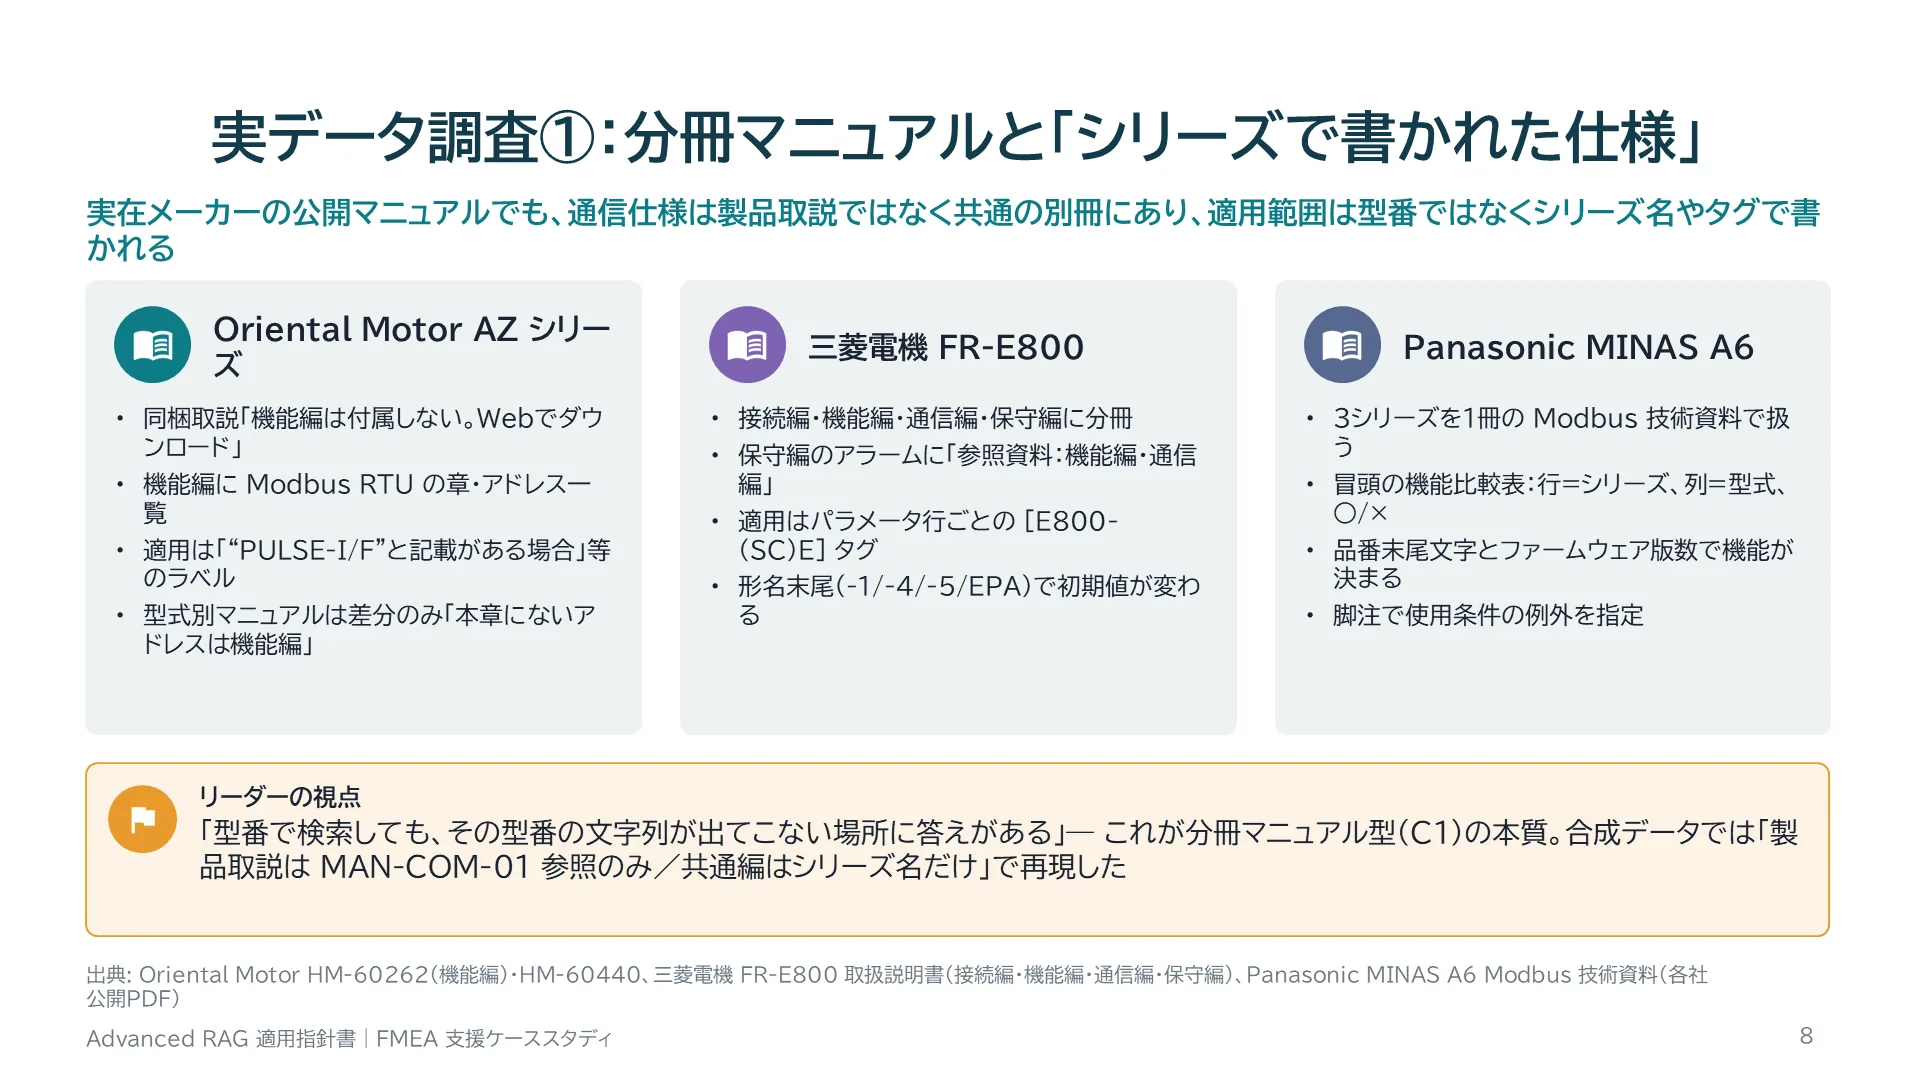
実データ調査①:分冊マニュアルと「シリーズで書かれた仕様」 実在メーカーの公開マニュアルでも、通信仕様は製品取説ではなく共通の別冊にあり、適用範囲は型番ではなくシリーズ名やタグで書かれる 出典: Oriental Motor HM-60262(機能編)・HM-60440、三菱電機 FR-E800 取扱説明書(接続編・機能編・通信編・保守編)、Panasonic MINAS A6 Modbus 技術資料(各社公開PDF) Oriental Motor AZ シリーズ 同梱取説「機能編は付属しない。Webでダウンロード」 機能編に Modbus RTU の章・アドレス一覧 適用は「“PULSE-I/F”と記載がある場合」等のラベル 型式別マニュアルは差分のみ「本章にないアドレスは機能編」 三菱電機 FR-E800 接続編・機能編・通信編・保守編に分冊 保守編のアラームに「参照資料:機能編・通信編」 適用はパラメータ行ごとの [E800-(SC)E] タグ 形名末尾(-1/-4/-5/EPA)で初期値が変わる Panasonic MINAS A6 3シリーズを1冊の Modbus 技術資料で扱う 冒頭の機能比較表:行=シリーズ、列=型式、○/× 品番末尾文字とファームウェア版数で機能が決まる 脚注で使用条件の例外を指定 リーダーの視点 「型番で検索しても、その型番の文字列が出てこない場所に答えがある」― これが分冊マニュアル型(C1)の本質。合成データでは「製品取説は MAN-COM-01 参照のみ/共通編はシリーズ名だけ」で再現した 8
解説

オリエンタルモーターのAZシリーズでは、本体同梱の取説に「機能編は付属しません、Webからダウンロード」と書かれ、Modbus RTUの章やアドレス一覧は機能編にあります。機能編の適用範囲は品名ではなく「PULSE-I/Fと記載がある場合」のようなラベルで表されます。三菱電機FR-E800は、接続編・機能編・通信編・保守編に分かれ、パラメータ1行ごとに[E800-(SC)E]のような角括弧タグで適用機種が示されます。パナソニックMINAS A6は、行がシリーズ、列が型式の○×表と脚注で機能差を示します。どれも「型番で検索しても、その型番の文字列が出てこない場所に答えがある」構造です。
実データ調査②:FMEA・DRBFM の「神エクセル」
スライド 9 のテキストと解説
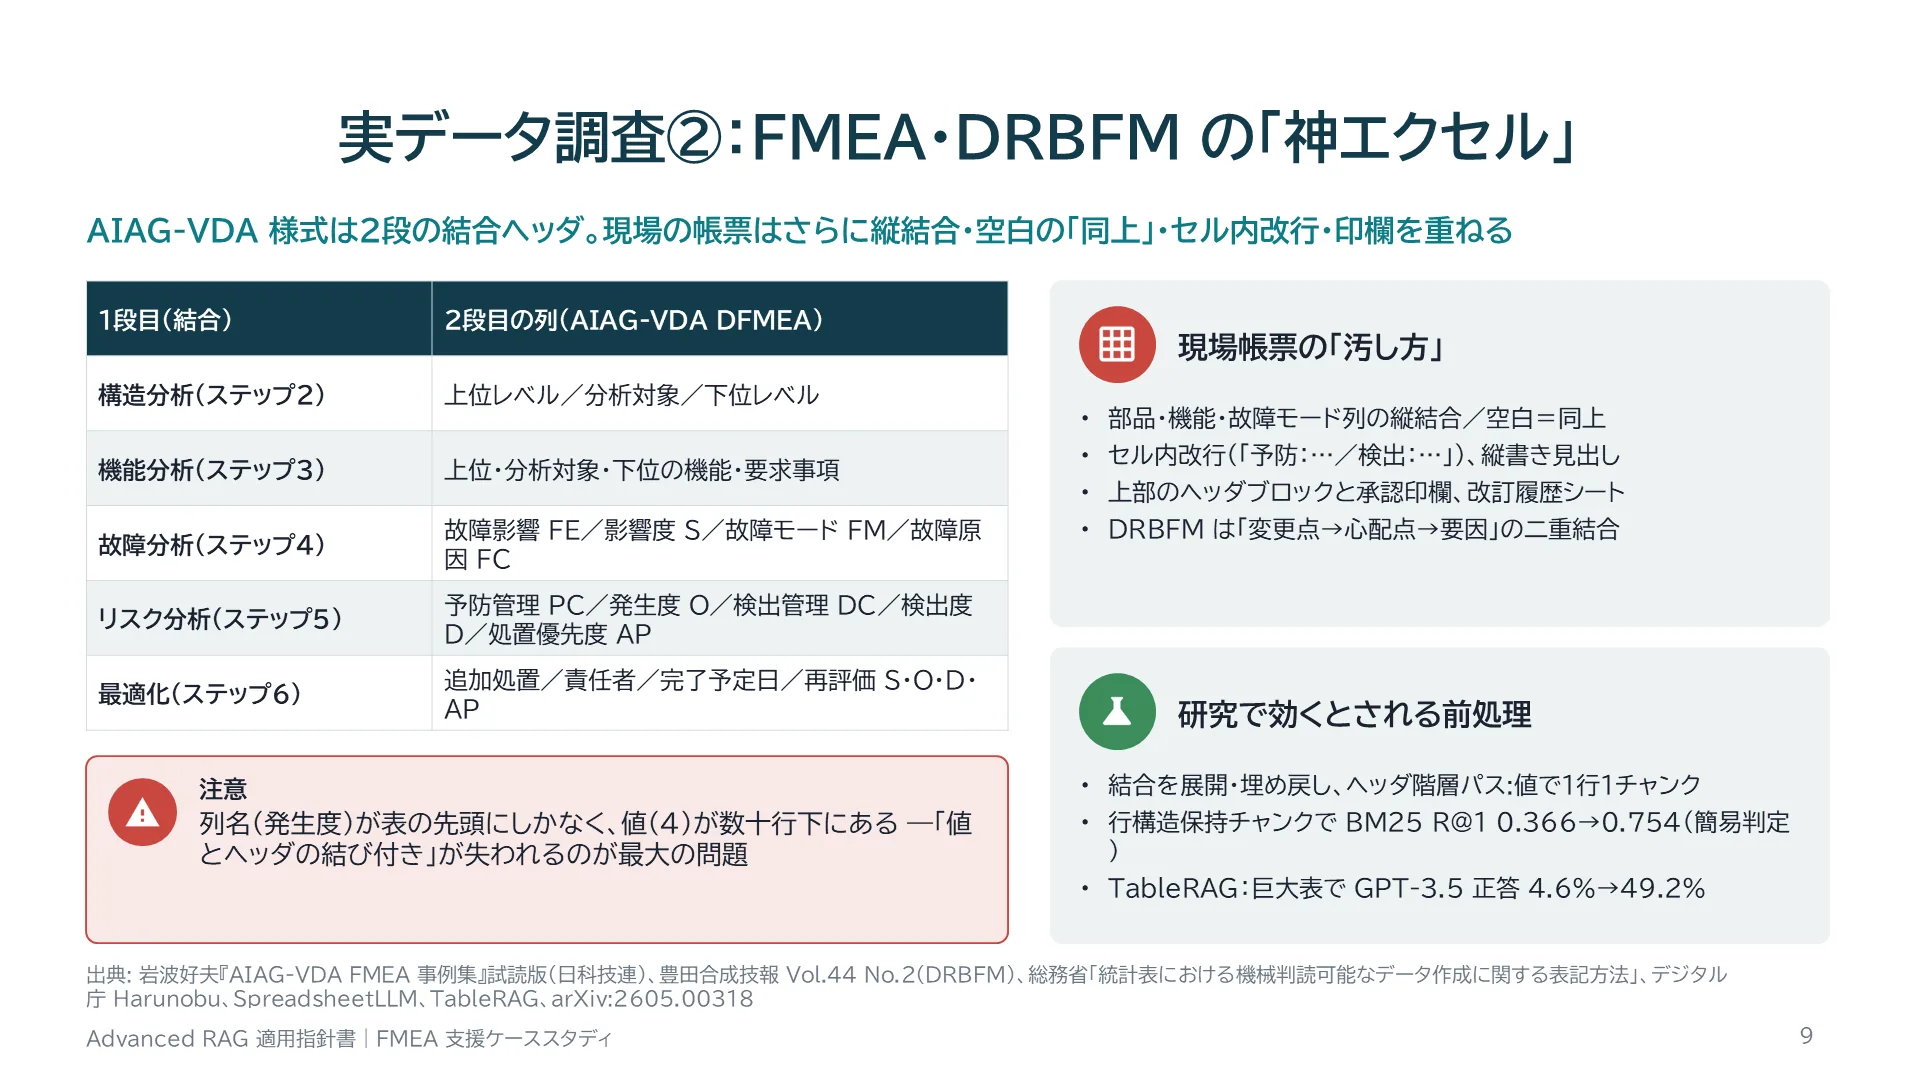
実データ調査②:FMEA・DRBFM の「神エクセル」 AIAG-VDA 様式は2段の結合ヘッダ。現場の帳票はさらに縦結合・空白の「同上」・セル内改行・印欄を重ねる 出典: 岩波好夫『AIAG-VDA FMEA 事例集』試読版(日科技連)、豊田合成技報 Vol.44 No.2(DRBFM)、総務省「統計表における機械判読可能なデータ作成に関する表記方法」、デジタル庁 Harunobu、SpreadsheetLLM、TableRAG、arXiv:2605.00318 1段目(結合) | 2段目の列(AIAG-VDA DFMEA) 構造分析(ステップ2) | 上位レベル/分析対象/下位レベル 機能分析(ステップ3) | 上位・分析対象・下位の機能・要求事項 故障分析(ステップ4) | 故障影響 FE/影響度 S/故障モード FM/故障原因 FC リスク分析(ステップ5) | 予防管理 PC/発生度 O/検出管理 DC/検出度 D/処置優先度 AP 最適化(ステップ6) | 追加処置/責任者/完了予定日/再評価 S・O・D・AP 現場帳票の「汚し方」 部品・機能・故障モード列の縦結合/空白=同上 セル内改行(「予防:…/検出:…」)、縦書き見出し 上部のヘッダブロックと承認印欄、改訂履歴シート DRBFM は「変更点→心配点→要因」の二重結合 研究で効くとされる前処理 結合を展開・埋め戻し、ヘッダ階層パス:値で1行1チャンク 行構造保持チャンクで BM25 R@1 0.366→0.754(簡易判定) TableRAG:巨大表で GPT-3.5 正答 4.6%→49.2% 注意 列名(発生度)が表の先頭にしかなく、値(4)が数十行下にある ―「値とヘッダの結び付き」が失われるのが最大の問題 9
解説

AIAG-VDAのDFMEA様式は、1段目に「構造分析(ステップ2)」「故障分析(ステップ4)」などのステップ名が結合セルで並び、2段目に故障影響FE、影響度S、故障モードFM、故障原因FC、発生度O、検出度Dなどの列が並びます。現場の帳票は、さらに部品や機能の列を縦結合し、空白を「同上」として使い、セル内で改行し、上部に承認印欄を置きます。総務省の機械判読ルールがまさに避けるべき書き方として挙げているものです。研究では、結合を展開して埋め戻し、「ヘッダの階層パス: 値」の形で1行1チャンクに直列化する前処理が最も効くとされています。行単位で構造を保ったチャンクで、BM25のRecall@1が0.366から0.754に上がったという報告もあります(文字列一致の簡易判定)。
実データ調査③:特許の「図と符号」
スライド 10 のテキストと解説
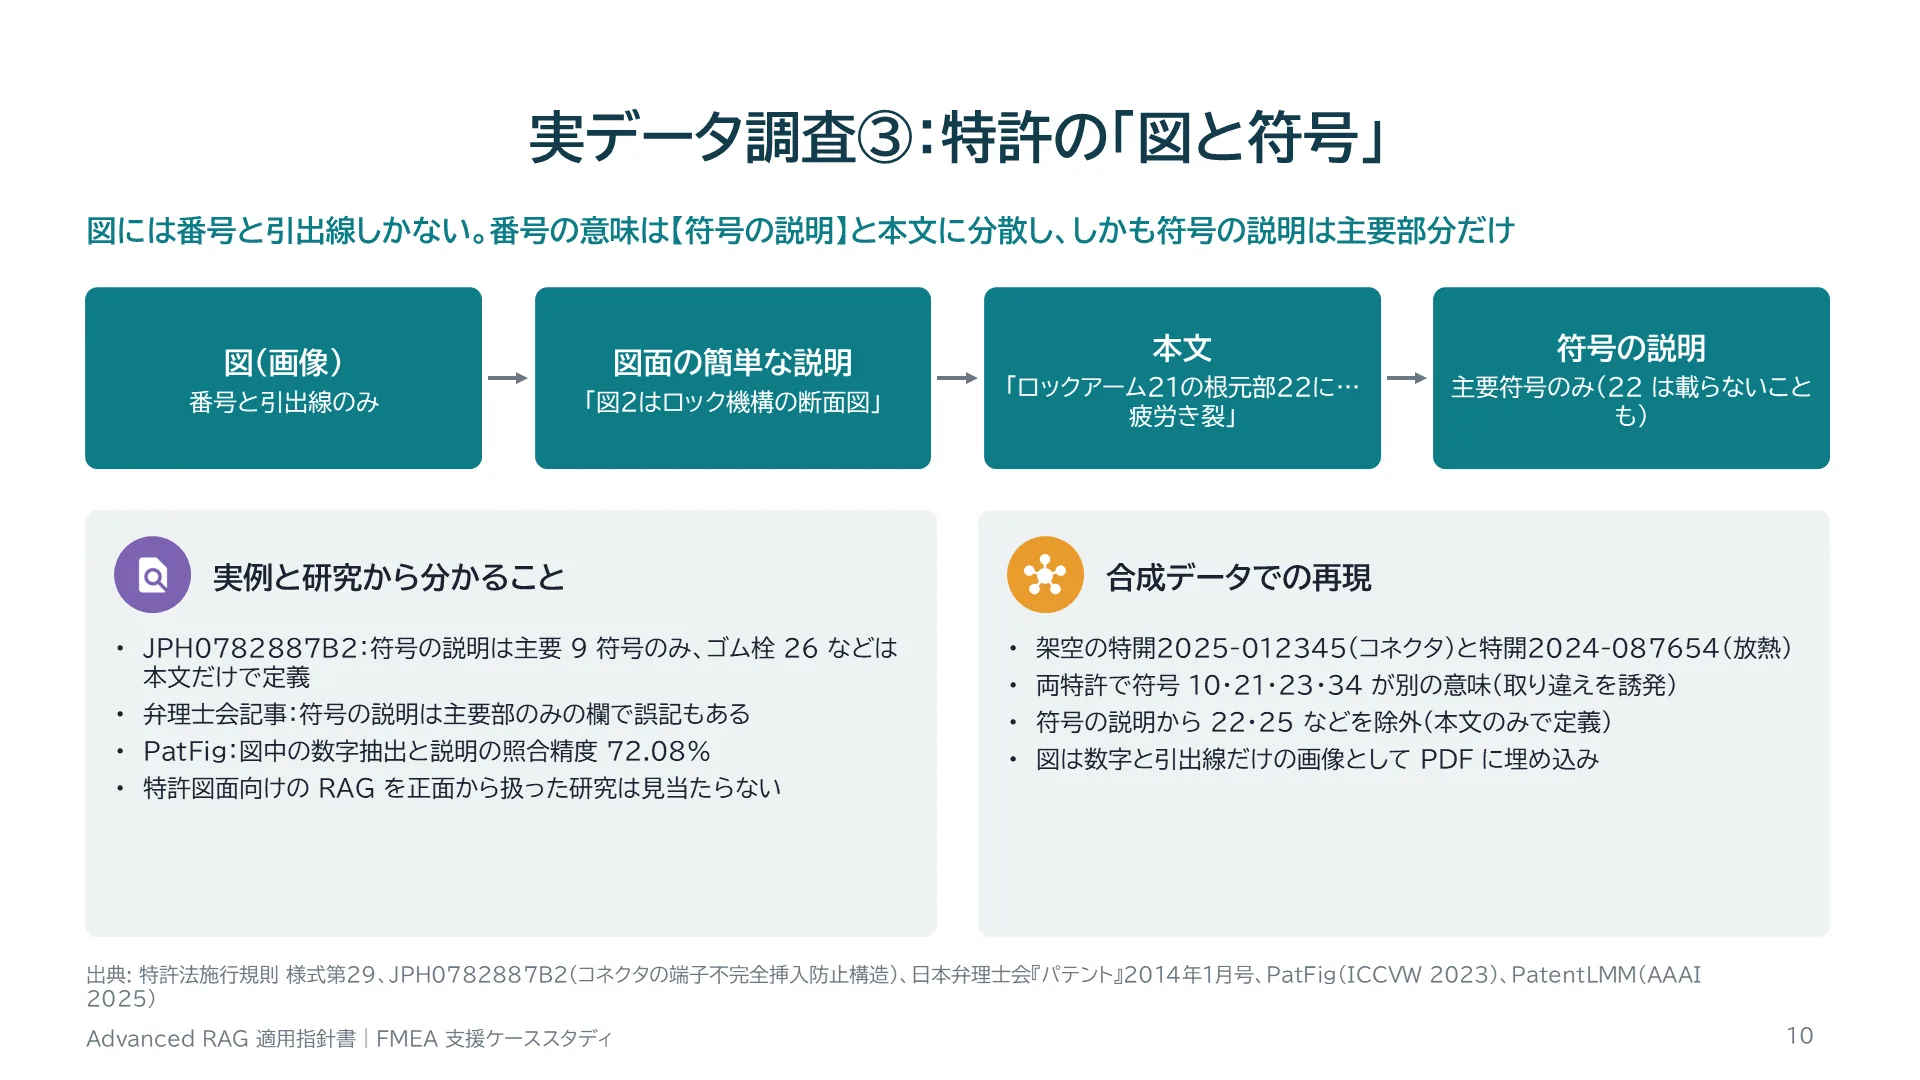
実データ調査③:特許の「図と符号」 図には番号と引出線しかない。番号の意味は【符号の説明】と本文に分散し、しかも符号の説明は主要部分だけ 出典: 特許法施行規則 様式第29、JPH0782887B2(コネクタの端子不完全挿入防止構造)、日本弁理士会『パテント』2014年1月号、PatFig(ICCVW 2023)、PatentLMM(AAAI 2025) 図(画像) 番号と引出線のみ 図面の簡単な説明 「図2はロック機構の断面図」 本文 「ロックアーム21の根元部22に…疲労き裂」 符号の説明 主要符号のみ(22 は載らないことも) 実例と研究から分かること JPH0782887B2:符号の説明は主要 9 符号のみ、ゴム栓 26 などは本文だけで定義 弁理士会記事:符号の説明は主要部のみの欄で誤記もある PatFig:図中の数字抽出と説明の照合精度 72.08% 特許図面向けの RAG を正面から扱った研究は見当たらない 合成データでの再現 架空の特開2025-012345(コネクタ)と特開2024-087654(放熱) 両特許で符号 10・21・23・34 が別の意味(取り違えを誘発) 符号の説明から 22・25 などを除外(本文のみで定義) 図は数字と引出線だけの画像として PDF に埋め込み 10
解説

日本の特許明細書は、【図面の簡単な説明】で図の種類を、【発明を実施するための形態】の本文で「端子18は係止段部20に係合せず」のように名称と符号を組で書き、末尾の【符号の説明】で主な符号の名称を列挙します。実例のJPH0782887B2では、符号の説明に載っているのは主要な9符号だけで、他の符号は本文中にしか定義がありません。弁理士会の記事も、符号の説明は主要部分のみで誤記もあると指摘しています。図そのものは画像なので、図中の数字はOCRしないと取り出せず、PatFigの研究では図中の数字の抽出と照合の精度は72%程度でした。「図3の符号22は何で、どんな故障に関係するか」に答えるには、図の種類、図中の符号、名称、本文の故障記述の4つを結ぶ必要があります。
実データ調査④:スキャン報告書・不具合DB・規格
スライド 11 のテキストと解説
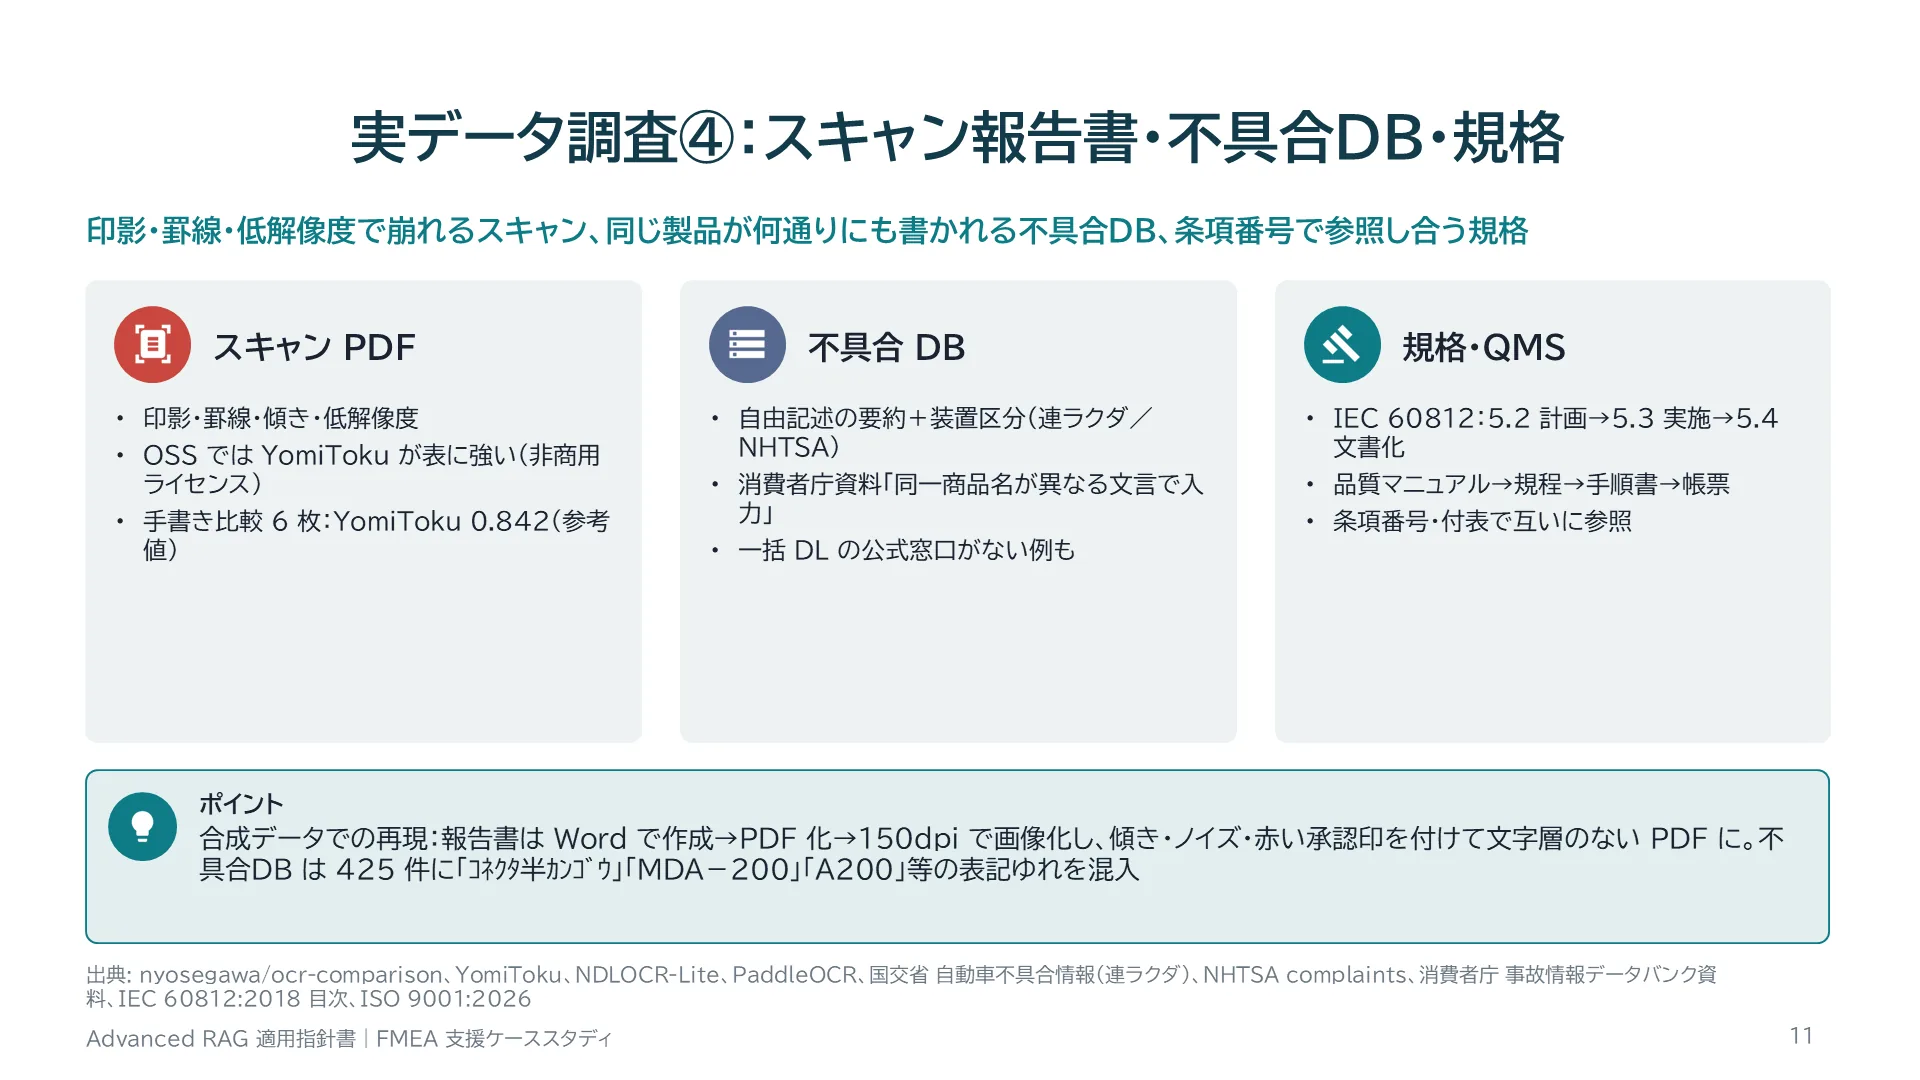
実データ調査④:スキャン報告書・不具合DB・規格 印影・罫線・低解像度で崩れるスキャン、同じ製品が何通りにも書かれる不具合DB、条項番号で参照し合う規格 出典: nyosegawa/ocr-comparison、YomiToku、NDLOCR-Lite、PaddleOCR、国交省 自動車不具合情報(連ラクダ)、NHTSA complaints、消費者庁 事故情報データバンク資料、IEC 60812:2018 目次、ISO 9001:2026 スキャン PDF 印影・罫線・傾き・低解像度 OSS では YomiToku が表に強い(非商用ライセンス) 手書き比較 6 枚:YomiToku 0.842(参考値) 不具合 DB 自由記述の要約+装置区分(連ラクダ/NHTSA) 消費者庁資料「同一商品名が異なる文言で入力」 一括 DL の公式窓口がない例も 規格・QMS IEC 60812:5.2 計画→5.3 実施→5.4 文書化 品質マニュアル→規程→手順書→帳票 条項番号・付表で互いに参照 ポイント 合成データでの再現:報告書は Word で作成→PDF 化→150dpi で画像化し、傾き・ノイズ・赤い承認印を付けて文字層のない PDF に。不具合DB は 425 件に「コネクタ半カンゴウ」「MDA-200」「A200」等の表記ゆれを混入 11
解説

スキャン文書は、印影の重なり、罫線の縦棒の誤認識、傾き、低解像度が典型的な難所です。日本語手書きメモ6枚の比較では、YomiTokuが0.842とOSSで最良でした(件数が少なく参考値)。YomiTokuは表構造の認識に対応しますが、OSS版は非商用ライセンスです。不具合DBの実例として、国交省の不具合情報やNHTSAのcomplaintsは、装置区分と自由記述の要約を持ちます。消費者庁の資料自体が「同一企業名・商品名が異なる文言で入力されている」と表記ゆれを課題に挙げています。規格はIEC 60812のように箇条番号で構造化され、社内QMS文書は品質マニュアル→規程→手順書→帳票の階層で、互いに条項番号で参照します。
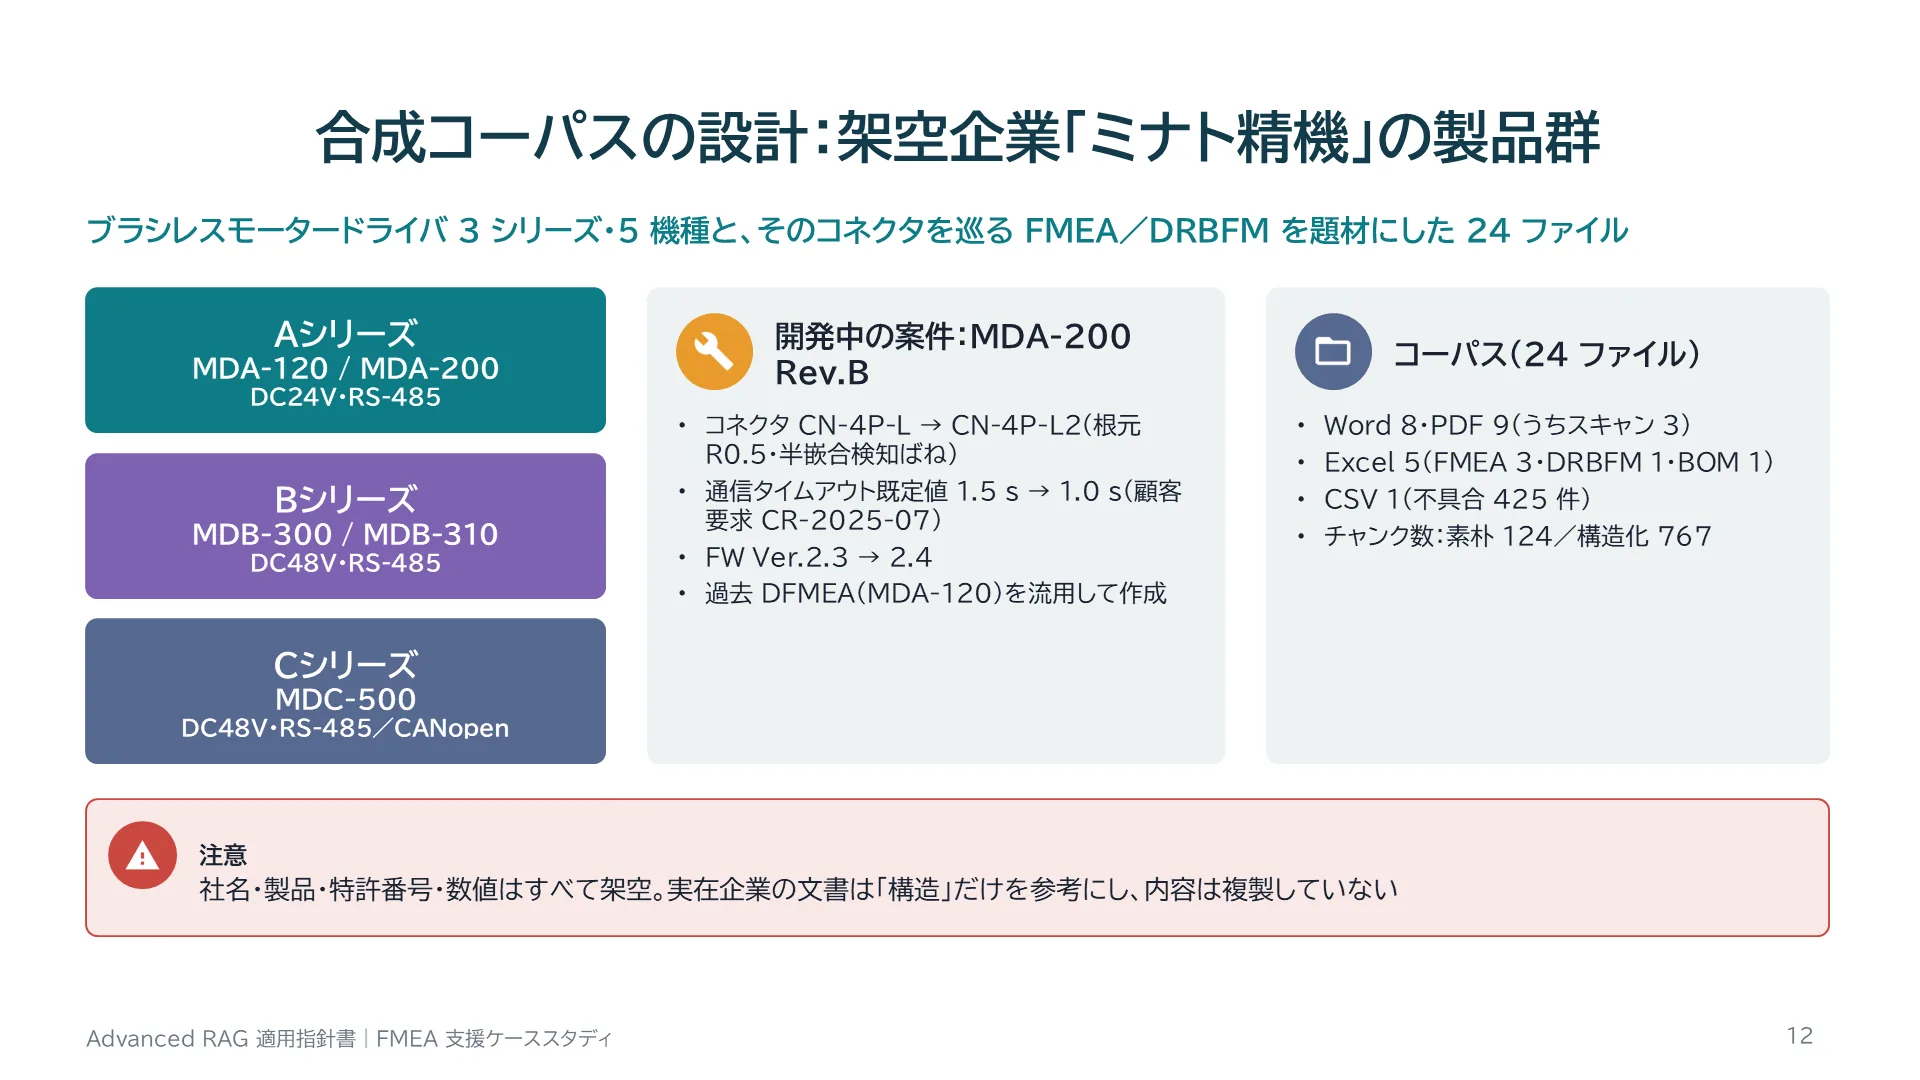
合成コーパスの設計:架空企業「ミナト精機」の製品群
スライド 12 のテキストと解説
合成コーパスの設計:架空企業「ミナト精機」の製品群 ブラシレスモータードライバ 3 シリーズ・5 機種と、そのコネクタを巡る FMEA/DRBFM を題材にした 24 ファイル Aシリーズ MDA-120 / MDA-200 DC24V・RS-485 Bシリーズ MDB-300 / MDB-310 DC48V・RS-485 Cシリーズ MDC-500 DC48V・RS-485/CANopen 開発中の案件:MDA-200 Rev.B コネクタ CN-4P-L → CN-4P-L2(根元 R0.5・半嵌合検知ばね) 通信タイムアウト既定値 1.5 s → 1.0 s(顧客要求 CR-2025-07) FW Ver.2.3 → 2.4 過去 DFMEA(MDA-120)を流用して作成 コーパス(24 ファイル) Word 8・PDF 9(うちスキャン 3) Excel 5(FMEA 3・DRBFM 1・BOM 1) CSV 1(不具合 425 件) チャンク数:素朴 124/構造化 767 注意 社名・製品・特許番号・数値はすべて架空。実在企業の文書は「構造」だけを参考にし、内容は複製していない 12
解説

架空企業ミナト精機(架空)は、ブラシレスモータードライバのAシリーズ(MDA-120、MDA-200)、Bシリーズ(MDB-300、MDB-310)、Cシリーズ(MDC-500)を持っています。いま進めているのは、MDA-200のRev.B改良開発です。変更点は、市場不具合(コネクタの半嵌合による通信断)を受けたコネクタの変更と、顧客要求に合わせた通信タイムアウト既定値の変更です。このDFMEAとDRBFMを作るために、過去のFMEA、不具合DB、試験報告書、社内基準、特許、顧客要求を横断して調べる、という設定です。
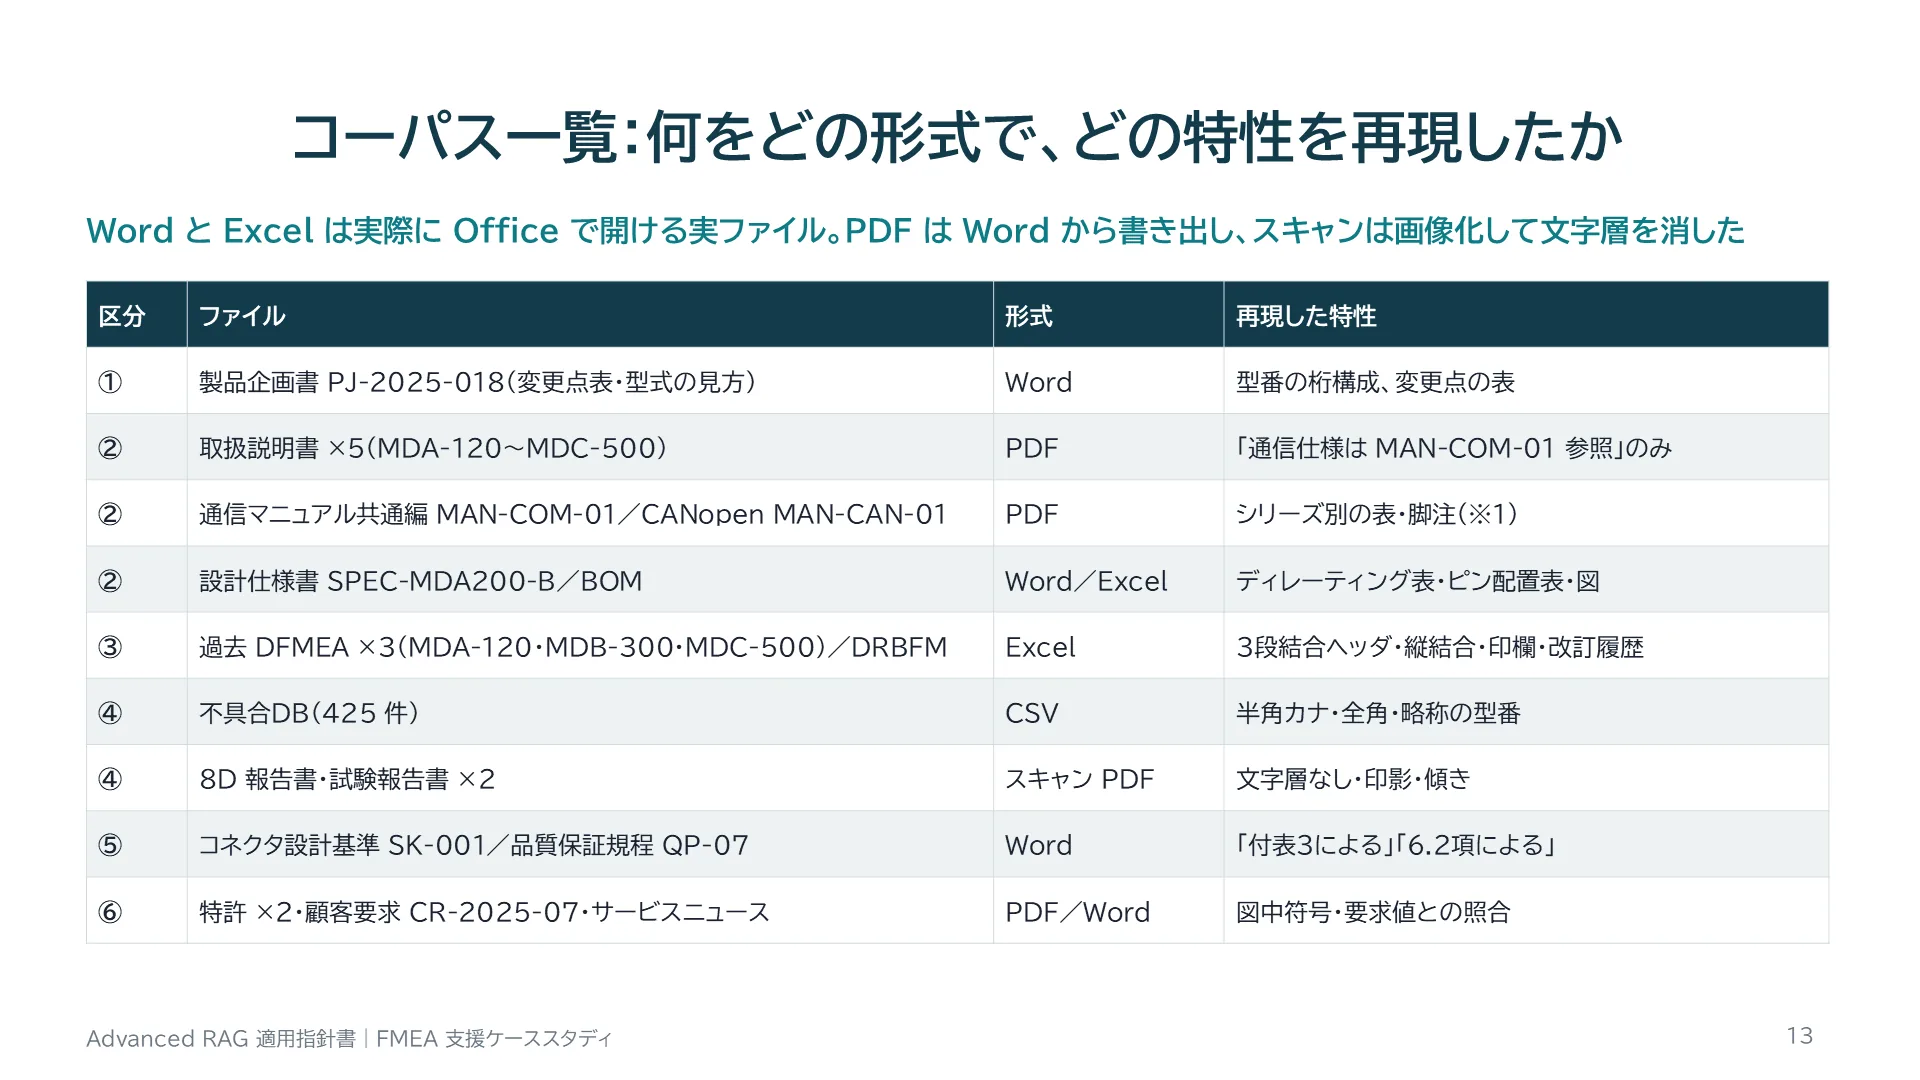
コーパス一覧:何をどの形式で、どの特性を再現したか
スライド 13 のテキストと解説
コーパス一覧:何をどの形式で、どの特性を再現したか Word と Excel は実際に Office で開ける実ファイル。PDF は Word から書き出し、スキャンは画像化して文字層を消した 区分 | ファイル | 形式 | 再現した特性 ① | 製品企画書 PJ-2025-018(変更点表・型式の見方) | Word | 型番の桁構成、変更点の表 ② | 取扱説明書 ×5(MDA-120〜MDC-500) | PDF | 「通信仕様は MAN-COM-01 参照」のみ ② | 通信マニュアル共通編 MAN-COM-01/CANopen MAN-CAN-01 | PDF | シリーズ別の表・脚注(※1) ② | 設計仕様書 SPEC-MDA200-B/BOM | Word/Excel | ディレーティング表・ピン配置表・図 ③ | 過去 DFMEA ×3(MDA-120・MDB-300・MDC-500)/DRBFM | Excel | 3段結合ヘッダ・縦結合・印欄・改訂履歴 ④ | 不具合DB(425 件) | CSV | 半角カナ・全角・略称の型番 ④ | 8D 報告書・試験報告書 ×2 | スキャン PDF | 文字層なし・印影・傾き ⑤ | コネクタ設計基準 SK-001/品質保証規程 QP-07 | Word | 「付表3による」「6.2項による」 ⑥ | 特許 ×2・顧客要求 CR-2025-07・サービスニュース | PDF/Word | 図中符号・要求値との照合 13
解説

コーパスは生成スクリプトで作り、PDFはWordのCOM経由で実際に書き出しています。こうすることで、PDFの表が実物と同じように抽出されにくくなり、現実に近い失敗が起こります。スキャンPDFは、Wordで作った報告書をPDF化し、150dpiの画像にして、傾き、ノイズ、ぼかし、赤い承認印を加えました。
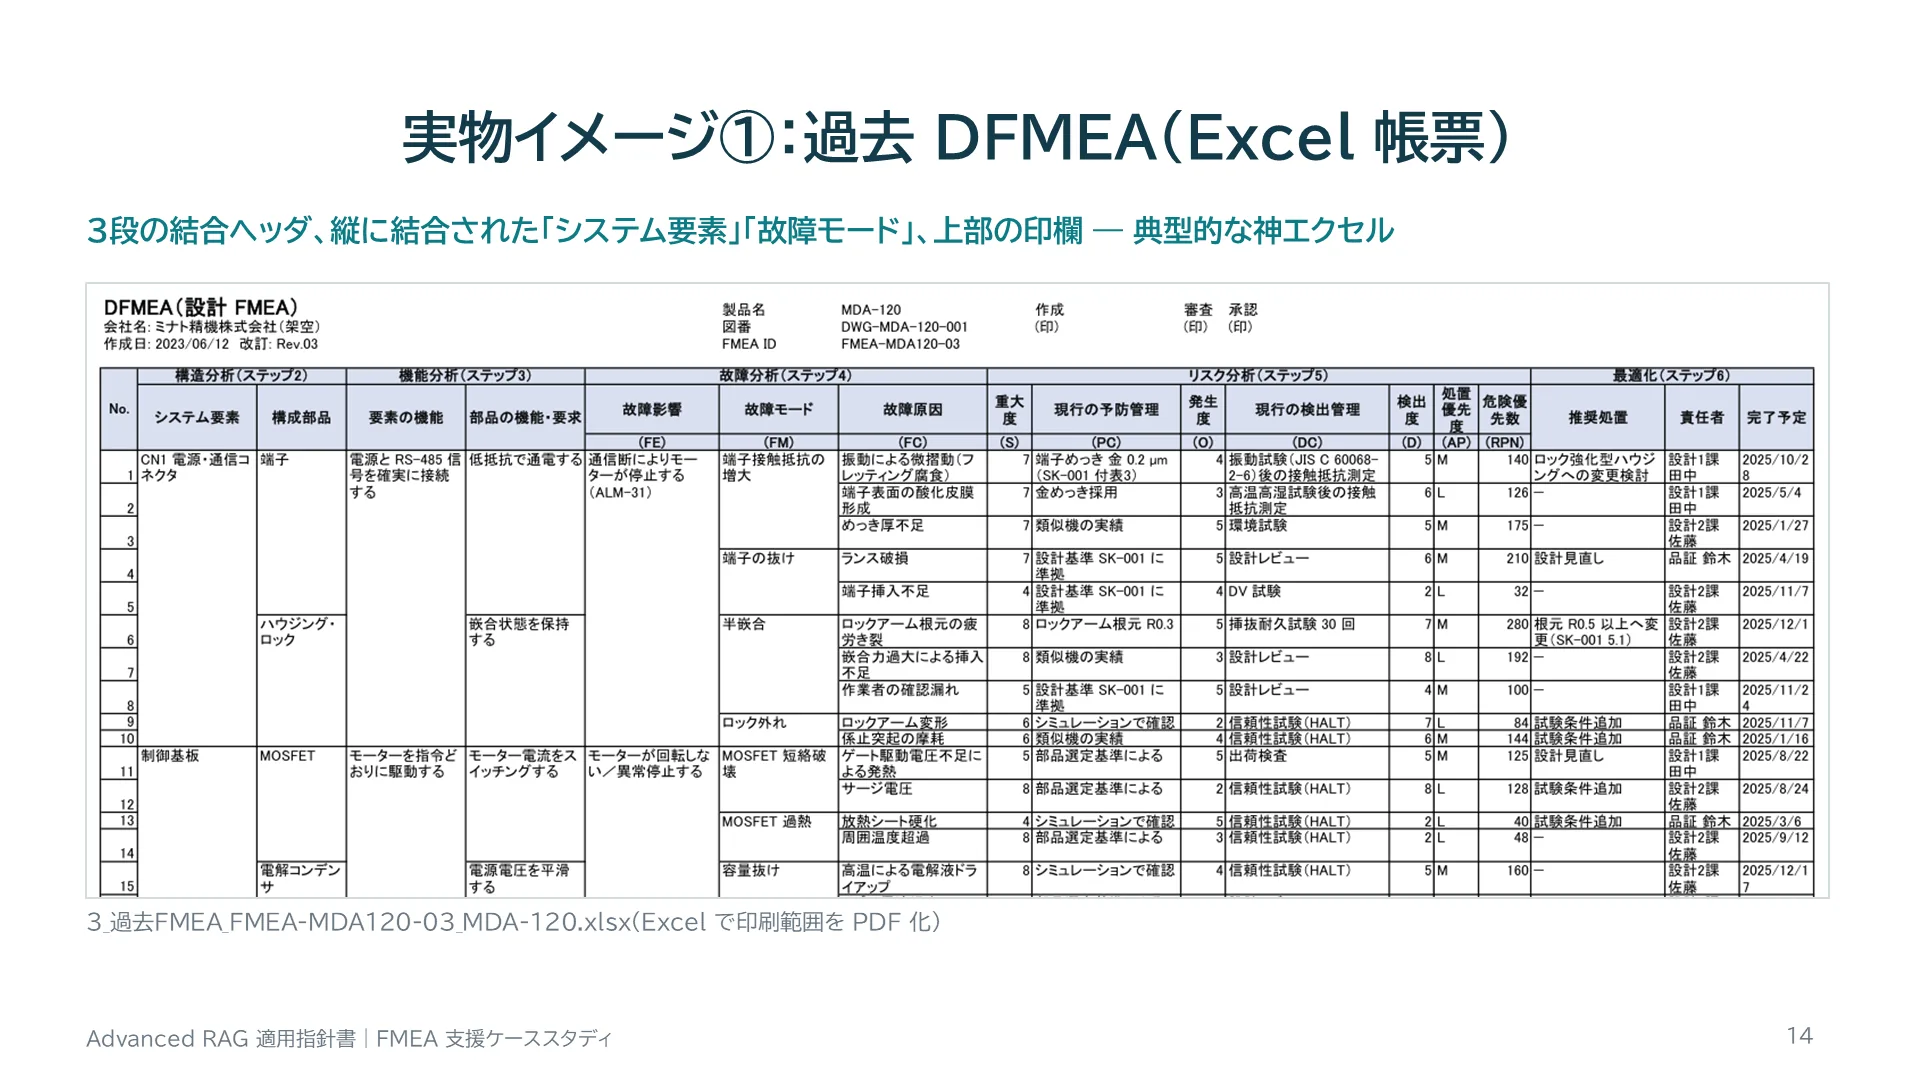
実物イメージ①:過去 DFMEA(Excel 帳票)
スライド 14 のテキストと解説
実物イメージ①:過去 DFMEA(Excel 帳票) 3段の結合ヘッダ、縦に結合された「システム要素」「故障モード」、上部の印欄 ― 典型的な神エクセル 3_過去FMEA_FMEA-MDA120-03_MDA-120.xlsx(Excel で印刷範囲を PDF 化) 14
解説

実際に生成したExcelファイルを印刷イメージで書き出したものです。1段目にステップ名、2段目に列名、3段目に(S)(O)(D)などの略号が入り、システム要素や故障モードは縦に結合されています。人間には読みやすい帳票ですが、セルを左上から順に読むと、4という数字が発生度なのか検出度なのかが分からなくなります。
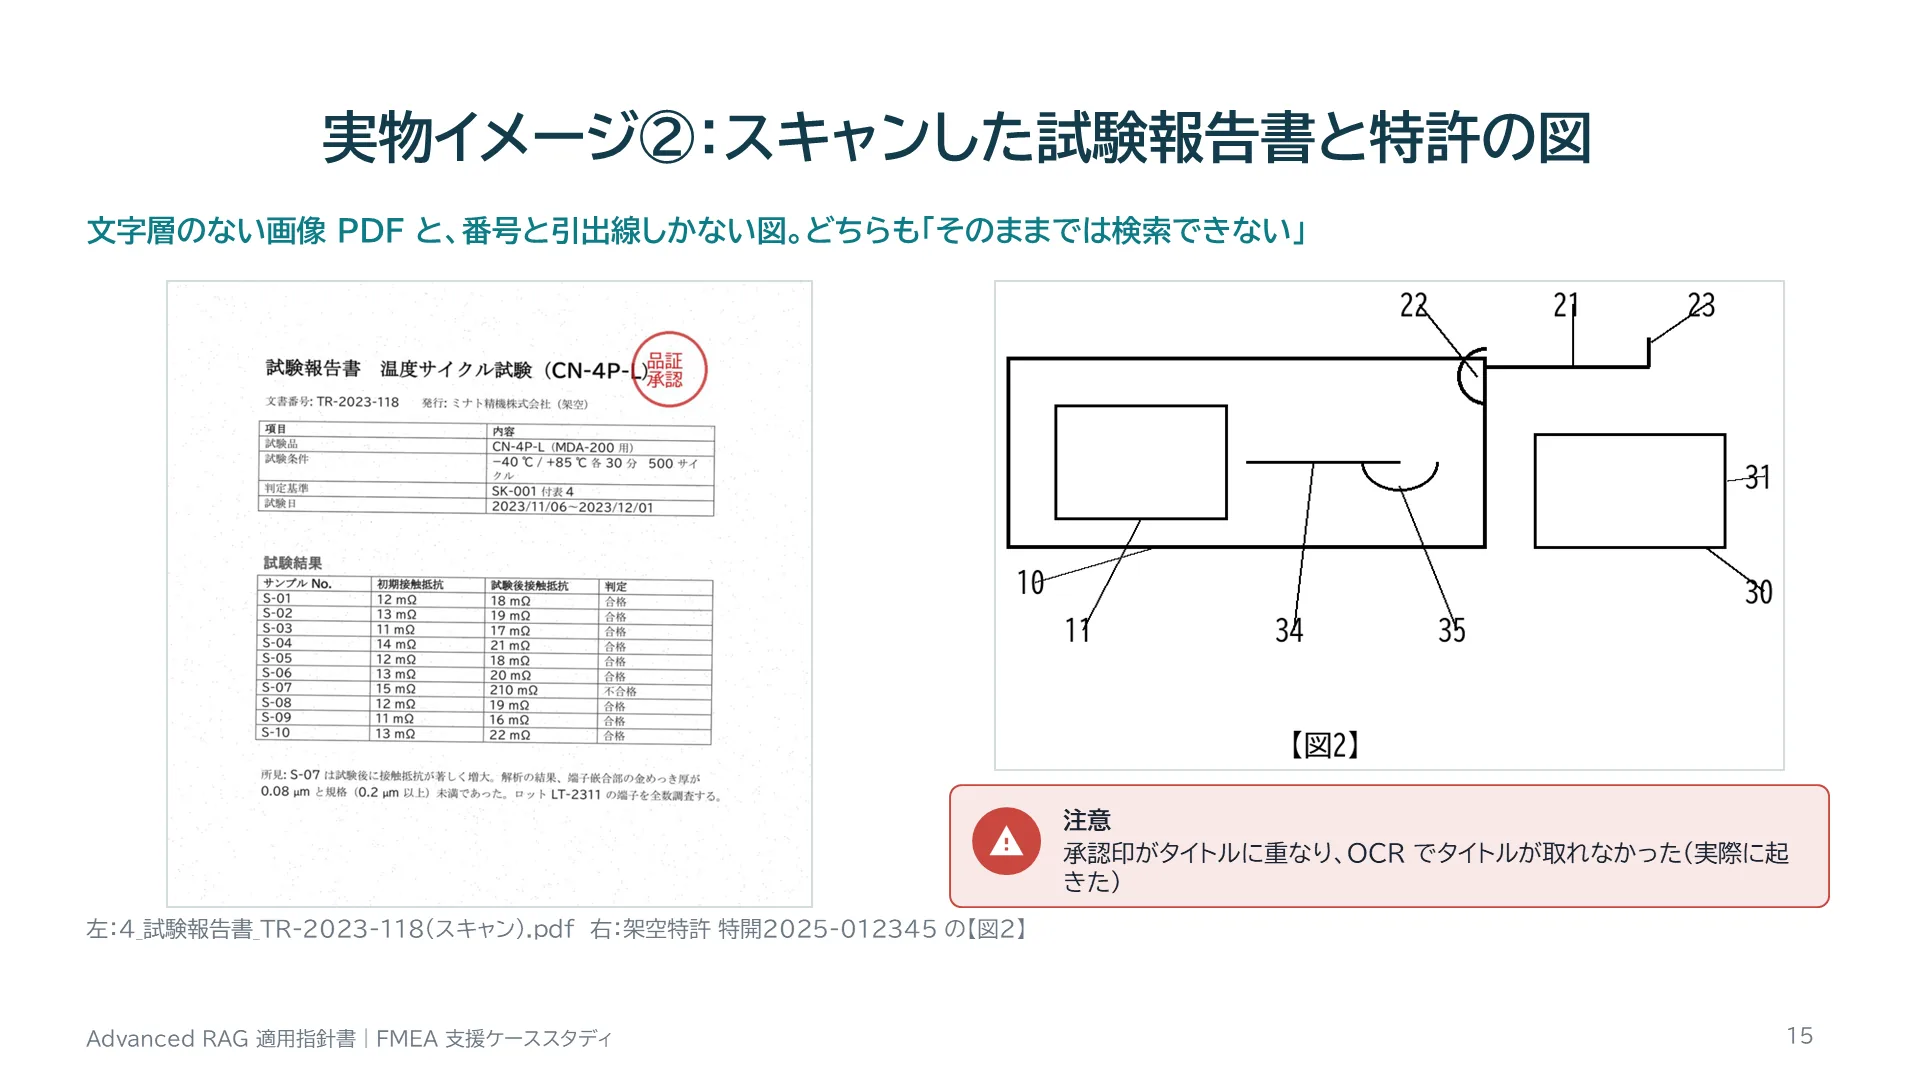
実物イメージ②:スキャンした試験報告書と特許の図
スライド 15 のテキストと解説
実物イメージ②:スキャンした試験報告書と特許の図 文字層のない画像 PDF と、番号と引出線しかない図。どちらも「そのままでは検索できない」 左:4_試験報告書_TR-2023-118(スキャン).pdf 右:架空特許 特開2025-012345 の【図2】 注意 承認印がタイトルに重なり、OCR でタイトルが取れなかった(実際に起きた) 15
解説

左はスキャンした温度サイクル試験報告書です。赤い承認印がタイトルに重なっており、実際にOCRでタイトルが取れませんでした。右は架空特許の図2で、10、21、22などの数字と引出線しかありません。どの数字が何を指すかは、本文と符号の説明を読まないと分かりません。
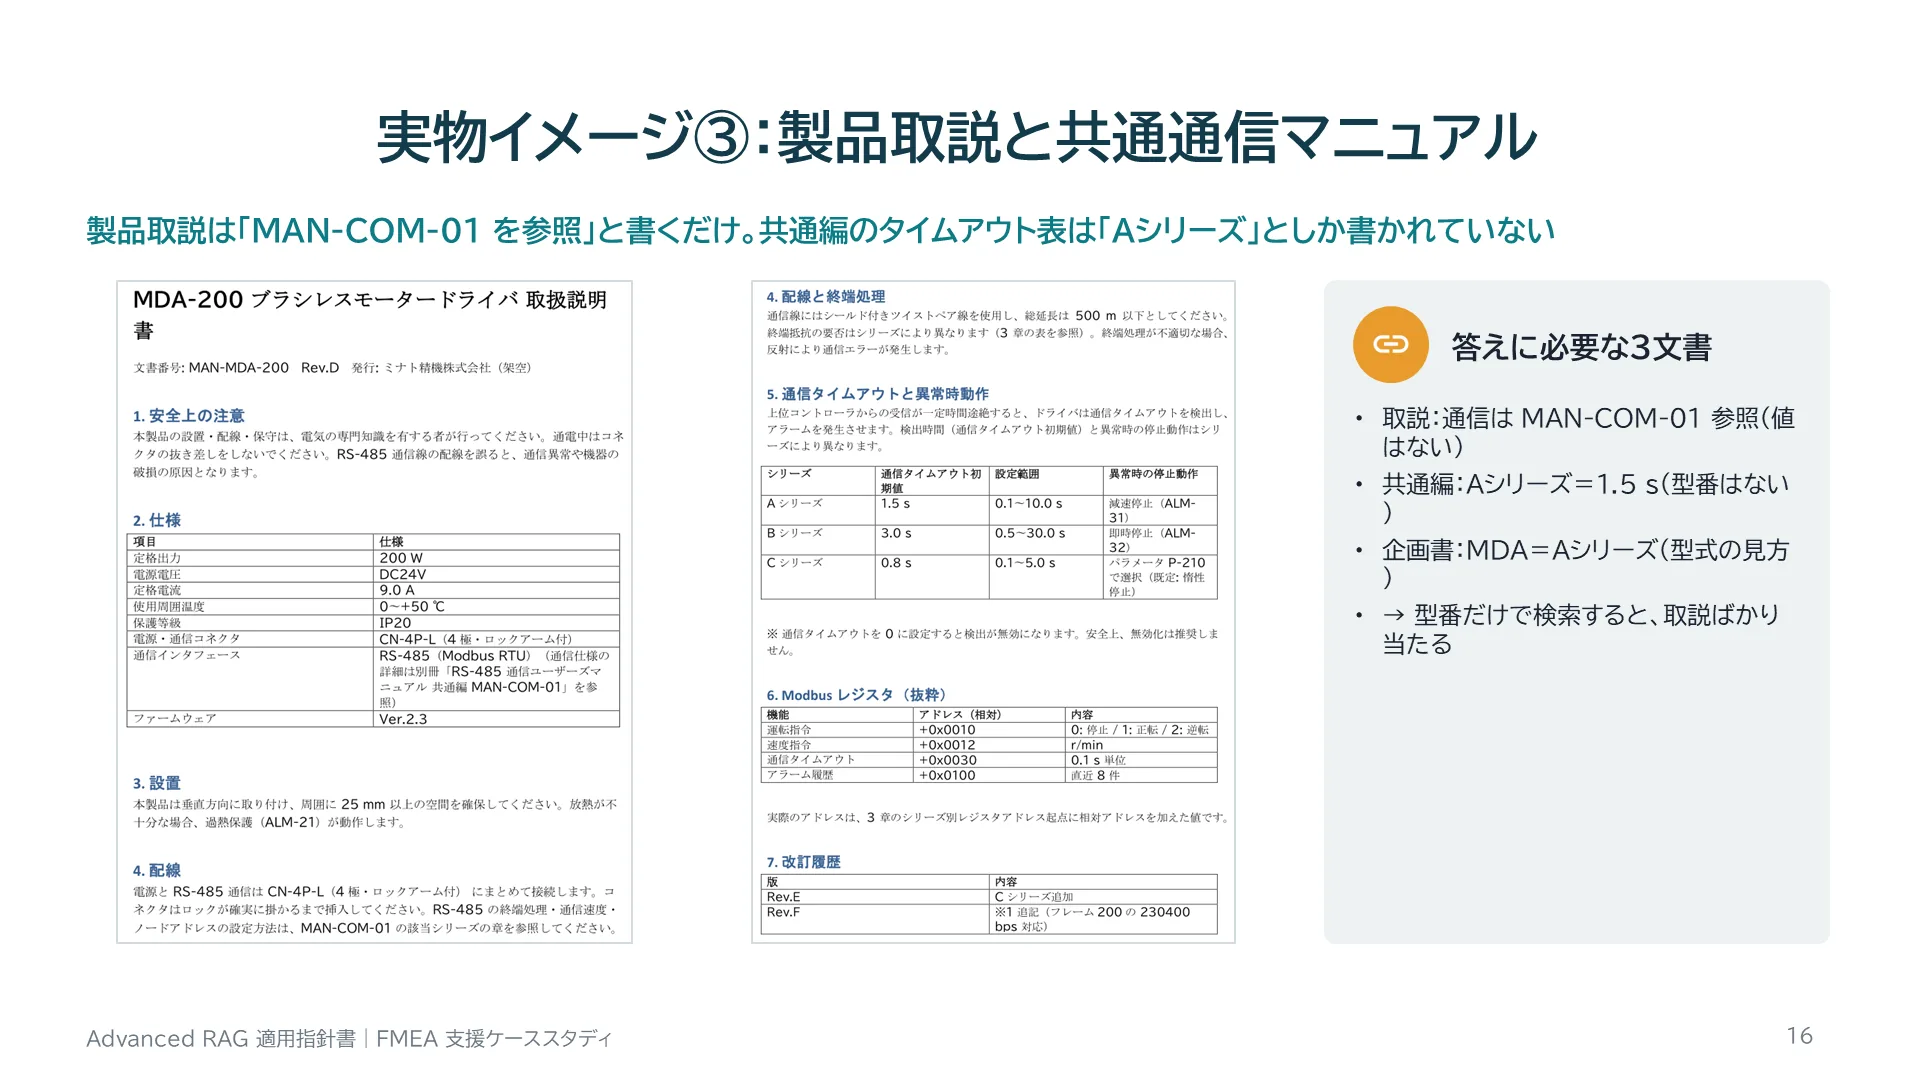
実物イメージ③:製品取説と共通通信マニュアル
スライド 16 のテキストと解説
実物イメージ③:製品取説と共通通信マニュアル 製品取説は「MAN-COM-01 を参照」と書くだけ。共通編のタイムアウト表は「Aシリーズ」としか書かれていない 答えに必要な3文書 取説:通信は MAN-COM-01 参照(値はない) 共通編:Aシリーズ=1.5 s(型番はない) 企画書:MDA=Aシリーズ(型式の見方) → 型番だけで検索すると、取説ばかり当たる 16
解説

左はMDA-200の取扱説明書で、仕様表の通信インタフェース欄に「通信仕様の詳細は別冊MAN-COM-01を参照」とだけ書かれています。右は共通編で、通信タイムアウトの初期値がシリーズ別の表になっています。MDA-200がAシリーズであることは、どちらにも書かれていません。製品企画書の「型式の見方」にだけ「MDA=Aシリーズ」とあります。つまり「MDA-200の通信タイムアウト初期値は?」に答えるには3つの文書をつなぐ必要があります。
PART B
スライド 17 のテキストと解説
PART B 検証の設計 「答えられたか」を主観で判定しないために、質問・必要事実・判定方法・環境を固定する このPartで答えられるようになる問い どんな質問で、何を「答えられた」とみなすか? なぜ LLM の回答ではなく検索結果で評価するのか? どんな環境・モデル・段階で比較したか? 17
解説

Part B は検証の設計です。ここが曖昧だと、後の数字はすべて信用できなくなります。
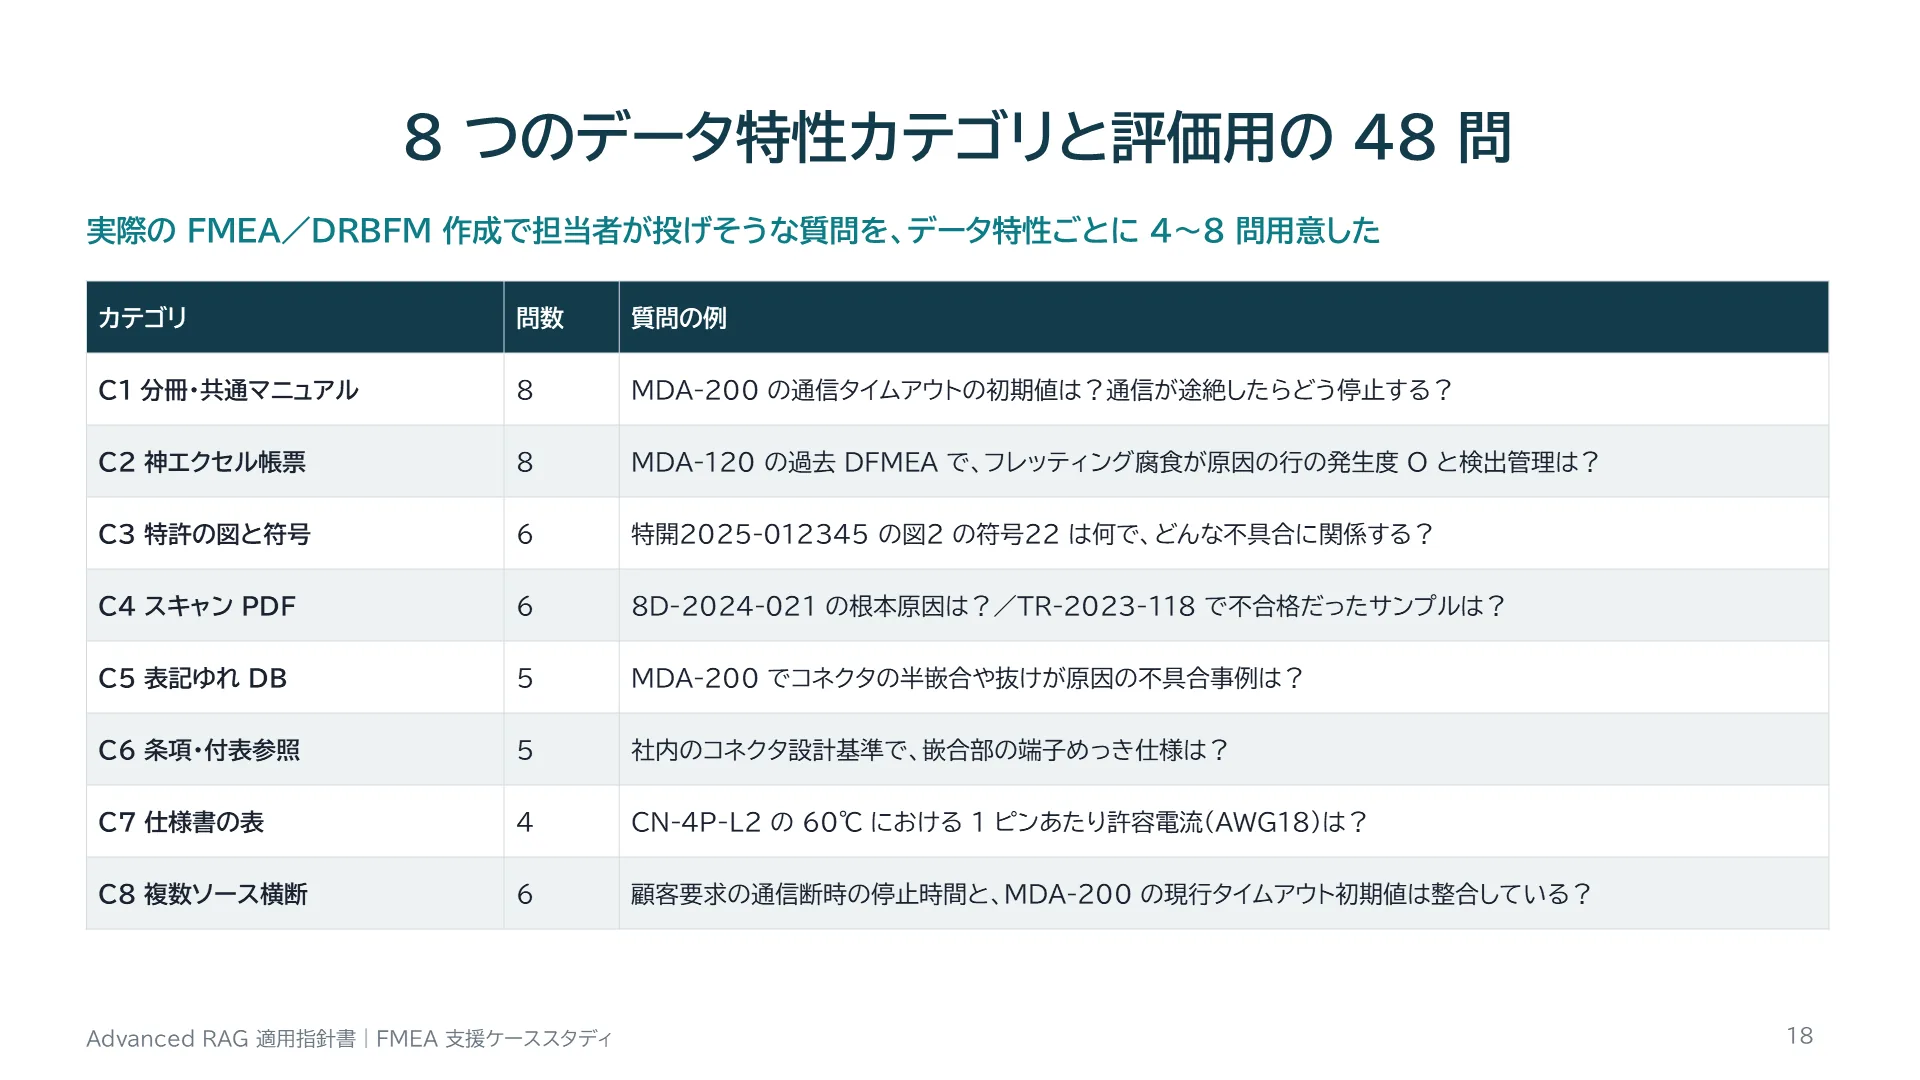
8 つのデータ特性カテゴリと評価用の 48 問
スライド 18 のテキストと解説
8 つのデータ特性カテゴリと評価用の 48 問 実際の FMEA/DRBFM 作成で担当者が投げそうな質問を、データ特性ごとに 4〜8 問用意した カテゴリ | 問数 | 質問の例 C1 分冊・共通マニュアル | 8 | MDA-200 の通信タイムアウトの初期値は?通信が途絶したらどう停止する? C2 神エクセル帳票 | 8 | MDA-120 の過去 DFMEA で、フレッティング腐食が原因の行の発生度 O と検出管理は? C3 特許の図と符号 | 6 | 特開2025-012345 の図2 の符号22 は何で、どんな不具合に関係する? C4 スキャン PDF | 6 | 8D-2024-021 の根本原因は?/TR-2023-118 で不合格だったサンプルは? C5 表記ゆれ DB | 5 | MDA-200 でコネクタの半嵌合や抜けが原因の不具合事例は? C6 条項・付表参照 | 5 | 社内のコネクタ設計基準で、嵌合部の端子めっき仕様は? C7 仕様書の表 | 4 | CN-4P-L2 の 60℃ における 1 ピンあたり許容電流(AWG18)は? C8 複数ソース横断 | 6 | 顧客要求の通信断時の停止時間と、MDA-200 の現行タイムアウト初期値は整合している? 18
解説

評価用の質問は、データ特性ごとに4〜8問、合計48問です。どれもFMEAやDRBFMの作成時に実際に必要になる質問で、たとえば「MDA-120の過去DFMEAで、フレッティング腐食が原因の行の発生度と検出管理は?」「8D-2024-021の根本原因は?」「特開2025-012345の図2の符号22は何で、どんな不具合に関係する?」などです。C8は複数ソースの横断で、顧客要求と製品の初期値の照合のように、2つ以上の文書の根拠が必要です。
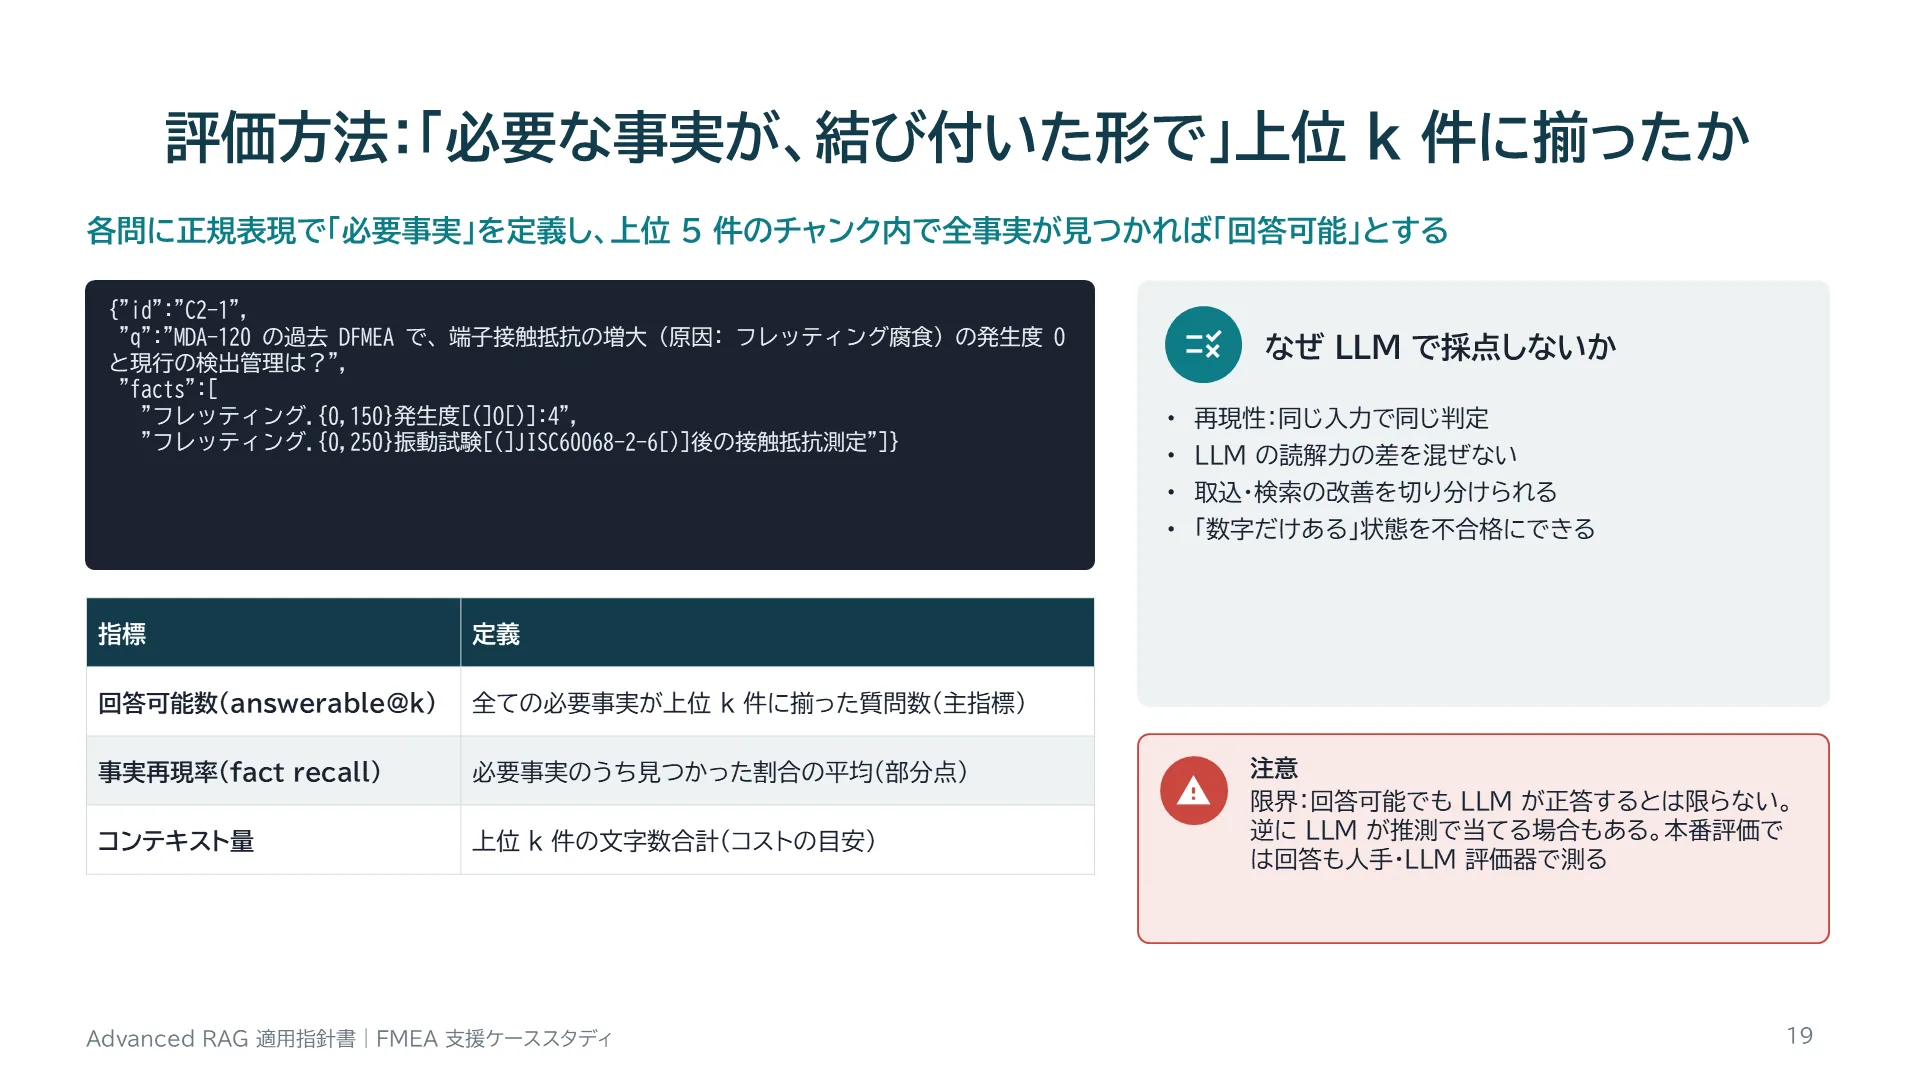
評価方法:「必要な事実が、結び付いた形で」上位 k 件に揃ったか
スライド 19 のテキストと解説
評価方法:「必要な事実が、結び付いた形で」上位 k 件に揃ったか 各問に正規表現で「必要事実」を定義し、上位 5 件のチャンク内で全事実が見つかれば「回答可能」とする {"id":"C2-1", "q":"MDA-120 の過去 DFMEA で、端子接触抵抗の増大(原因: フレッティング腐食)の発生度 O と現行の検出管理は?", "facts":[ "フレッティング.{0,150}発生度[(]O[)]:4", "フレッティング.{0,250}振動試験[(]JISC60068-2-6[)]後の接触抵抗測定"]} 指標 | 定義 回答可能数(answerable@k) | 全ての必要事実が上位 k 件に揃った質問数(主指標) 事実再現率(fact recall) | 必要事実のうち見つかった割合の平均(部分点) コンテキスト量 | 上位 k 件の文字数合計(コストの目安) なぜ LLM で採点しないか 再現性:同じ入力で同じ判定 LLM の読解力の差を混ぜない 取込・検索の改善を切り分けられる 「数字だけある」状態を不合格にできる 注意 限界:回答可能でも LLM が正答するとは限らない。逆に LLM が推測で当てる場合もある。本番評価では回答も人手・LLM 評価器で測る 19
解説

評価はLLMの回答ではなく、LLMに渡すコンテキスト、つまり検索結果の上位k件で行いました。各質問に、回答に必要な事実を正規表現で定義します。ポイントは「結び付き」も判定に含めることです。たとえばFMEAの質問では、単に数字の4があるだけでなく「フレッティング…発生度(O):4」のように、故障原因と列名と値が1つのチャンクの中で結び付いている必要があります。文字列は判定前にNFKC正規化し、空白を除去しています。LLMを使わない理由は3つあります。再現できること、LLMの読解力の差が混ざらないこと、そして検索段階の改善効果を切り分けられることです。限界として、ここで回答可能となっても、LLMが正しく答えるとは限りません。
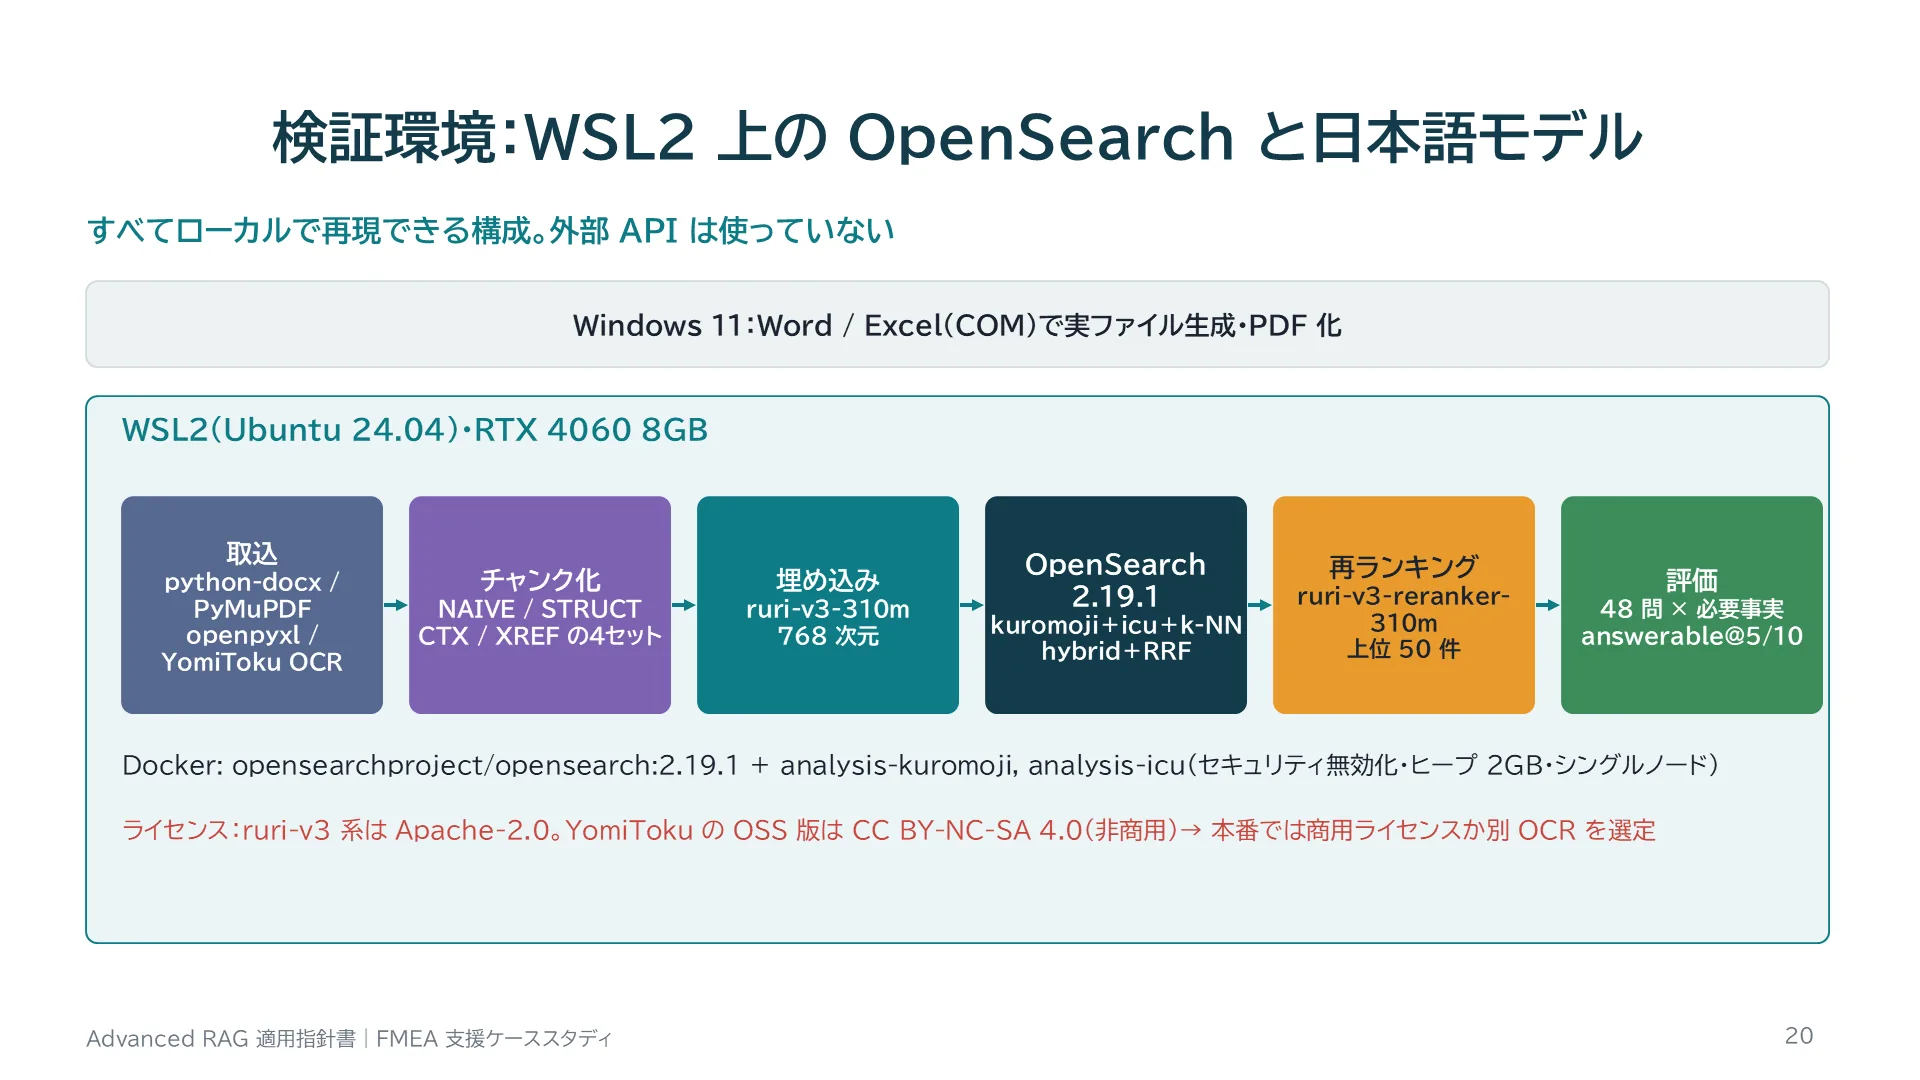
検証環境:WSL2 上の OpenSearch と日本語モデル
スライド 20 のテキストと解説
検証環境:WSL2 上の OpenSearch と日本語モデル すべてローカルで再現できる構成。外部 API は使っていない Windows 11:Word / Excel(COM)で実ファイル生成・PDF 化 WSL2(Ubuntu 24.04)・RTX 4060 8GB 取込 python-docx / PyMuPDF openpyxl / YomiToku OCR チャンク化 NAIVE / STRUCT CTX / XREF の4セット 埋め込み ruri-v3-310m 768 次元 OpenSearch 2.19.1 kuromoji+icu+k-NN hybrid+RRF 再ランキング ruri-v3-reranker-310m 上位 50 件 評価 48 問 × 必要事実 answerable@5/10 Docker: opensearchproject/opensearch:2.19.1 + analysis-kuromoji, analysis-icu(セキュリティ無効化・ヒープ 2GB・シングルノード) ライセンス:ruri-v3 系は Apache-2.0。YomiToku の OSS 版は CC BY-NC-SA 4.0(非商用)→ 本番では商用ライセンスか別 OCR を選定 20
解説

検証はWindows 11上のWSL2(Ubuntu 24.04)で行いました。OpenSearch 2.19.1の公式Dockerイメージに、日本語形態素解析のanalysis-kuromojiと、NFKC正規化のためのanalysis-icuを追加しています。2.19はハイブリッド検索の順位融合RRFに対応した最初の版です。埋め込みは日本語特化のcl-nagoya/ruri-v3-310m(768次元)、再ランキングはcl-nagoya/ruri-v3-reranker-310mで、どちらもApache-2.0ライセンスです。OCRはYomiTokuで、表構造を保ったMarkdownを出力しますが、OSS版は非商用ライセンスなので、本番では商用ライセンスか別のOCRを選びます。GPUはRTX 4060(8GB)で、索引作成と全評価の実行は数分で終わります。
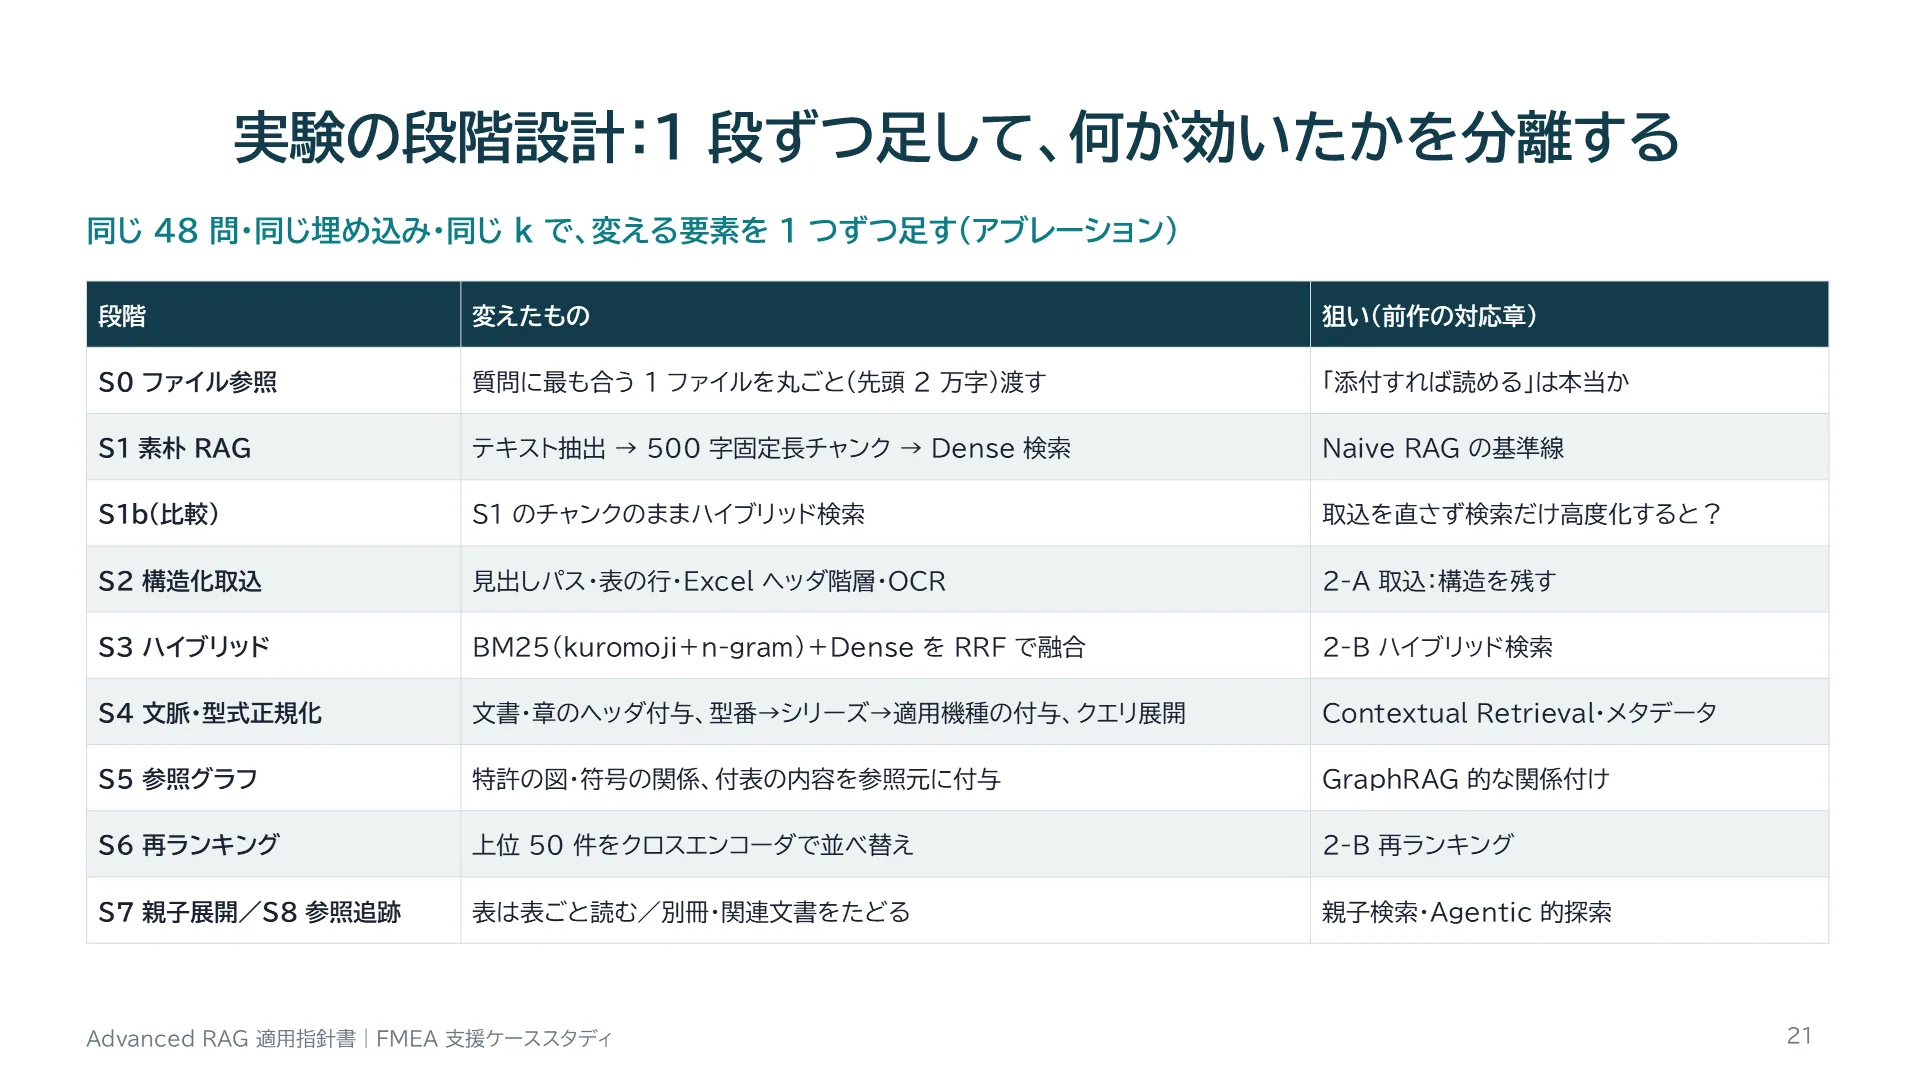
実験の段階設計:1 段ずつ足して、何が効いたかを分離する
スライド 21 のテキストと解説
実験の段階設計:1 段ずつ足して、何が効いたかを分離する 同じ 48 問・同じ埋め込み・同じ k で、変える要素を 1 つずつ足す(アブレーション) 段階 | 変えたもの | 狙い(前作の対応章) S0 ファイル参照 | 質問に最も合う 1 ファイルを丸ごと(先頭 2 万字)渡す | 「添付すれば読める」は本当か S1 素朴 RAG | テキスト抽出 → 500 字固定長チャンク → Dense 検索 | Naive RAG の基準線 S1b(比較) | S1 のチャンクのままハイブリッド検索 | 取込を直さず検索だけ高度化すると? S2 構造化取込 | 見出しパス・表の行・Excel ヘッダ階層・OCR | 2-A 取込:構造を残す S3 ハイブリッド | BM25(kuromoji+n-gram)+Dense を RRF で融合 | 2-B ハイブリッド検索 S4 文脈・型式正規化 | 文書・章のヘッダ付与、型番→シリーズ→適用機種の付与、クエリ展開 | Contextual Retrieval・メタデータ S5 参照グラフ | 特許の図・符号の関係、付表の内容を参照元に付与 | GraphRAG 的な関係付け S6 再ランキング | 上位 50 件をクロスエンコーダで並べ替え | 2-B 再ランキング S7 親子展開/S8 参照追跡 | 表は表ごと読む/別冊・関連文書をたどる | 親子検索・Agentic 的探索 21
解説

S0のファイル参照から始めて、1段ずつ要素を足していきます。前作で学んだ「2つの変数を同時に動かさない」原則に従い、各段では1つだけを変えています。S1bは、素朴なチャンクのままハイブリッド検索だけを足した比較用の段です。「取込を直さずに検索だけ高度化するとどうなるか」を確かめるために入れています。
PART C
スライド 22 のテキストと解説
PART C ステップ別の改善(S0〜S8) 1 ステップ 1〜3 スライドで、「何を変えたか → 何問変わったか → なぜか → 何を学ぶか」を追う このPartで答えられるようになる問い 「ファイルを渡す」と「素朴な RAG」は何が違い、何が同じか? 構造化取込・ハイブリッド・文脈付与は、どのデータに効いたか? 効かなかった打ち手は、なぜ効かなかったか? 22
解説

Part C が本資料の中心です。上部のS0〜S8の表示で、いまどの段階かを示しています。
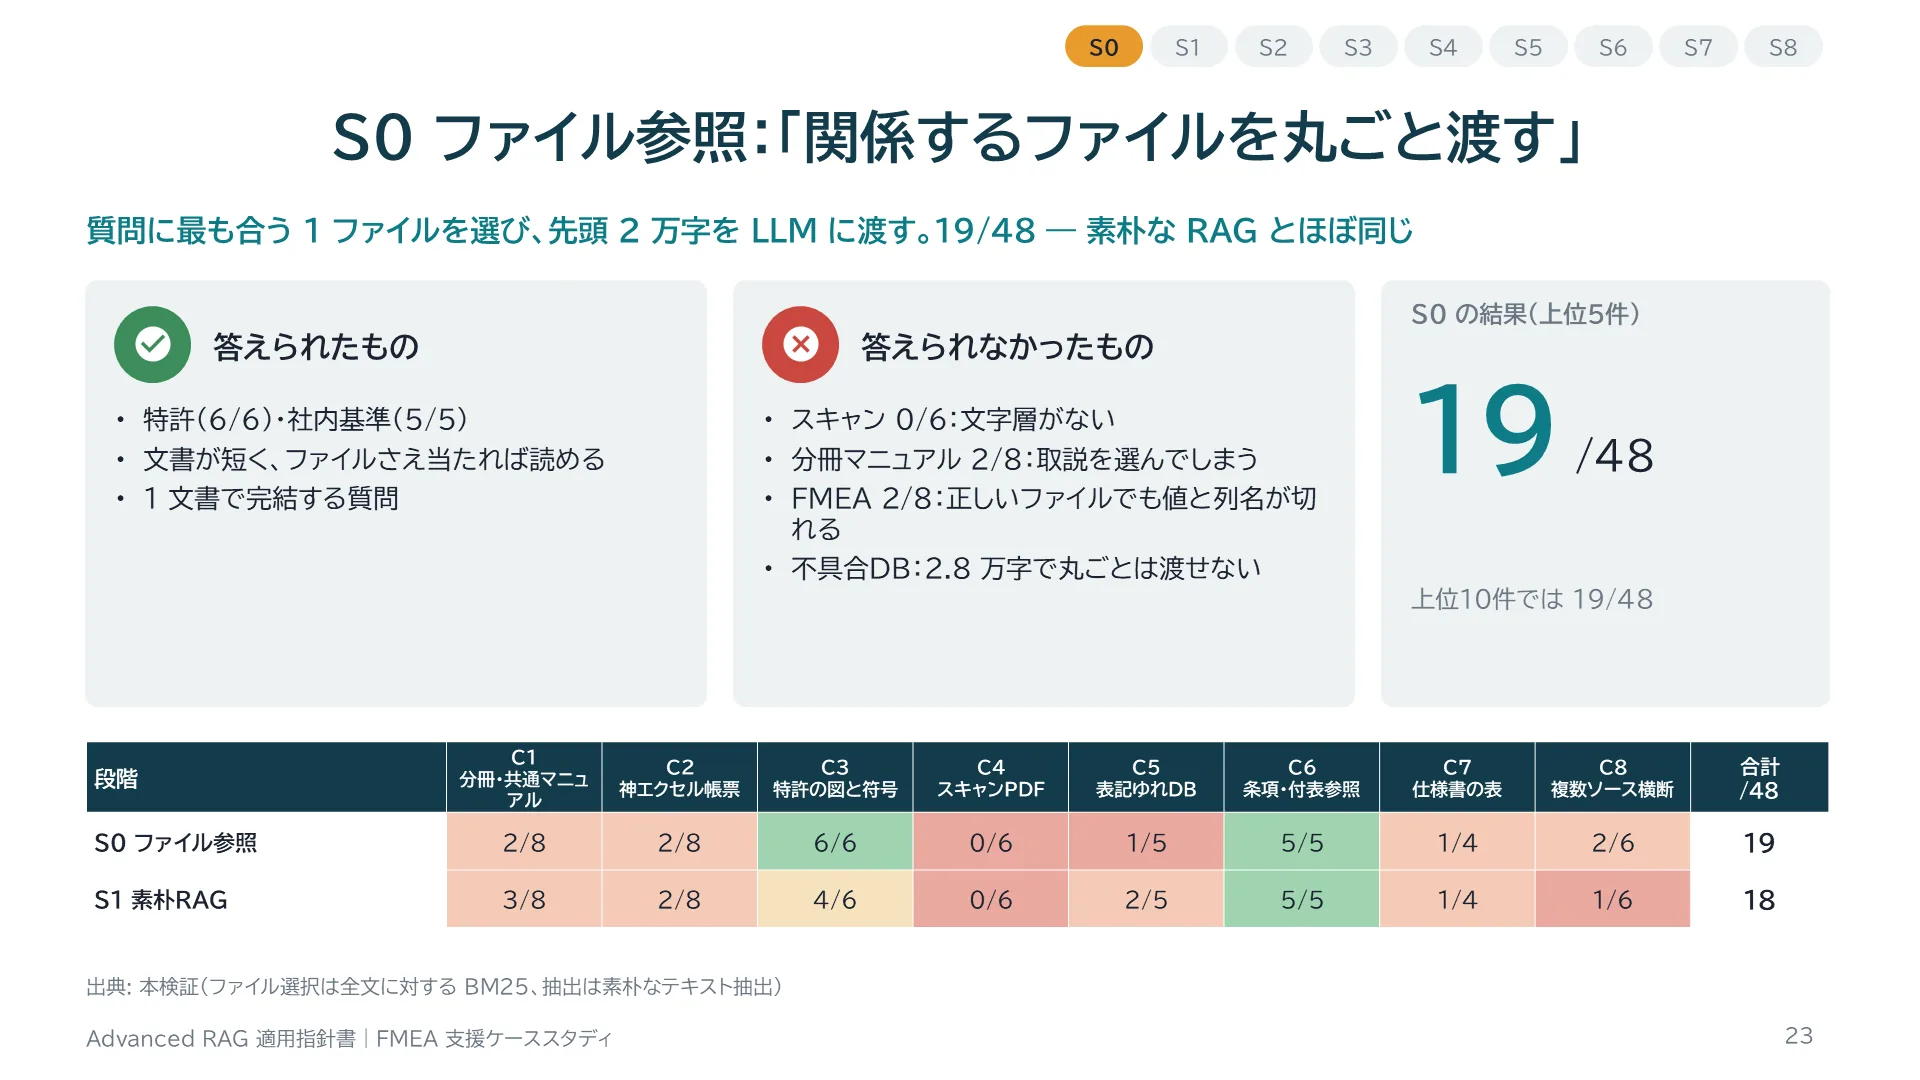
S0 ファイル参照:「関係するファイルを丸ごと渡す」
スライド 23 のテキストと解説
S0 ファイル参照:「関係するファイルを丸ごと渡す」 質問に最も合う 1 ファイルを選び、先頭 2 万字を LLM に渡す。19/48 ― 素朴な RAG とほぼ同じ 出典: 本検証(ファイル選択は全文に対する BM25、抽出は素朴なテキスト抽出) S0 S1 S2 S3 S4 S5 S6 S7 S8 答えられたもの 特許(6/6)・社内基準(5/5) 文書が短く、ファイルさえ当たれば読める 1 文書で完結する質問 答えられなかったもの スキャン 0/6:文字層がない 分冊マニュアル 2/8:取説を選んでしまう FMEA 2/8:正しいファイルでも値と列名が切れる 不具合DB:2.8 万字で丸ごとは渡せない S0 の結果(上位5件) 19 /48 上位10件では 19/48 段階 | C1 分冊・共通マニュアル | C2 神エクセル帳票 | C3 特許の図と符号 | C4 スキャンPDF | C5 表記ゆれDB | C6 条項・付表参照 | C7 仕様書の表 | C8 複数ソース横断 | 合計 /48 S0 ファイル参照 | 2/8 | 2/8 | 6/6 | 0/6 | 1/5 | 5/5 | 1/4 | 2/6 | 19 S1 素朴RAG | 3/8 | 2/8 | 4/6 | 0/6 | 2/5 | 5/5 | 1/4 | 1/6 | 18 23
解説

S0は、チャット画面にファイルを添付して質問するような使い方を模擬しています。質問に最も合う1ファイルをBM25で選び、そのファイルから素朴に抽出したテキストの先頭2万字を渡します。結果は48問中19問でした。特許(C3)と社内基準(C6)は、ファイルさえ当たれば中身が短いので答えられます。一方、スキャンPDF(C4)は文字層がないので0問、分冊マニュアル(C1)はファイル自体を取り違え、FMEA(C2)は正しいファイルを選んでも、数字と列名の結び付きが失われていて答えられません。
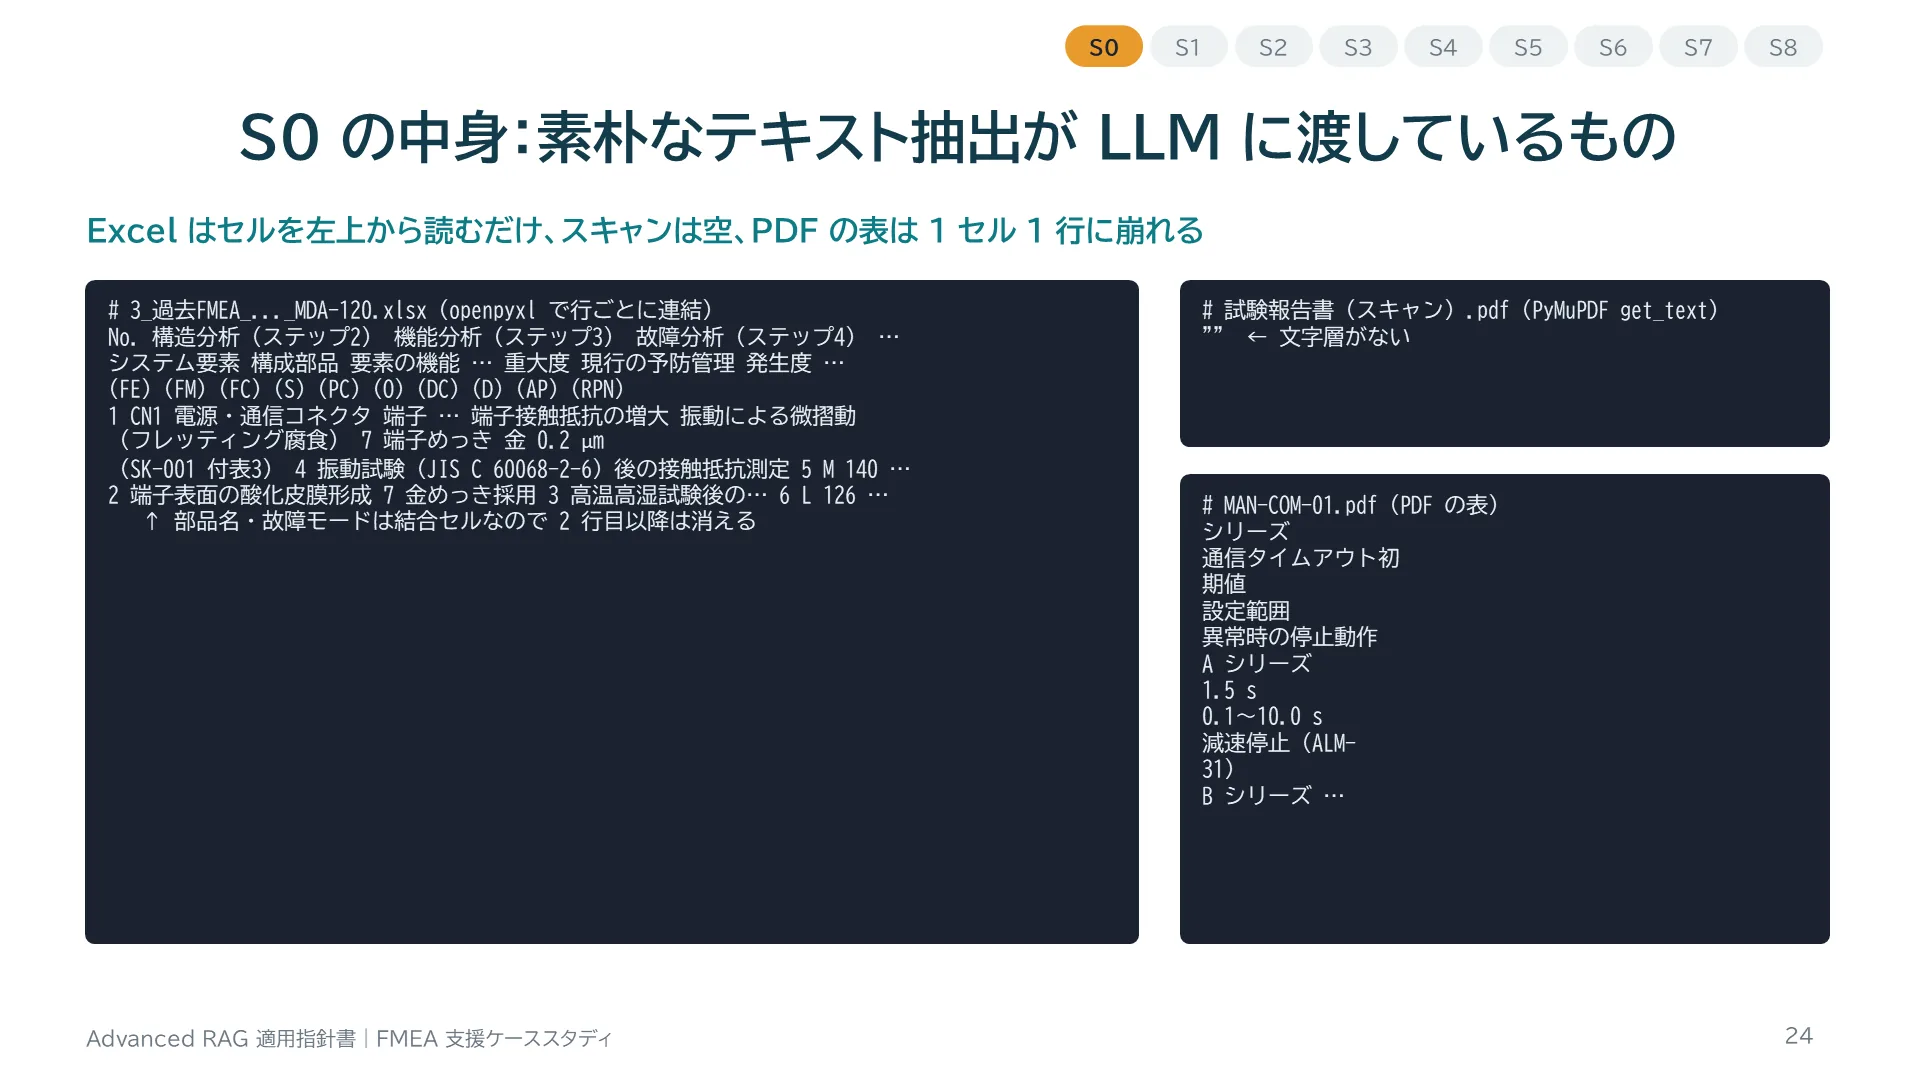
S0 の中身:素朴なテキスト抽出が LLM に渡しているもの
スライド 24 のテキストと解説
S0 の中身:素朴なテキスト抽出が LLM に渡しているもの Excel はセルを左上から読むだけ、スキャンは空、PDF の表は 1 セル 1 行に崩れる S0 S1 S2 S3 S4 S5 S6 S7 S8 # 3_過去FMEA_..._MDA-120.xlsx(openpyxl で行ごとに連結) No. 構造分析(ステップ2) 機能分析(ステップ3) 故障分析(ステップ4) … システム要素 構成部品 要素の機能 … 重大度 現行の予防管理 発生度 … (FE) (FM) (FC) (S) (PC) (O) (DC) (D) (AP) (RPN) 1 CN1 電源・通信コネクタ 端子 … 端子接触抵抗の増大 振動による微摺動 (フレッティング腐食) 7 端子めっき 金 0.2 µm (SK-001 付表3) 4 振動試験(JIS C 60068-2-6)後の接触抵抗測定 5 M 140 … 2 端子表面の酸化皮膜形成 7 金めっき採用 3 高温高湿試験後の… 6 L 126 … ↑ 部品名・故障モードは結合セルなので 2 行目以降は消える # 試験報告書(スキャン).pdf(PyMuPDF get_text) "" ← 文字層がない # MAN-COM-01.pdf(PDF の表) シリーズ 通信タイムアウト初 期値 設定範囲 異常時の停止動作 A シリーズ 1.5 s 0.1〜10.0 s 減速停止(ALM- 31) B シリーズ … 24
解説

素朴なテキスト抽出が実際に出力したものです。左はFMEAのExcelで、ヘッダの行と値の行が離れ、「7 端子めっき 金 0.2 µm」の次の行に「4 振動試験…」と続きます。この4が発生度だと分かるには、数十行上の3段ヘッダを数えて対応付ける必要があります。結合セルの値は左上のセルにしか入っていないので、2行目以降は「CN1コネクタ」という部品名も消えています。右上のスキャンPDFは、文字層がないので空文字です。右下の共通マニュアルの表は、1セル1行に崩れ、どの値がどのシリーズかは列の順番から推測するしかありません。
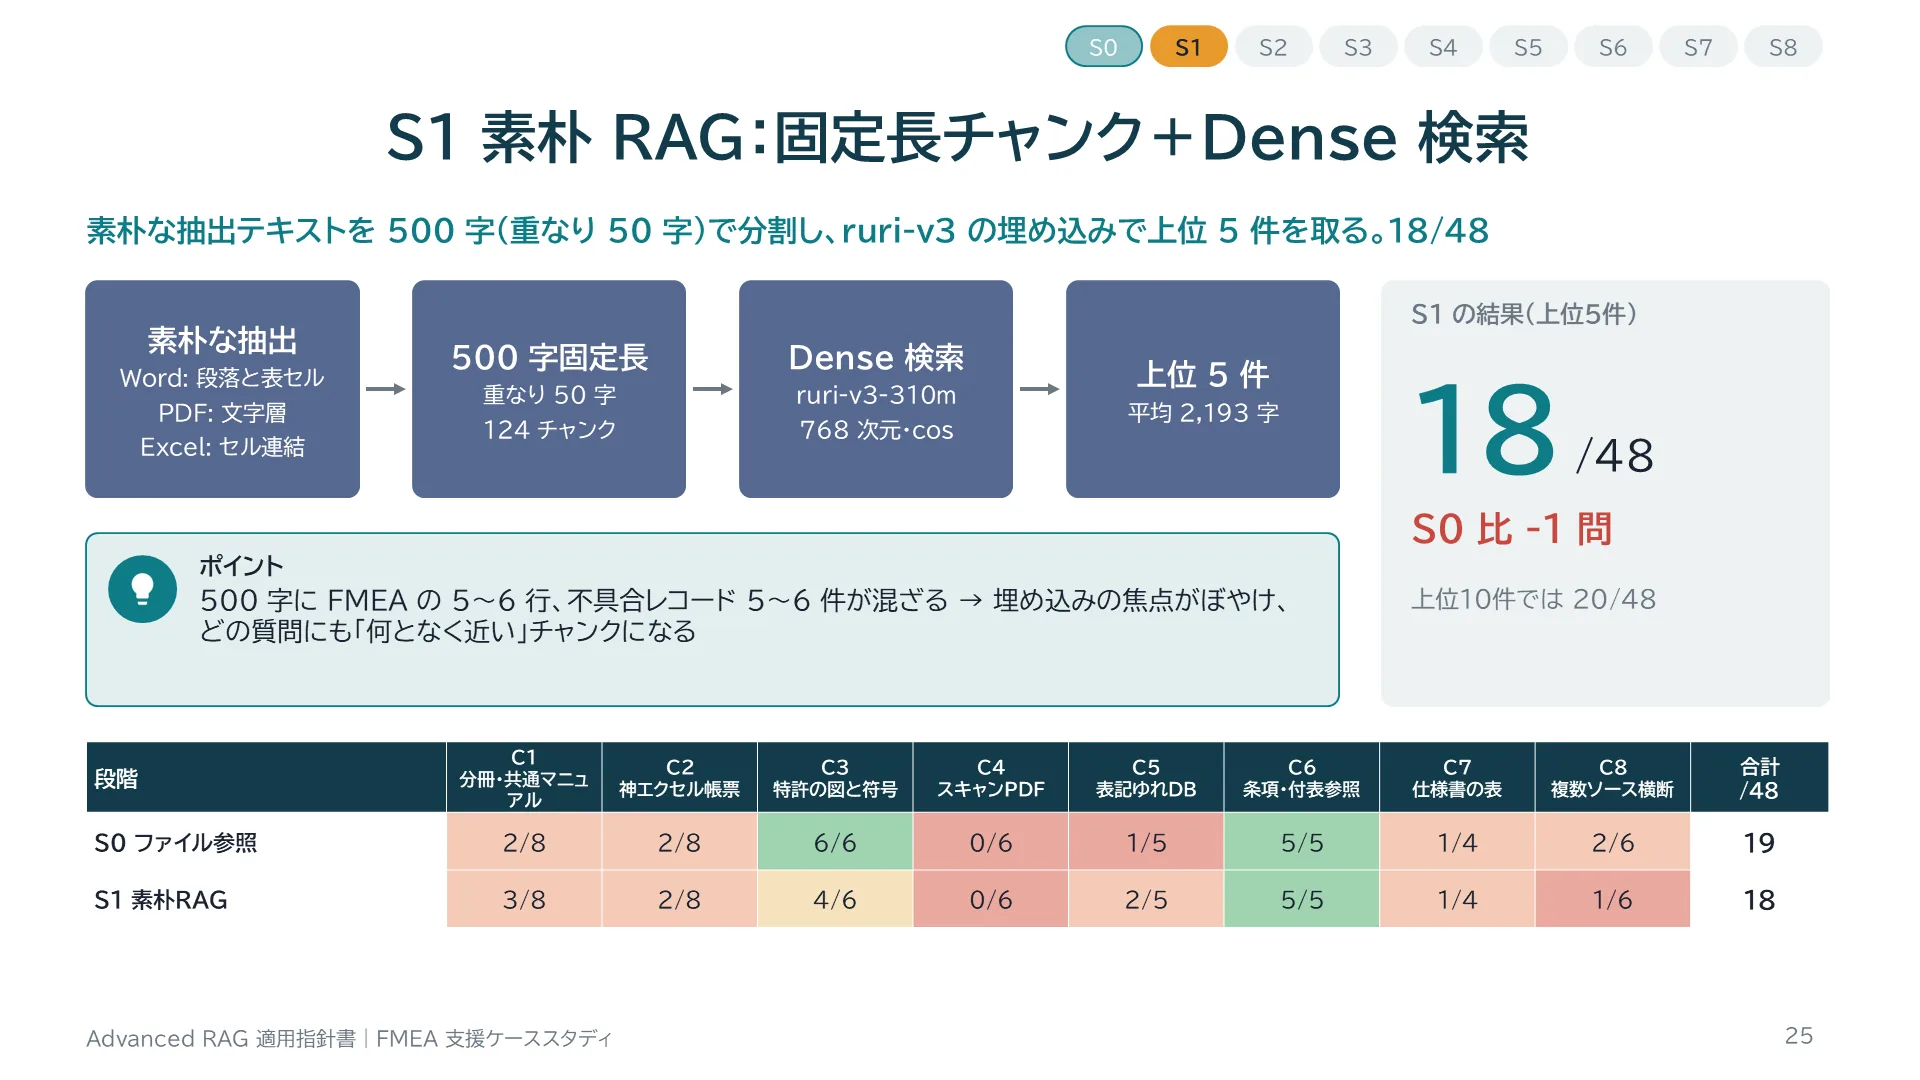
S1 素朴 RAG:固定長チャンク+Dense 検索
スライド 25 のテキストと解説
S1 素朴 RAG:固定長チャンク+Dense 検索 素朴な抽出テキストを 500 字(重なり 50 字)で分割し、ruri-v3 の埋め込みで上位 5 件を取る。18/48 S0 S1 S2 S3 S4 S5 S6 S7 S8 素朴な抽出 Word: 段落と表セル PDF: 文字層 Excel: セル連結 500 字固定長 重なり 50 字 124 チャンク Dense 検索 ruri-v3-310m 768 次元・cos 上位 5 件 平均 2,193 字 ポイント 500 字に FMEA の 5〜6 行、不具合レコード 5〜6 件が混ざる → 埋め込みの焦点がぼやけ、どの質問にも「何となく近い」チャンクになる S1 の結果(上位5件) 18 /48 S0 比 -1 問 上位10件では 20/48 段階 | C1 分冊・共通マニュアル | C2 神エクセル帳票 | C3 特許の図と符号 | C4 スキャンPDF | C5 表記ゆれDB | C6 条項・付表参照 | C7 仕様書の表 | C8 複数ソース横断 | 合計 /48 S0 ファイル参照 | 2/8 | 2/8 | 6/6 | 0/6 | 1/5 | 5/5 | 1/4 | 2/6 | 19 S1 素朴RAG | 3/8 | 2/8 | 4/6 | 0/6 | 2/5 | 5/5 | 1/4 | 1/6 | 18 25
解説

S1は典型的な最初のPoCです。S0と同じ素朴な抽出をして、500字ずつ分割し、日本語埋め込みモデルruri-v3-310mでベクトル化し、質問に近い上位5件を渡します。結果は18問で、S0とほぼ同じです。チャンク数は24ファイルでわずか124個でした。500字に複数のFMEA行や複数の不具合レコードが混ざるため、埋め込みの焦点がぼやけます。ファイル参照より文脈は短くなりますが、取込段階で失われた情報は戻らないので、正答できる質問の範囲は変わりません。
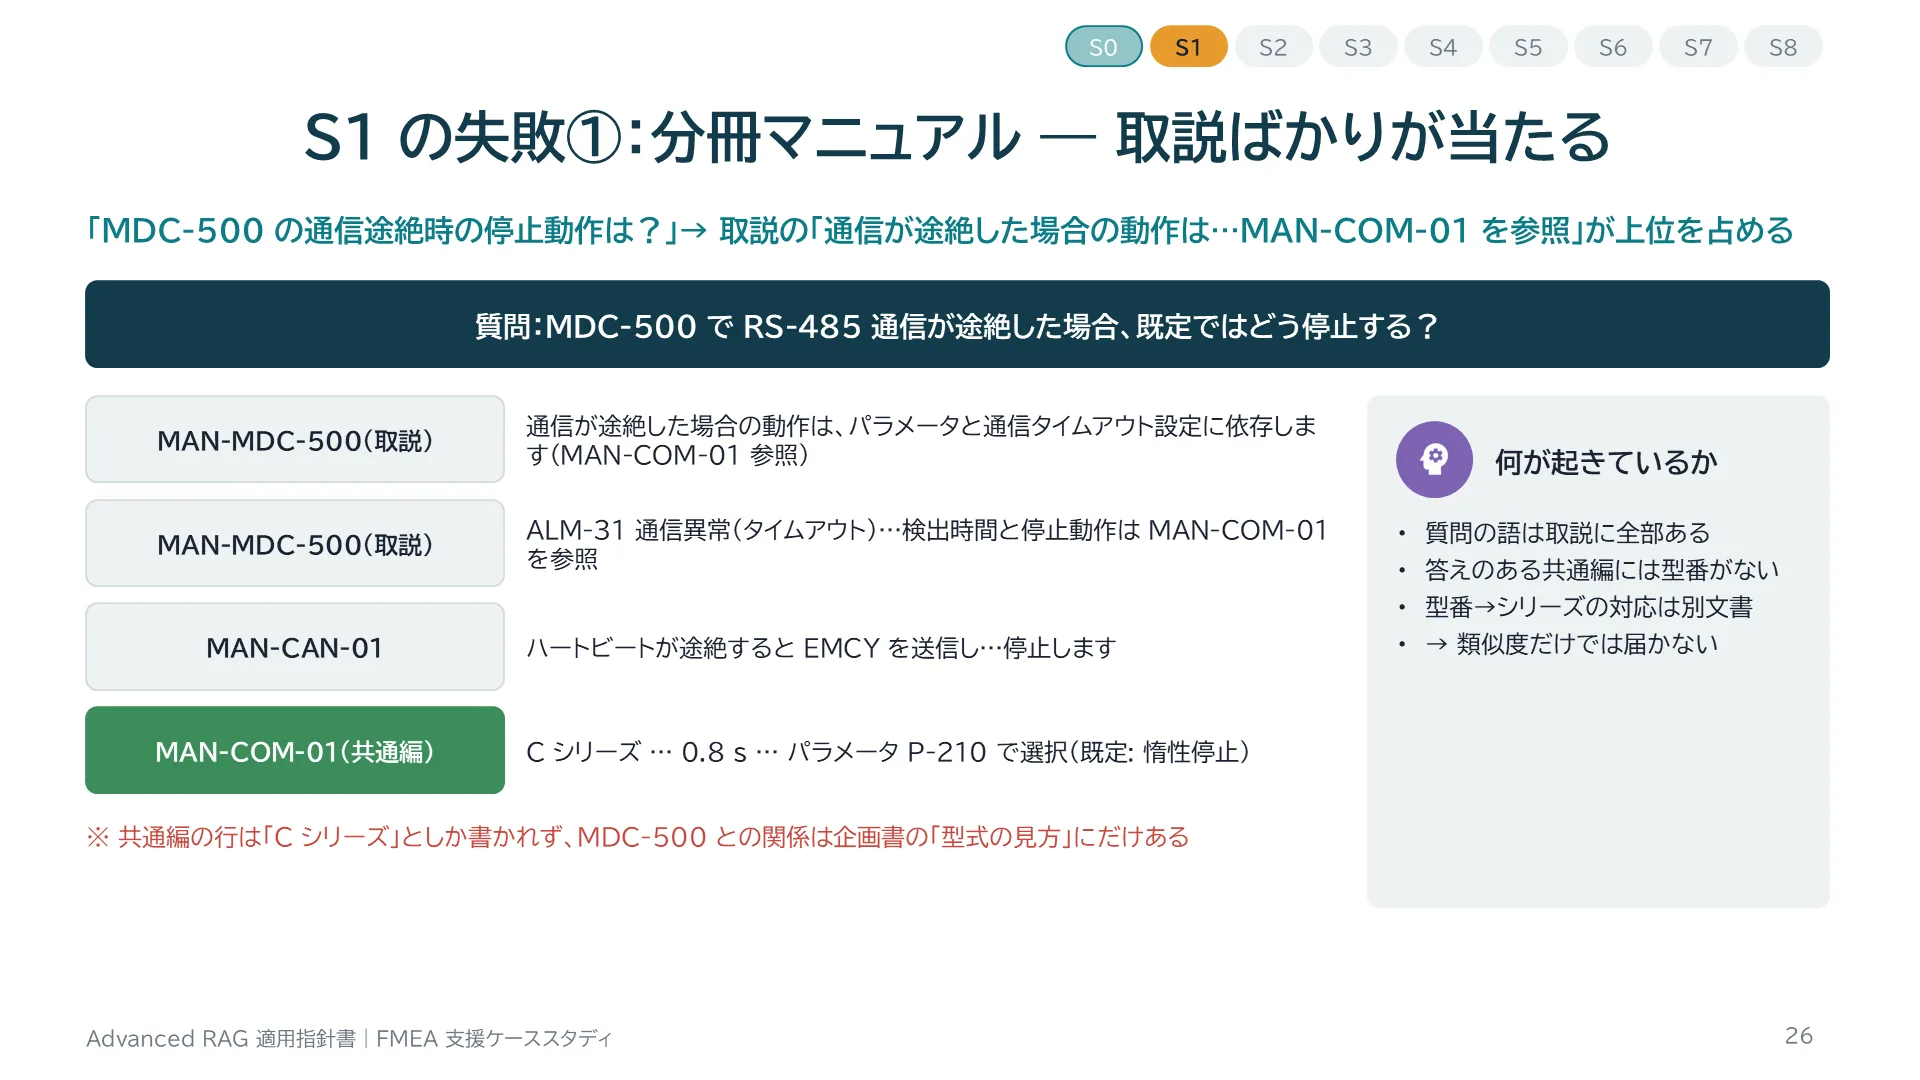
S1 の失敗①:分冊マニュアル ― 取説ばかりが当たる
スライド 26 のテキストと解説
S1 の失敗①:分冊マニュアル ― 取説ばかりが当たる 「MDC-500 の通信途絶時の停止動作は?」→ 取説の「通信が途絶した場合の動作は…MAN-COM-01 を参照」が上位を占める S0 S1 S2 S3 S4 S5 S6 S7 S8 質問:MDC-500 で RS-485 通信が途絶した場合、既定ではどう停止する? MAN-MDC-500(取説) 通信が途絶した場合の動作は、パラメータと通信タイムアウト設定に依存します(MAN-COM-01 参照) MAN-MDC-500(取説) ALM-31 通信異常(タイムアウト)…検出時間と停止動作は MAN-COM-01 を参照 MAN-CAN-01 ハートビートが途絶すると EMCY を送信し…停止します MAN-COM-01(共通編) C シリーズ … 0.8 s … パラメータ P-210 で選択(既定: 惰性停止) ※ 共通編の行は「C シリーズ」としか書かれず、MDC-500 との関係は企画書の「型式の見方」にだけある 何が起きているか 質問の語は取説に全部ある 答えのある共通編には型番がない 型番→シリーズの対応は別文書 → 類似度だけでは届かない 26
解説

分冊マニュアル型の典型的な失敗です。質問に含まれる「MDC-500」「通信」「途絶」「停止」という語は、MDC-500の取扱説明書にすべて出てきます。取説の運転の章には「通信が途絶した場合の動作は、パラメータと通信タイムアウト設定に依存します」とあり、アラーム表にも「通信異常」があります。そのため類似度では取説が上位を占めますが、そこには値がありません。答えは共通編の「Cシリーズ…惰性停止」にありますが、共通編にはMDC-500という文字列がなく、Cシリーズと書かれているだけです。たまたま共通編の表がチャンク内で崩れずに残り、上位に入ったときだけ答えられる、運任せの状態です。
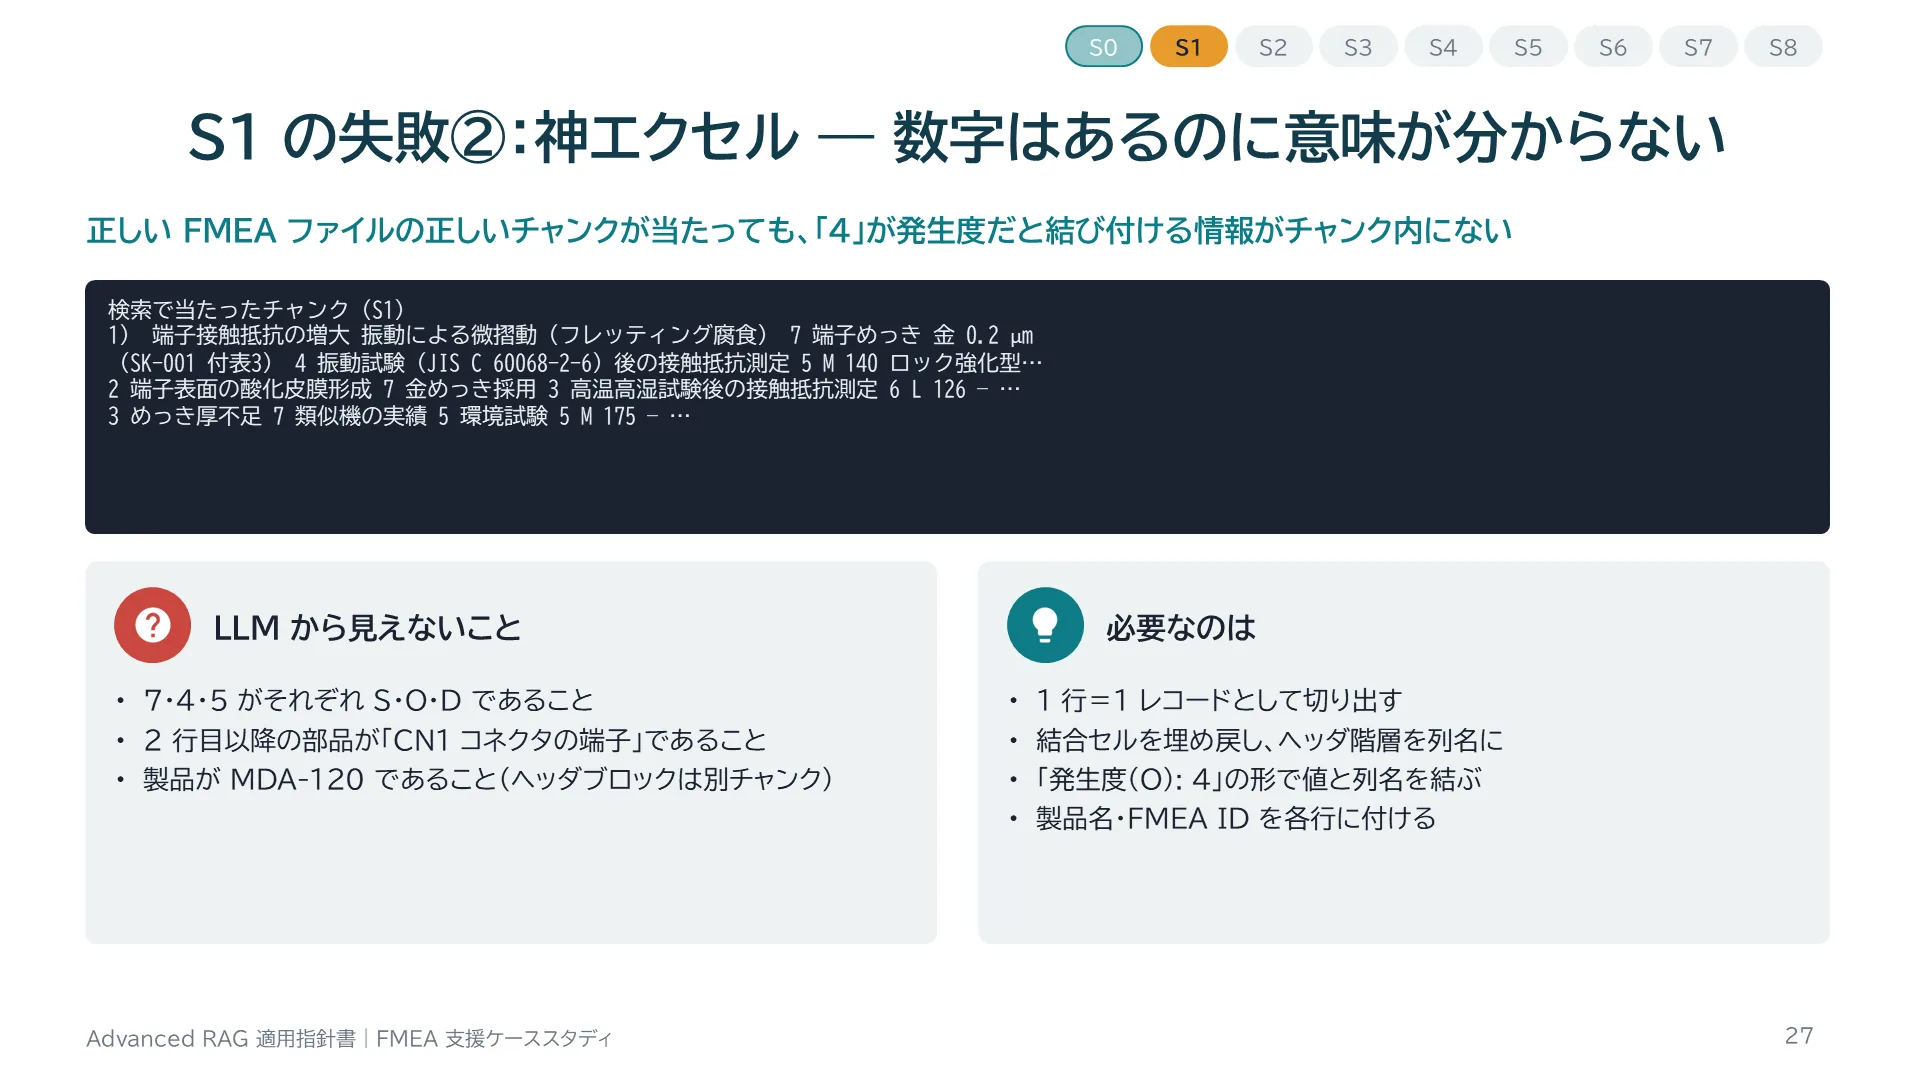
S1 の失敗②:神エクセル ― 数字はあるのに意味が分からない
スライド 27 のテキストと解説
S1 の失敗②:神エクセル ― 数字はあるのに意味が分からない 正しい FMEA ファイルの正しいチャンクが当たっても、「4」が発生度だと結び付ける情報がチャンク内にない S0 S1 S2 S3 S4 S5 S6 S7 S8 検索で当たったチャンク(S1) 1) 端子接触抵抗の増大 振動による微摺動(フレッティング腐食) 7 端子めっき 金 0.2 µm (SK-001 付表3) 4 振動試験(JIS C 60068-2-6)後の接触抵抗測定 5 M 140 ロック強化型… 2 端子表面の酸化皮膜形成 7 金めっき採用 3 高温高湿試験後の接触抵抗測定 6 L 126 — … 3 めっき厚不足 7 類似機の実績 5 環境試験 5 M 175 — … LLM から見えないこと 7・4・5 がそれぞれ S・O・D であること 2 行目以降の部品が「CN1 コネクタの端子」であること 製品が MDA-120 であること(ヘッダブロックは別チャンク) 必要なのは 1 行=1 レコードとして切り出す 結合セルを埋め戻し、ヘッダ階層を列名に 「発生度(O): 4」の形で値と列名を結ぶ 製品名・FMEA ID を各行に付ける 27
解説

FMEAの質問では、S1でも正しいファイルのチャンクは上位に来ます。しかしチャンクの中身は「(フレッティング腐食) 7 端子めっき 金 0.2 µm(SK-001 付表3) 4 振動試験… 5 M 140」です。7が重大度、4が発生度、5が検出度であることは、表の先頭のヘッダ3行を数えないと分からず、そのヘッダは別のチャンクにあります。LLMがこれを見て「発生度は4」と答えたなら、それは推測です。たまたま当たるかもしれませんが、根拠付きの回答とは言えません。本検証の判定では「発生度(O):4」のように列名と値が結び付いていることを要求したので、不合格になります。
S1b 比較:取込を直さずに検索だけ高度化すると?
スライド 28 のテキストと解説
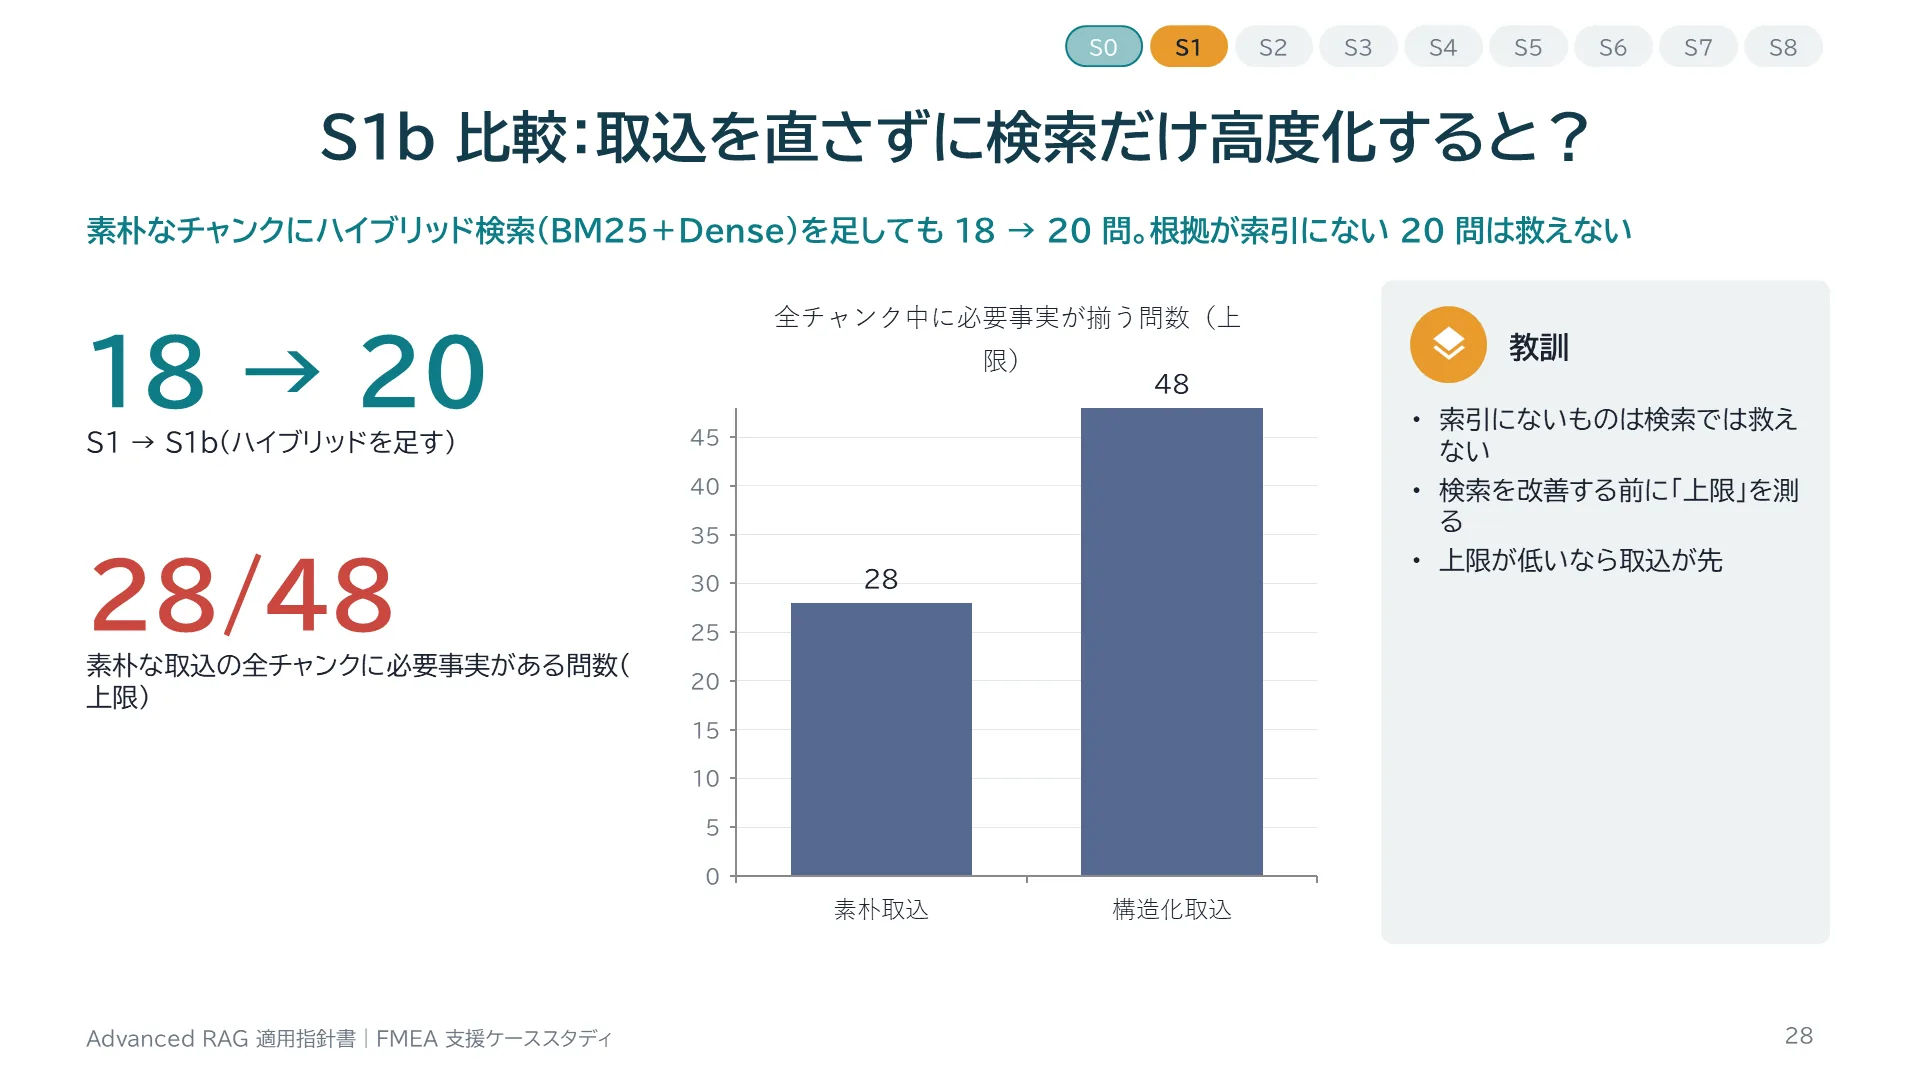
S1b 比較:取込を直さずに検索だけ高度化すると? 素朴なチャンクにハイブリッド検索(BM25+Dense)を足しても 18 → 20 問。根拠が索引にない 20 問は救えない S0 S1 S2 S3 S4 S5 S6 S7 S8 18 → 20 S1 → S1b(ハイブリッドを足す) 28/48 素朴な取込の全チャンクに必要事実がある問数(上限) 教訓 索引にないものは検索では救えない 検索を改善する前に「上限」を測る 上限が低いなら取込が先 28
解説

S1bは比較用の段です。素朴なチャンクのまま、BM25とDenseのハイブリッド検索だけを足しました。結果は2問増の20問です。そもそも素朴な取込のチャンク全体を見ても、必要事実が揃うのは48問中28問しかありません(スキャンの文字層がない、表の値と列名が離れているなど)。つまり残りの20問は、検索をどれだけ高度化しても答えられません。前作で学んだ「候補にないものは再ランキングでは救えない」の取込版で、「索引にないものは検索では救えない」ということです。
診断の型:S1 の 30 問の失敗を 3 つに分ける
スライド 29 のテキストと解説
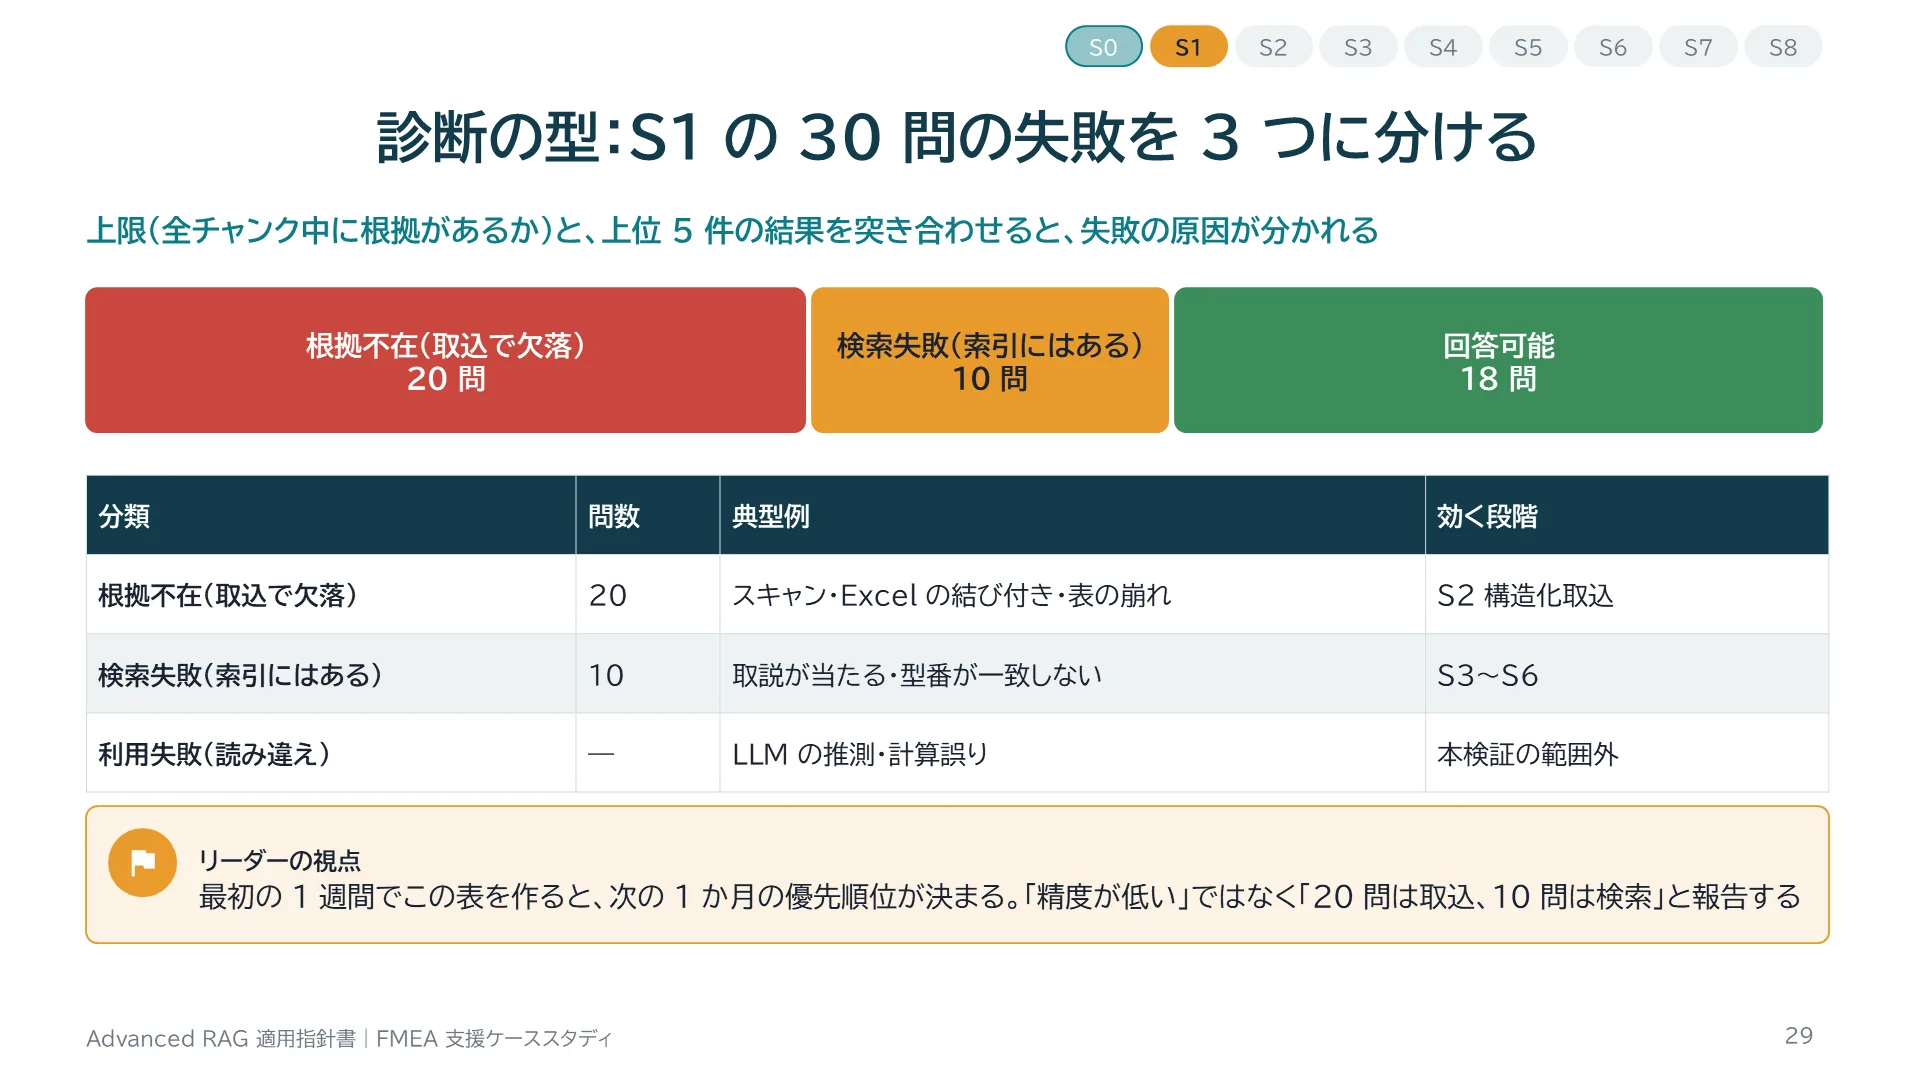
診断の型:S1 の 30 問の失敗を 3 つに分ける 上限(全チャンク中に根拠があるか)と、上位 5 件の結果を突き合わせると、失敗の原因が分かれる S0 S1 S2 S3 S4 S5 S6 S7 S8 根拠不在(取込で欠落) 20 問 検索失敗(索引にはある) 10 問 回答可能 18 問 分類 | 問数 | 典型例 | 効く段階 根拠不在(取込で欠落) | 20 | スキャン・Excel の結び付き・表の崩れ | S2 構造化取込 検索失敗(索引にはある) | 10 | 取説が当たる・型番が一致しない | S3〜S6 利用失敗(読み違え) | — | LLM の推測・計算誤り | 本検証の範囲外 リーダーの視点 最初の 1 週間でこの表を作ると、次の 1 か月の優先順位が決まる。「精度が低い」ではなく「20 問は取込、10 問は検索」と報告する 29
解説

前作の「根拠不在・検索失敗・利用失敗」の分類を、実データに当てはめます。素朴取込の全チャンクに必要事実があるのは28問です。S1で答えられたのは18問なので、28問のうち10問は「索引にはあるが上位5件に来なかった」検索失敗です。残りの20問は、索引に根拠そのものがない根拠不在(正確には取込による欠落)です。この分類ができると、打ち手の優先順位が決まります。20問の根拠不在を直すのが取込の構造化(S2)、10問の検索失敗を直すのがハイブリッドや文脈付与(S3以降)です。利用失敗(LLMが読み違える)は、本検証では評価範囲外です。
S2 構造化取込:形式ごとに「構造を残す」パーサを作る
スライド 30 のテキストと解説
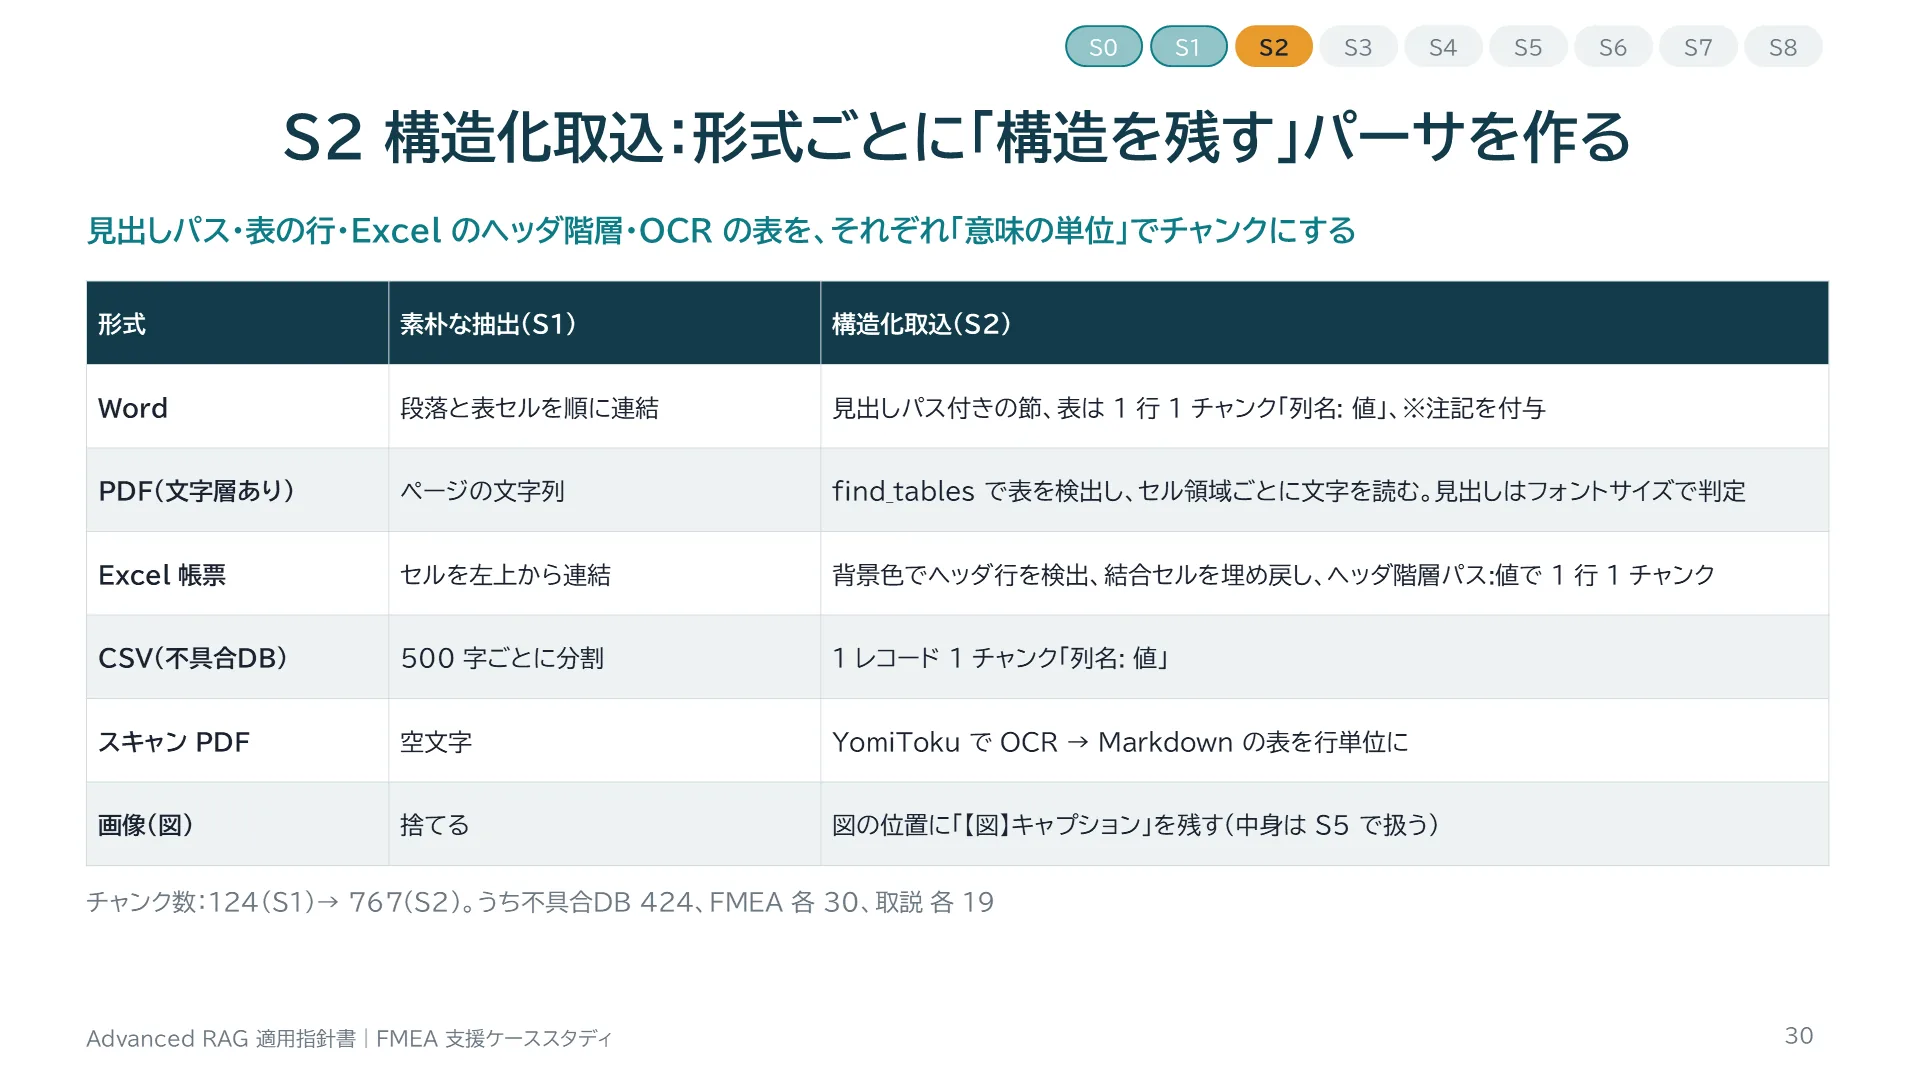
S2 構造化取込:形式ごとに「構造を残す」パーサを作る 見出しパス・表の行・Excel のヘッダ階層・OCR の表を、それぞれ「意味の単位」でチャンクにする S0 S1 S2 S3 S4 S5 S6 S7 S8 形式 | 素朴な抽出(S1) | 構造化取込(S2) Word | 段落と表セルを順に連結 | 見出しパス付きの節、表は 1 行 1 チャンク「列名: 値」、※注記を付与 PDF(文字層あり) | ページの文字列 | find_tables で表を検出し、セル領域ごとに文字を読む。見出しはフォントサイズで判定 Excel 帳票 | セルを左上から連結 | 背景色でヘッダ行を検出、結合セルを埋め戻し、ヘッダ階層パス:値で 1 行 1 チャンク CSV(不具合DB) | 500 字ごとに分割 | 1 レコード 1 チャンク「列名: 値」 スキャン PDF | 空文字 | YomiToku で OCR → Markdown の表を行単位に 画像(図) | 捨てる | 図の位置に「【図】キャプション」を残す(中身は S5 で扱う) チャンク数:124(S1)→ 767(S2)。うち不具合DB 424、FMEA 各 30、取説 各 19 30
解説

S2では、ファイル形式ごとに構造を残すパーサを用意しました。Wordは見出しスタイルから章のパスを作り、表は1行を1チャンクにして「列名: 値」の形にします。表の直後の※注記はその表の各行に付けます。PDFはPyMuPDFのfind_tablesで表を検出し、各セルの領域を切り出してテキストを読みます。Excelは背景色の付いた行をヘッダと判定し、結合セルを埋め戻してヘッダの階層パスを列名にします。CSVは1レコード1チャンク、スキャンPDFはYomiTokuでOCRし、出力されたMarkdownの表を同じように行単位にします。チャンク数は124から767に増えました。
S2 の要:Excel 帳票を「1 行 1 レコード」に直列化する
スライド 31 のテキストと解説
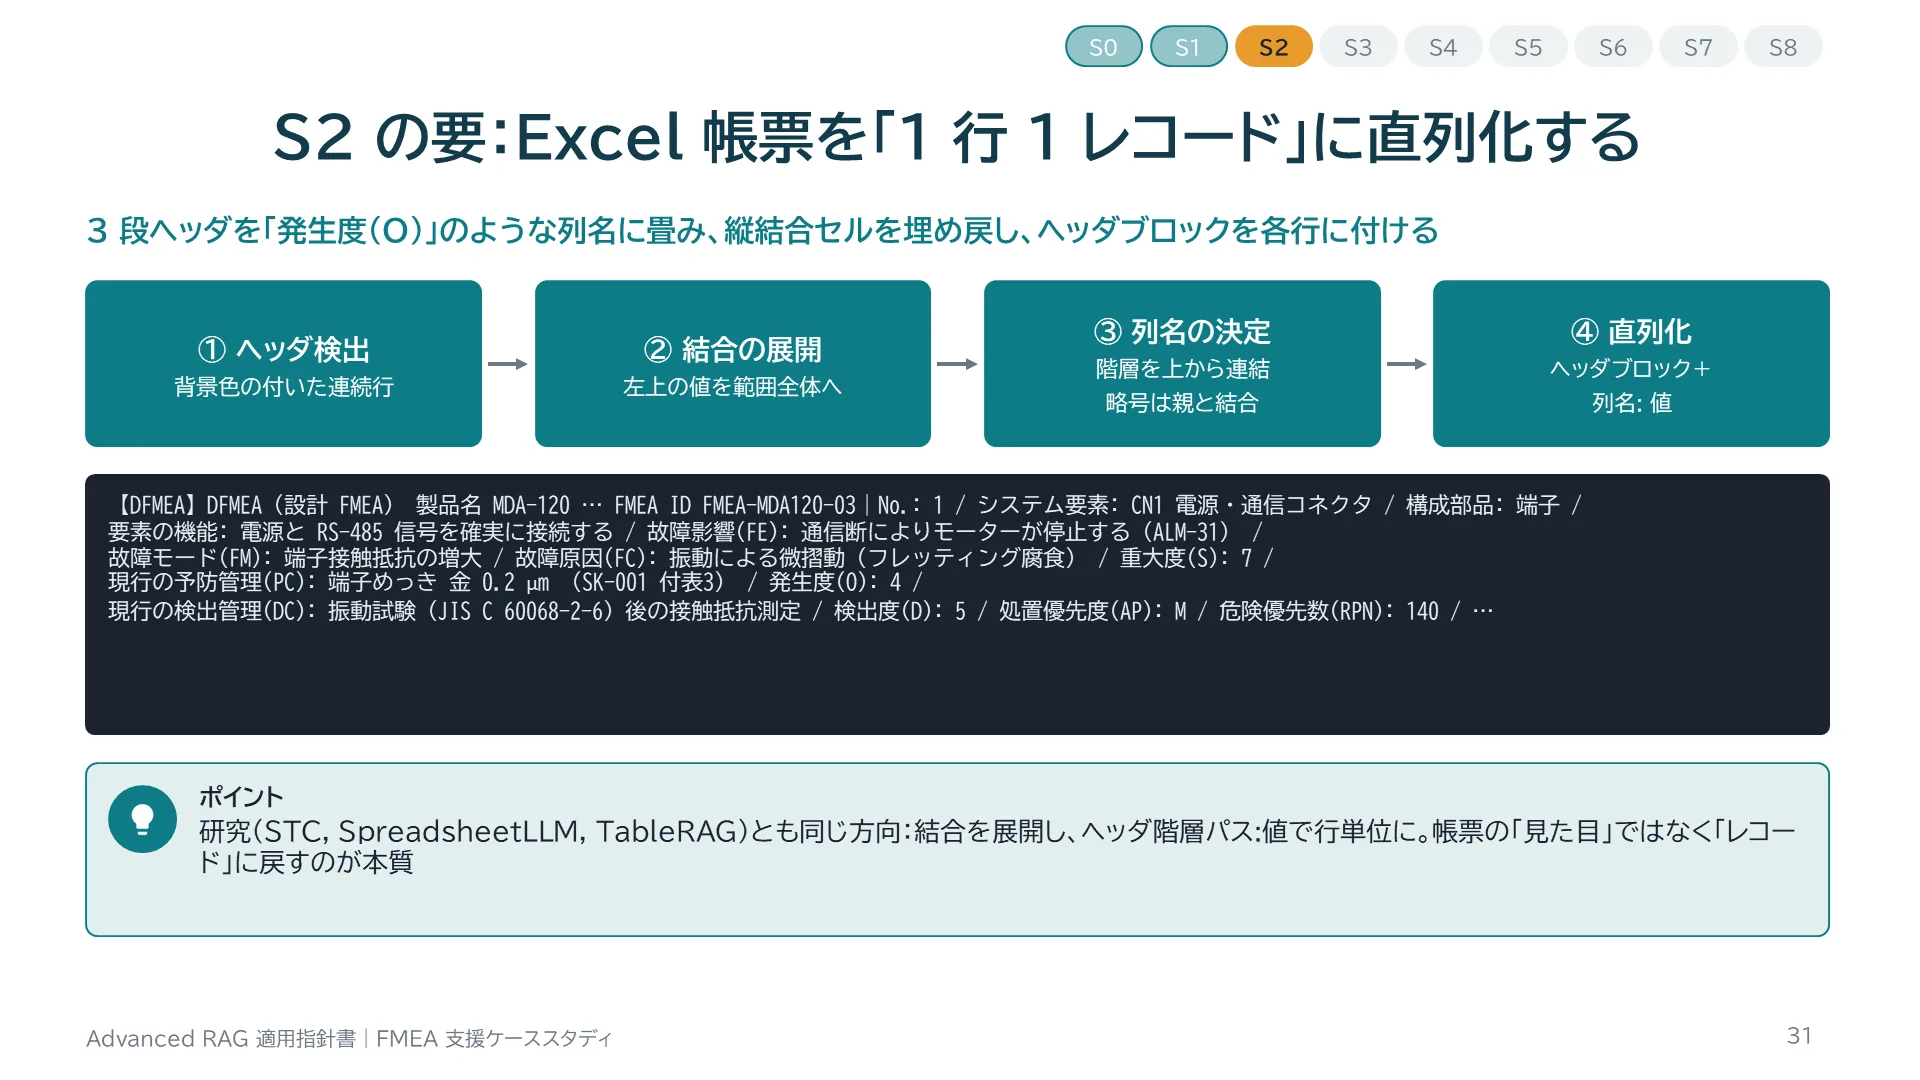
S2 の要:Excel 帳票を「1 行 1 レコード」に直列化する 3 段ヘッダを「発生度(O)」のような列名に畳み、縦結合セルを埋め戻し、ヘッダブロックを各行に付ける S0 S1 S2 S3 S4 S5 S6 S7 S8 ① ヘッダ検出 背景色の付いた連続行 ② 結合の展開 左上の値を範囲全体へ ③ 列名の決定 階層を上から連結 略号は親と結合 ④ 直列化 ヘッダブロック+ 列名: 値 【DFMEA】DFMEA(設計 FMEA) 製品名 MDA-120 … FMEA ID FMEA-MDA120-03|No.: 1 / システム要素: CN1 電源・通信コネクタ / 構成部品: 端子 / 要素の機能: 電源と RS-485 信号を確実に接続する / 故障影響(FE): 通信断によりモーターが停止する(ALM-31) / 故障モード(FM): 端子接触抵抗の増大 / 故障原因(FC): 振動による微摺動(フレッティング腐食) / 重大度(S): 7 / 現行の予防管理(PC): 端子めっき 金 0.2 µm (SK-001 付表3) / 発生度(O): 4 / 現行の検出管理(DC): 振動試験(JIS C 60068-2-6)後の接触抵抗測定 / 検出度(D): 5 / 処置優先度(AP): M / 危険優先数(RPN): 140 / … ポイント 研究(STC, SpreadsheetLLM, TableRAG)とも同じ方向:結合を展開し、ヘッダ階層パス:値で行単位に。帳票の「見た目」ではなく「レコード」に戻すのが本質 31
解説

Excel帳票の処理を具体的に示します。まず背景色の付いた連続行をヘッダとみなします(書式は機械にとって数少ない手掛かりです)。次に結合セルの範囲を展開して、各セルに左上の値を埋め戻します。列ごとにヘッダの値を上から並べ、末尾が「(O)」のような略号なら1つ上の列名と結合して「発生度(O)」とします。最後に、上部のヘッダブロック(製品名・図番・FMEA ID)を各行の先頭に付けます。こうすると、1行のチャンクだけで「MDA-120のFMEAの、CN1コネクタ端子の、フレッティング腐食が原因の行の、発生度は4」が読めるようになります。
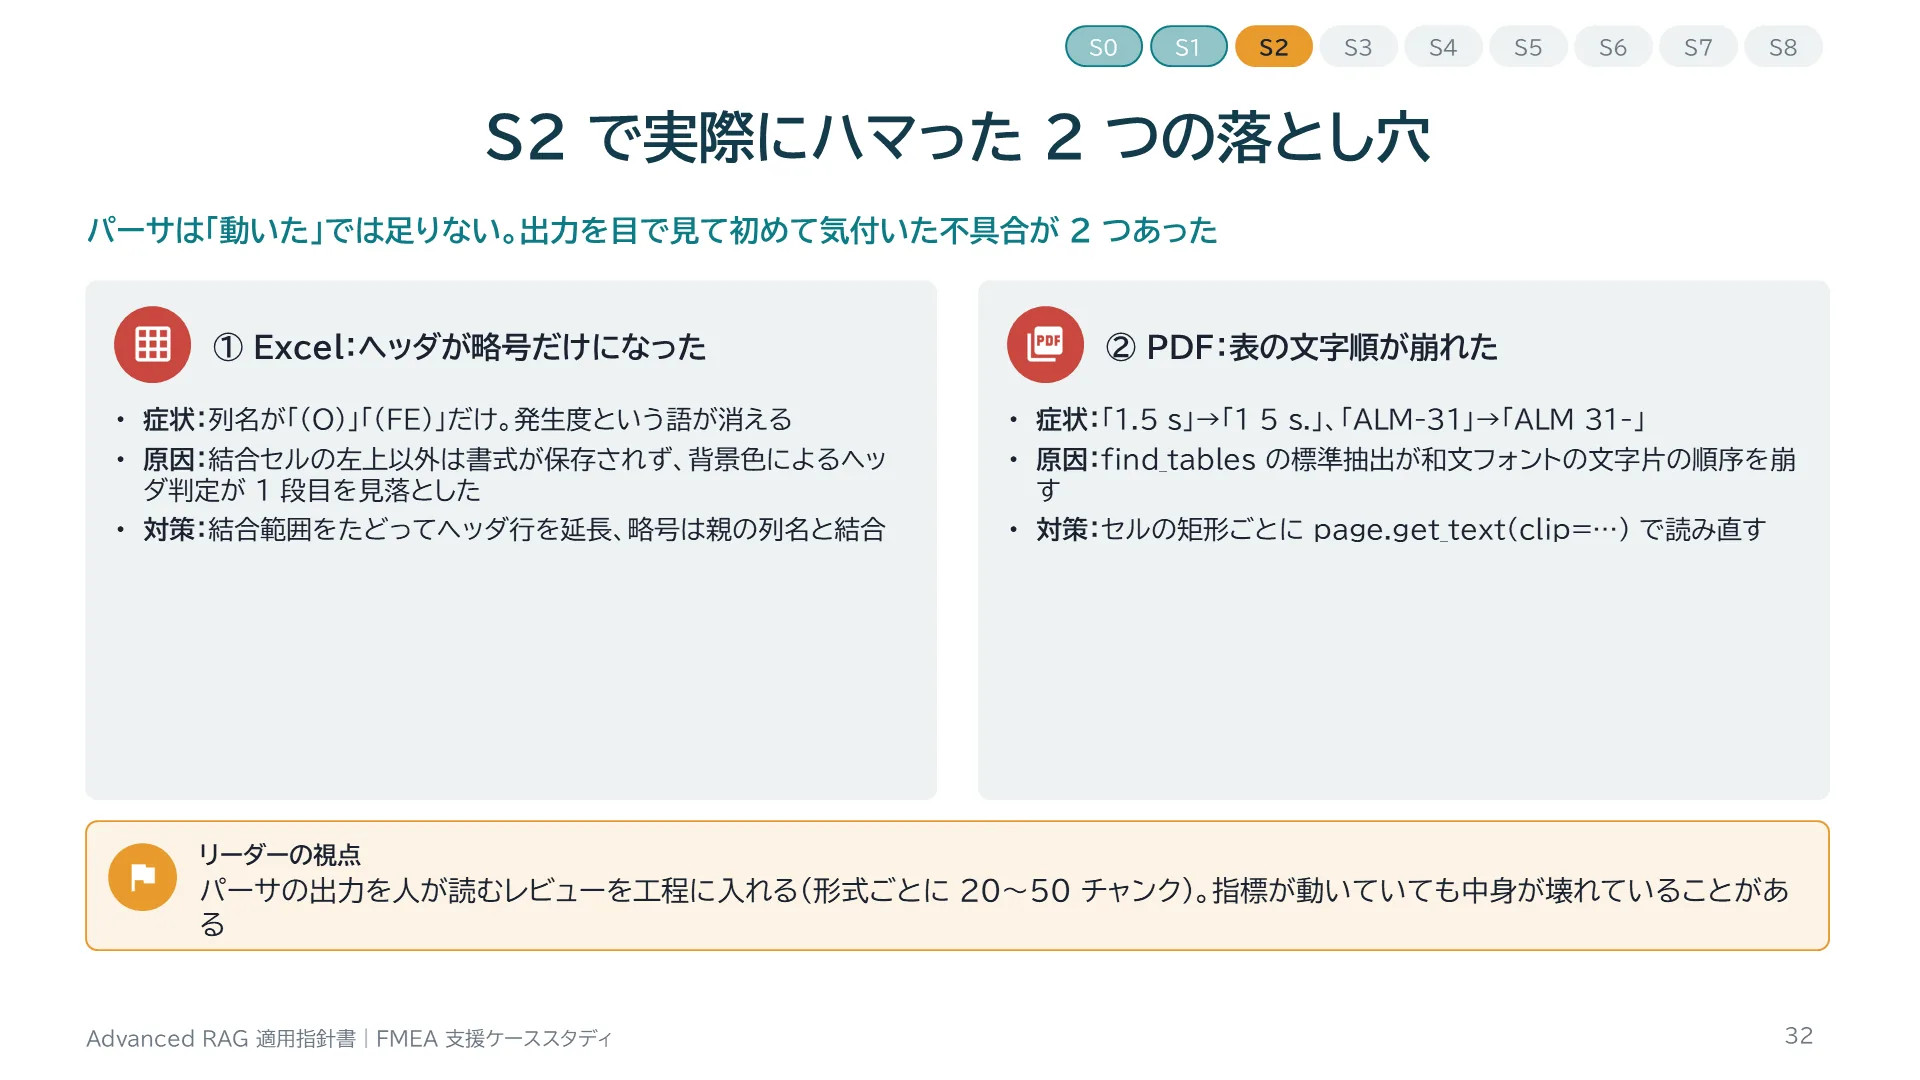
S2 で実際にハマった 2 つの落とし穴
スライド 32 のテキストと解説
S2 で実際にハマった 2 つの落とし穴 パーサは「動いた」では足りない。出力を目で見て初めて気付いた不具合が 2 つあった S0 S1 S2 S3 S4 S5 S6 S7 S8 ① Excel:ヘッダが略号だけになった 症状:列名が「(O)」「(FE)」だけ。発生度という語が消える 原因:結合セルの左上以外は書式が保存されず、背景色によるヘッダ判定が 1 段目を見落とした 対策:結合範囲をたどってヘッダ行を延長、略号は親の列名と結合 ② PDF:表の文字順が崩れた 症状:「1.5 s」→「1 5 s.」、「ALM-31」→「ALM 31-」 原因:find_tables の標準抽出が和文フォントの文字片の順序を崩す 対策:セルの矩形ごとに page.get_text(clip=…) で読み直す リーダーの視点 パーサの出力を人が読むレビューを工程に入れる(形式ごとに 20〜50 チャンク)。指標が動いていても中身が壊れていることがある 32
解説

実装中に実際に起きた不具合です。1つ目はExcelで、結合セルの左上以外のセルは書式が保存されないため、背景色でヘッダを判定すると1段目の行がヘッダと見なされず、列名が「(O)」のような略号だけになっていました。検索も評価も一見動くので、出力を目で見るまで気付きませんでした。2つ目はPDFで、find_tablesの標準の抽出は日本語フォントの文字の並び順を崩し、「1.5 s」が「1 5 s.」、「ALM-31」が「ALM 31-」になっていました。セルの領域を切り出して文字を読み直す方法に変えて解決しました。リーダーとしては、パーサの出力を人がサンプリングして読むレビューを工程に組み込むことが重要です。
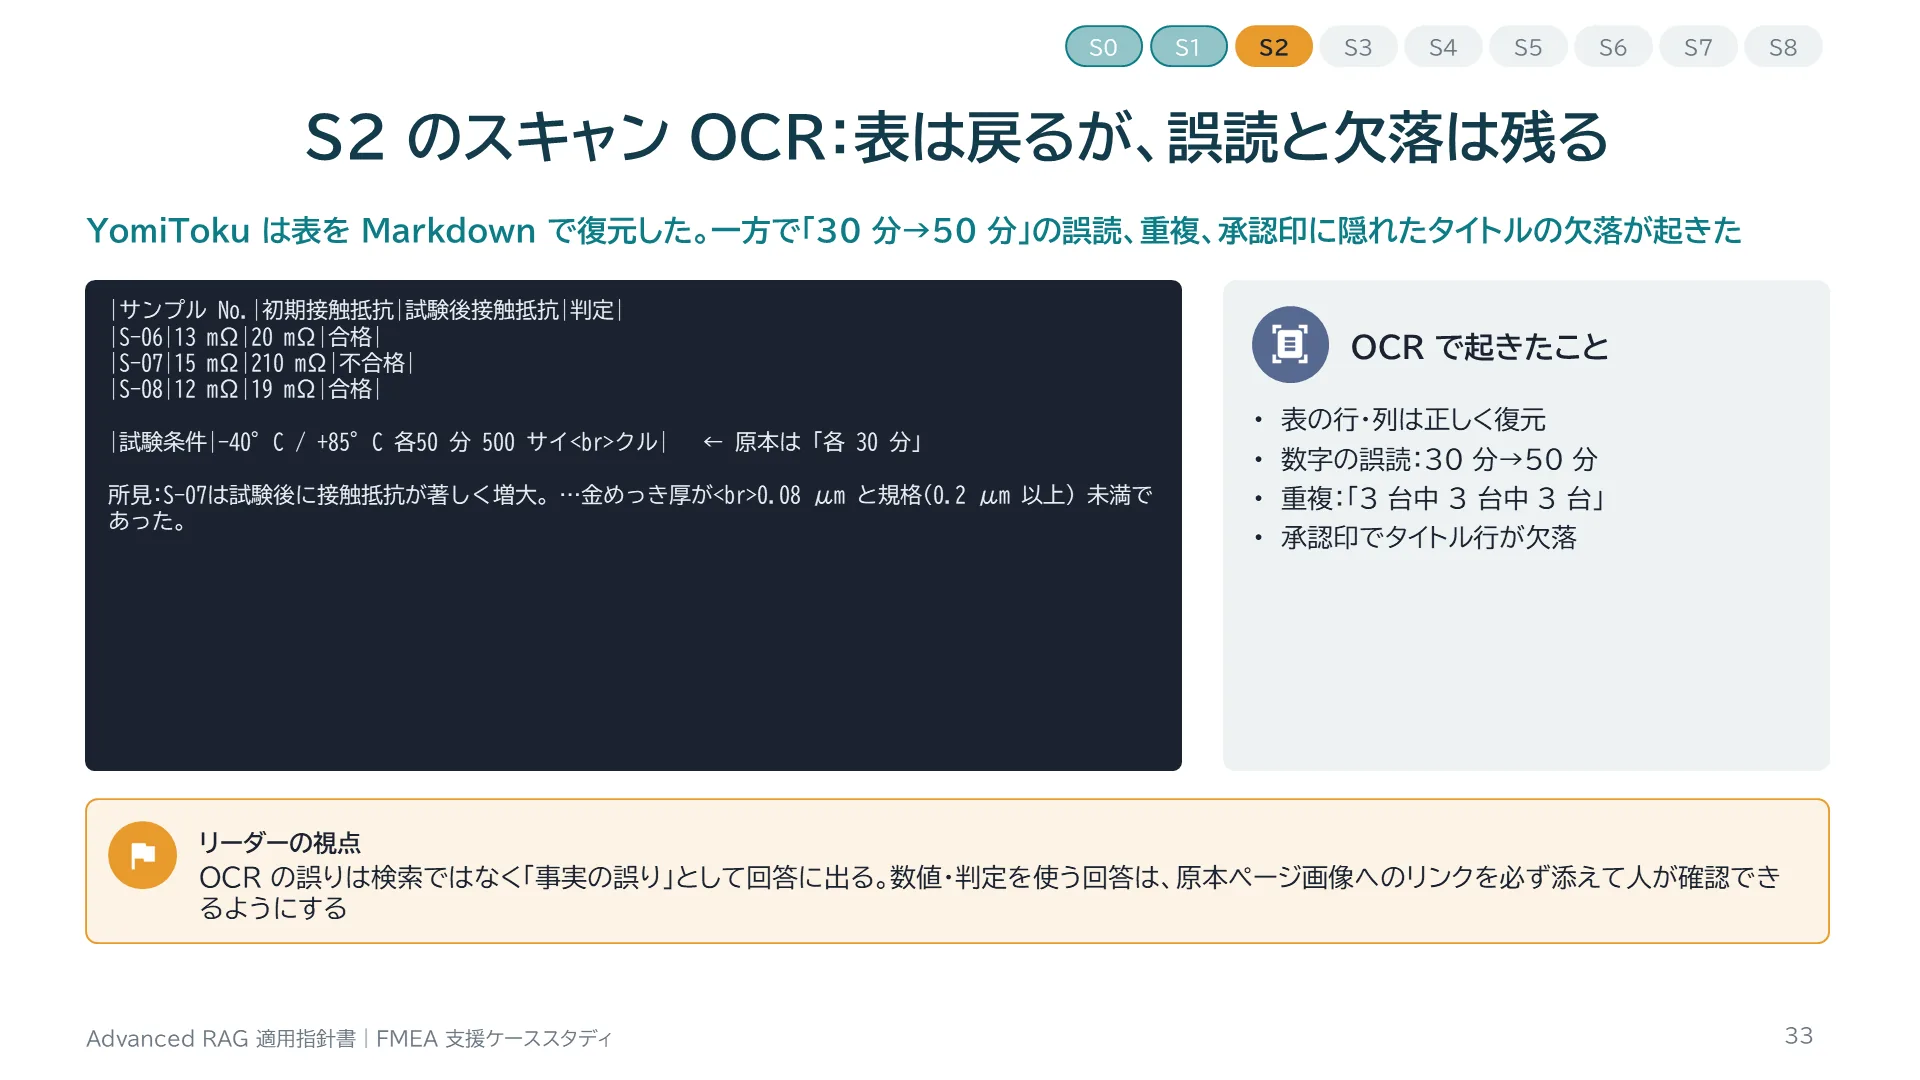
S2 のスキャン OCR:表は戻るが、誤読と欠落は残る
スライド 33 のテキストと解説
S2 のスキャン OCR:表は戻るが、誤読と欠落は残る YomiToku は表を Markdown で復元した。一方で「30 分→50 分」の誤読、重複、承認印に隠れたタイトルの欠落が起きた S0 S1 S2 S3 S4 S5 S6 S7 S8 |サンプル No.|初期接触抵抗|試験後接触抵抗|判定| |S-06|13 mΩ|20 mΩ|合格| |S-07|15 mΩ|210 mΩ|不合格| |S-08|12 mΩ|19 mΩ|合格| |試験条件|-40°C / +85°C 各50 分 500 サイ<br>クル| ← 原本は「各 30 分」 所見:S-07は試験後に接触抵抗が著しく増大。…金めっき厚が<br>0.08 μm と規格(0.2 μm 以上) 未満であった。 OCR で起きたこと 表の行・列は正しく復元 数字の誤読:30 分→50 分 重複:「3 台中 3 台中 3 台」 承認印でタイトル行が欠落 リーダーの視点 OCR の誤りは検索ではなく「事実の誤り」として回答に出る。数値・判定を使う回答は、原本ページ画像へのリンクを必ず添えて人が確認できるようにする 33
解説

スキャンした試験報告書をYomiTokuでOCRした実際の出力です。罫線の表は行と列ごとに正しく復元され、S-07の行の「210 mΩ・不合格」も読めています。一方で、試験条件の「各30分」は「各50分」に誤読され、8D報告書では「3台中3台中3台」のような重複も起きました。最も影響が大きかったのは、赤い承認印がタイトルに重なり、タイトル行がOCRで取れなかったことです。そのため文書の題名として本文の「所見:…」が使われ、後の文脈付与(S4)で誤ったヘッダが付く原因になりました。OCRの結果も、パーサと同じく人がサンプリングして確認する必要があります。
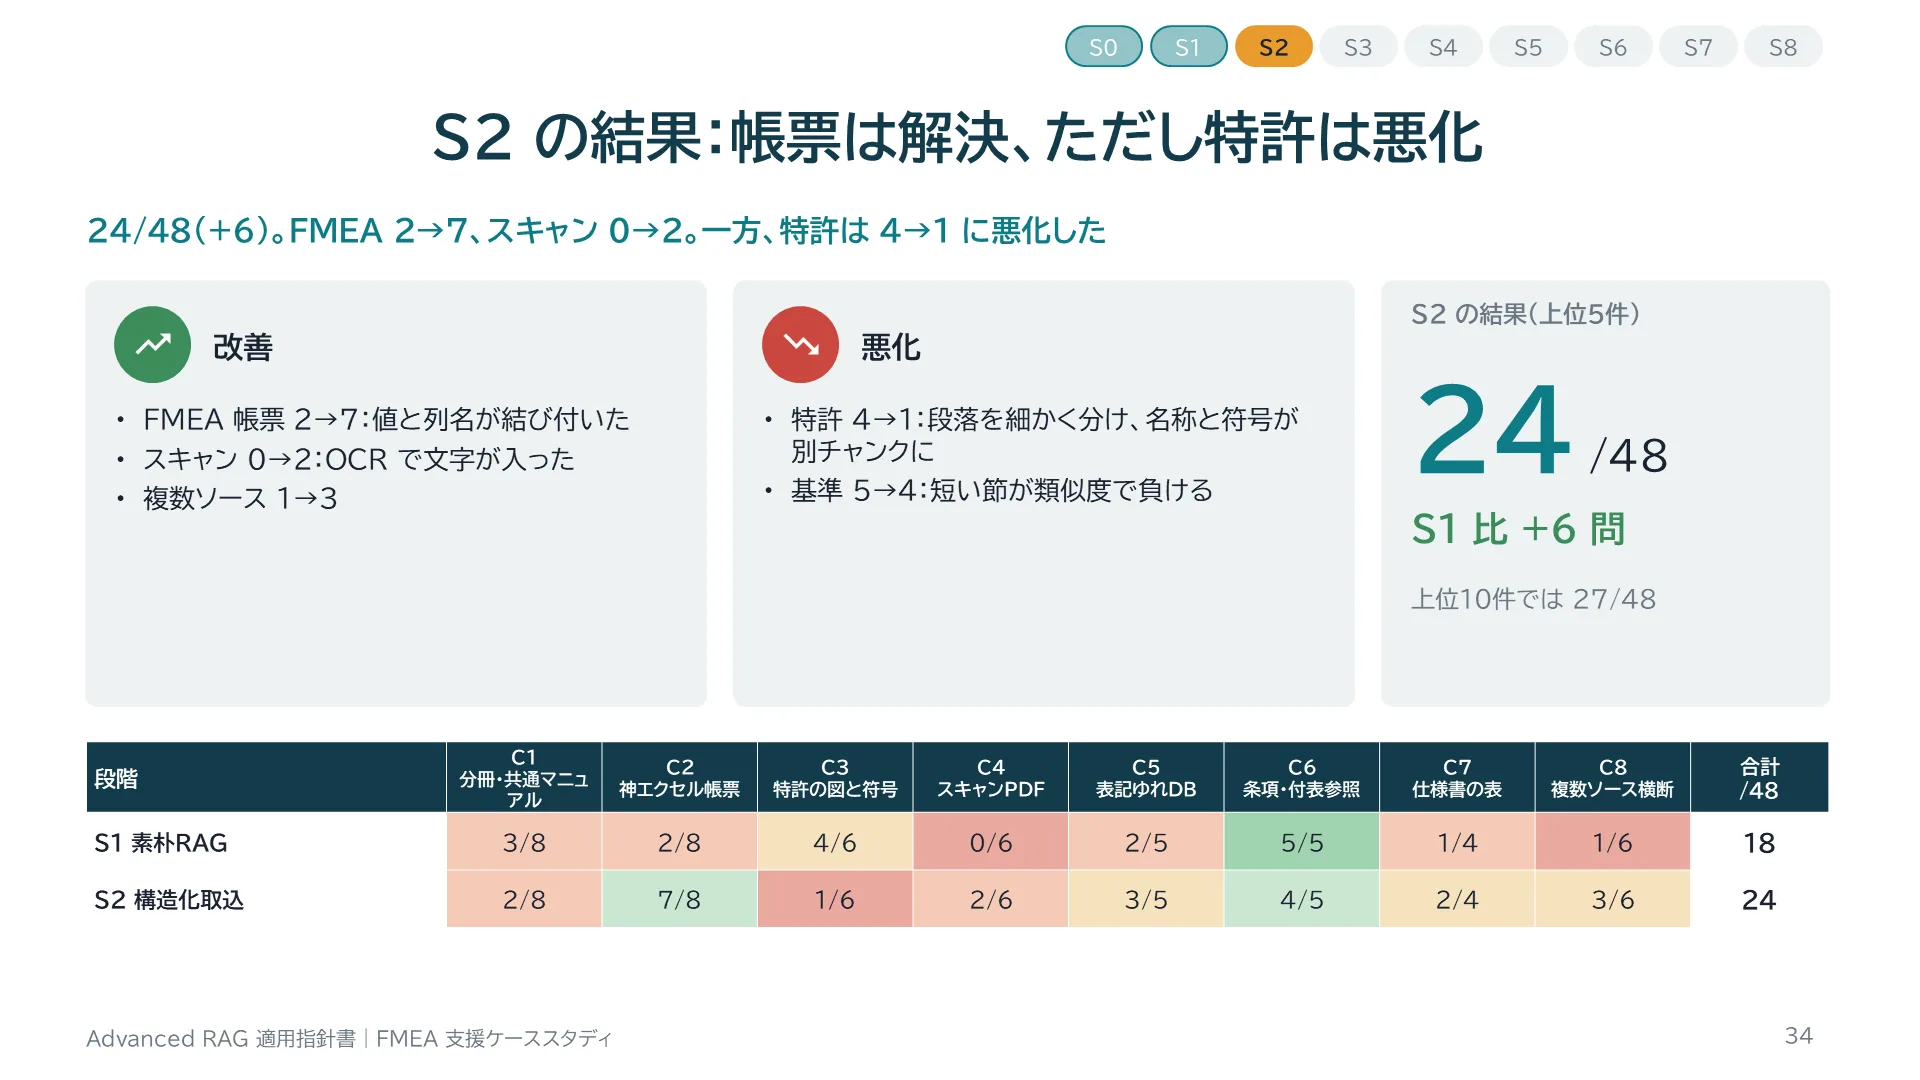
S2 の結果:帳票は解決、ただし特許は悪化
スライド 34 のテキストと解説
S2 の結果:帳票は解決、ただし特許は悪化 24/48(+6)。FMEA 2→7、スキャン 0→2。一方、特許は 4→1 に悪化した S0 S1 S2 S3 S4 S5 S6 S7 S8 改善 FMEA 帳票 2→7:値と列名が結び付いた スキャン 0→2:OCR で文字が入った 複数ソース 1→3 悪化 特許 4→1:段落を細かく分け、名称と符号が別チャンクに 基準 5→4:短い節が類似度で負ける S2 の結果(上位5件) 24 /48 S1 比 +6 問 上位10件では 27/48 段階 | C1 分冊・共通マニュアル | C2 神エクセル帳票 | C3 特許の図と符号 | C4 スキャンPDF | C5 表記ゆれDB | C6 条項・付表参照 | C7 仕様書の表 | C8 複数ソース横断 | 合計 /48 S1 素朴RAG | 3/8 | 2/8 | 4/6 | 0/6 | 2/5 | 5/5 | 1/4 | 1/6 | 18 S2 構造化取込 | 2/8 | 7/8 | 1/6 | 2/6 | 3/5 | 4/5 | 2/4 | 3/6 | 24 34
解説

構造化取込の結果は24問で、S1から6問増えました。FMEA(C2)は2問から7問に大きく改善し、スキャン(C4)も0問から2問になりました。一方、特許(C3)は4問から1問に悪化しています。素朴な500字チャンクでは「ロックアーム21の根元部22…疲労き裂」と符号の説明が近くにあり、たまたま1つのチャンクに収まっていましたが、構造化で段落ごとに細かく分けた結果、名称と符号を結ぶ情報が別々のチャンクに分かれたためです。構造化は万能ではなく、分け方によって失われる文脈があるというトレードオフを示しています。この悪化はS3とS5で回復します。
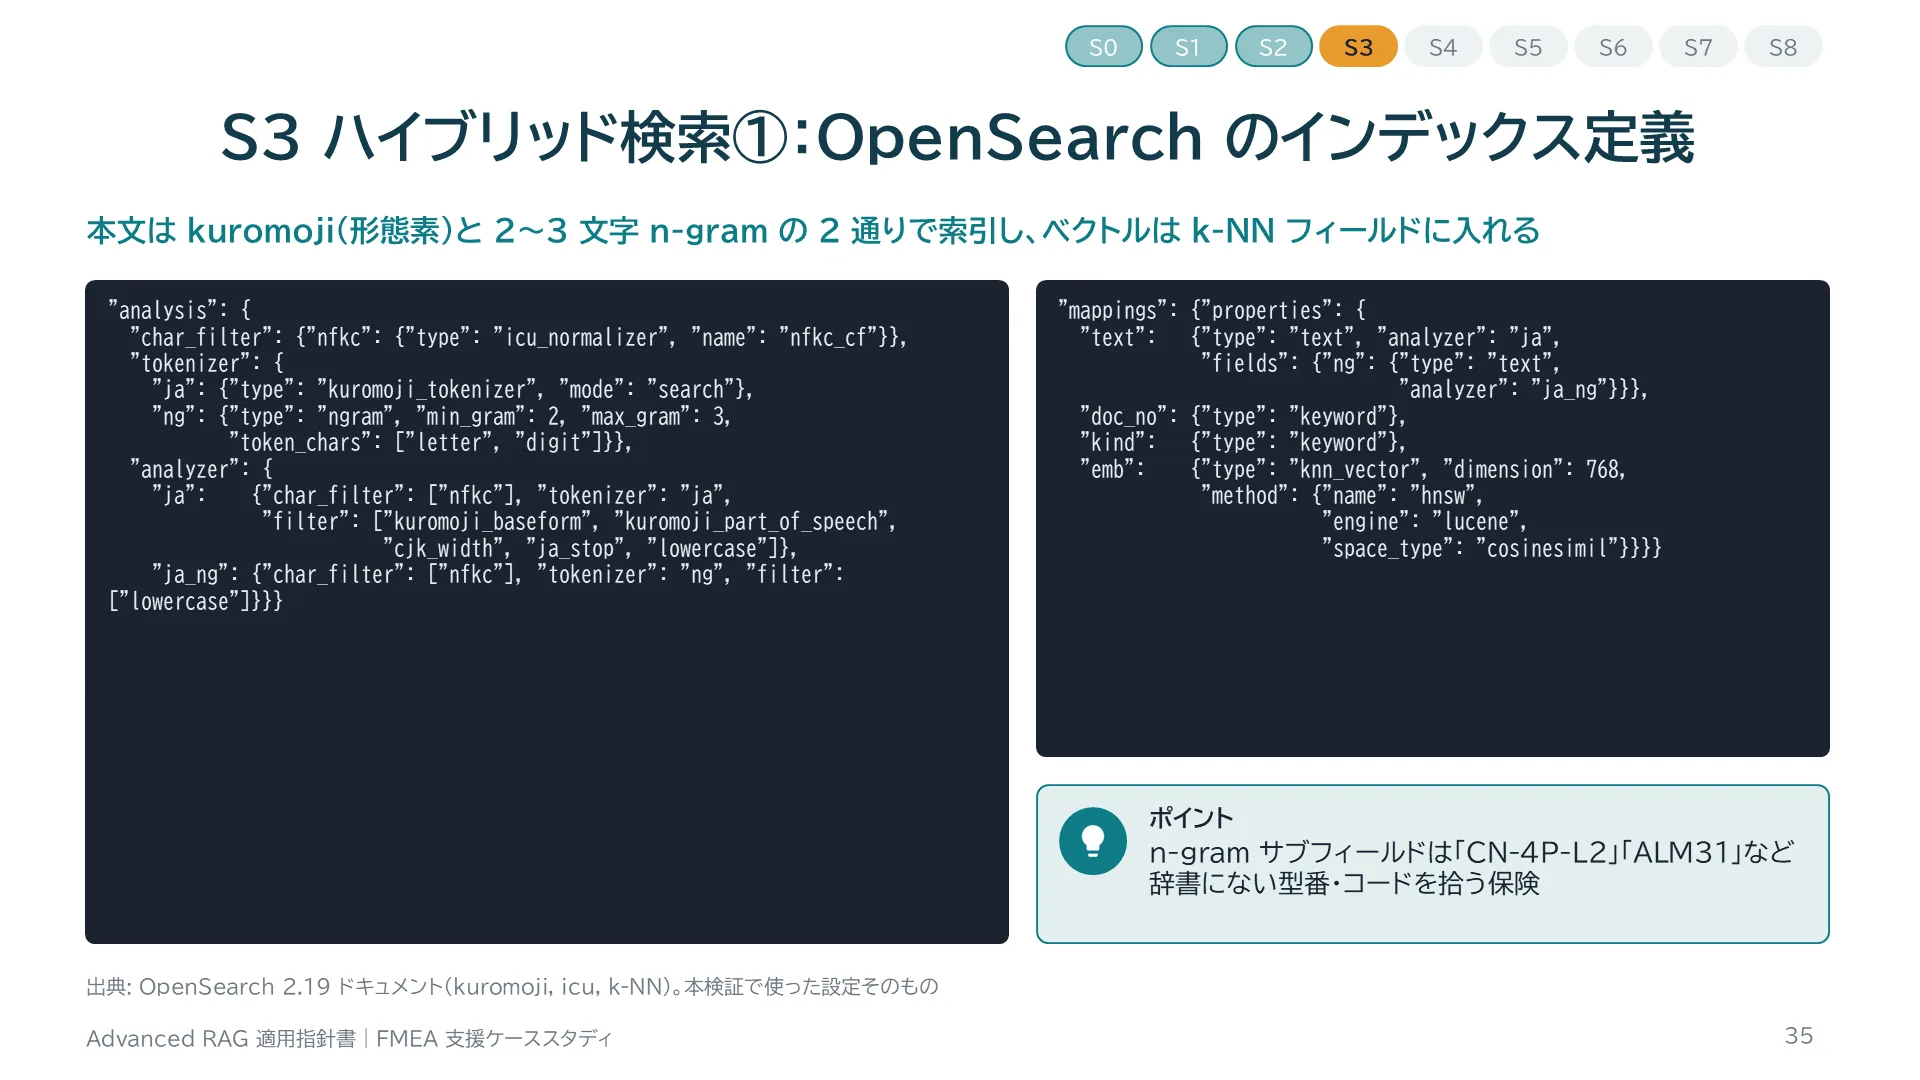
S3 ハイブリッド検索①:OpenSearch のインデックス定義
スライド 35 のテキストと解説
S3 ハイブリッド検索①:OpenSearch のインデックス定義 本文は kuromoji(形態素)と 2〜3 文字 n-gram の 2 通りで索引し、ベクトルは k-NN フィールドに入れる 出典: OpenSearch 2.19 ドキュメント(kuromoji, icu, k-NN)。本検証で使った設定そのもの S0 S1 S2 S3 S4 S5 S6 S7 S8 "analysis": { "char_filter": {"nfkc": {"type": "icu_normalizer", "name": "nfkc_cf"}}, "tokenizer": { "ja": {"type": "kuromoji_tokenizer", "mode": "search"}, "ng": {"type": "ngram", "min_gram": 2, "max_gram": 3, "token_chars": ["letter", "digit"]}}, "analyzer": { "ja": {"char_filter": ["nfkc"], "tokenizer": "ja", "filter": ["kuromoji_baseform", "kuromoji_part_of_speech", "cjk_width", "ja_stop", "lowercase"]}, "ja_ng": {"char_filter": ["nfkc"], "tokenizer": "ng", "filter": ["lowercase"]}}} "mappings": {"properties": { "text": {"type": "text", "analyzer": "ja", "fields": {"ng": {"type": "text", "analyzer": "ja_ng"}}}, "doc_no": {"type": "keyword"}, "kind": {"type": "keyword"}, "emb": {"type": "knn_vector", "dimension": 768, "method": {"name": "hnsw", "engine": "lucene", "space_type": "cosinesimil"}}}} ポイント n-gram サブフィールドは「CN-4P-L2」「ALM31」など辞書にない型番・コードを拾う保険 35
解説

OpenSearchのインデックス設定です。本文フィールドtextは、ICUのNFKC正規化(全角・半角や大文字・小文字を揃える)をかけた上で、kuromojiで形態素解析します。さらにサブフィールドtext.ngに2〜3文字のn-gramを持たせ、型番や略語のように辞書にない語でも部分一致で拾えるようにしました。doc_noはキーワード型で、文書を絞り込むフィルタに使います。埋め込みは768次元のknn_vectorで、HNSWとコサイン類似度を使います。小規模なのでluceneエンジンにしています。
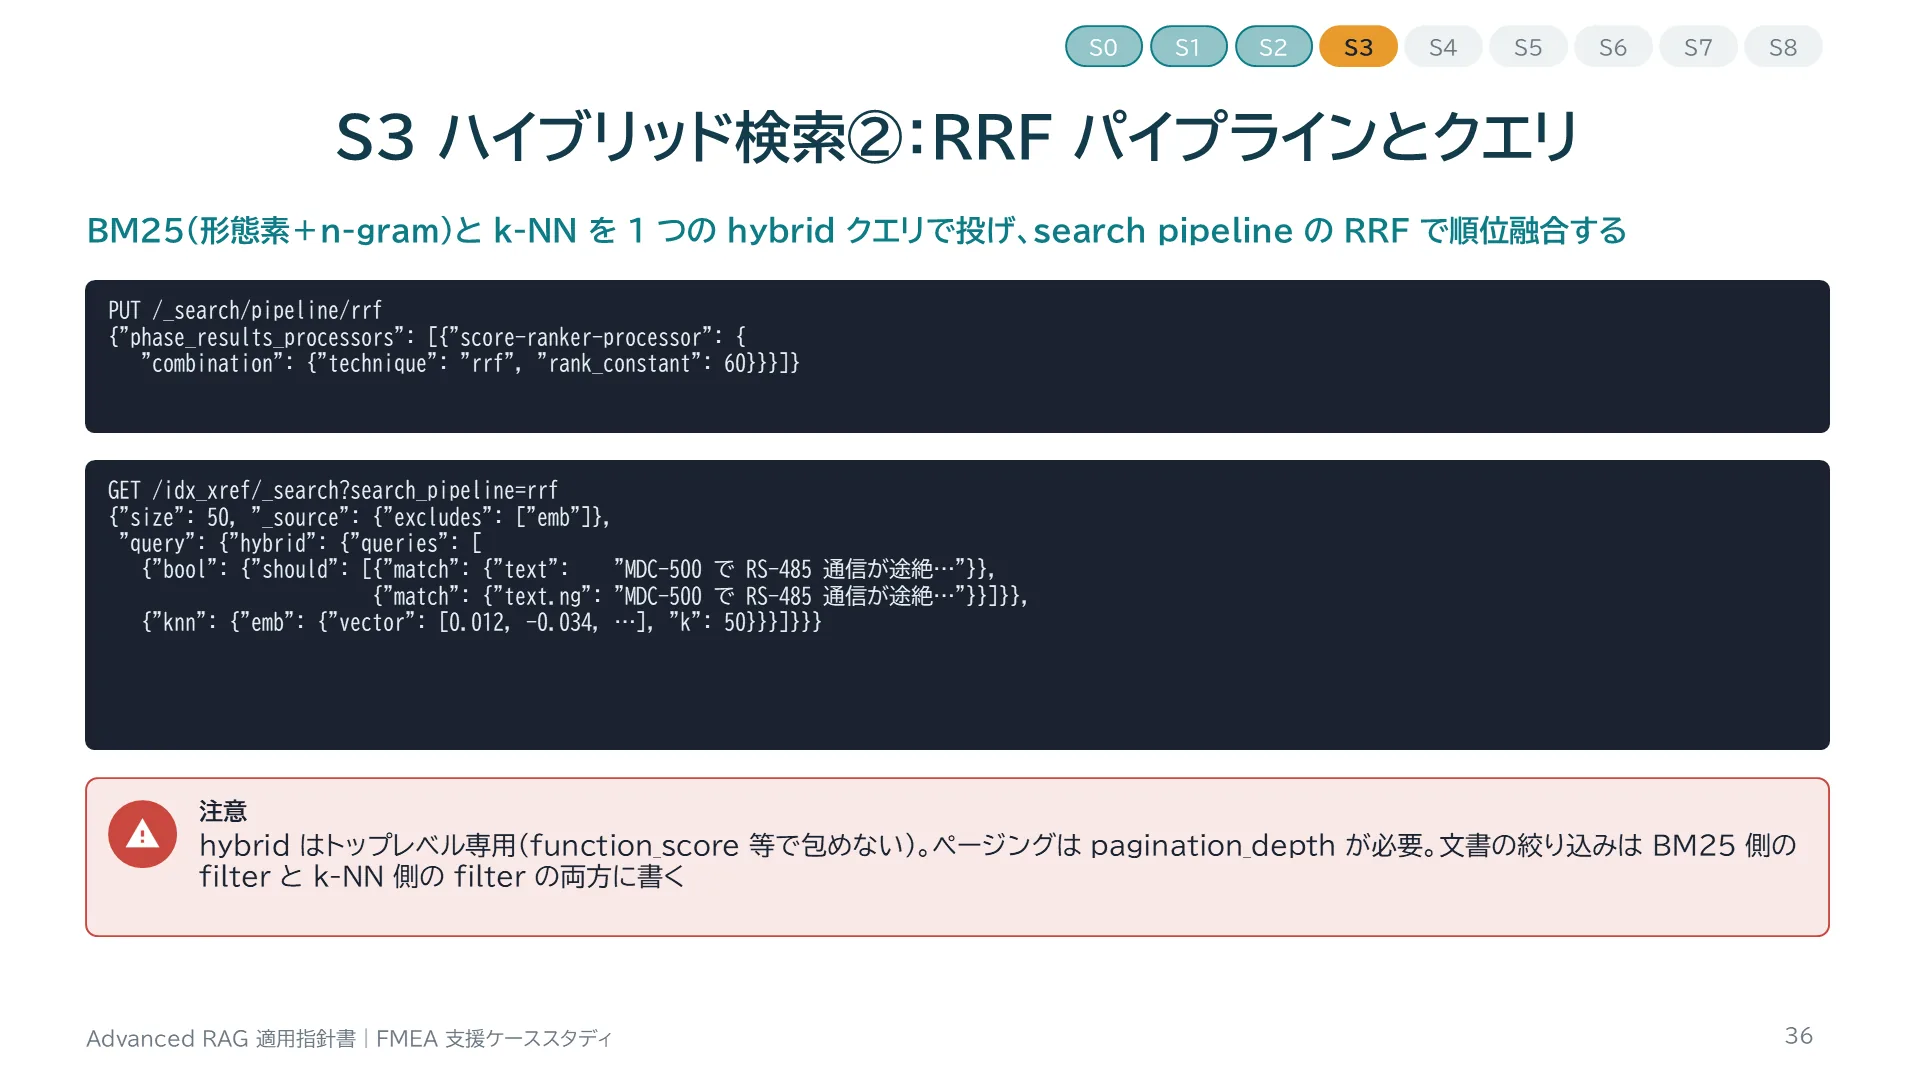
S3 ハイブリッド検索②:RRF パイプラインとクエリ
スライド 36 のテキストと解説
S3 ハイブリッド検索②:RRF パイプラインとクエリ BM25(形態素+n-gram)と k-NN を 1 つの hybrid クエリで投げ、search pipeline の RRF で順位融合する S0 S1 S2 S3 S4 S5 S6 S7 S8 PUT /_search/pipeline/rrf {"phase_results_processors": [{"score-ranker-processor": { "combination": {"technique": "rrf", "rank_constant": 60}}}]} GET /idx_xref/_search?search_pipeline=rrf {"size": 50, "_source": {"excludes": ["emb"]}, "query": {"hybrid": {"queries": [ {"bool": {"should": [{"match": {"text": "MDC-500 で RS-485 通信が途絶…"}}, {"match": {"text.ng": "MDC-500 で RS-485 通信が途絶…"}}]}}, {"knn": {"emb": {"vector": [0.012, -0.034, …], "k": 50}}}]}}} 注意 hybrid はトップレベル専用(function_score 等で包めない)。ページングは pagination_depth が必要。文書の絞り込みは BM25 側の filter と k-NN 側の filter の両方に書く 36
解説

ハイブリッド検索は、search pipelineにRRF(Reciprocal Rank Fusion)のscore-ranker-processorを登録し、hybridクエリでBM25側とk-NN側の2つのサブクエリを投げます。BM25側は形態素のmatchとn-gramのmatchをshouldで組み合わせています。RRFはスコアの尺度の違いを気にせず順位だけで融合できるので、BM25とコサイン類似度を混ぜるのに向いています。rank_constantは標準的な60にしました。hybridクエリはトップレベルでしか使えない、ページングにはpagination_depthが要る、といった制約があります。
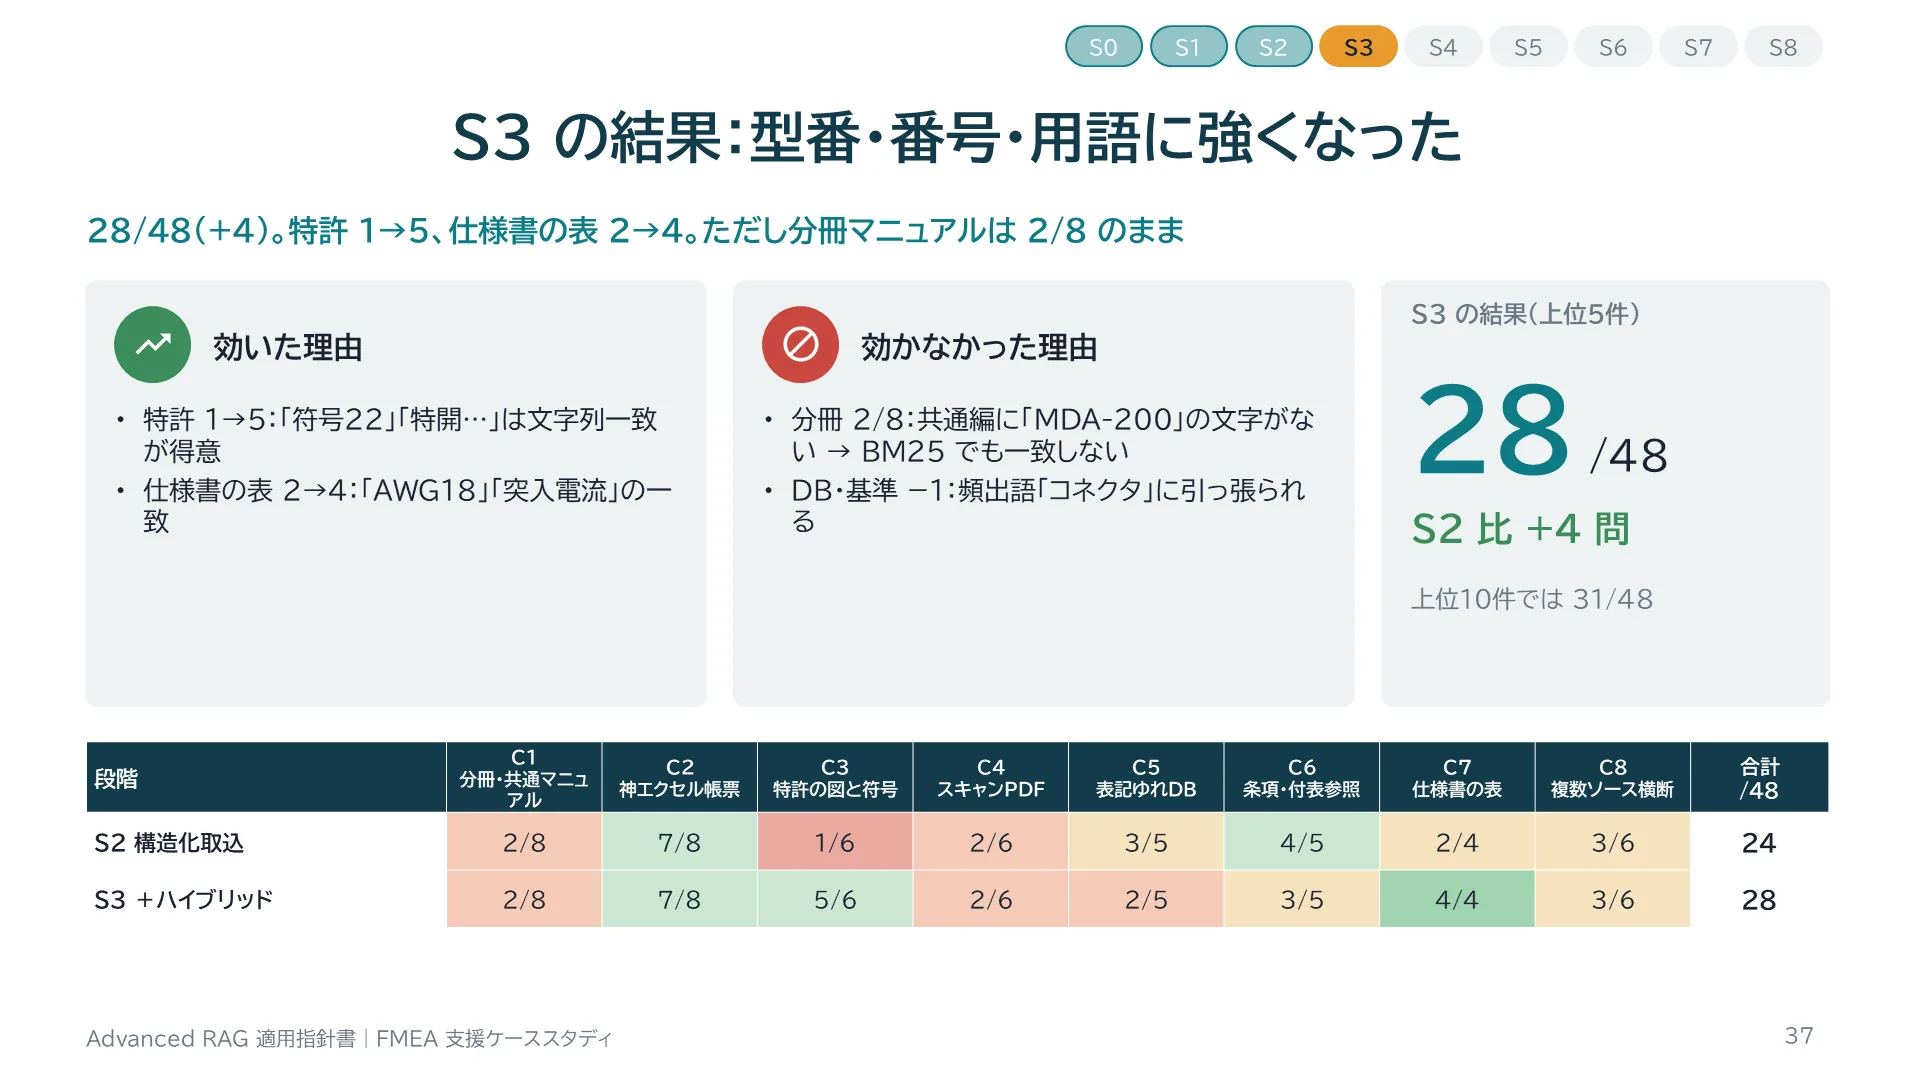
S3 の結果:型番・番号・用語に強くなった
スライド 37 のテキストと解説
S3 の結果:型番・番号・用語に強くなった 28/48(+4)。特許 1→5、仕様書の表 2→4。ただし分冊マニュアルは 2/8 のまま S0 S1 S2 S3 S4 S5 S6 S7 S8 効いた理由 特許 1→5:「符号22」「特開…」は文字列一致が得意 仕様書の表 2→4:「AWG18」「突入電流」の一致 効かなかった理由 分冊 2/8:共通編に「MDA-200」の文字がない → BM25 でも一致しない DB・基準 −1:頻出語「コネクタ」に引っ張られる S3 の結果(上位5件) 28 /48 S2 比 +4 問 上位10件では 31/48 段階 | C1 分冊・共通マニュアル | C2 神エクセル帳票 | C3 特許の図と符号 | C4 スキャンPDF | C5 表記ゆれDB | C6 条項・付表参照 | C7 仕様書の表 | C8 複数ソース横断 | 合計 /48 S2 構造化取込 | 2/8 | 7/8 | 1/6 | 2/6 | 3/5 | 4/5 | 2/4 | 3/6 | 24 S3 +ハイブリッド | 2/8 | 7/8 | 5/6 | 2/6 | 2/5 | 3/5 | 4/4 | 3/6 | 28 37
解説

ハイブリッド検索で28問になりました。特許(C3)は1問から5問に回復しました。「符号22」「特開2025-012345」のような数字や番号は、意味の埋め込みよりBM25の文字列一致が得意だからです。仕様書の表(C7)も「AWG18」「突入電流」のような用語の一致で改善しました。一方、分冊マニュアル(C1)は2問のままです。共通編には「MDA-200」という文字列がないので、BM25でも一致しません。型番とシリーズの関係そのものを索引に持たせる必要があり、それがS4です。また不具合DBと基準が1問ずつ減っています。BM25が「コネクタ」などの頻出語に引っ張られた影響です。
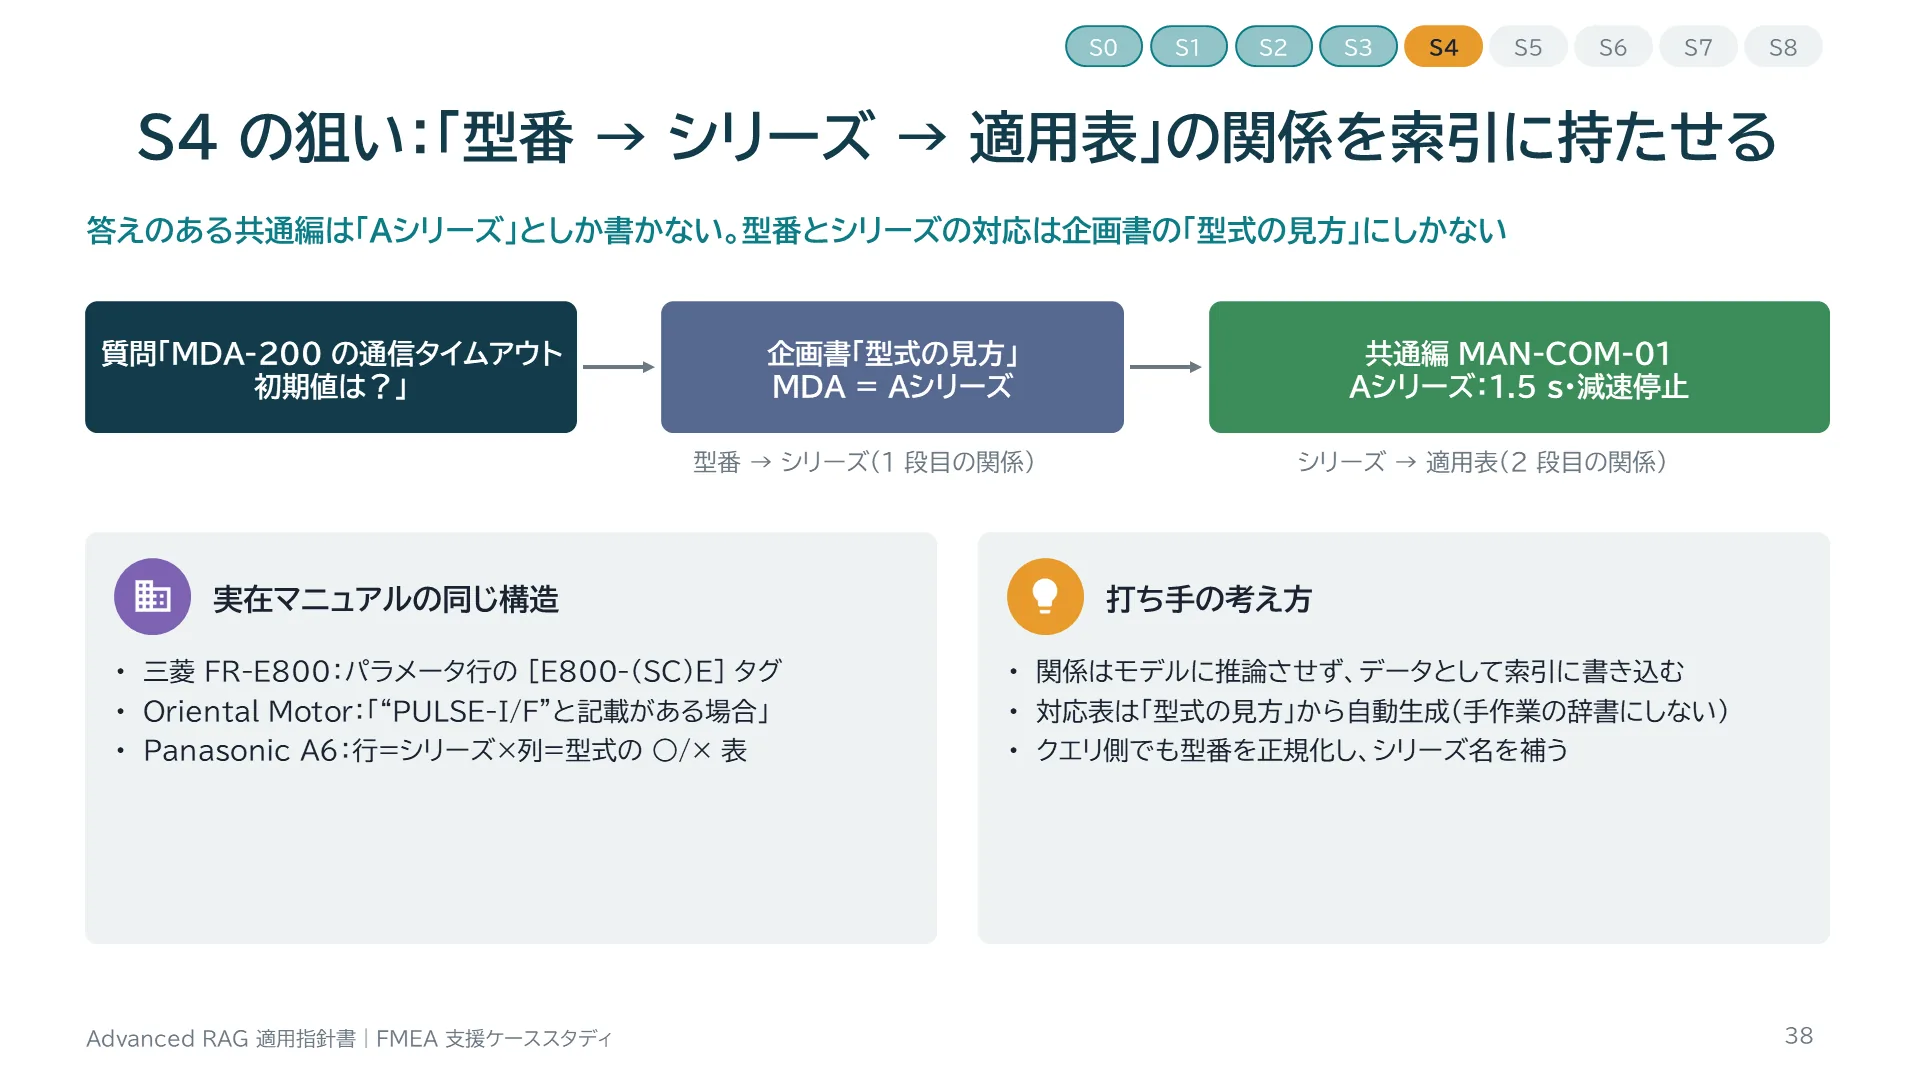
S4 の狙い:「型番 → シリーズ → 適用表」の関係を索引に持たせる
スライド 38 のテキストと解説
S4 の狙い:「型番 → シリーズ → 適用表」の関係を索引に持たせる 答えのある共通編は「Aシリーズ」としか書かない。型番とシリーズの対応は企画書の「型式の見方」にしかない S0 S1 S2 S3 S4 S5 S6 S7 S8 質問「MDA-200 の通信タイムアウト初期値は?」 企画書「型式の見方」 MDA = Aシリーズ 共通編 MAN-COM-01 Aシリーズ:1.5 s・減速停止 型番 → シリーズ(1 段目の関係) シリーズ → 適用表(2 段目の関係) 実在マニュアルの同じ構造 三菱 FR-E800:パラメータ行の [E800-(SC)E] タグ Oriental Motor:「“PULSE-I/F”と記載がある場合」 Panasonic A6:行=シリーズ×列=型式の ○/× 表 打ち手の考え方 関係はモデルに推論させず、データとして索引に書き込む 対応表は「型式の見方」から自動生成(手作業の辞書にしない) クエリ側でも型番を正規化し、シリーズ名を補う 38
解説

S4が狙う問題の構造です。ユーザーは「MDA-200」と型番で質問します。答えは共通編のタイムアウト表の「Aシリーズ 1.5 s」の行にありますが、そこにはMDA-200という文字列がありません。MDA-200がAシリーズであることは、製品企画書の「型式の見方」の表に「MDA=Aシリーズ」とあるだけです。つまり、型番からシリーズへ、シリーズから適用表へという2段の関係をたどる必要があります。実在のマニュアルでも、三菱電機の角括弧タグ、オリエンタルモーターの「PULSE-I/Fと記載がある場合」のラベル、パナソニックのシリーズ×型式表など、同じ構造が見られます。
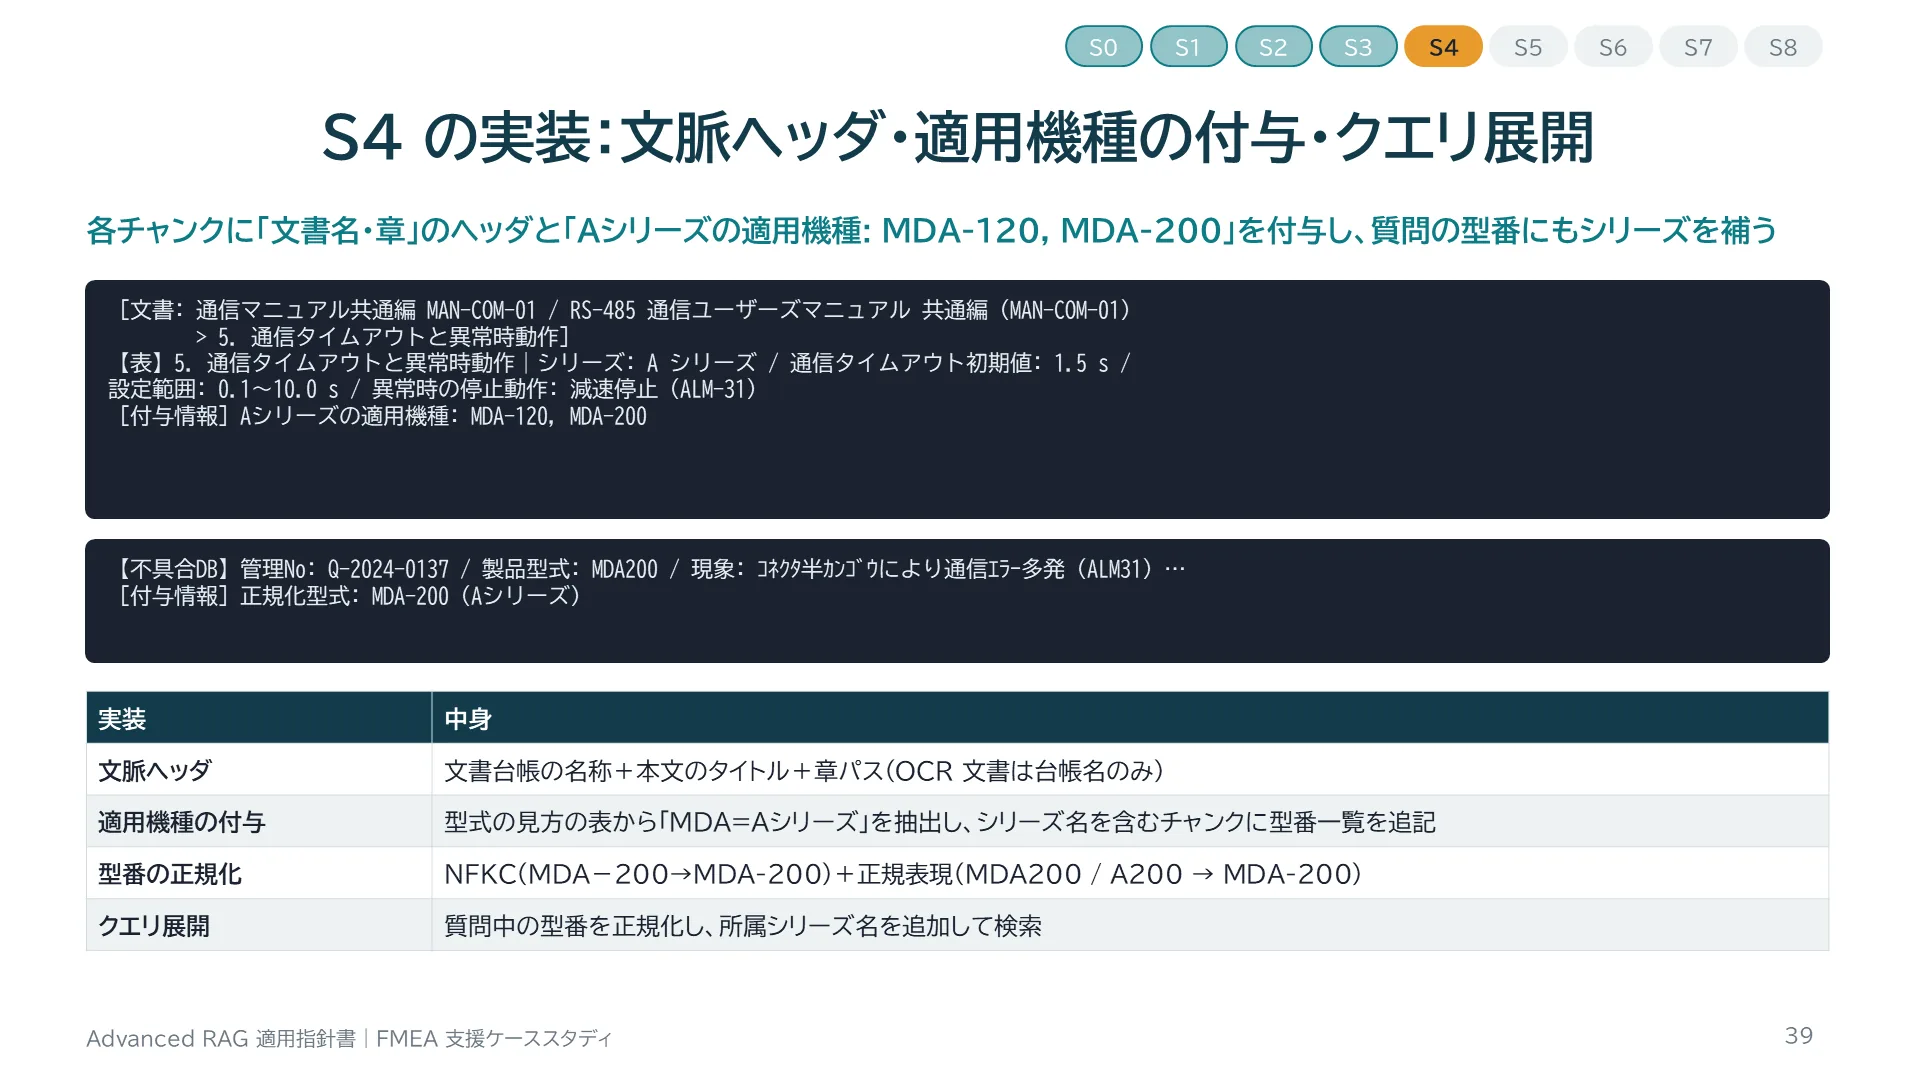
S4 の実装:文脈ヘッダ・適用機種の付与・クエリ展開
スライド 39 のテキストと解説
S4 の実装:文脈ヘッダ・適用機種の付与・クエリ展開 各チャンクに「文書名・章」のヘッダと「Aシリーズの適用機種: MDA-120, MDA-200」を付与し、質問の型番にもシリーズを補う S0 S1 S2 S3 S4 S5 S6 S7 S8 [文書: 通信マニュアル共通編 MAN-COM-01 / RS-485 通信ユーザーズマニュアル 共通編(MAN-COM-01) > 5. 通信タイムアウトと異常時動作] 【表】5. 通信タイムアウトと異常時動作|シリーズ: A シリーズ / 通信タイムアウト初期値: 1.5 s / 設定範囲: 0.1〜10.0 s / 異常時の停止動作: 減速停止(ALM-31) [付与情報]Aシリーズの適用機種: MDA-120, MDA-200 【不具合DB】管理No: Q-2024-0137 / 製品型式: MDA200 / 現象: コネクタ半カンゴウにより通信エラー多発(ALM31)… [付与情報]正規化型式: MDA-200(Aシリーズ) 実装 | 中身 文脈ヘッダ | 文書台帳の名称+本文のタイトル+章パス(OCR 文書は台帳名のみ) 適用機種の付与 | 型式の見方の表から「MDA=Aシリーズ」を抽出し、シリーズ名を含むチャンクに型番一覧を追記 型番の正規化 | NFKC(MDA-200→MDA-200)+正規表現(MDA200 / A200 → MDA-200) クエリ展開 | 質問中の型番を正規化し、所属シリーズ名を追加して検索 39
解説

実装は3つです。1つ目は文脈ヘッダで、各チャンクの先頭に「文書: 通信マニュアル共通編(MAN-COM-01)> 5. 通信タイムアウトと異常時動作」のような文書名と章のパスを付けます。前作のContextual Retrievalを、LLMを使わず構造から決定的に作る版です。2つ目は付与情報で、チャンクにシリーズ名があれば「Aシリーズの適用機種: MDA-120, MDA-200」を、型番があれば正規化した型番とシリーズを追記します。対応表は企画書の型式の見方の表から自動で作り、表記ゆれ(MDA-200、A200)はNFKC正規化と正規表現で揃えます。3つ目はクエリ展開で、質問の「MDA-200」に「Aシリーズ」を補って検索します。
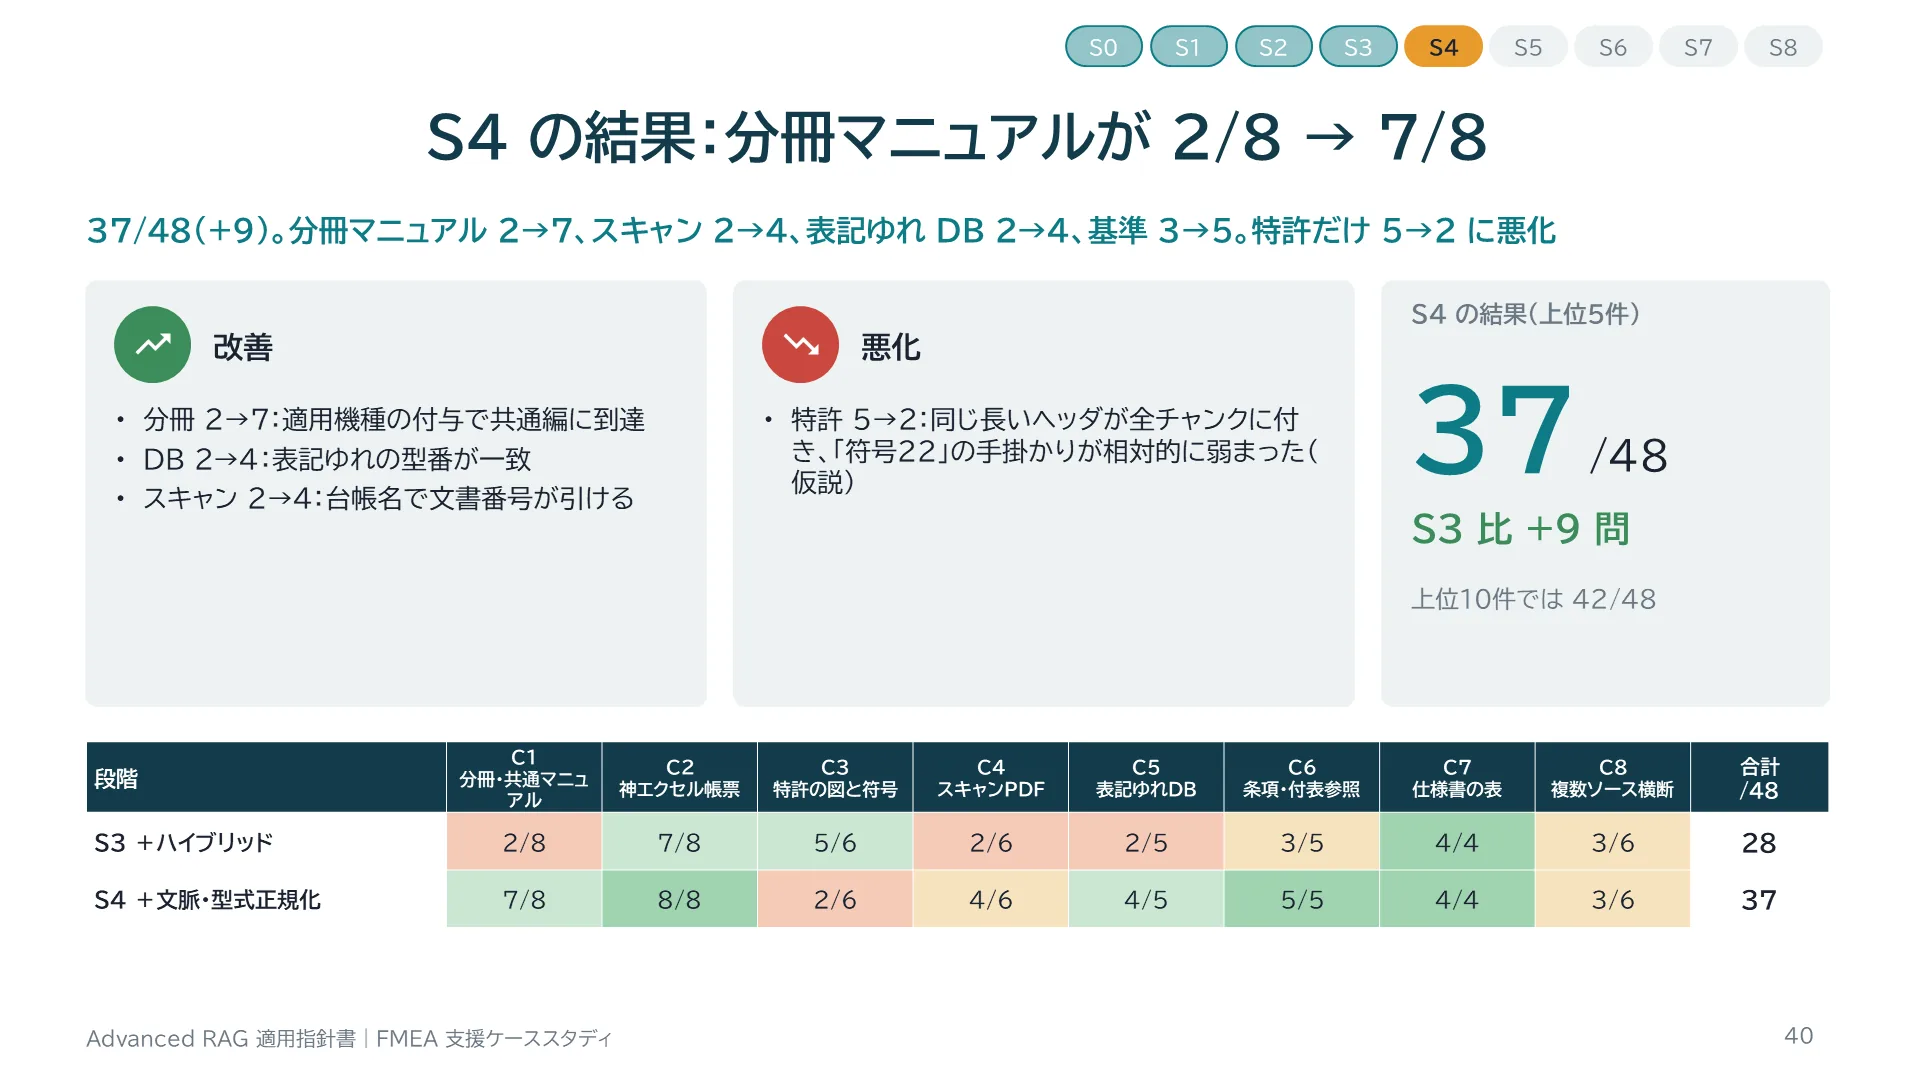
S4 の結果:分冊マニュアルが 2/8 → 7/8
スライド 40 のテキストと解説
S4 の結果:分冊マニュアルが 2/8 → 7/8 37/48(+9)。分冊マニュアル 2→7、スキャン 2→4、表記ゆれ DB 2→4、基準 3→5。特許だけ 5→2 に悪化 S0 S1 S2 S3 S4 S5 S6 S7 S8 改善 分冊 2→7:適用機種の付与で共通編に到達 DB 2→4:表記ゆれの型番が一致 スキャン 2→4:台帳名で文書番号が引ける 悪化 特許 5→2:同じ長いヘッダが全チャンクに付き、「符号22」の手掛かりが相対的に弱まった(仮説) S4 の結果(上位5件) 37 /48 S3 比 +9 問 上位10件では 42/48 段階 | C1 分冊・共通マニュアル | C2 神エクセル帳票 | C3 特許の図と符号 | C4 スキャンPDF | C5 表記ゆれDB | C6 条項・付表参照 | C7 仕様書の表 | C8 複数ソース横断 | 合計 /48 S3 +ハイブリッド | 2/8 | 7/8 | 5/6 | 2/6 | 2/5 | 3/5 | 4/4 | 3/6 | 28 S4 +文脈・型式正規化 | 7/8 | 8/8 | 2/6 | 4/6 | 4/5 | 5/5 | 4/4 | 3/6 | 37 40
解説

S4は全ステップで最大の改善で、37問になりました。分冊マニュアル(C1)は2問から7問へ大きく改善しました。不具合DB(C5)は型番の正規化によって「A200」「MDA-200」のような表記ゆれのレコードが拾えるようになり、スキャン(C4)は文書台帳名のヘッダで「8D-2024-021」などの文書番号で引けるようになりました。一方、特許(C3)は5問から2問に悪化しました。2つの特許の全チャンクに同じような長い文書ヘッダが付いたため、「符号22」のような短い手掛かりの重みが相対的に下がり、両特許のチャンクが似通ったためと考えられます。この悪化はS5の参照グラフで解消します。
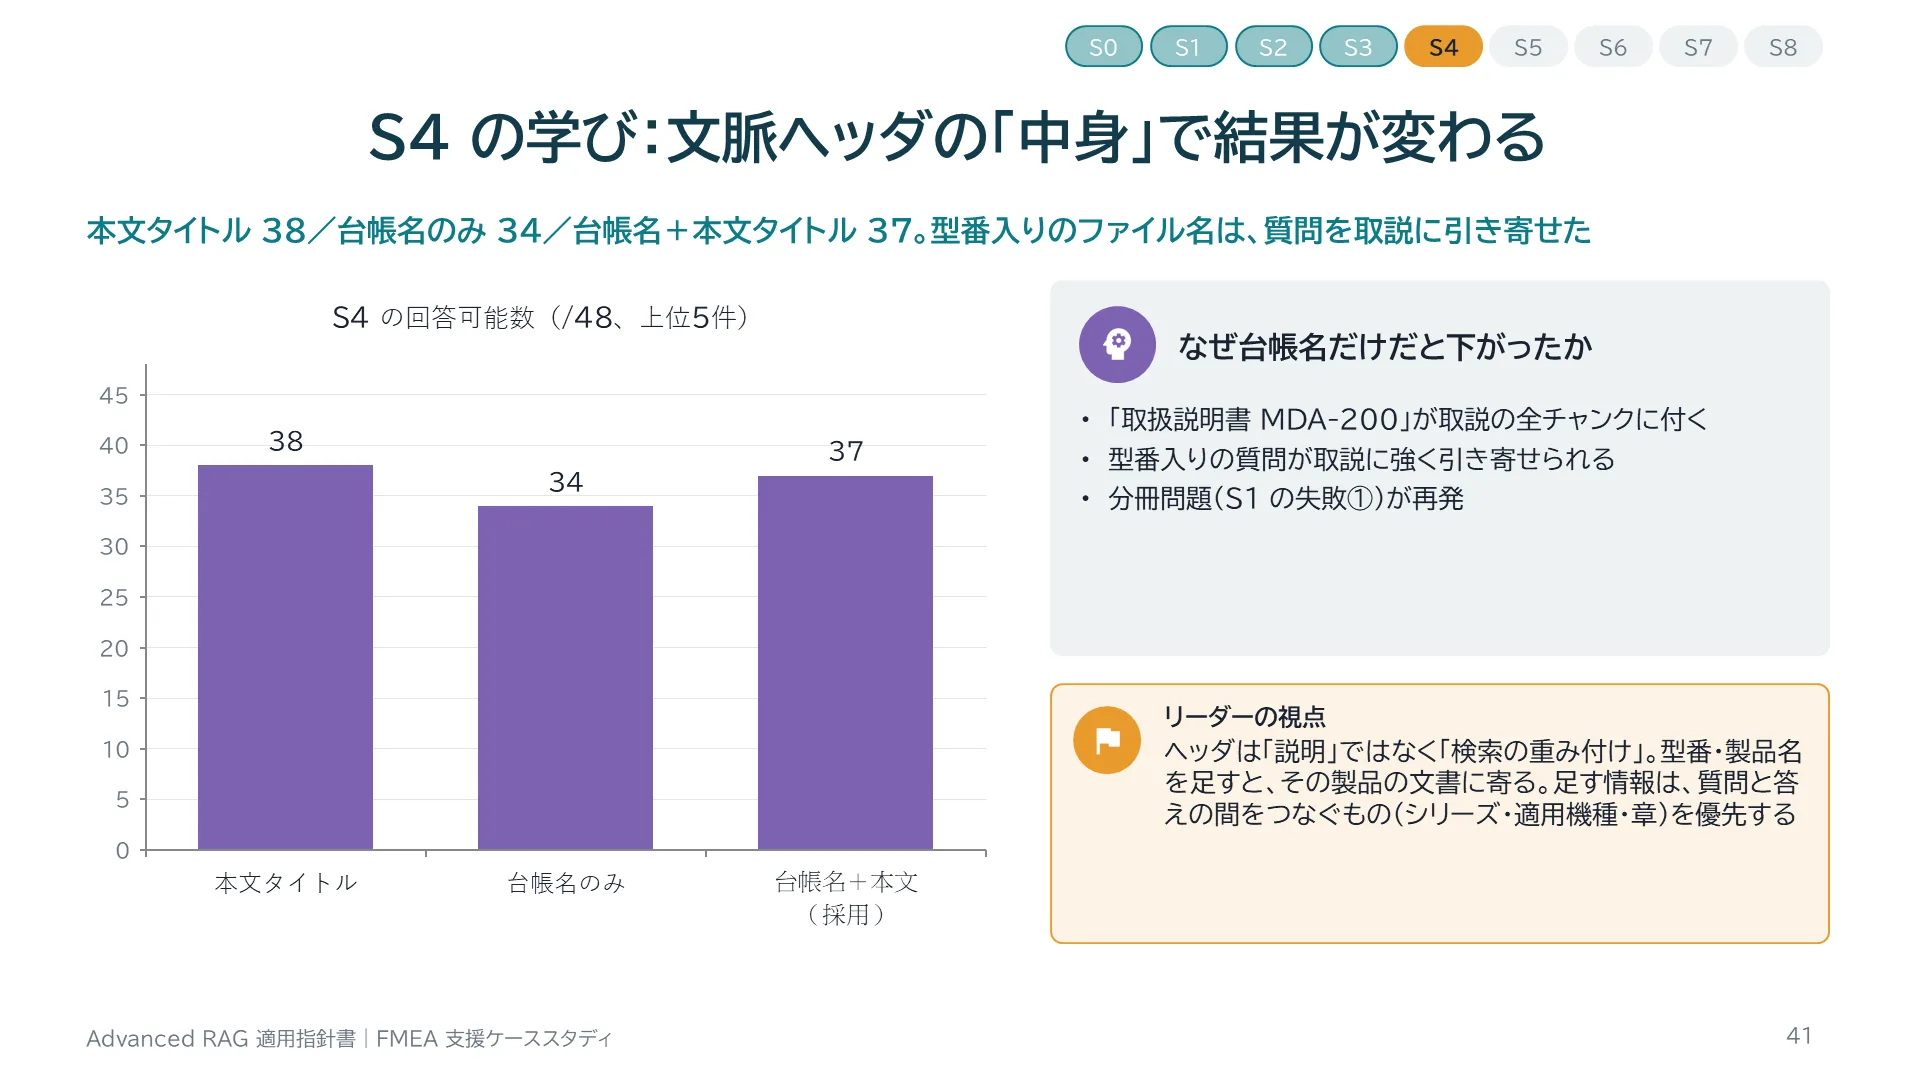
S4 の学び:文脈ヘッダの「中身」で結果が変わる
スライド 41 のテキストと解説
S4 の学び:文脈ヘッダの「中身」で結果が変わる 本文タイトル 38/台帳名のみ 34/台帳名+本文タイトル 37。型番入りのファイル名は、質問を取説に引き寄せた S0 S1 S2 S3 S4 S5 S6 S7 S8 なぜ台帳名だけだと下がったか 「取扱説明書 MDA-200」が取説の全チャンクに付く 型番入りの質問が取説に強く引き寄せられる 分冊問題(S1 の失敗①)が再発 リーダーの視点 ヘッダは「説明」ではなく「検索の重み付け」。型番・製品名を足すと、その製品の文書に寄る。足す情報は、質問と答えの間をつなぐもの(シリーズ・適用機種・章)を優先する 41
解説

文脈ヘッダに何を入れるかで結果が変わることを、実際に3通りで比べました。最初は本文から抽出したタイトルを使い38問でした。しかしスキャン文書では承認印のせいでタイトルが「所見:…」になる問題があったので、文書台帳の名称(ファイル名)に置き換えたところ34問に下がりました。台帳名は「取扱説明書 MDA-200」のように型番を強く含むため、型番入りの質問が製品取説に引き寄せられ、分冊マニュアルの問題が再発したのです。最終的に、台帳名と本文タイトルを併記し、OCR文書だけは台帳名のみにして37問にしました。どの版も1〜4問の差なので誤差の可能性はありますが、「ヘッダは検索の重み付けそのものを変える」という教訓は重要です。
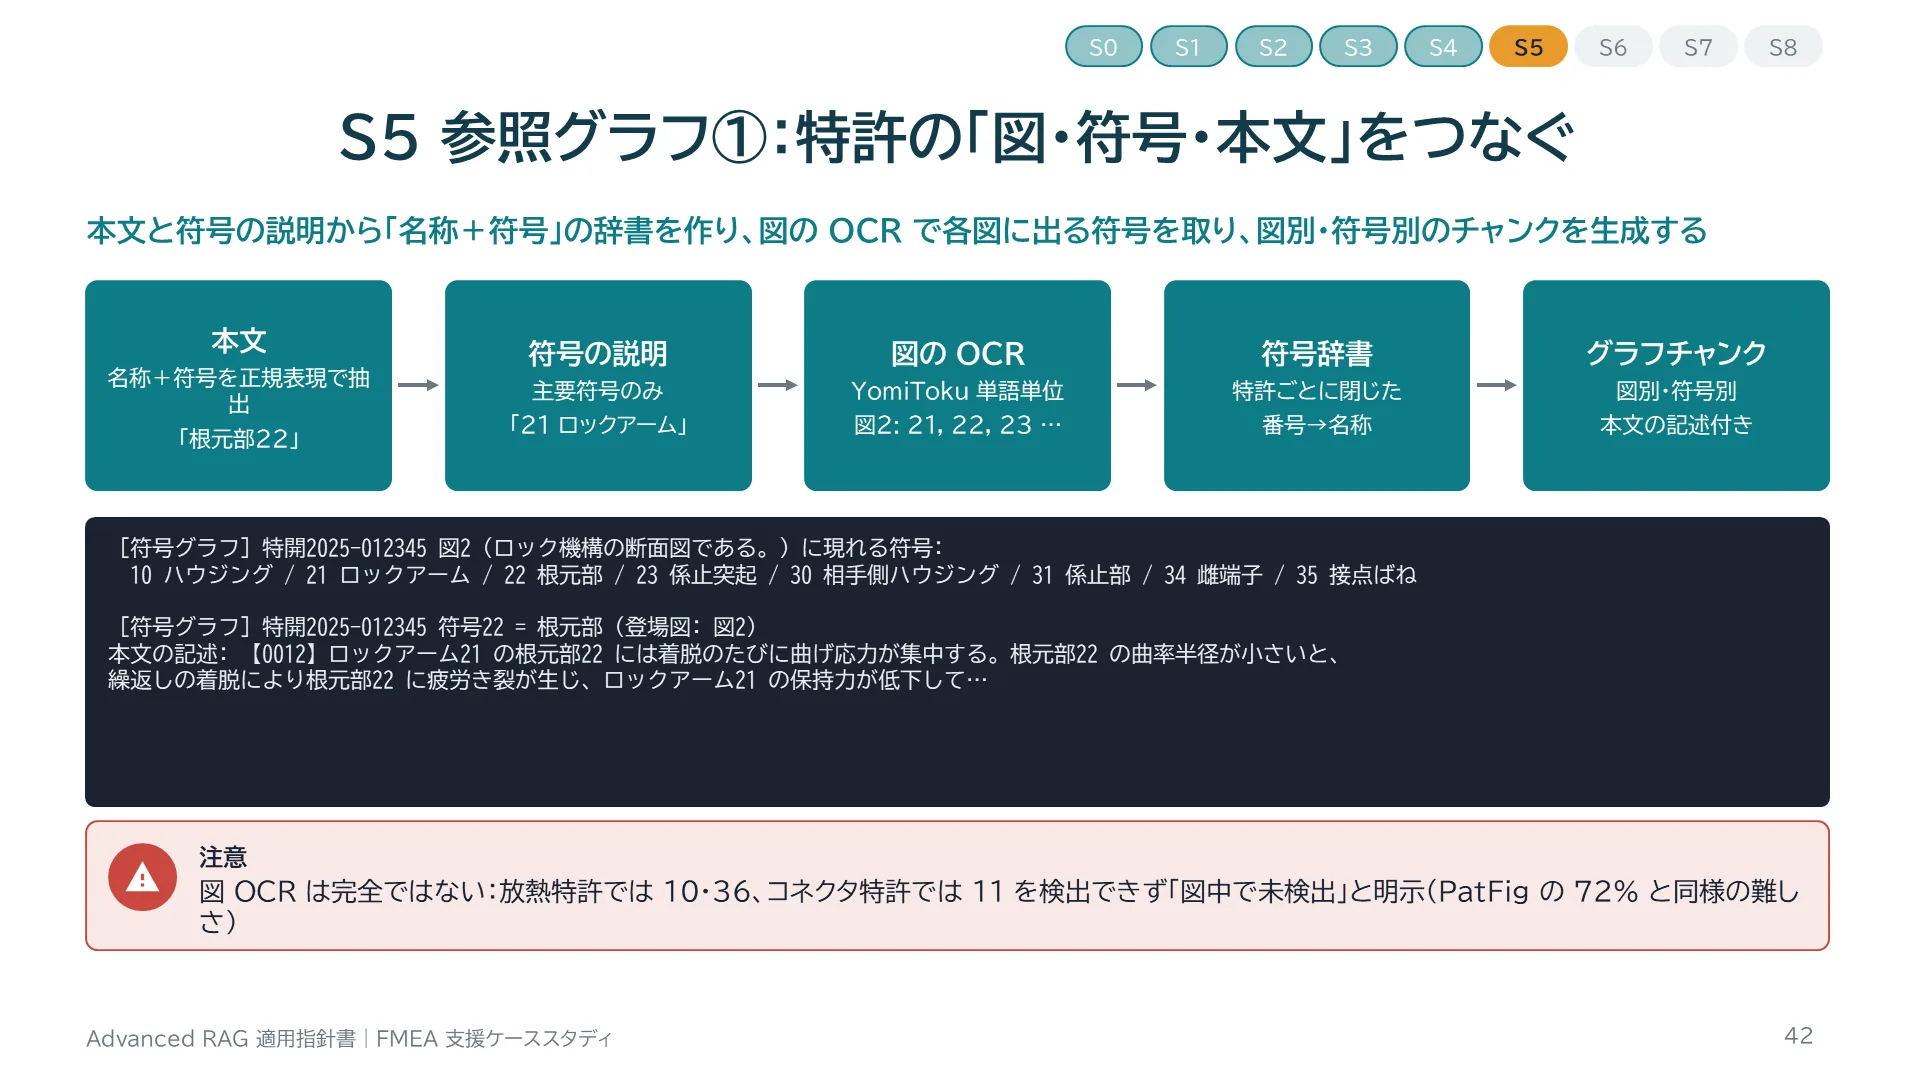
S5 参照グラフ①:特許の「図・符号・本文」をつなぐ
スライド 42 のテキストと解説
S5 参照グラフ①:特許の「図・符号・本文」をつなぐ 本文と符号の説明から「名称+符号」の辞書を作り、図の OCR で各図に出る符号を取り、図別・符号別のチャンクを生成する S0 S1 S2 S3 S4 S5 S6 S7 S8 本文 名称+符号を正規表現で抽出 「根元部22」 符号の説明 主要符号のみ 「21 ロックアーム」 図の OCR YomiToku 単語単位 図2: 21, 22, 23 … 符号辞書 特許ごとに閉じた 番号→名称 グラフチャンク 図別・符号別 本文の記述付き [符号グラフ]特開2025-012345 図2(ロック機構の断面図である。)に現れる符号: 10 ハウジング / 21 ロックアーム / 22 根元部 / 23 係止突起 / 30 相手側ハウジング / 31 係止部 / 34 雌端子 / 35 接点ばね [符号グラフ]特開2025-012345 符号22 = 根元部(登場図: 図2) 本文の記述: 【0012】ロックアーム21 の根元部22 には着脱のたびに曲げ応力が集中する。根元部22 の曲率半径が小さいと、 繰返しの着脱により根元部22 に疲労き裂が生じ、ロックアーム21 の保持力が低下して… 注意 図 OCR は完全ではない:放熱特許では 10・36、コネクタ特許では 11 を検出できず「図中で未検出」と明示(PatFig の 72% と同様の難しさ) 42
解説

S5の1つ目は特許の符号グラフです。まず本文から「ロックアーム21」「根元部22」のような名称と符号の組を正規表現で抜き出し、符号の説明の表と合わせて符号辞書を作ります。助詞の「の」「は」で語を区切る簡単な規則で、名称の取り違えを防いでいます。次に、PDFから図の画像を取り出してYomiTokuで単語単位のOCRをかけ、各図に現れる数字を取ります。最後に、図ごとに「図2(ロック機構の断面図)に現れる符号: 10 ハウジング / 21 ロックアーム / 22 根元部…」、符号ごとに「符号22 = 根元部(登場図: 図2)+本文の記述」というチャンクを作ります。符号の範囲は特許ごとに閉じているので、別の特許の符号23(放熱フィン)と混ざりません。
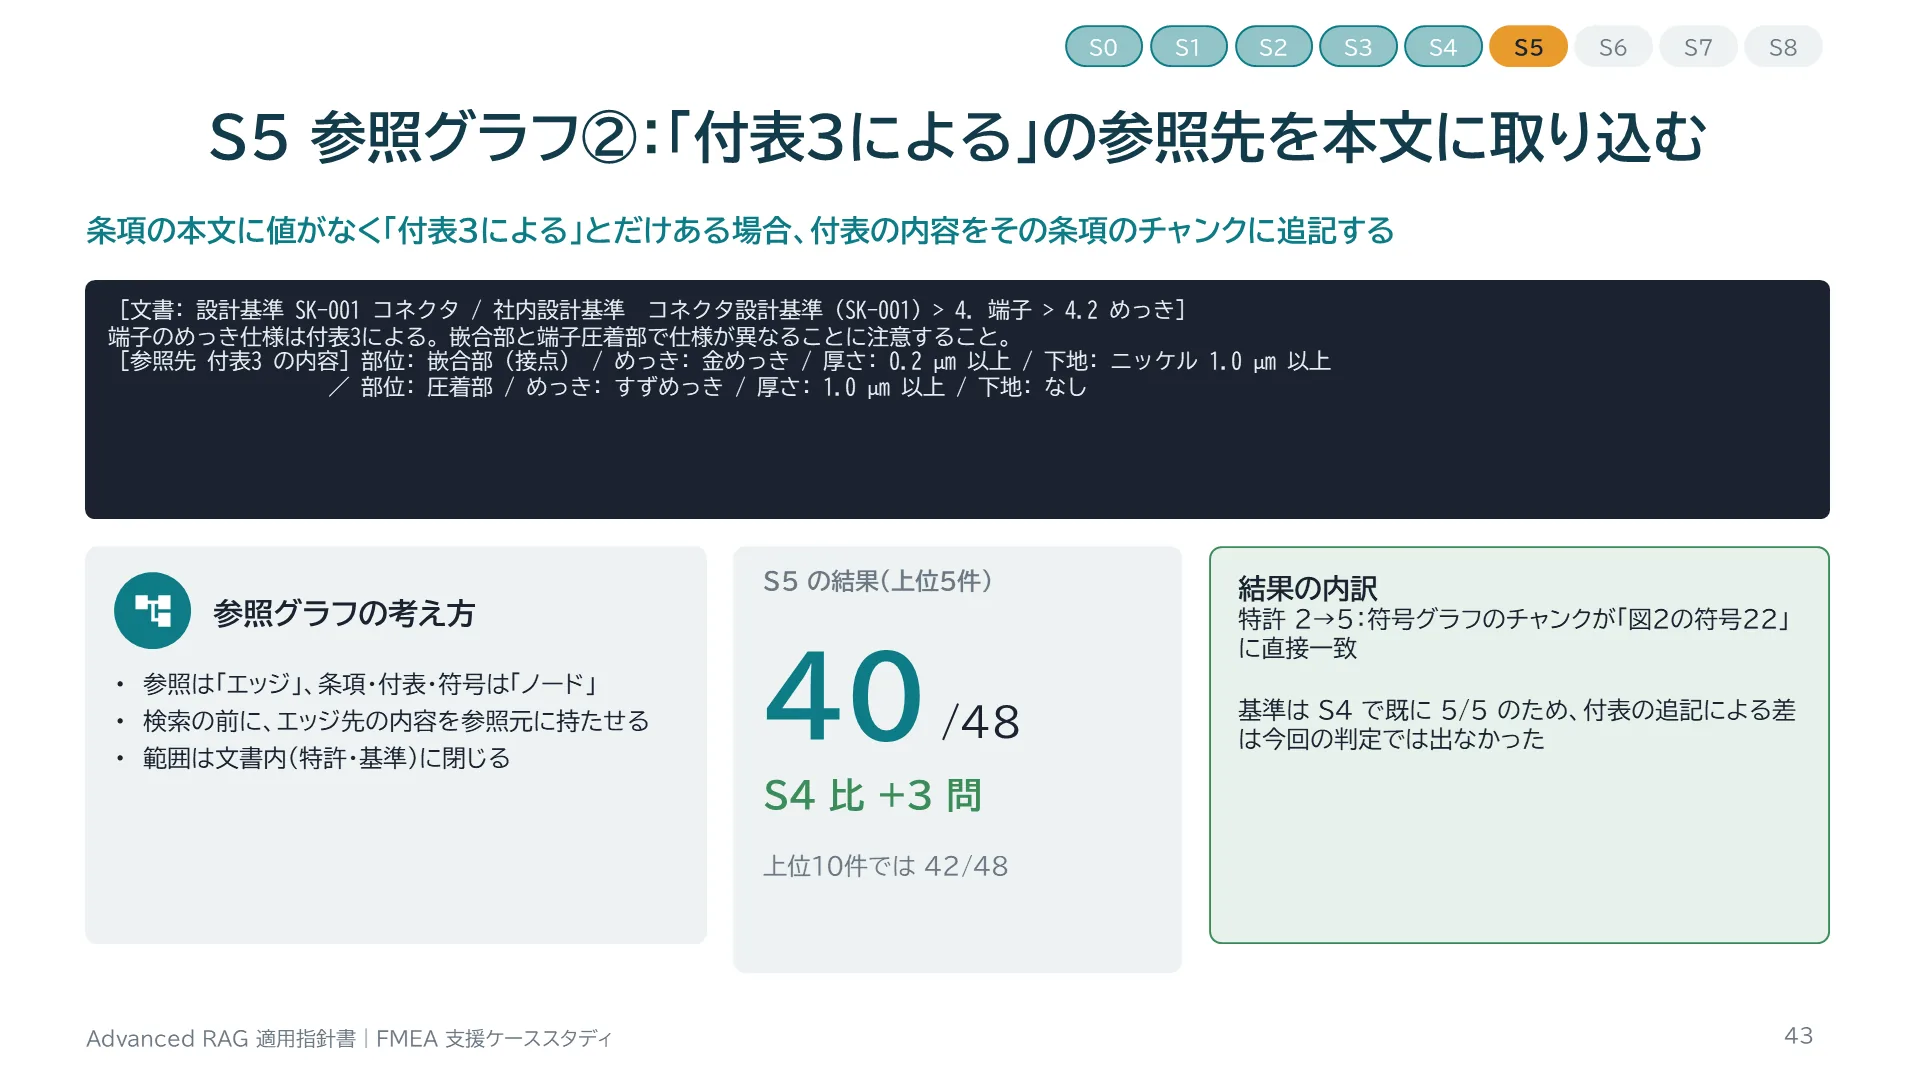
S5 参照グラフ②:「付表3による」の参照先を本文に取り込む
スライド 43 のテキストと解説
S5 参照グラフ②:「付表3による」の参照先を本文に取り込む 条項の本文に値がなく「付表3による」とだけある場合、付表の内容をその条項のチャンクに追記する S0 S1 S2 S3 S4 S5 S6 S7 S8 [文書: 設計基準 SK-001 コネクタ / 社内設計基準 コネクタ設計基準(SK-001)> 4. 端子 > 4.2 めっき] 端子のめっき仕様は付表3による。嵌合部と端子圧着部で仕様が異なることに注意すること。 [参照先 付表3 の内容]部位: 嵌合部(接点) / めっき: 金めっき / 厚さ: 0.2 µm 以上 / 下地: ニッケル 1.0 µm 以上 / 部位: 圧着部 / めっき: すずめっき / 厚さ: 1.0 µm 以上 / 下地: なし 参照グラフの考え方 参照は「エッジ」、条項・付表・符号は「ノード」 検索の前に、エッジ先の内容を参照元に持たせる 範囲は文書内(特許・基準)に閉じる S5 の結果(上位5件) 40 /48 S4 比 +3 問 上位10件では 42/48 結果の内訳 特許 2→5:符号グラフのチャンクが「図2の符号22」に直接一致 基準は S4 で既に 5/5 のため、付表の追記による差は今回の判定では出なかった 43
解説

S5の2つ目は、社内基準の「付表3による」のような参照の解決です。条項4.2「めっき」の本文には「端子のめっき仕様は付表3による」とだけあり、値は文書末尾の付表3にあります。条項と付表が別々のチャンクになると、「嵌合部のめっき仕様は?」という質問に条項4.2が当たっても値がありません。そこで、同じ文書内の付表の行を、参照している条項のチャンクに追記しました。前作で学んだ「参照主義」の文書を、検索用に逆展開する処理です。
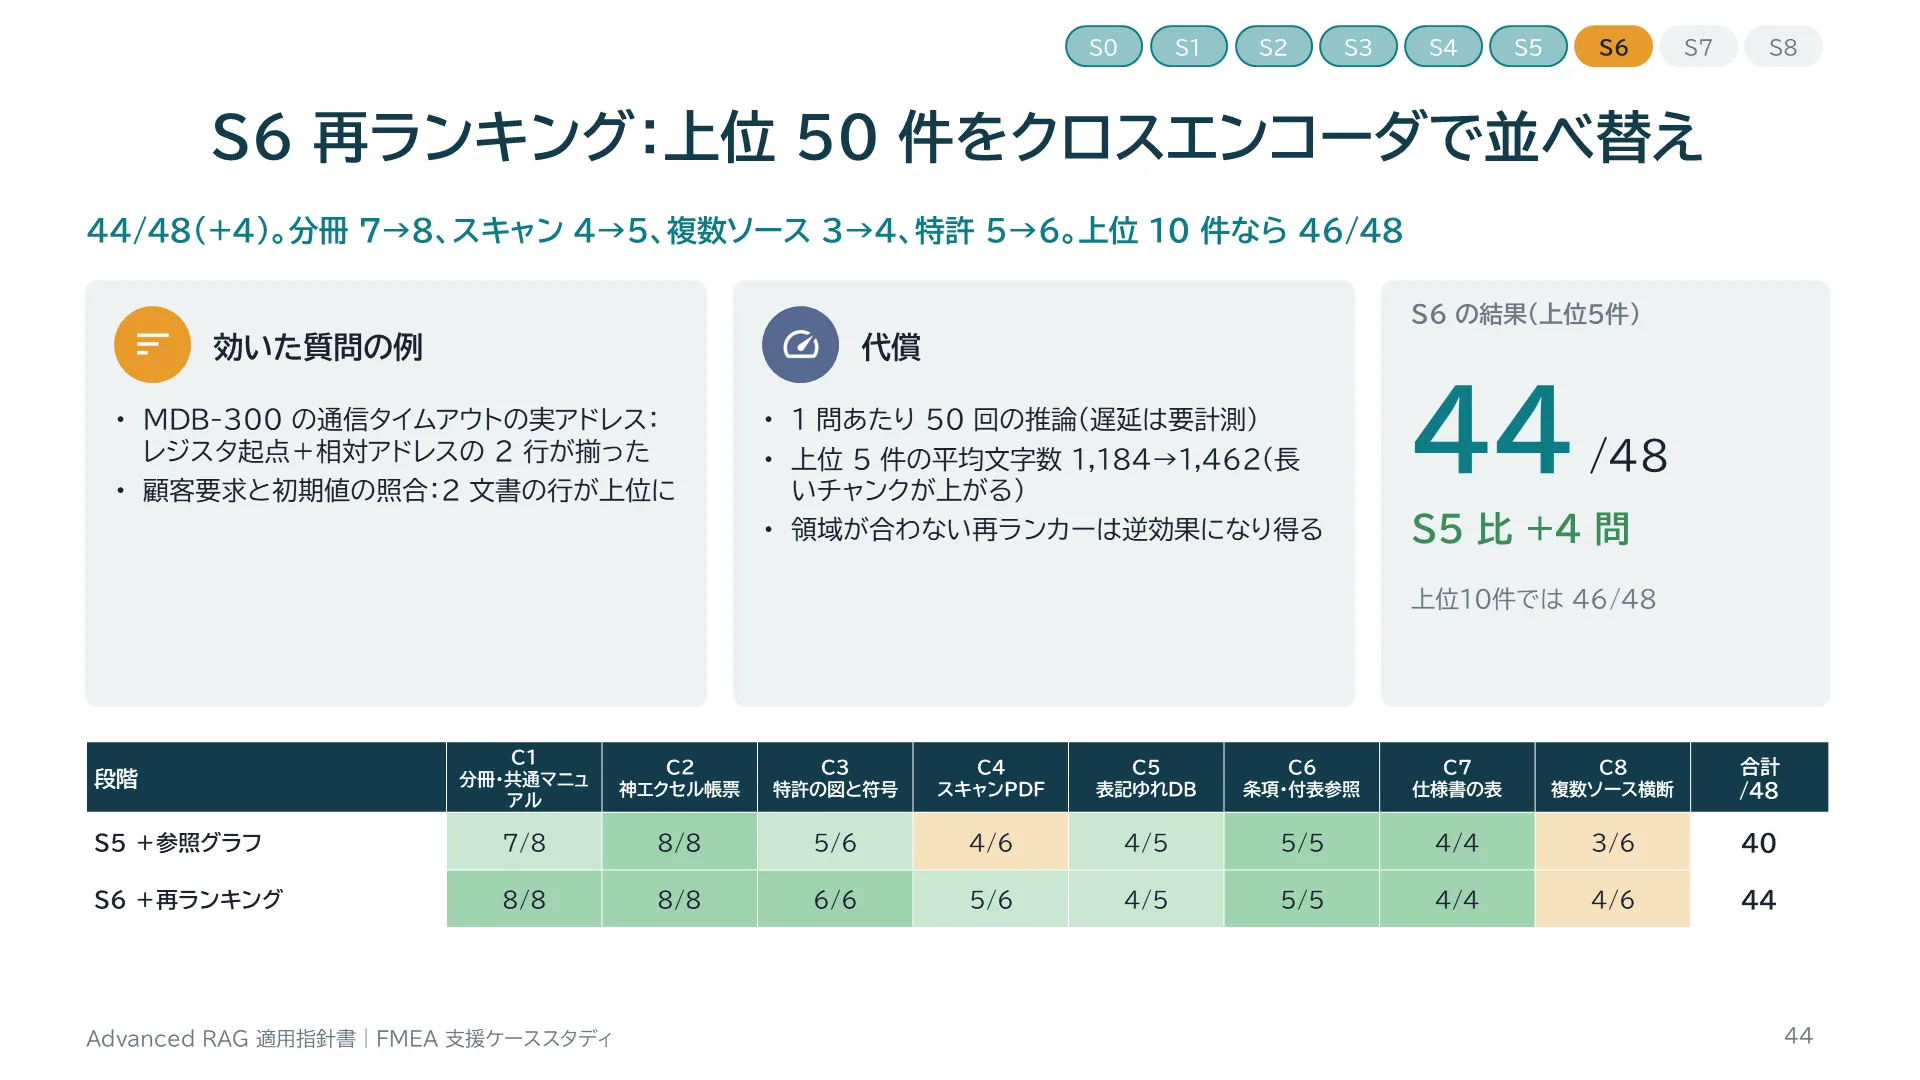
S6 再ランキング:上位 50 件をクロスエンコーダで並べ替え
スライド 44 のテキストと解説
S6 再ランキング:上位 50 件をクロスエンコーダで並べ替え 44/48(+4)。分冊 7→8、スキャン 4→5、複数ソース 3→4、特許 5→6。上位 10 件なら 46/48 S0 S1 S2 S3 S4 S5 S6 S7 S8 効いた質問の例 MDB-300 の通信タイムアウトの実アドレス:レジスタ起点+相対アドレスの 2 行が揃った 顧客要求と初期値の照合:2 文書の行が上位に 代償 1 問あたり 50 回の推論(遅延は要計測) 上位 5 件の平均文字数 1,184→1,462(長いチャンクが上がる) 領域が合わない再ランカーは逆効果になり得る S6 の結果(上位5件) 44 /48 S5 比 +4 問 上位10件では 46/48 段階 | C1 分冊・共通マニュアル | C2 神エクセル帳票 | C3 特許の図と符号 | C4 スキャンPDF | C5 表記ゆれDB | C6 条項・付表参照 | C7 仕様書の表 | C8 複数ソース横断 | 合計 /48 S5 +参照グラフ | 7/8 | 8/8 | 5/6 | 4/6 | 4/5 | 5/5 | 4/4 | 3/6 | 40 S6 +再ランキング | 8/8 | 8/8 | 6/6 | 5/6 | 4/5 | 5/5 | 4/4 | 4/6 | 44 44
解説

S6では、ハイブリッド検索の上位50件を、日本語のクロスエンコーダcl-nagoya/ruri-v3-reranker-310mで並べ替えてから上位5件を取りました。44問、上位10件なら46問です。再ランキングは質問とチャンクを一緒に読むので、「MDB-300の通信タイムアウトの実アドレス」のように、Bシリーズのレジスタ起点と相対アドレスの2行が必要な質問で、両方を上位に引き上げられました。前作で見たBRIGHTのように領域が合わないと逆効果になることもありますが、今回は全カテゴリで悪化はありませんでした。代償として、1問あたり50回のクロスエンコーダ推論が増えます(本検証では遅延を計測していないので、本番ではp95遅延を測ってください)。
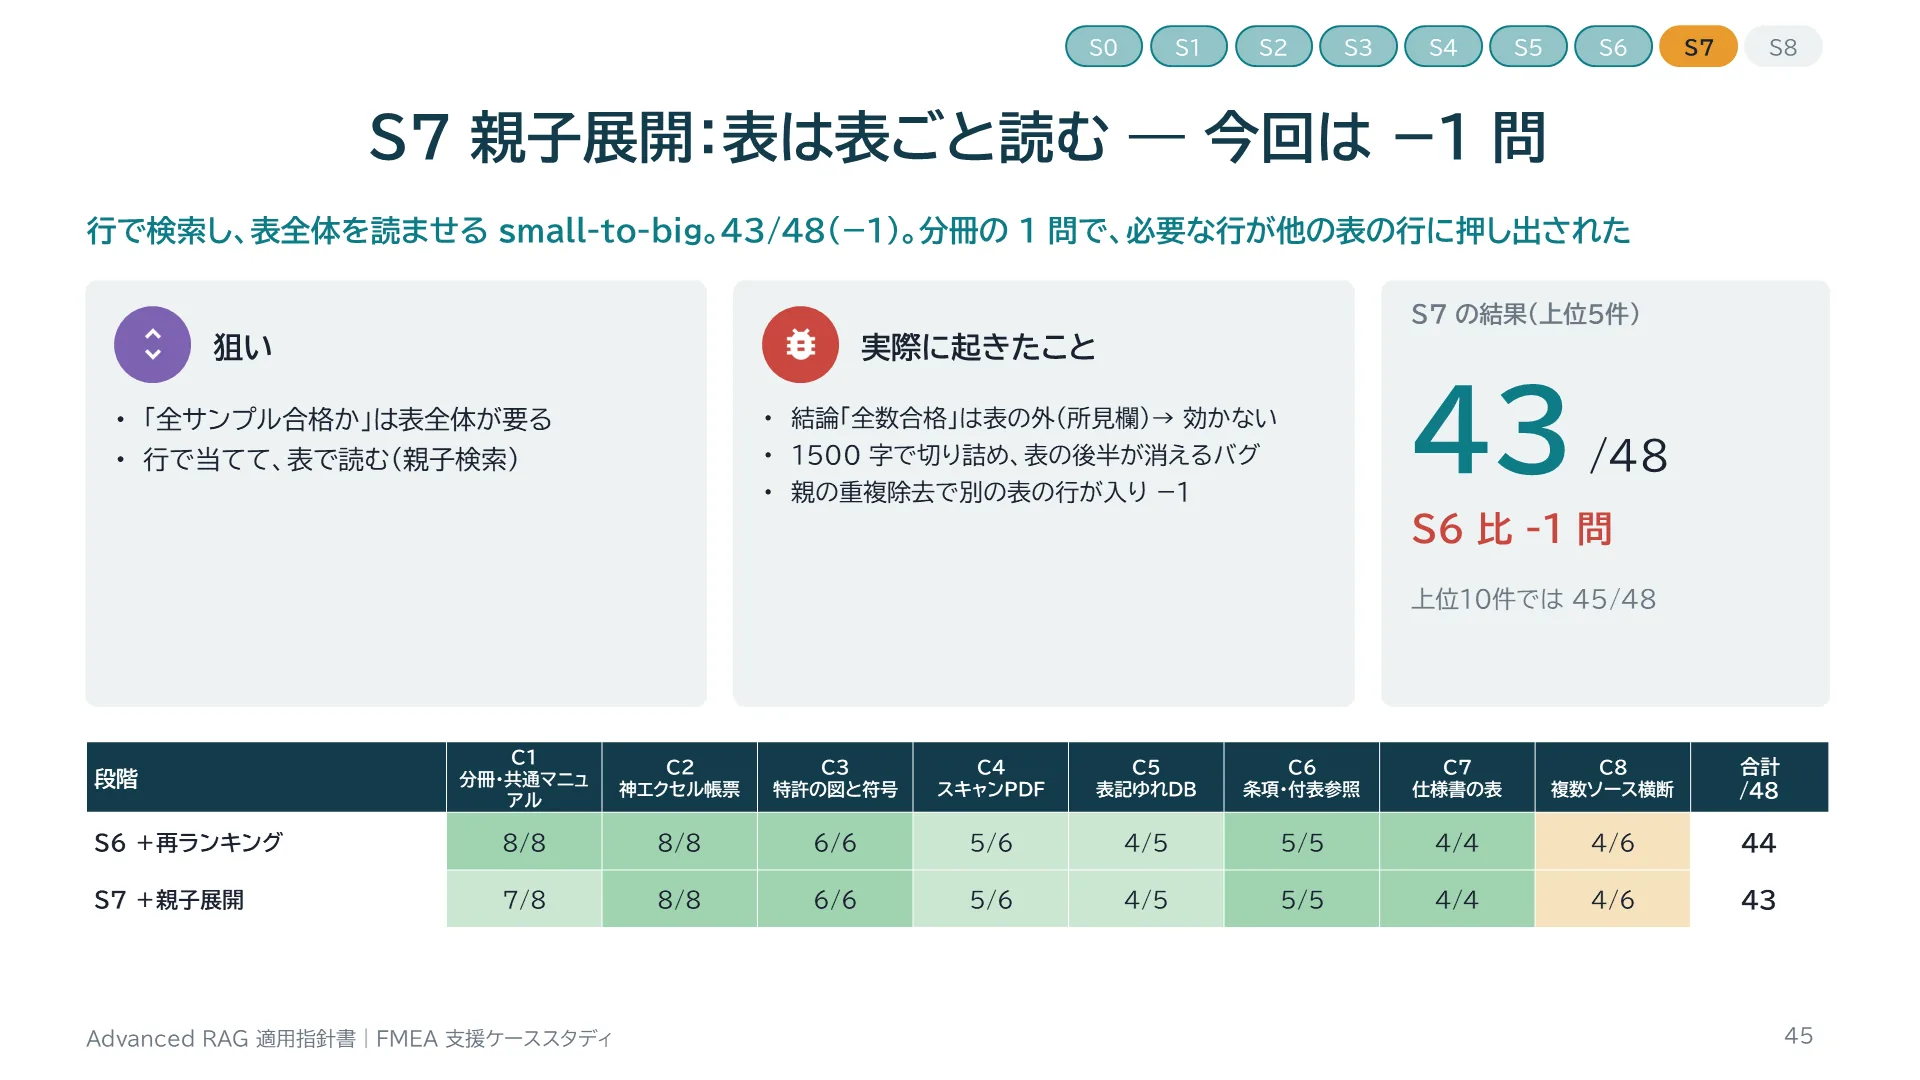
S7 親子展開:表は表ごと読む ― 今回は −1 問
スライド 45 のテキストと解説
S7 親子展開:表は表ごと読む ― 今回は −1 問 行で検索し、表全体を読ませる small-to-big。43/48(−1)。分冊の 1 問で、必要な行が他の表の行に押し出された S0 S1 S2 S3 S4 S5 S6 S7 S8 狙い 「全サンプル合格か」は表全体が要る 行で当てて、表で読む(親子検索) 実際に起きたこと 結論「全数合格」は表の外(所見欄)→ 効かない 1500 字で切り詰め、表の後半が消えるバグ 親の重複除去で別の表の行が入り −1 S7 の結果(上位5件) 43 /48 S6 比 -1 問 上位10件では 45/48 段階 | C1 分冊・共通マニュアル | C2 神エクセル帳票 | C3 特許の図と符号 | C4 スキャンPDF | C5 表記ゆれDB | C6 条項・付表参照 | C7 仕様書の表 | C8 複数ソース横断 | 合計 /48 S6 +再ランキング | 8/8 | 8/8 | 6/6 | 5/6 | 4/5 | 5/5 | 4/4 | 4/6 | 44 S7 +親子展開 | 7/8 | 8/8 | 6/6 | 5/6 | 4/5 | 5/5 | 4/4 | 4/6 | 43 45
解説

S7は前作の親子検索です。表の1行で当たったら、その表全体(親)に差し替えてLLMに渡します。狙いは「全サンプル合格か」のような、表全体を見ないと答えられない質問でした。結果は43問で1問減りました。分冊マニュアルの質問で、親に差し替えたことで同じ表の行の重複が除かれ、代わりに入った別の表の行で必要事実が足りなくなったためです。実装中には、親の文字数を1500字で切り捨てたせいで、大きな表の後半の行が消えるバグもありました(大きな表は展開しない、に修正)。狙っていた試験報告書の「全数合格」は、結論が表の外の所見欄にあるため、表を展開しても解決しませんでした。
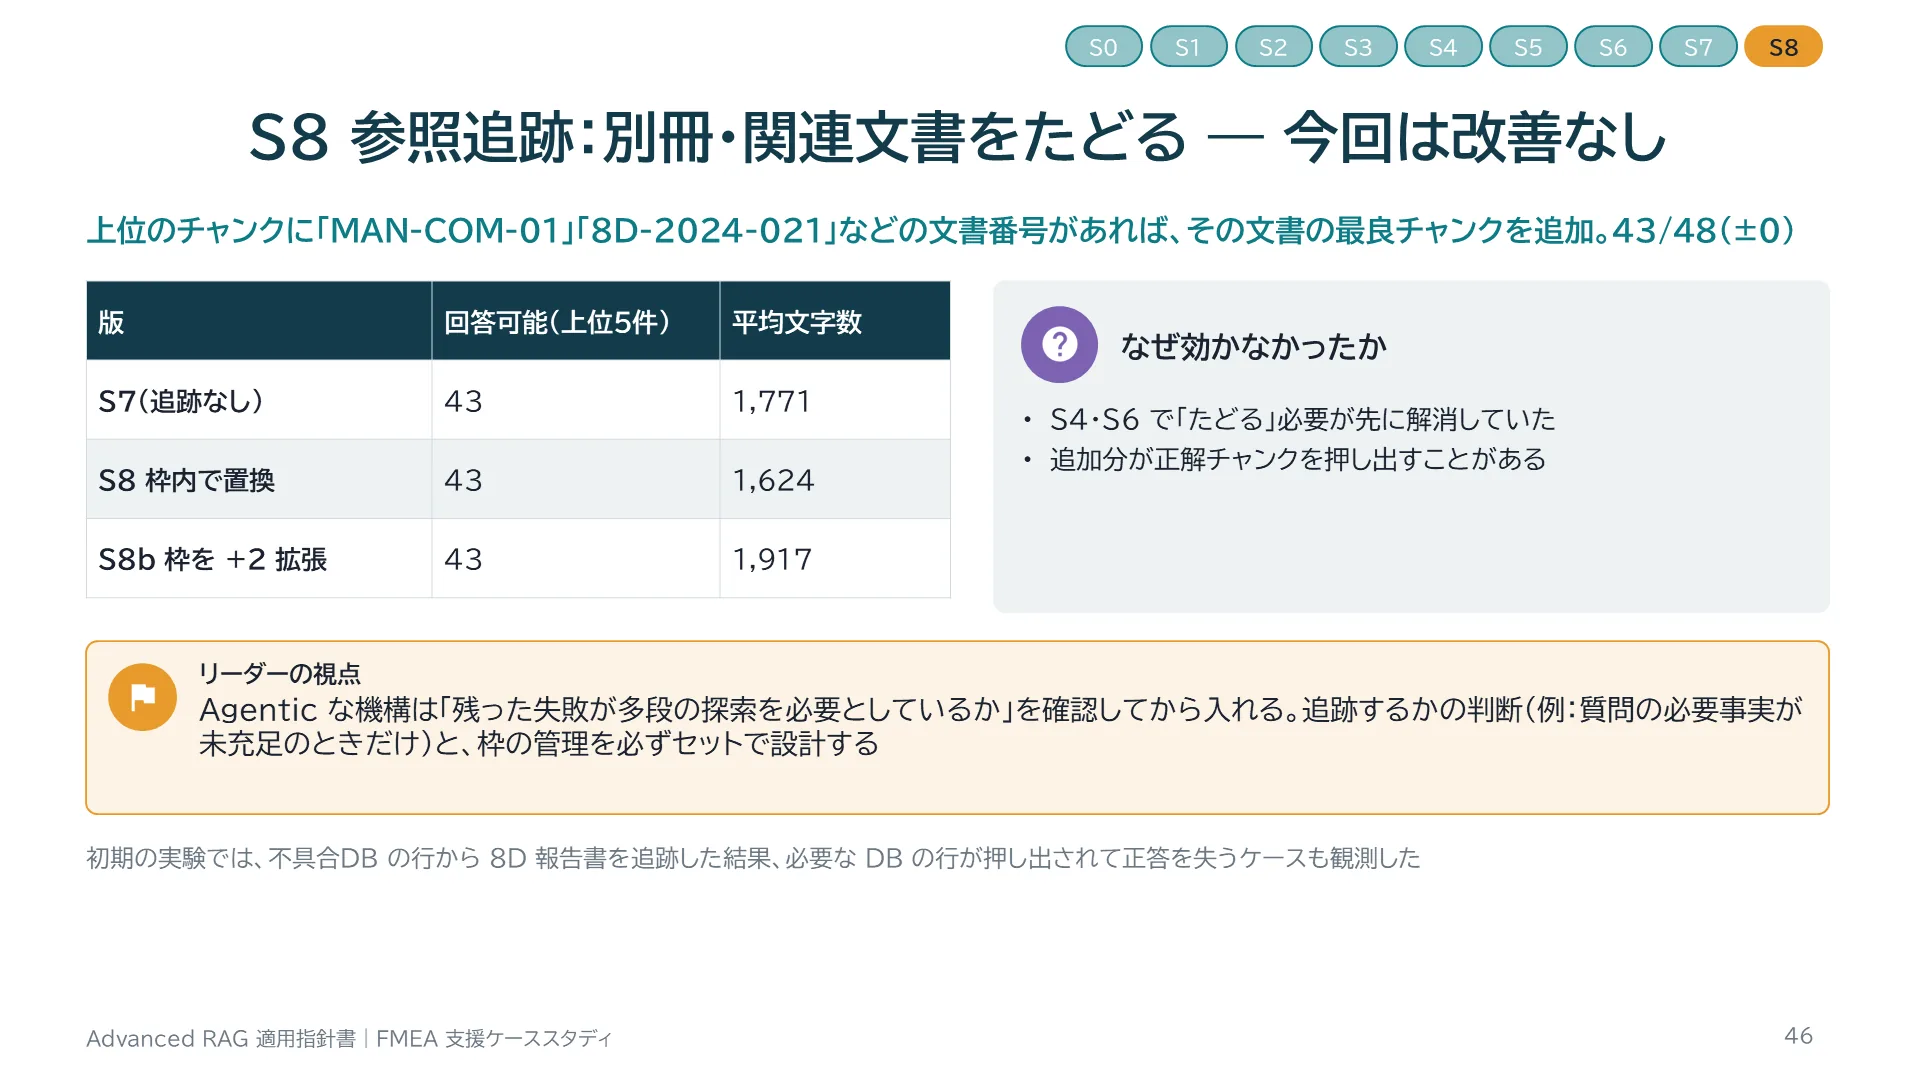
S8 参照追跡:別冊・関連文書をたどる ― 今回は改善なし
スライド 46 のテキストと解説
S8 参照追跡:別冊・関連文書をたどる ― 今回は改善なし 上位のチャンクに「MAN-COM-01」「8D-2024-021」などの文書番号があれば、その文書の最良チャンクを追加。43/48(±0) S0 S1 S2 S3 S4 S5 S6 S7 S8 版 | 回答可能(上位5件) | 平均文字数 S7(追跡なし) | 43 | 1,771 S8 枠内で置換 | 43 | 1,624 S8b 枠を +2 拡張 | 43 | 1,917 なぜ効かなかったか S4・S6 で「たどる」必要が先に解消していた 追加分が正解チャンクを押し出すことがある リーダーの視点 Agentic な機構は「残った失敗が多段の探索を必要としているか」を確認してから入れる。追跡するかの判断(例:質問の必要事実が未充足のときだけ)と、枠の管理を必ずセットで設計する 初期の実験では、不具合DB の行から 8D 報告書を追跡した結果、必要な DB の行が押し出されて正答を失うケースも観測した 46
解説

S8は、前作のAgentic RAGを単純化した参照追跡です。上位のチャンクが別の文書番号を参照していたら、その文書に絞った検索で最良のチャンクを取り、最大2件まで加えます。枠内で置き換える版も、枠を2件増やす版も、43問で改善しませんでした。理由は2つあります。S4の適用機種の付与とS6の再ランキングで、取説から共通編へ「たどる」必要がすでになくなっていたこと。そして、追加したチャンクが既存の正解チャンクを押し出す場合があったことです。初期の実験では、不具合DBの行から8D報告書を追跡した結果、必要な不具合DBの行が押し出されて正答が失われるケースも観測しました。追跡するかどうかの判断(ゲート)と、枠の管理がないと、Agentic的な機構はコストだけを増やします。
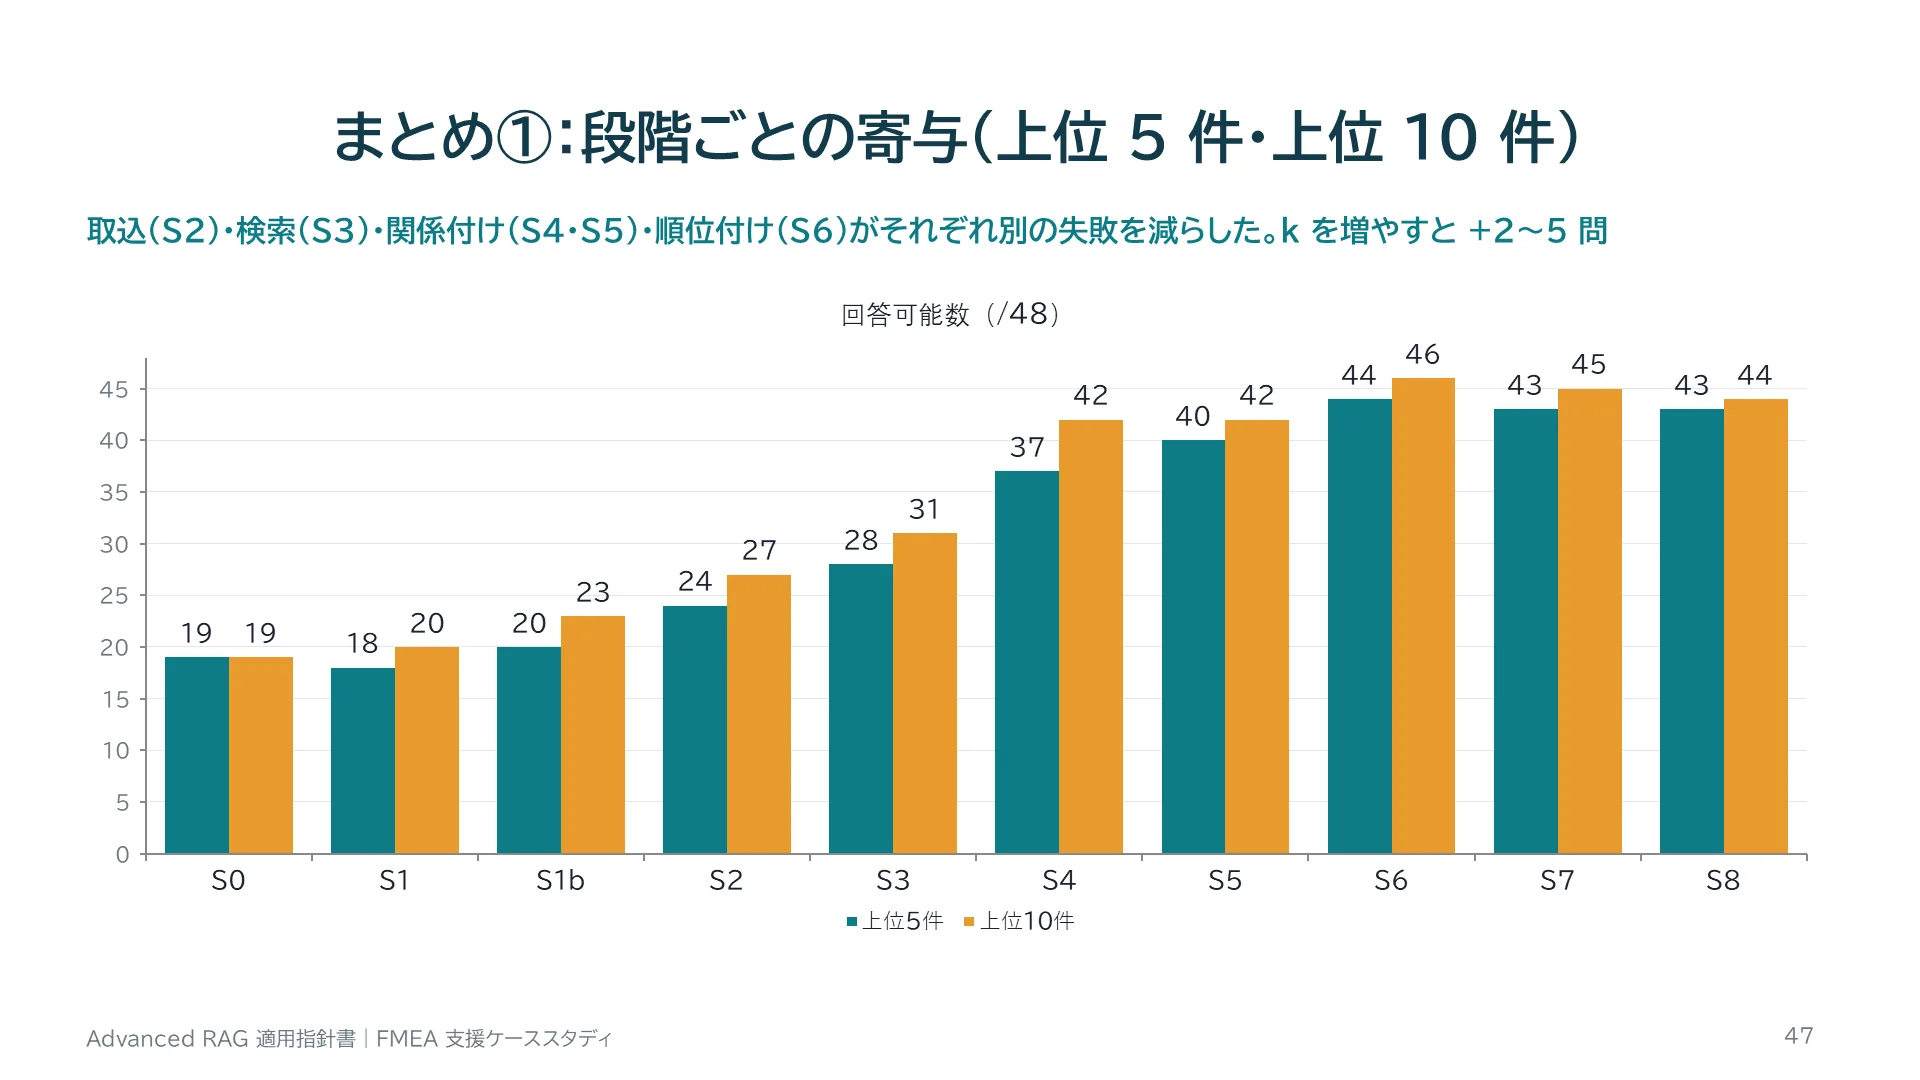
まとめ①:段階ごとの寄与(上位 5 件・上位 10 件)
スライド 47 のテキストと解説
まとめ①:段階ごとの寄与(上位 5 件・上位 10 件) 取込(S2)・検索(S3)・関係付け(S4・S5)・順位付け(S6)がそれぞれ別の失敗を減らした。k を増やすと +2〜5 問 47
解説

全段階の回答可能数を、上位5件と上位10件で並べました。上位10件にすると、多くの段階で2〜5問増えます。コンテキストを増やすことで救える質問がある一方、上位5件で44問、上位10件で46問という差は、コストと遅延に見合うかで判断します。注目すべきは、S1とS1bの差(検索だけの改善)よりも、S1とS2の差(取込の改善)、S3とS4の差(関係付け)のほうがずっと大きいことです。
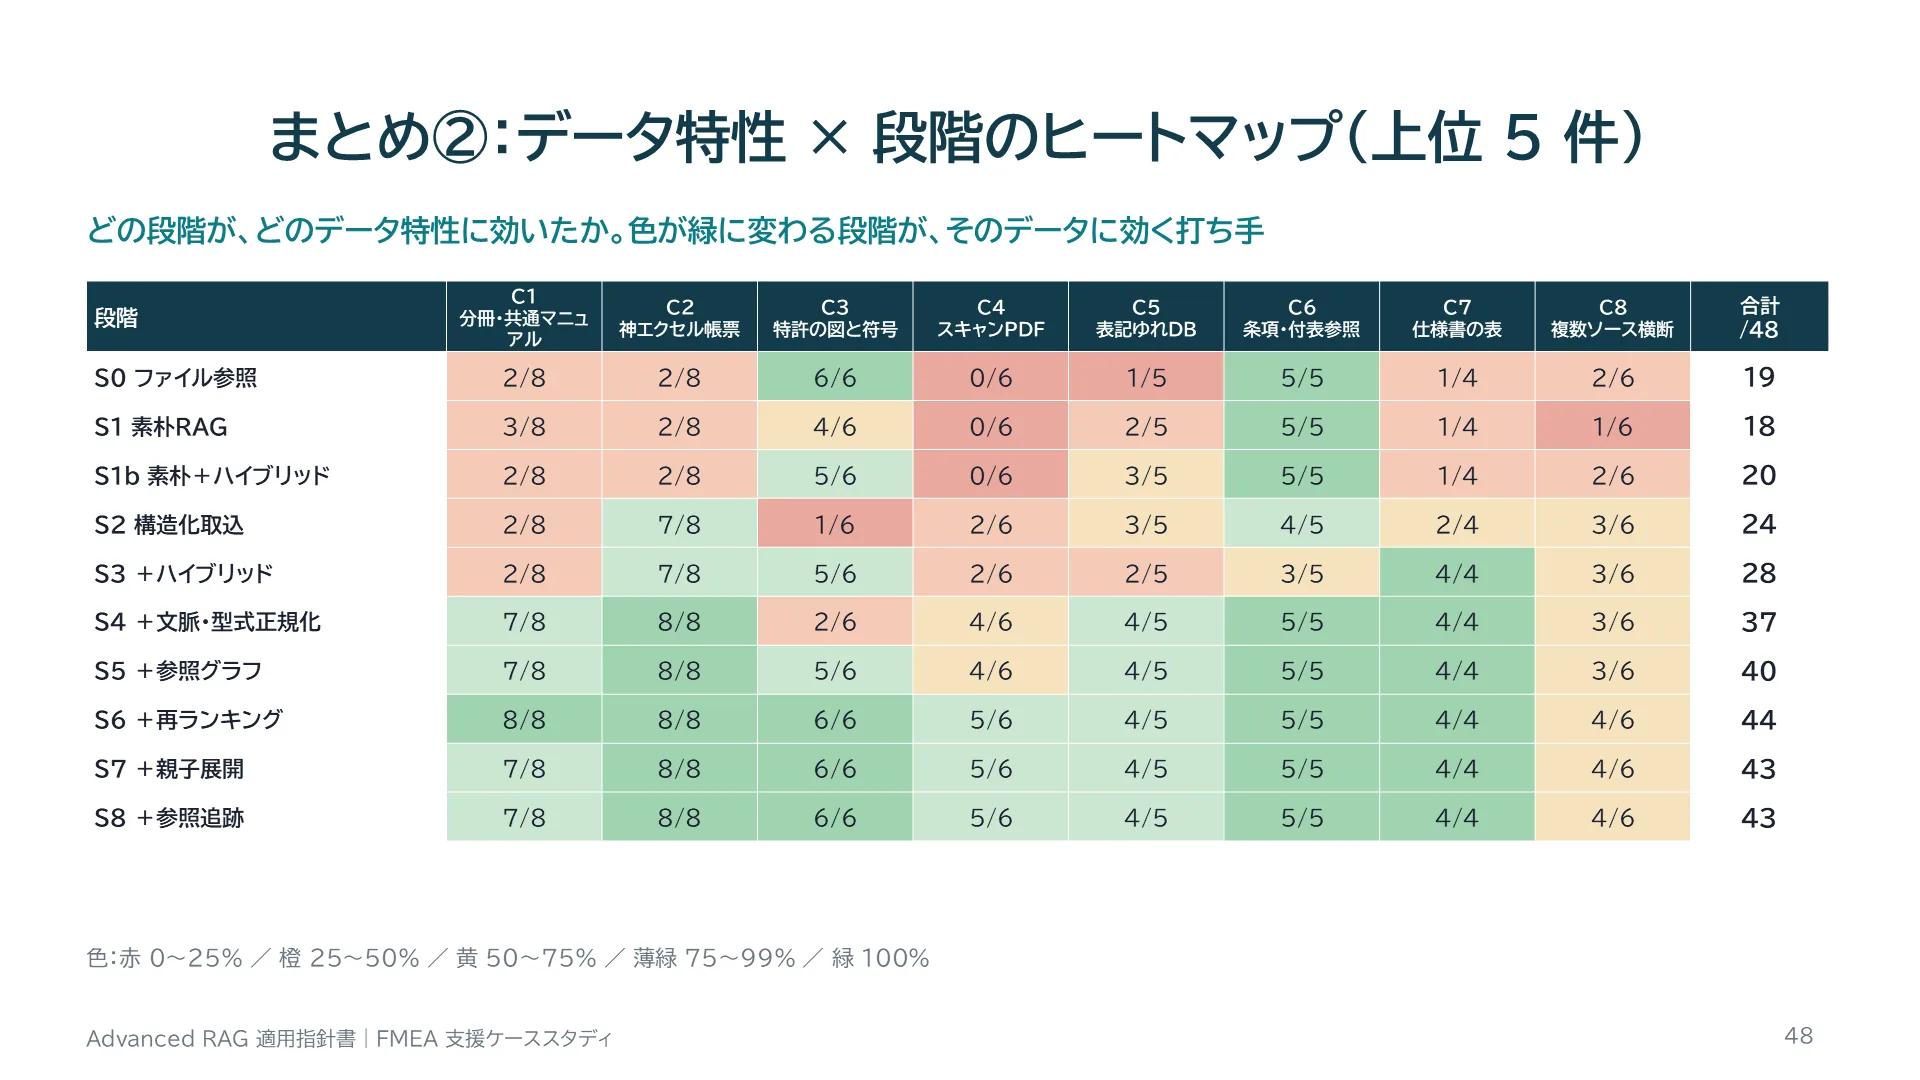
まとめ②:データ特性 × 段階のヒートマップ(上位 5 件)
スライド 48 のテキストと解説
まとめ②:データ特性 × 段階のヒートマップ(上位 5 件) どの段階が、どのデータ特性に効いたか。色が緑に変わる段階が、そのデータに効く打ち手 段階 | C1 分冊・共通マニュアル | C2 神エクセル帳票 | C3 特許の図と符号 | C4 スキャンPDF | C5 表記ゆれDB | C6 条項・付表参照 | C7 仕様書の表 | C8 複数ソース横断 | 合計 /48 S0 ファイル参照 | 2/8 | 2/8 | 6/6 | 0/6 | 1/5 | 5/5 | 1/4 | 2/6 | 19 S1 素朴RAG | 3/8 | 2/8 | 4/6 | 0/6 | 2/5 | 5/5 | 1/4 | 1/6 | 18 S1b 素朴+ハイブリッド | 2/8 | 2/8 | 5/6 | 0/6 | 3/5 | 5/5 | 1/4 | 2/6 | 20 S2 構造化取込 | 2/8 | 7/8 | 1/6 | 2/6 | 3/5 | 4/5 | 2/4 | 3/6 | 24 S3 +ハイブリッド | 2/8 | 7/8 | 5/6 | 2/6 | 2/5 | 3/5 | 4/4 | 3/6 | 28 S4 +文脈・型式正規化 | 7/8 | 8/8 | 2/6 | 4/6 | 4/5 | 5/5 | 4/4 | 3/6 | 37 S5 +参照グラフ | 7/8 | 8/8 | 5/6 | 4/6 | 4/5 | 5/5 | 4/4 | 3/6 | 40 S6 +再ランキング | 8/8 | 8/8 | 6/6 | 5/6 | 4/5 | 5/5 | 4/4 | 4/6 | 44 S7 +親子展開 | 7/8 | 8/8 | 6/6 | 5/6 | 4/5 | 5/5 | 4/4 | 4/6 | 43 S8 +参照追跡 | 7/8 | 8/8 | 6/6 | 5/6 | 4/5 | 5/5 | 4/4 | 4/6 | 43 色:赤 0〜25% / 橙 25〜50% / 黄 50〜75% / 薄緑 75〜99% / 緑 100% 48
解説

カテゴリごとの回答可能数を色で示しました。分冊マニュアル(C1)はS4で緑に変わり、神エクセル(C2)はS2で、特許(C3)はS3とS5で、スキャン(C4)はS2とS4とS6で段階的に、仕様書の表(C7)はS3で改善しています。社内基準(C6)は最初から答えられていて、S2やS3でかえって下がっています。データ特性によって効く打ち手が違うことが一目で分かります。これがPart Eの適用指針の根拠です。
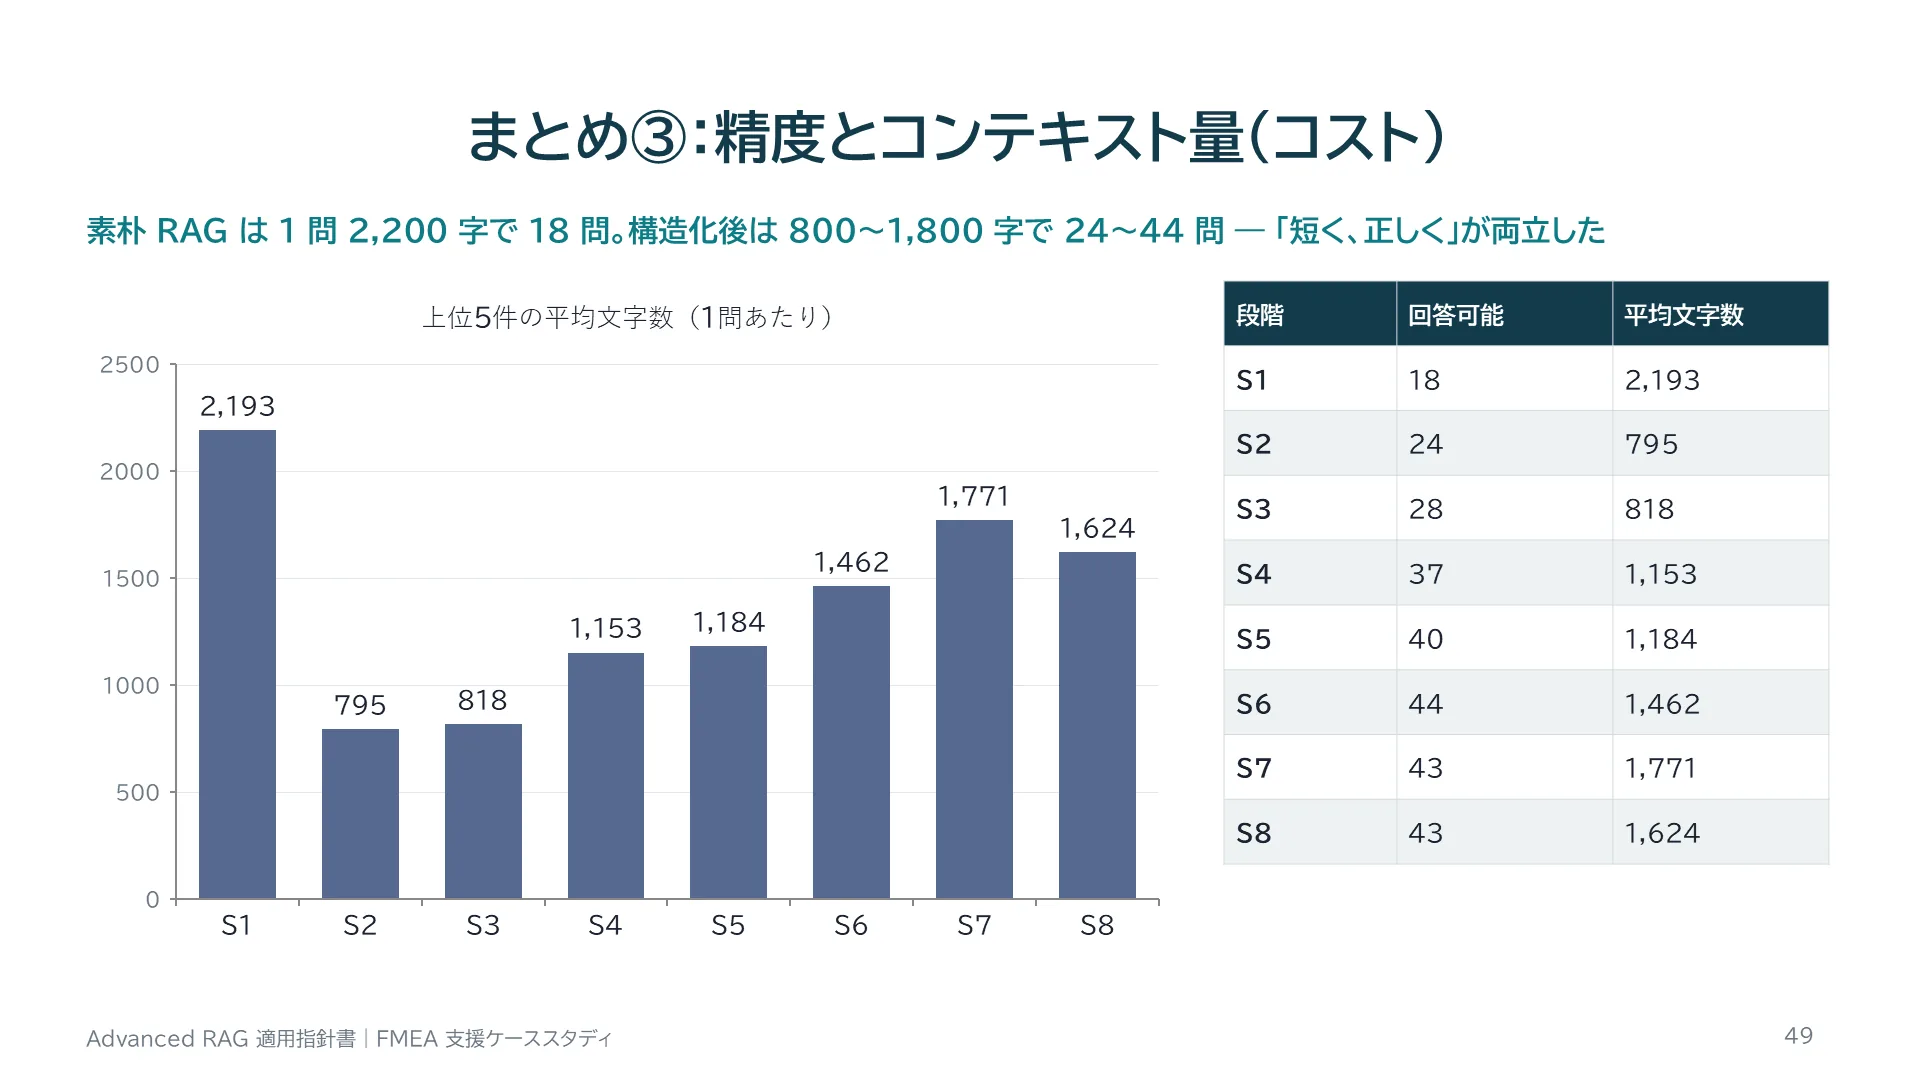
まとめ③:精度とコンテキスト量(コスト)
スライド 49 のテキストと解説
まとめ③:精度とコンテキスト量(コスト) 素朴 RAG は 1 問 2,200 字で 18 問。構造化後は 800〜1,800 字で 24〜44 問 ― 「短く、正しく」が両立した 段階 | 回答可能 | 平均文字数 S1 | 18 | 2,193 S2 | 24 | 795 S3 | 28 | 818 S4 | 37 | 1,153 S5 | 40 | 1,184 S6 | 44 | 1,462 S7 | 43 | 1,771 S8 | 43 | 1,624 49
解説

上位5件の合計文字数、つまりLLMに渡すコンテキスト量の平均です。素朴なRAGは500字チャンクを5件なので約2,200字で、答えられるのは18問でした。構造化後は1チャンクが意味の単位で短くなり、約800字で24問になりました。文脈ヘッダ(S4)や再ランキング(S6)で文字数は増えますが、それでも1,500字前後です。親子展開(S7)は表全体を渡すので最も長く、精度は上がりませんでした。LLMのコストと遅延はコンテキスト量にほぼ比例するので、構造化はコスト削減の打ち手でもあります。
PART D
スライド 50 のテキストと解説
PART D 残った失敗と仮説演習 S6 でも答えられなかった 4 問を題材に、「仮説 → 打ち手 → 検証」を組み立てる練習をする このPartで答えられるようになる問い 列挙・集計型の質問に top-k 検索は向いているか? 結論が表の外にある文書はどう扱うか? 多段の質問・紛らわしい文書にはどう対処するか? 1〜2 問の差をどう解釈すべきか? 50
解説

Part Dはテックリーダーとしての思考訓練です。残った失敗のそれぞれに、仮説・打ち手・検証方法・完了条件を付けて示します。
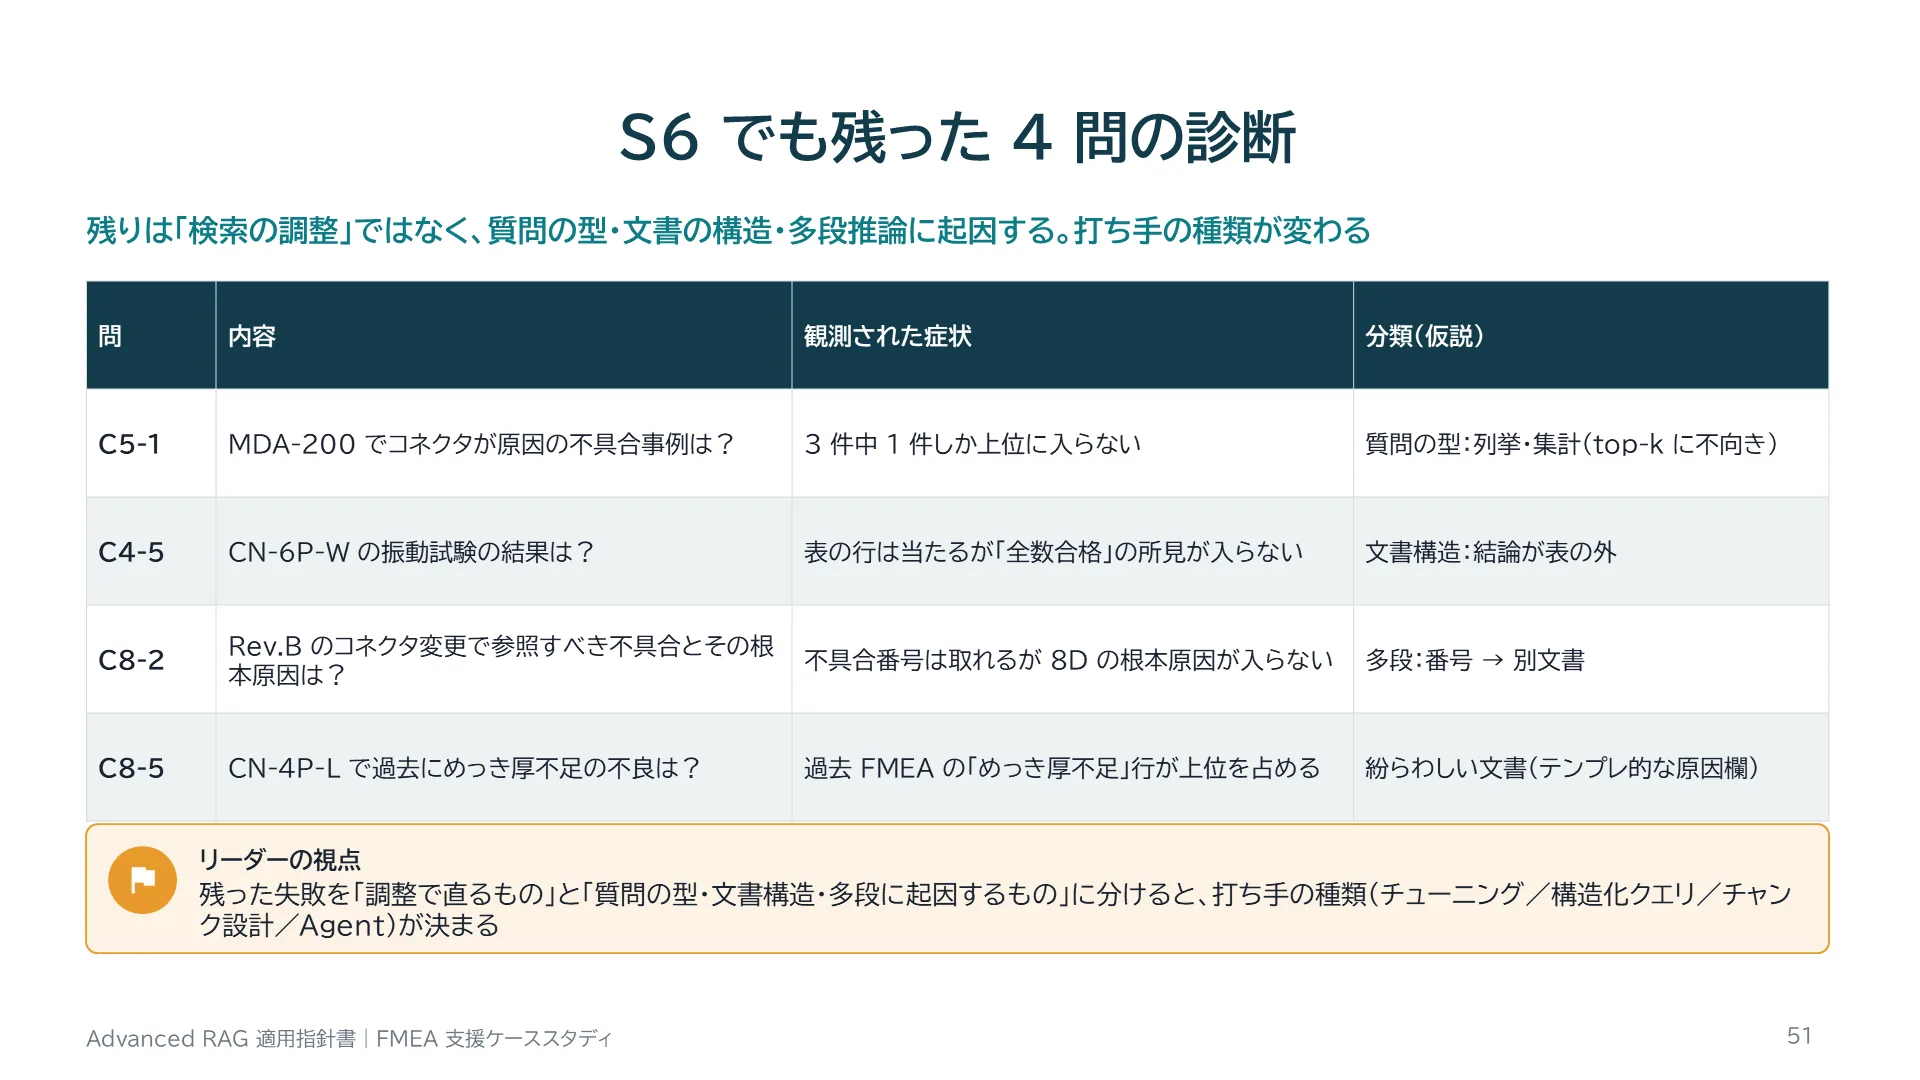
S6 でも残った 4 問の診断
スライド 51 のテキストと解説
S6 でも残った 4 問の診断 残りは「検索の調整」ではなく、質問の型・文書の構造・多段推論に起因する。打ち手の種類が変わる 問 | 内容 | 観測された症状 | 分類(仮説) C5-1 | MDA-200 でコネクタが原因の不具合事例は? | 3 件中 1 件しか上位に入らない | 質問の型:列挙・集計(top-k に不向き) C4-5 | CN-6P-W の振動試験の結果は? | 表の行は当たるが「全数合格」の所見が入らない | 文書構造:結論が表の外 C8-2 | Rev.B のコネクタ変更で参照すべき不具合とその根本原因は? | 不具合番号は取れるが 8D の根本原因が入らない | 多段:番号 → 別文書 C8-5 | CN-4P-L で過去にめっき厚不足の不良は? | 過去 FMEA の「めっき厚不足」行が上位を占める | 紛らわしい文書(テンプレ的な原因欄) リーダーの視点 残った失敗を「調整で直るもの」と「質問の型・文書構造・多段に起因するもの」に分けると、打ち手の種類(チューニング/構造化クエリ/チャンク設計/Agent)が決まる 51
解説

S6(上位5件)で答えられなかったのは4問です。C5-1は「MDA-200でコネクタが原因の不具合事例は?」という列挙型の質問で、該当する3件をすべて上位5件に入れる必要があります。似たレコードが数十件ある中で、類似度の上位だけを取る方式には向いていません。C4-5は振動試験の結論「全数合格」が表の外の所見欄に1行だけある文書です。C8-2は不具合DBの番号から8D報告書の根本原因へ、2段たどる必要があります。C8-5は「めっき厚不足」が過去FMEAの原因欄に何度も出てくるため、試験報告書の実例がFMEAの行に負けます。どれも検索パラメータの調整では解決しにくく、別の種類の打ち手が必要です。
演習①(C5-1 列挙型):top-k ではなく構造化フィルタで引く
スライド 52 のテキストと解説
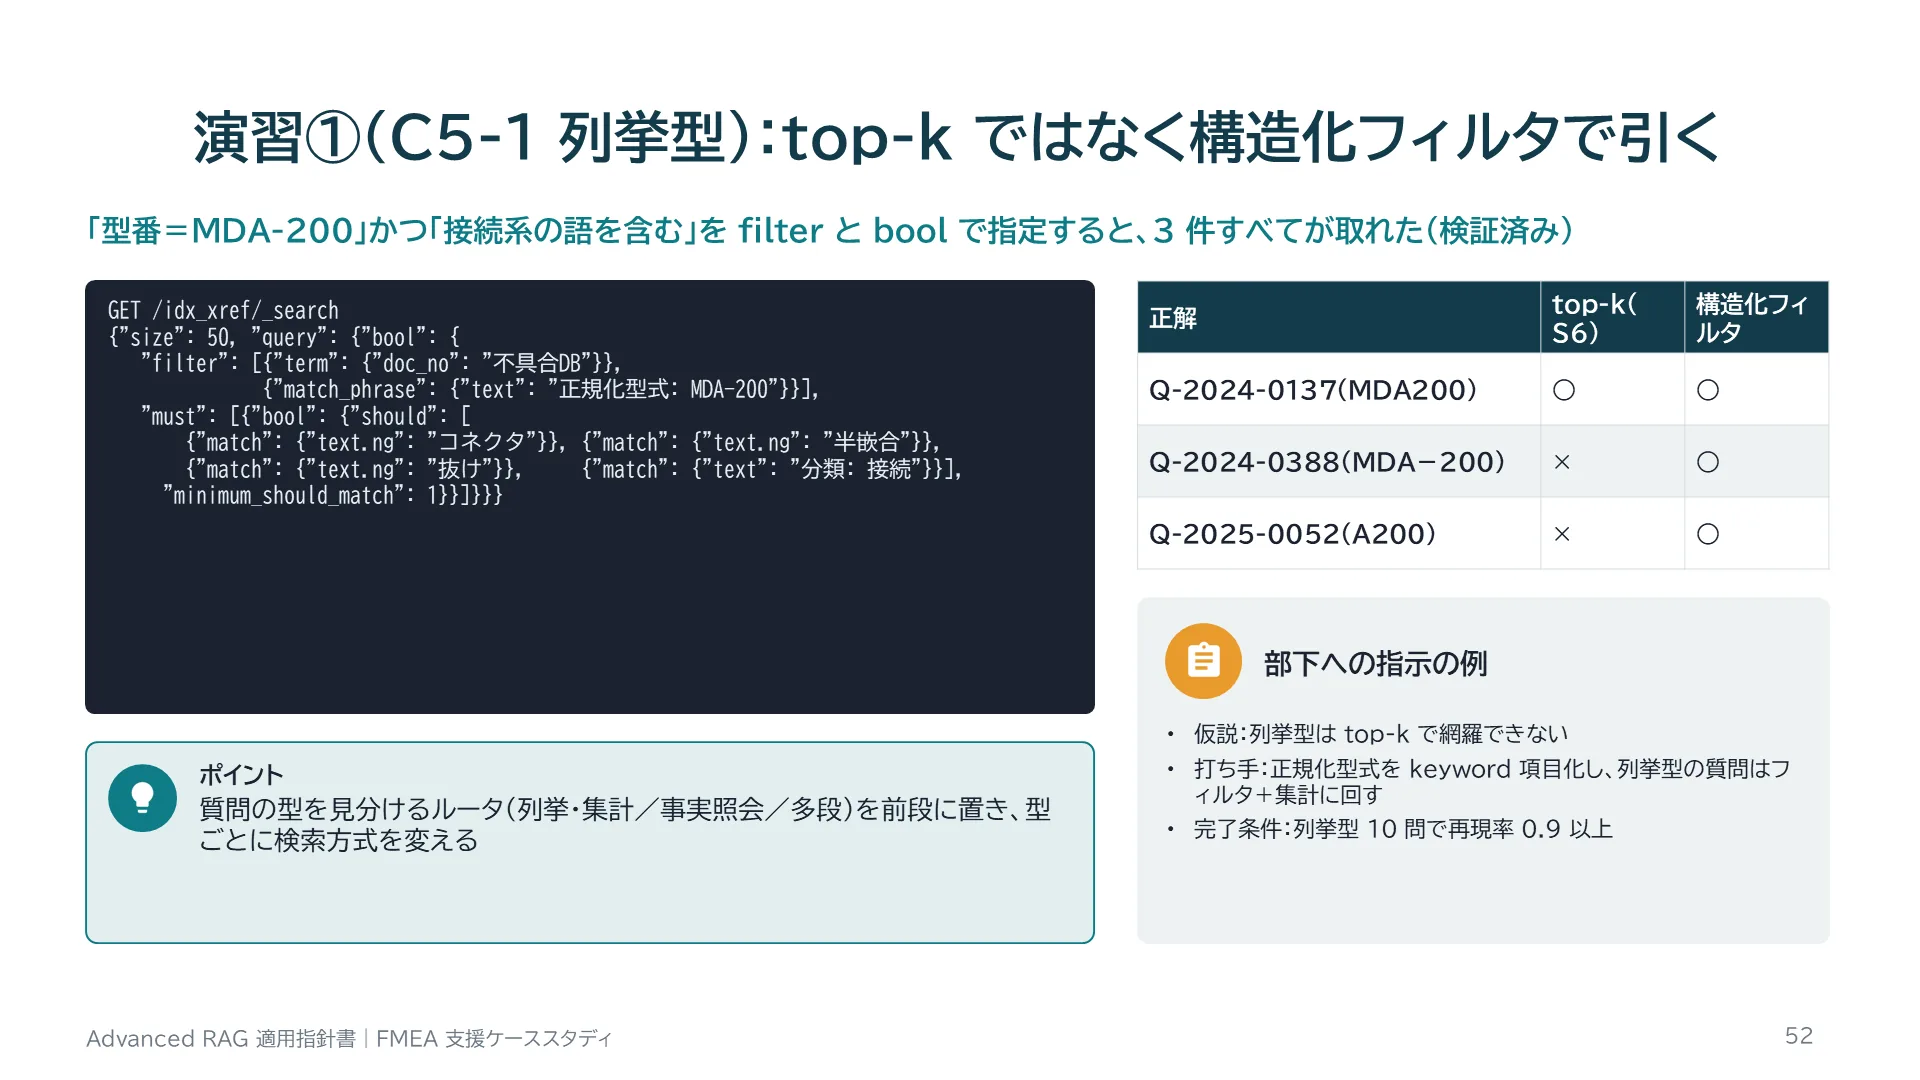
演習①(C5-1 列挙型):top-k ではなく構造化フィルタで引く 「型番=MDA-200」かつ「接続系の語を含む」を filter と bool で指定すると、3 件すべてが取れた(検証済み) GET /idx_xref/_search {"size": 50, "query": {"bool": { "filter": [{"term": {"doc_no": "不具合DB"}}, {"match_phrase": {"text": "正規化型式: MDA-200"}}], "must": [{"bool": {"should": [ {"match": {"text.ng": "コネクタ"}}, {"match": {"text.ng": "半嵌合"}}, {"match": {"text.ng": "抜け"}}, {"match": {"text": "分類: 接続"}}], "minimum_should_match": 1}}]}}} 正解 | top-k(S6) | 構造化フィルタ Q-2024-0137(MDA200) | ○ | ○ Q-2024-0388(MDA-200) | × | ○ Q-2025-0052(A200) | × | ○ 部下への指示の例 仮説:列挙型は top-k で網羅できない 打ち手:正規化型式を keyword 項目化し、列挙型の質問はフィルタ+集計に回す 完了条件:列挙型 10 問で再現率 0.9 以上 ポイント 質問の型を見分けるルータ(列挙・集計/事実照会/多段)を前段に置き、型ごとに検索方式を変える 52
解説

列挙型の質問に対する仮説は、「類似度の上位k件では、似たレコードが多いと該当レコードを網羅できない」です。打ち手として、S4で付与した正規化型式を条件にした構造化フィルタを試しました。不具合DBに絞り、「正規化型式: MDA-200」を含み、かつコネクタ・半嵌合・抜け・接続のどれかを含むレコードを検索すると、正解の3件がすべて取れました。表記ゆれの「MDA200」「A200」「MDA-200」も、正規化型式で一括で拾えています。本番では、正規化型式を本文ではなくキーワード型のフィールドに持たせ、件数の集計はOpenSearchの集計機能か、DBへのSQLに任せます。LLMには、絞り込んだ結果の一覧を渡して要約させます。
演習②(C4-5 結論が表の外)と ③(C8-2 多段)
スライド 53 のテキストと解説
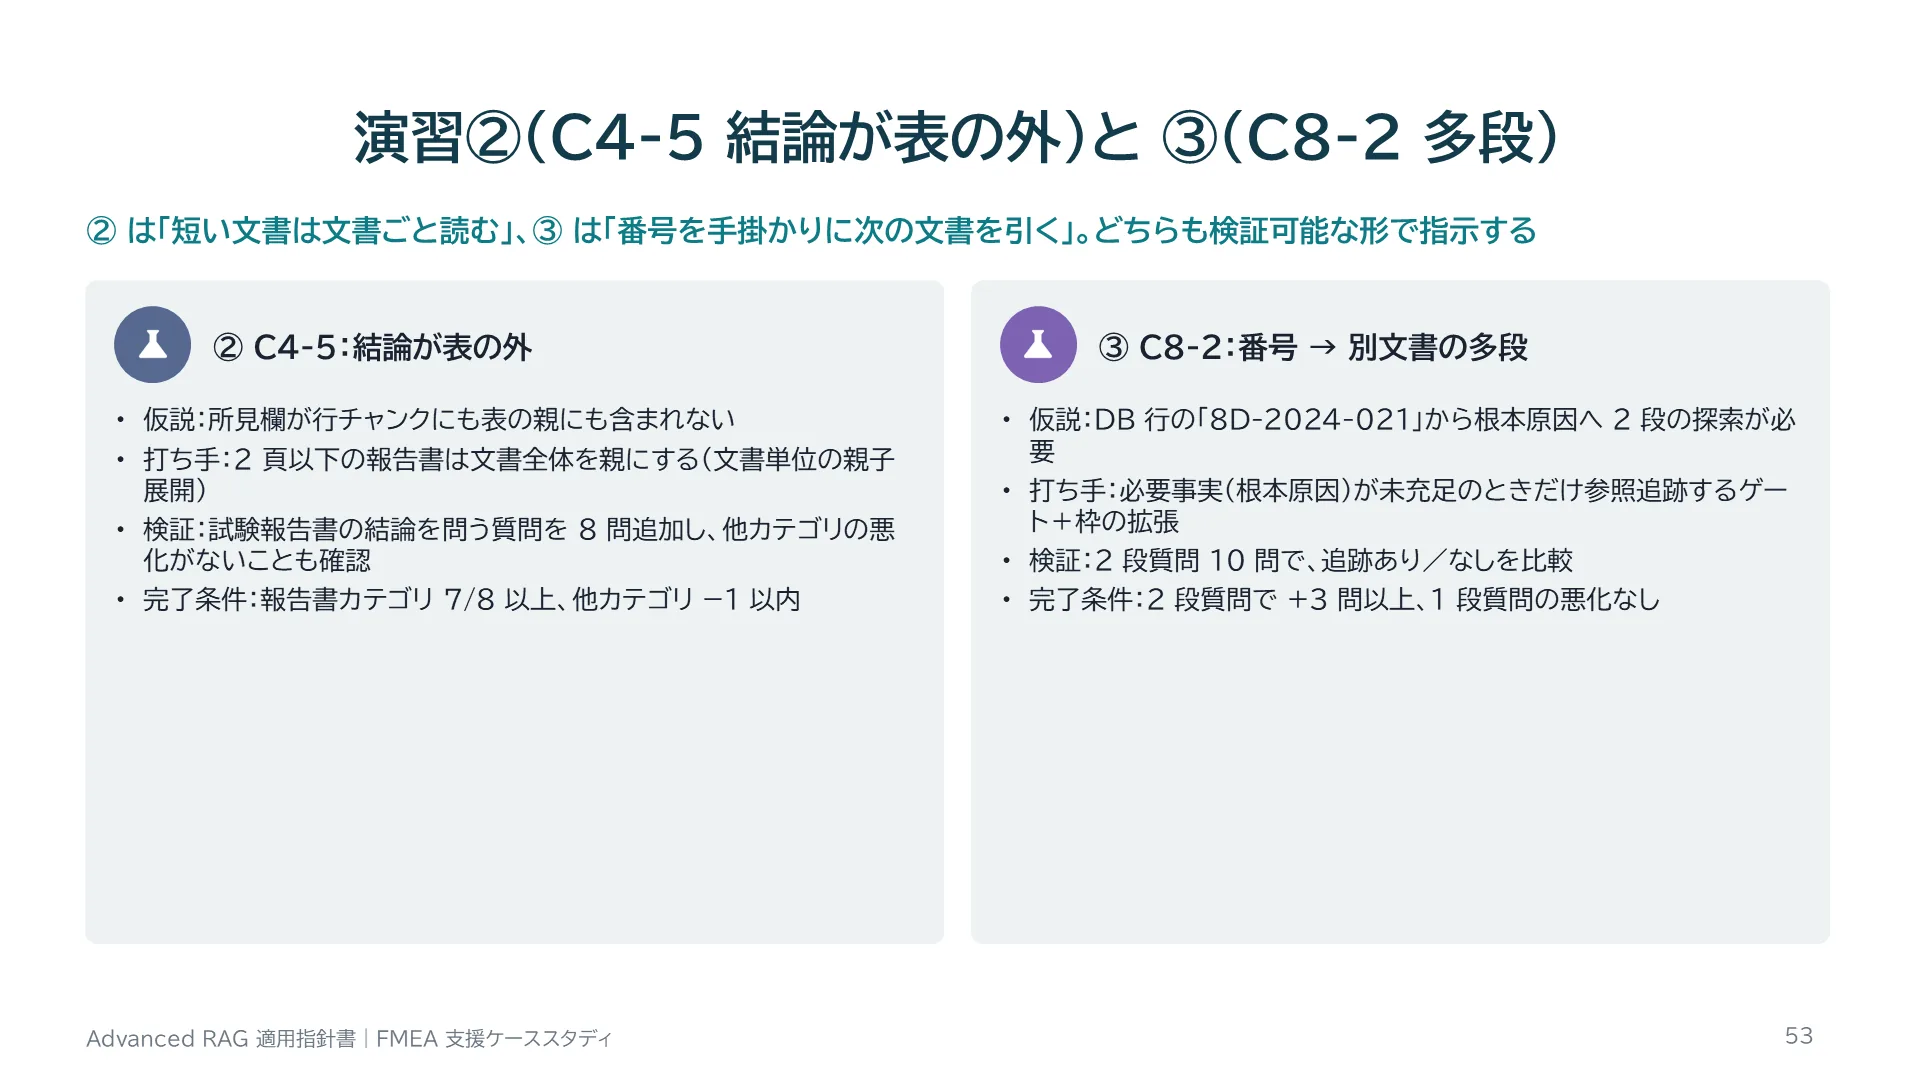
演習②(C4-5 結論が表の外)と ③(C8-2 多段) ② は「短い文書は文書ごと読む」、③ は「番号を手掛かりに次の文書を引く」。どちらも検証可能な形で指示する ② C4-5:結論が表の外 仮説:所見欄が行チャンクにも表の親にも含まれない 打ち手:2 頁以下の報告書は文書全体を親にする(文書単位の親子展開) 検証:試験報告書の結論を問う質問を 8 問追加し、他カテゴリの悪化がないことも確認 完了条件:報告書カテゴリ 7/8 以上、他カテゴリ −1 以内 ③ C8-2:番号 → 別文書の多段 仮説:DB 行の「8D-2024-021」から根本原因へ 2 段の探索が必要 打ち手:必要事実(根本原因)が未充足のときだけ参照追跡するゲート+枠の拡張 検証:2 段質問 10 問で、追跡あり/なしを比較 完了条件:2 段質問で +3 問以上、1 段質問の悪化なし 53
解説

C4-5の仮説は「試験報告書の結論は表の外の所見欄にあり、行単位のチャンクと親子展開(表)では届かない」です。打ち手として、2ページ以下の短い報告書は文書全体を親にする(文書単位の small-to-big)ことが考えられます。C8-2の仮説は「不具合DBの行にある8D番号から8D報告書の根本原因へ、2段の探索が必要」です。S8の参照追跡はこれを狙いましたが、枠の管理がなく正解を押し出しました。打ち手は、質問に必要な事実(根本原因)が未充足のときだけ追跡するゲートを入れ、追加分は枠を広げて加えることです。どちらも、対象となる質問を5〜10問追加して、改善と他カテゴリの悪化の両方を確認します。
演習④(C8-5 紛らわしい文書)と「1 問の差」の読み方
スライド 54 のテキストと解説
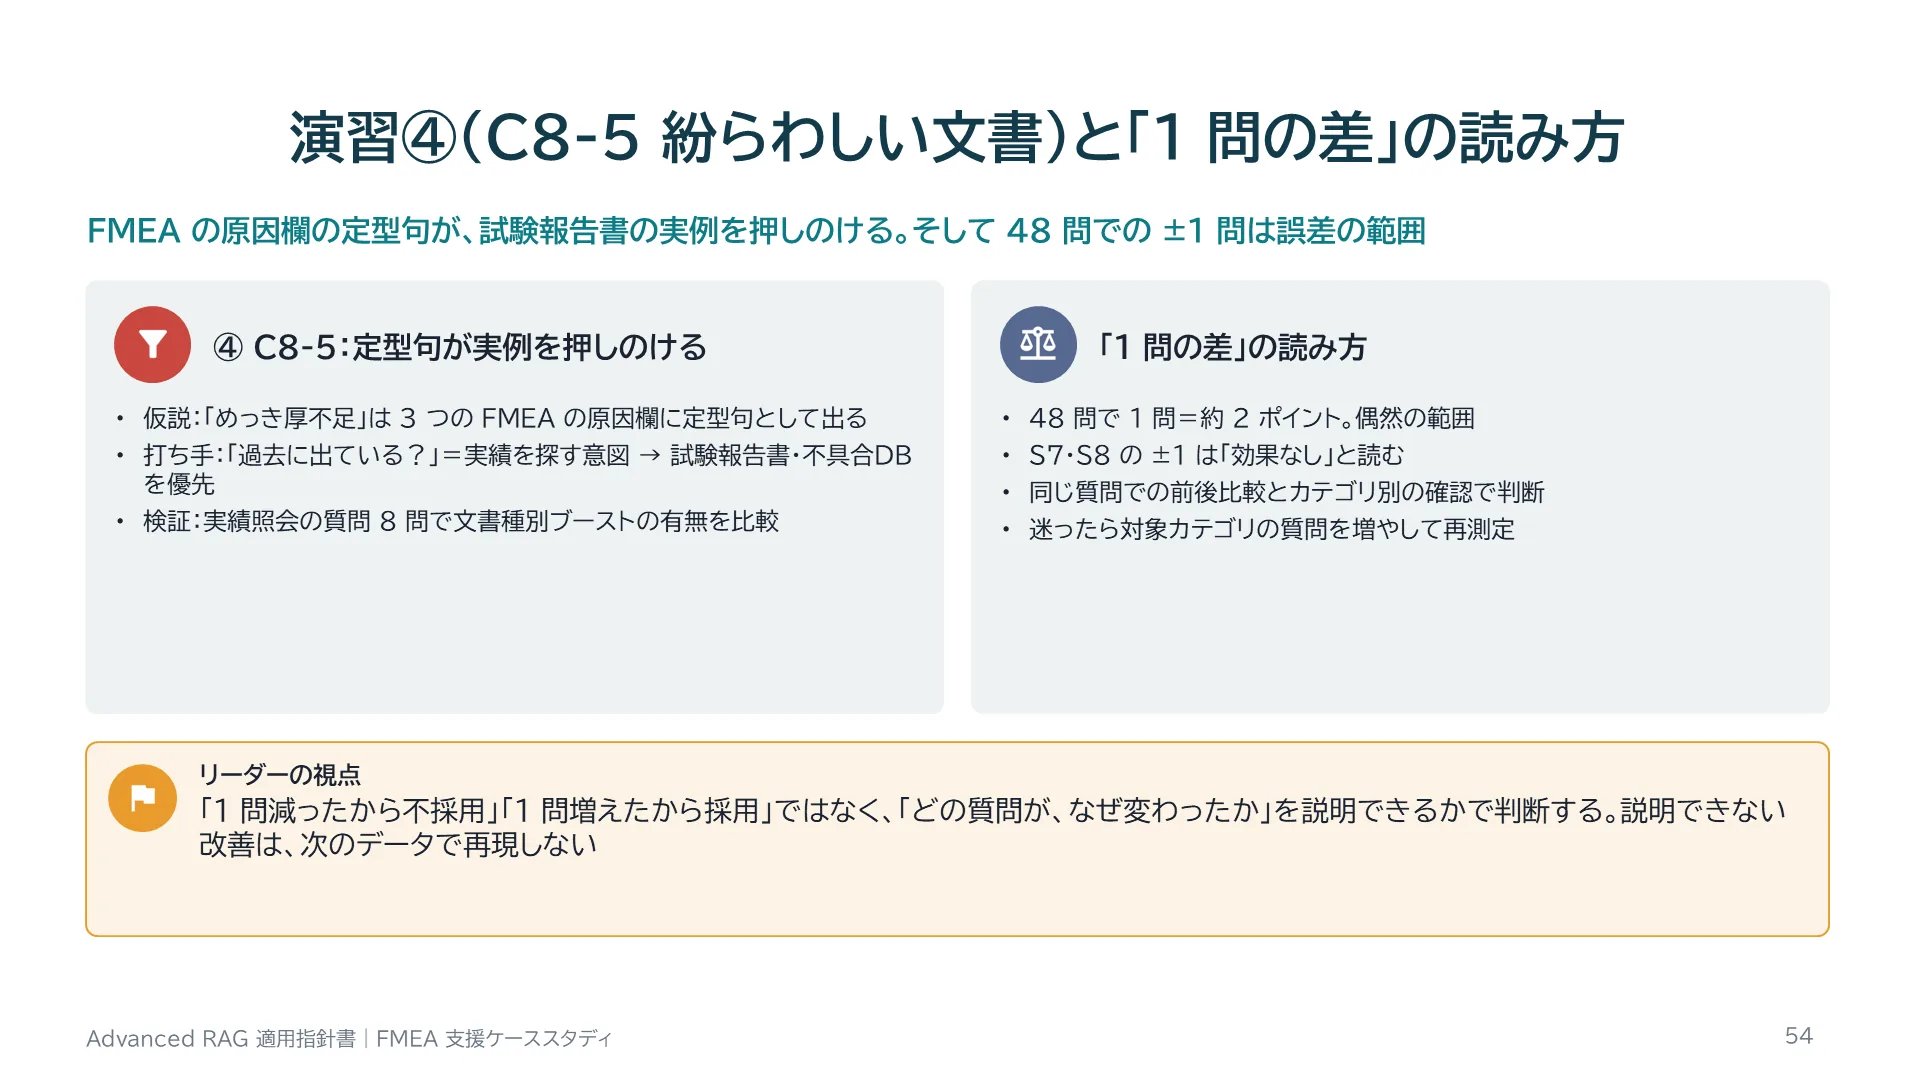
演習④(C8-5 紛らわしい文書)と「1 問の差」の読み方 FMEA の原因欄の定型句が、試験報告書の実例を押しのける。そして 48 問での ±1 問は誤差の範囲 ④ C8-5:定型句が実例を押しのける 仮説:「めっき厚不足」は 3 つの FMEA の原因欄に定型句として出る 打ち手:「過去に出ている?」=実績を探す意図 → 試験報告書・不具合DB を優先 検証:実績照会の質問 8 問で文書種別ブーストの有無を比較 「1 問の差」の読み方 48 問で 1 問=約 2 ポイント。偶然の範囲 S7・S8 の ±1 は「効果なし」と読む 同じ質問での前後比較とカテゴリ別の確認で判断 迷ったら対象カテゴリの質問を増やして再測定 リーダーの視点 「1 問減ったから不採用」「1 問増えたから採用」ではなく、「どの質問が、なぜ変わったか」を説明できるかで判断する。説明できない改善は、次のデータで再現しない 54
解説

C8-5では、「めっき厚不足」という語が3つの過去FMEAの原因欄に定型句として出てくるため、試験報告書の「金めっき厚が0.08µm」という実例より上位に来てしまいます。仮説は「実例を探す質問なのに、テンプレート的な文書が勝っている」で、打ち手は、質問の意図(実績・事例を探す)を判定して文書の種類(試験報告書・不具合DB)を優先するブーストを掛けることです。また、本検証は48問なので、1問の差は約2ポイントで、偶然の範囲に入ります。S7やS8の±1問を「悪化した」と断定せず、効果がなかったと読むのが妥当です。採否の判断には、対応のある比較(同じ質問で前後を比べる)と、カテゴリ別の確認、必要なら質問の追加を行います。
PART E
スライド 55 のテキストと解説
PART E データ特性別の適用指針 8 種類のデータそれぞれについて、打ち手の優先順位・期待値・OpenSearch の設計・検証方法を 1 枚にまとめる このPartで答えられるようになる問い このデータには、まず何を入れるべきか? どこまで改善が期待できるか? 何を測って、効いたと判断するか? 55
解説

Part Eは実プロジェクトで最も参照するカードです。期待値の数字は本検証での実測で、自分たちのデータでの目安として使ってください。
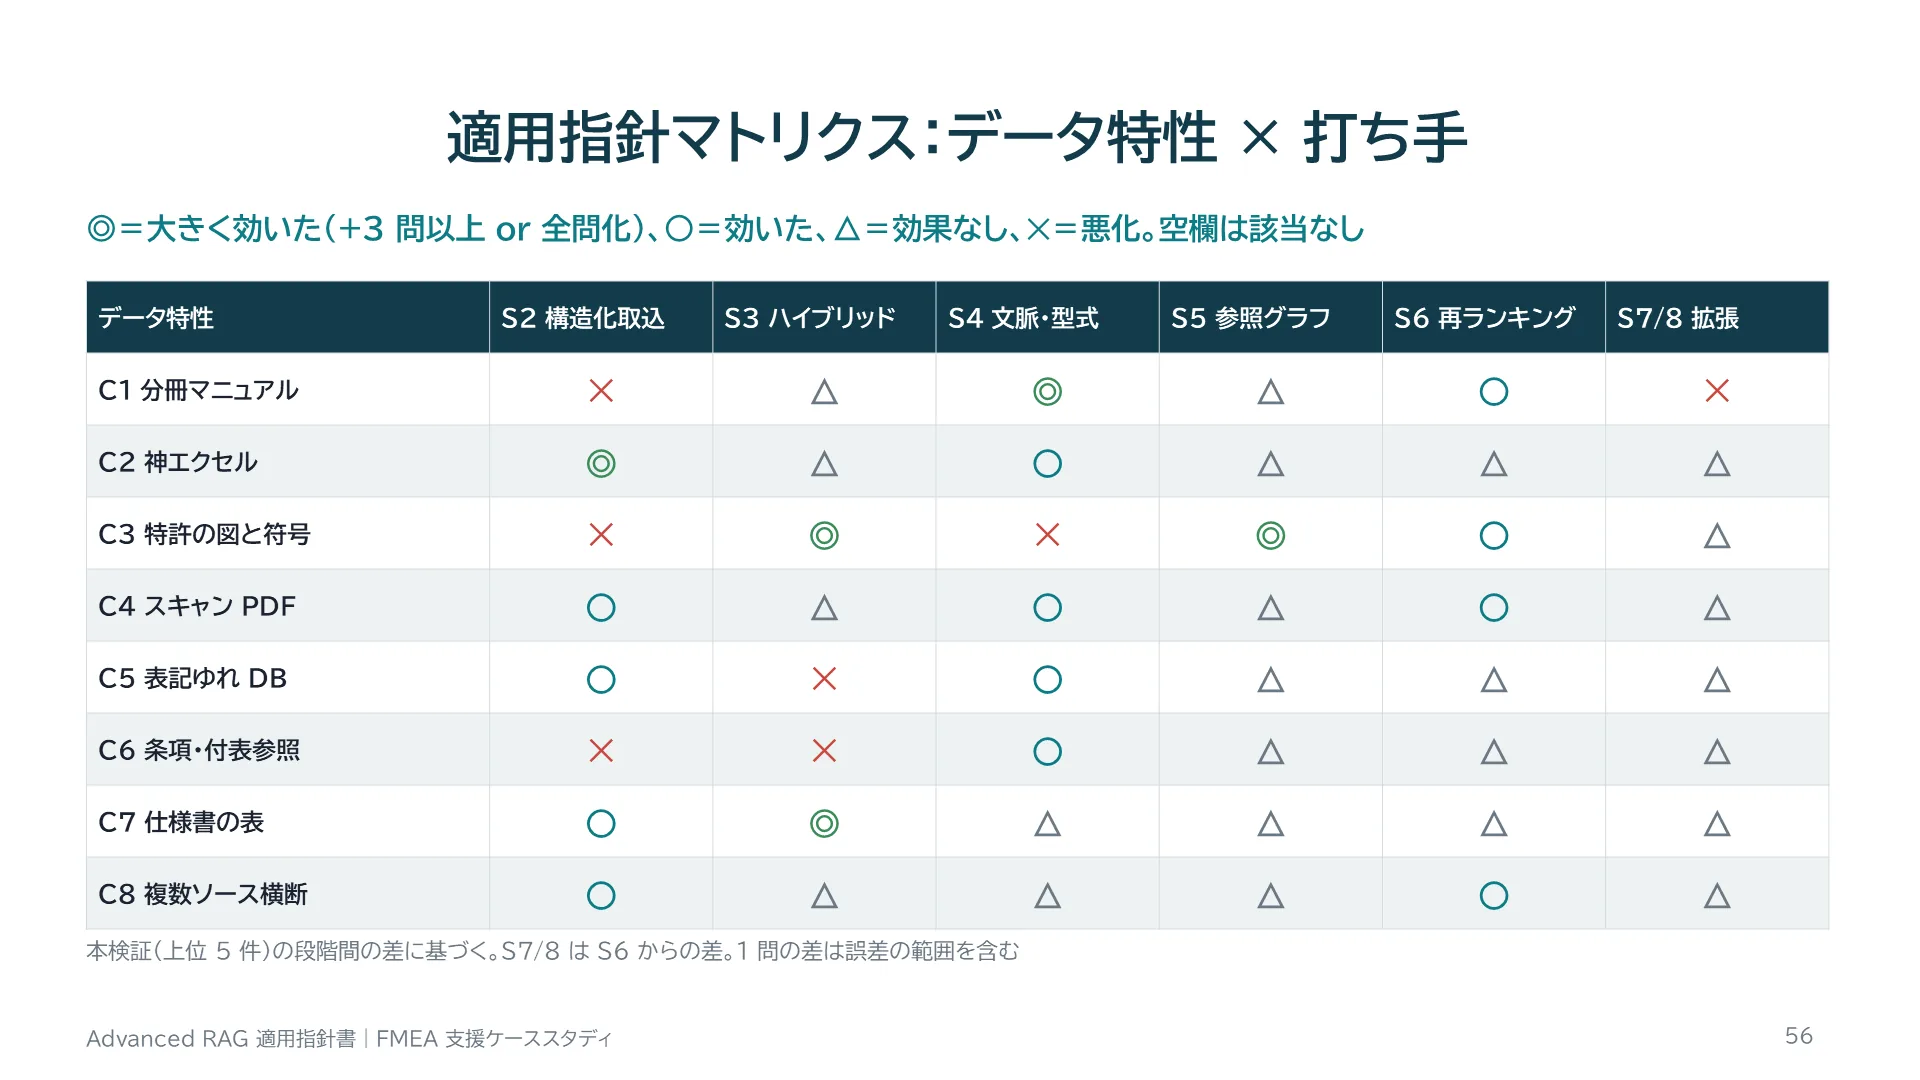
適用指針マトリクス:データ特性 × 打ち手
スライド 56 のテキストと解説
適用指針マトリクス:データ特性 × 打ち手 ◎=大きく効いた(+3 問以上 or 全問化)、○=効いた、△=効果なし、✕=悪化。空欄は該当なし データ特性 | S2 構造化取込 | S3 ハイブリッド | S4 文脈・型式 | S5 参照グラフ | S6 再ランキング | S7/8 拡張 C1 分冊マニュアル | ✕ | △ | ◎ | △ | ○ | ✕ C2 神エクセル | ◎ | △ | ○ | △ | △ | △ C3 特許の図と符号 | ✕ | ◎ | ✕ | ◎ | ○ | △ C4 スキャン PDF | ○ | △ | ○ | △ | ○ | △ C5 表記ゆれ DB | ○ | ✕ | ○ | △ | △ | △ C6 条項・付表参照 | ✕ | ✕ | ○ | △ | △ | △ C7 仕様書の表 | ○ | ◎ | △ | △ | △ | △ C8 複数ソース横断 | ○ | △ | △ | △ | ○ | △ 本検証(上位 5 件)の段階間の差に基づく。S7/8 は S6 からの差。1 問の差は誤差の範囲を含む 56
解説

本検証の結果から、データ特性ごとにどの打ち手が効いたかをまとめた表です。◎は3問以上の改善かそのカテゴリの全問正解化、○は1〜2問の改善、△は効果なし、✕は悪化です。たとえば特許は、構造化取込で悪化し、ハイブリッドと参照グラフで回復しています。このように、同じ打ち手でもデータによって逆の効果を持つことがあります。新しいデータが来たら、まずこの表の近い行を見て、最初に試す打ち手と、悪化に注意すべき打ち手を決めてください。
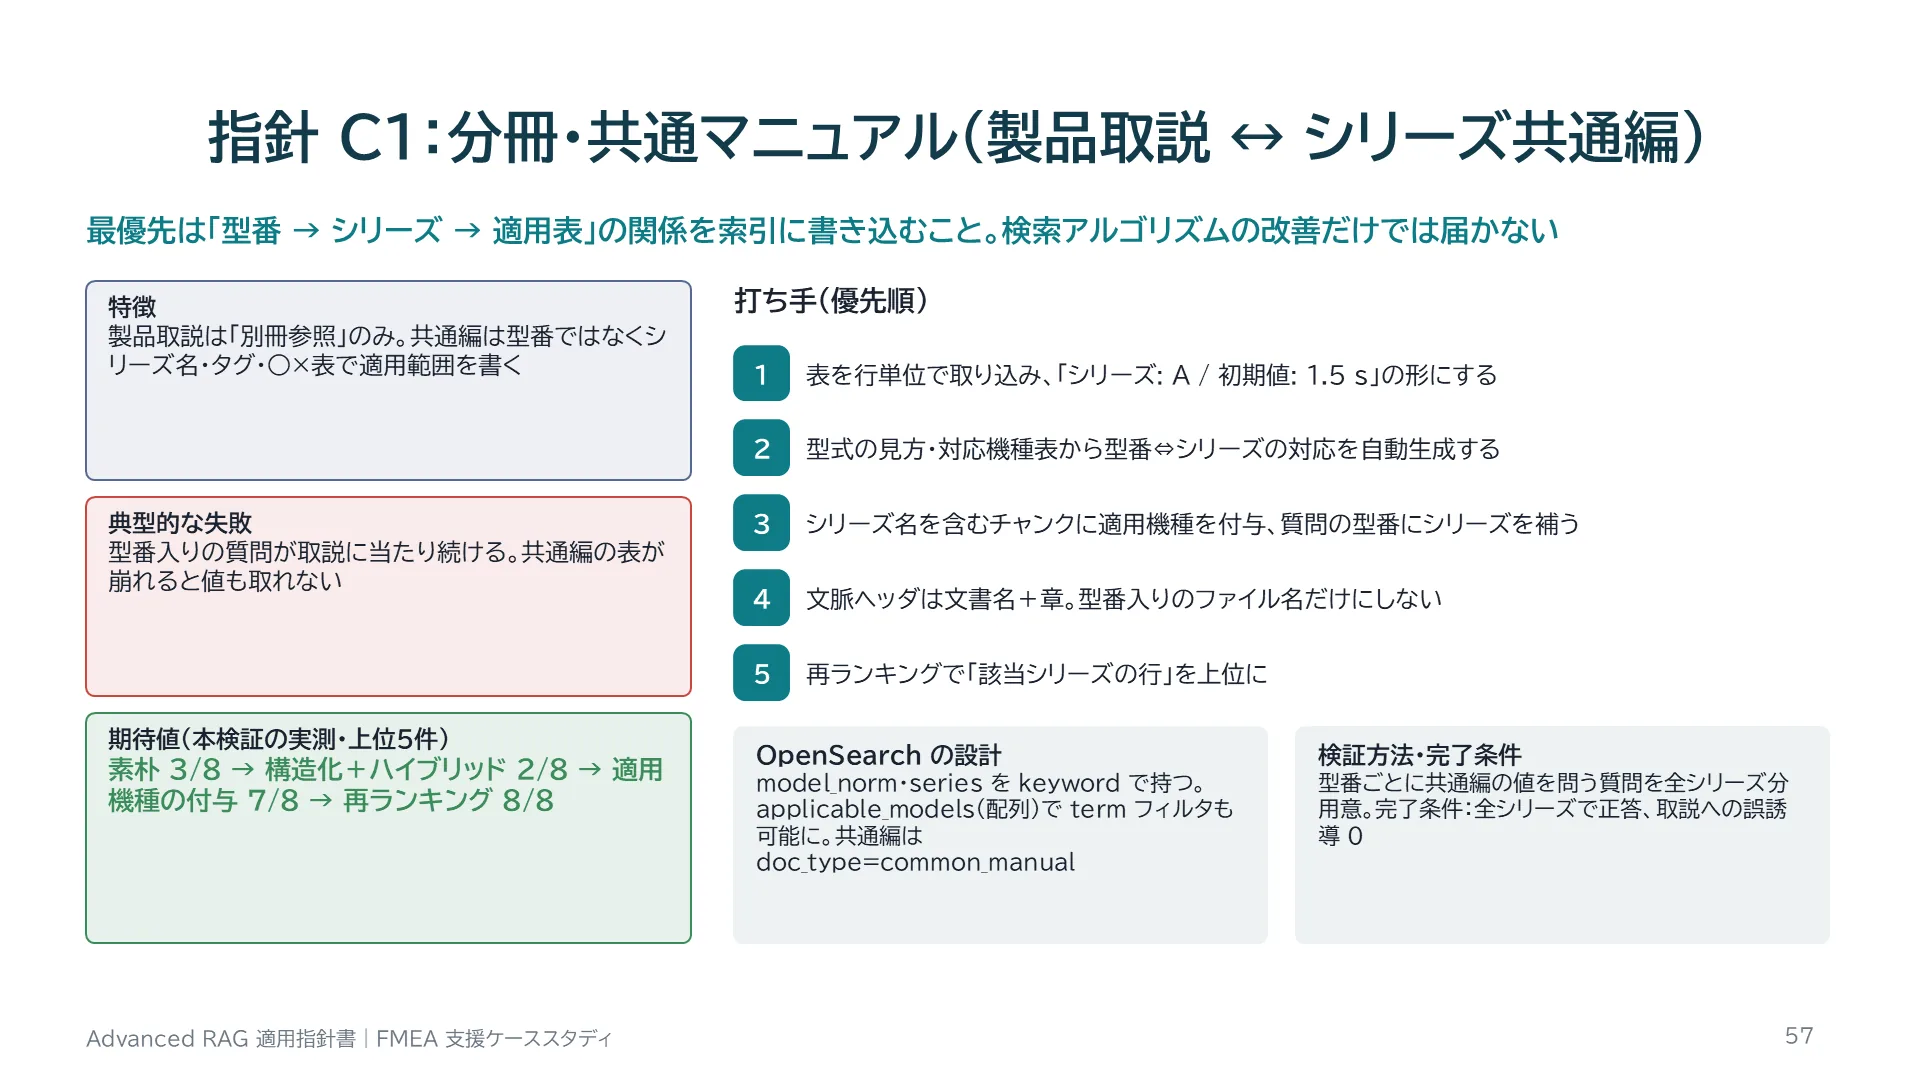
指針 C1:分冊・共通マニュアル(製品取説 ↔ シリーズ共通編)
スライド 57 のテキストと解説
指針 C1:分冊・共通マニュアル(製品取説 ↔ シリーズ共通編) 最優先は「型番 → シリーズ → 適用表」の関係を索引に書き込むこと。検索アルゴリズムの改善だけでは届かない 特徴 製品取説は「別冊参照」のみ。共通編は型番ではなくシリーズ名・タグ・○×表で適用範囲を書く 典型的な失敗 型番入りの質問が取説に当たり続ける。共通編の表が崩れると値も取れない 期待値(本検証の実測・上位5件) 素朴 3/8 → 構造化+ハイブリッド 2/8 → 適用機種の付与 7/8 → 再ランキング 8/8 打ち手(優先順) 1 表を行単位で取り込み、「シリーズ: A / 初期値: 1.5 s」の形にする 2 型式の見方・対応機種表から型番⇔シリーズの対応を自動生成する 3 シリーズ名を含むチャンクに適用機種を付与、質問の型番にシリーズを補う 4 文脈ヘッダは文書名+章。型番入りのファイル名だけにしない 5 再ランキングで「該当シリーズの行」を上位に OpenSearch の設計 model_norm・series を keyword で持つ。applicable_models(配列)で term フィルタも可能に。共通編は doc_type=common_manual 検証方法・完了条件 型番ごとに共通編の値を問う質問を全シリーズ分用意。完了条件:全シリーズで正答、取説への誤誘導 0 57
解説

分冊マニュアルの指針です。最も効いたのは、型番とシリーズの関係をデータとして索引に持たせることでした。期待値は、素朴なRAGで3/8、検索だけ改善しても2/8で、適用機種の付与で7/8、再ランキングで8/8です。OpenSearchでは、正規化型式とシリーズをキーワード型のフィールドに持たせ、適用機種の配列でフィルタできるようにするのが本番向けの設計です。検証は、全シリーズの型番で共通編の値を問う質問を作り、取説への誤誘導がないことを確認します。
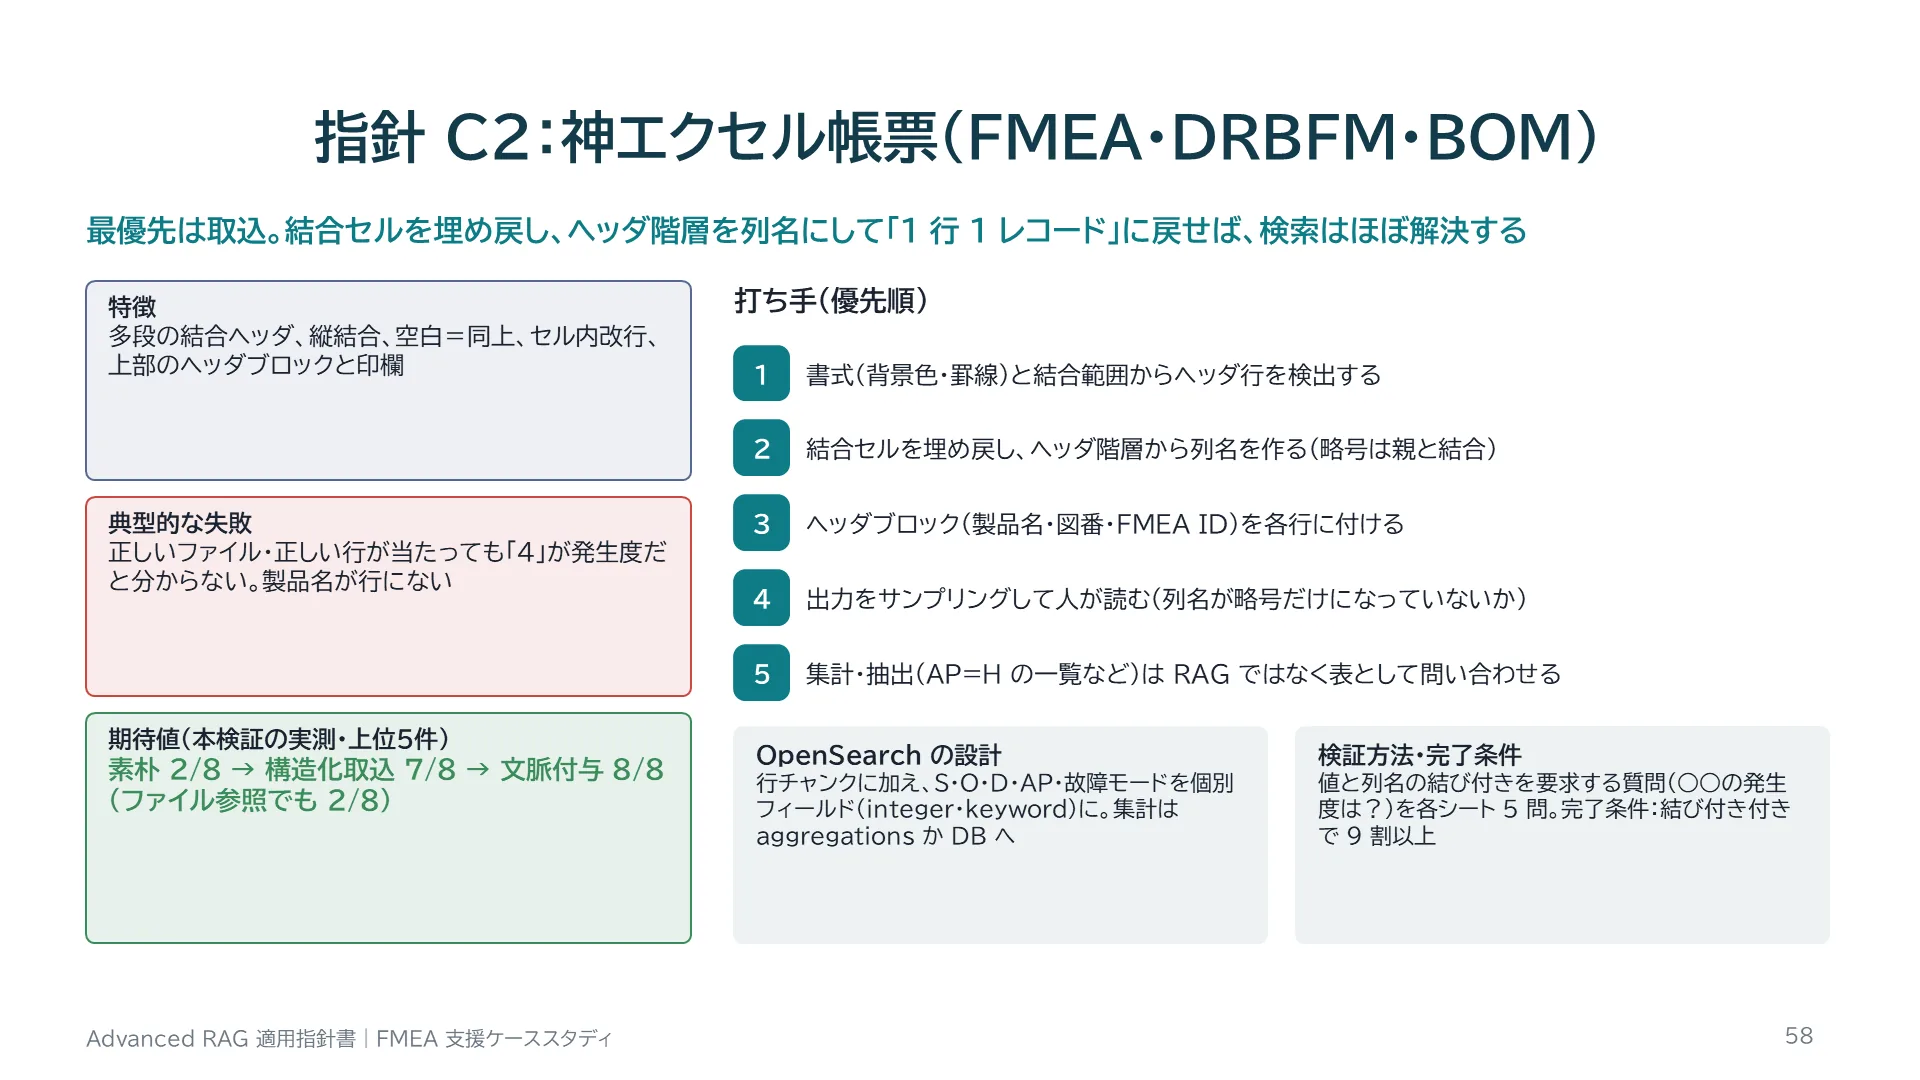
指針 C2:神エクセル帳票(FMEA・DRBFM・BOM)
スライド 58 のテキストと解説
指針 C2:神エクセル帳票(FMEA・DRBFM・BOM) 最優先は取込。結合セルを埋め戻し、ヘッダ階層を列名にして「1 行 1 レコード」に戻せば、検索はほぼ解決する 特徴 多段の結合ヘッダ、縦結合、空白=同上、セル内改行、上部のヘッダブロックと印欄 典型的な失敗 正しいファイル・正しい行が当たっても「4」が発生度だと分からない。製品名が行にない 期待値(本検証の実測・上位5件) 素朴 2/8 → 構造化取込 7/8 → 文脈付与 8/8(ファイル参照でも 2/8) 打ち手(優先順) 1 書式(背景色・罫線)と結合範囲からヘッダ行を検出する 2 結合セルを埋め戻し、ヘッダ階層から列名を作る(略号は親と結合) 3 ヘッダブロック(製品名・図番・FMEA ID)を各行に付ける 4 出力をサンプリングして人が読む(列名が略号だけになっていないか) 5 集計・抽出(AP=H の一覧など)は RAG ではなく表として問い合わせる OpenSearch の設計 行チャンクに加え、S・O・D・AP・故障モードを個別フィールド(integer・keyword)に。集計は aggregations か DB へ 検証方法・完了条件 値と列名の結び付きを要求する質問(○○の発生度は?)を各シート 5 問。完了条件:結び付き付きで 9 割以上 58
解説

神エクセルの指針です。取込の構造化だけで2/8から7/8に改善し、文脈付与で8/8になりました。ファイルを丸ごと渡しても2/8で、正しいファイルを渡しても値と列名の結び付きが分からないことが原因です。本番では、行のテキストに加えて、S・O・D・APなどを個別のフィールドとして持たせると、「AP=Hの故障モード一覧」のような集計型の質問を、RAGではなく構造化検索で答えられます。
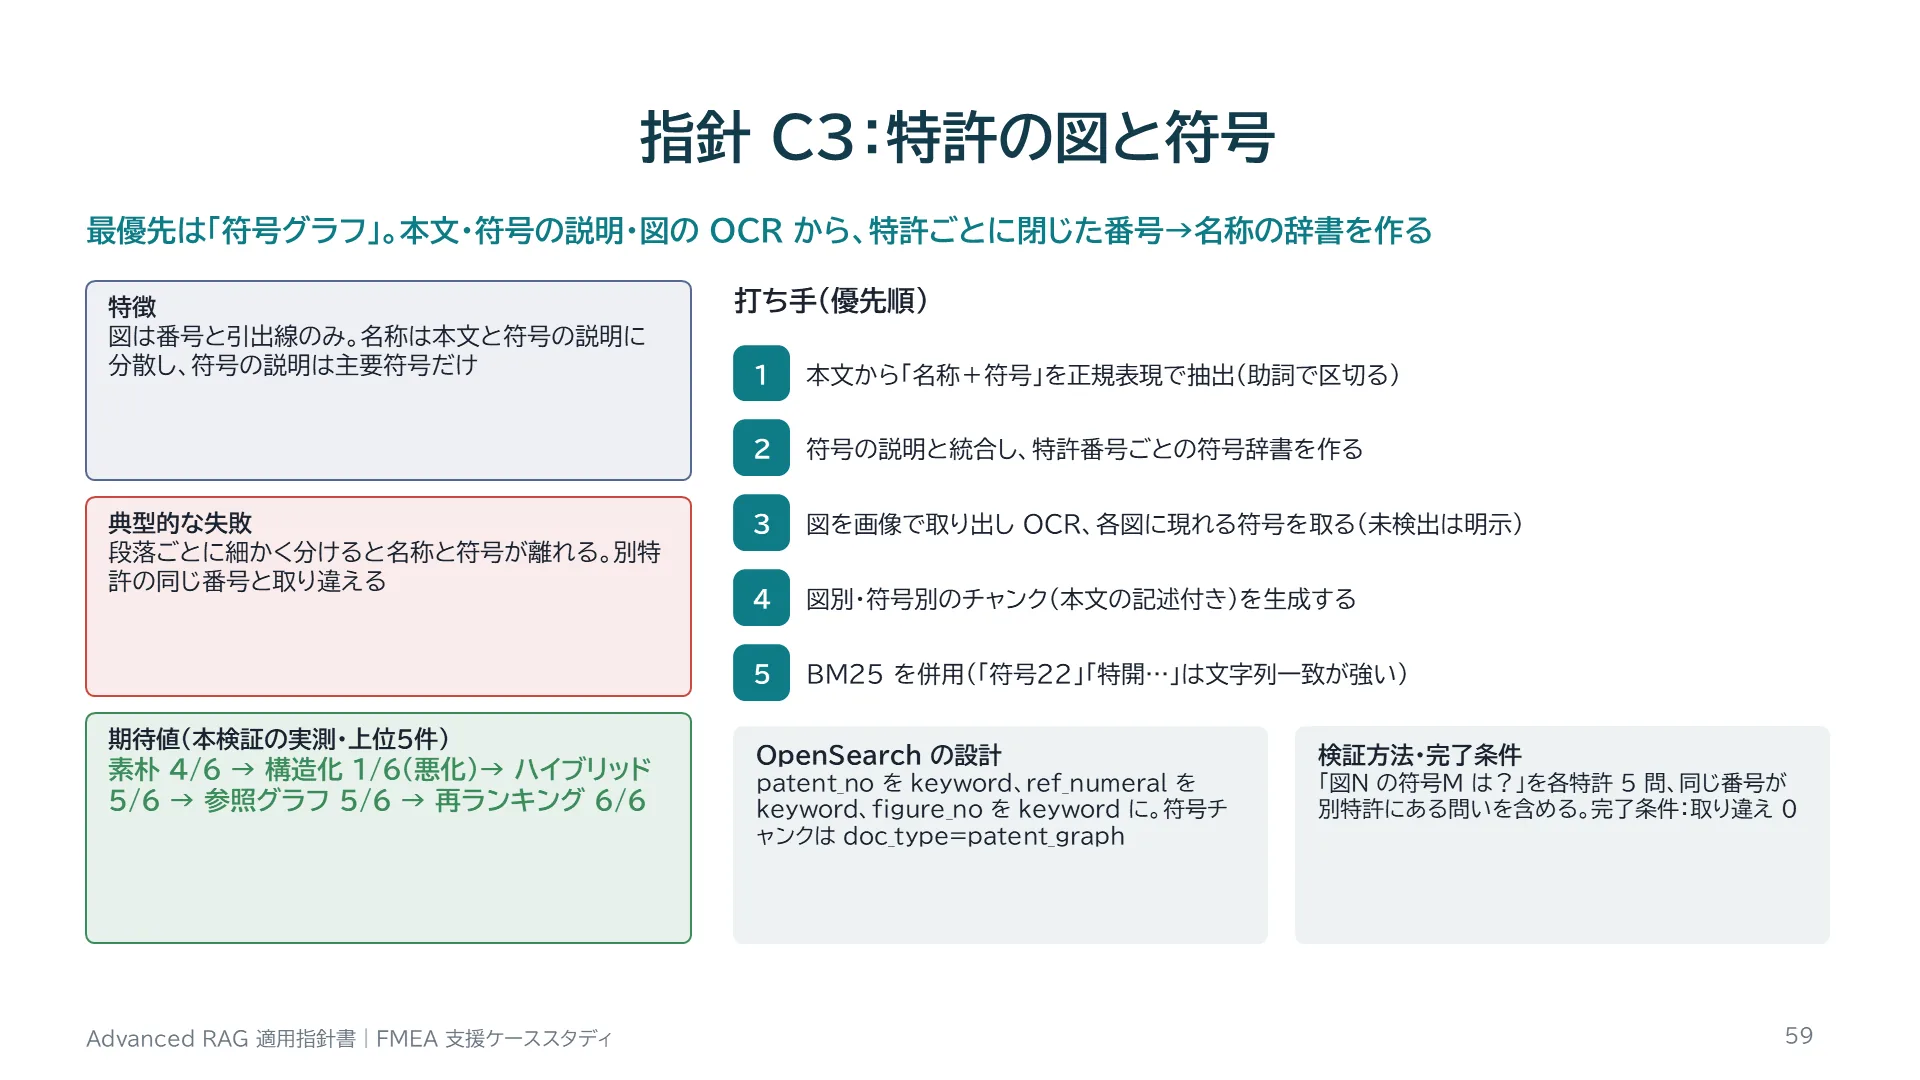
指針 C3:特許の図と符号
スライド 59 のテキストと解説
指針 C3:特許の図と符号 最優先は「符号グラフ」。本文・符号の説明・図の OCR から、特許ごとに閉じた番号→名称の辞書を作る 特徴 図は番号と引出線のみ。名称は本文と符号の説明に分散し、符号の説明は主要符号だけ 典型的な失敗 段落ごとに細かく分けると名称と符号が離れる。別特許の同じ番号と取り違える 期待値(本検証の実測・上位5件) 素朴 4/6 → 構造化 1/6(悪化)→ ハイブリッド 5/6 → 参照グラフ 5/6 → 再ランキング 6/6 打ち手(優先順) 1 本文から「名称+符号」を正規表現で抽出(助詞で区切る) 2 符号の説明と統合し、特許番号ごとの符号辞書を作る 3 図を画像で取り出し OCR、各図に現れる符号を取る(未検出は明示) 4 図別・符号別のチャンク(本文の記述付き)を生成する 5 BM25 を併用(「符号22」「特開…」は文字列一致が強い) OpenSearch の設計 patent_no を keyword、ref_numeral を keyword、figure_no を keyword に。符号チャンクは doc_type=patent_graph 検証方法・完了条件 「図N の符号M は?」を各特許 5 問、同じ番号が別特許にある問いを含める。完了条件:取り違え 0 59
解説

特許の指針です。構造化取込でかえって悪化した唯一のカテゴリで、段落を細かく分けると名称と符号が離れるためです。ハイブリッド検索で回復し、符号グラフで図と符号を結ぶと安定しました。図のOCRは完全ではないので、検出できなかった符号は「図中で未検出」と明示し、本文の記述で補います。
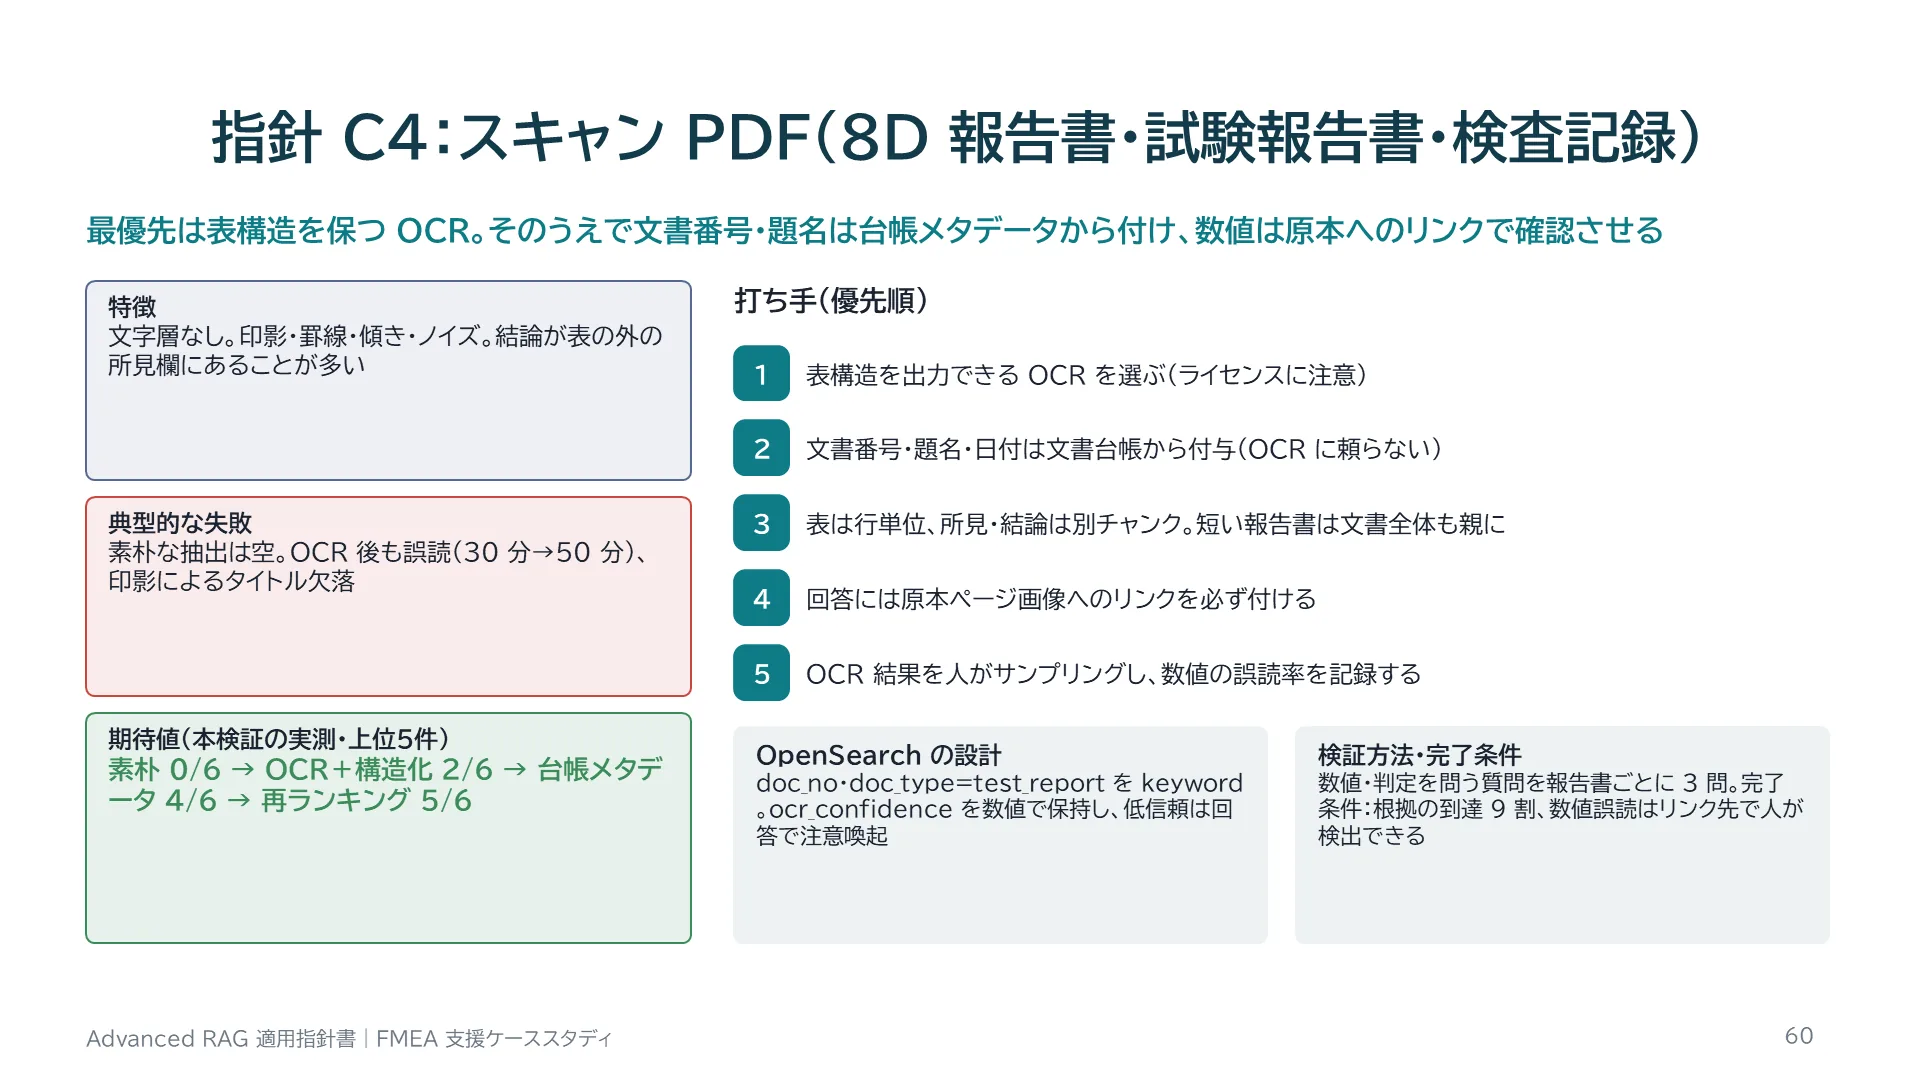
指針 C4:スキャン PDF(8D 報告書・試験報告書・検査記録)
スライド 60 のテキストと解説
指針 C4:スキャン PDF(8D 報告書・試験報告書・検査記録) 最優先は表構造を保つ OCR。そのうえで文書番号・題名は台帳メタデータから付け、数値は原本へのリンクで確認させる 特徴 文字層なし。印影・罫線・傾き・ノイズ。結論が表の外の所見欄にあることが多い 典型的な失敗 素朴な抽出は空。OCR 後も誤読(30 分→50 分)、印影によるタイトル欠落 期待値(本検証の実測・上位5件) 素朴 0/6 → OCR+構造化 2/6 → 台帳メタデータ 4/6 → 再ランキング 5/6 打ち手(優先順) 1 表構造を出力できる OCR を選ぶ(ライセンスに注意) 2 文書番号・題名・日付は文書台帳から付与(OCR に頼らない) 3 表は行単位、所見・結論は別チャンク。短い報告書は文書全体も親に 4 回答には原本ページ画像へのリンクを必ず付ける 5 OCR 結果を人がサンプリングし、数値の誤読率を記録する OpenSearch の設計 doc_no・doc_type=test_report を keyword。ocr_confidence を数値で保持し、低信頼は回答で注意喚起 検証方法・完了条件 数値・判定を問う質問を報告書ごとに 3 問。完了条件:根拠の到達 9 割、数値誤読はリンク先で人が検出できる 60
解説

スキャンPDFの指針です。素朴な抽出では0問で、OCRで表を戻して2問、文書台帳のメタデータでヘッダを付けて4問、再ランキングで5問でした。OCRは数値の誤読を起こすので、検索の改善とは別に、回答に原本へのリンクを付けて人が確認できるようにすることが重要です。本検証で使ったYomiTokuのOSS版は非商用ライセンスなので、本番では商用ライセンスか別のOCRを選定してください。
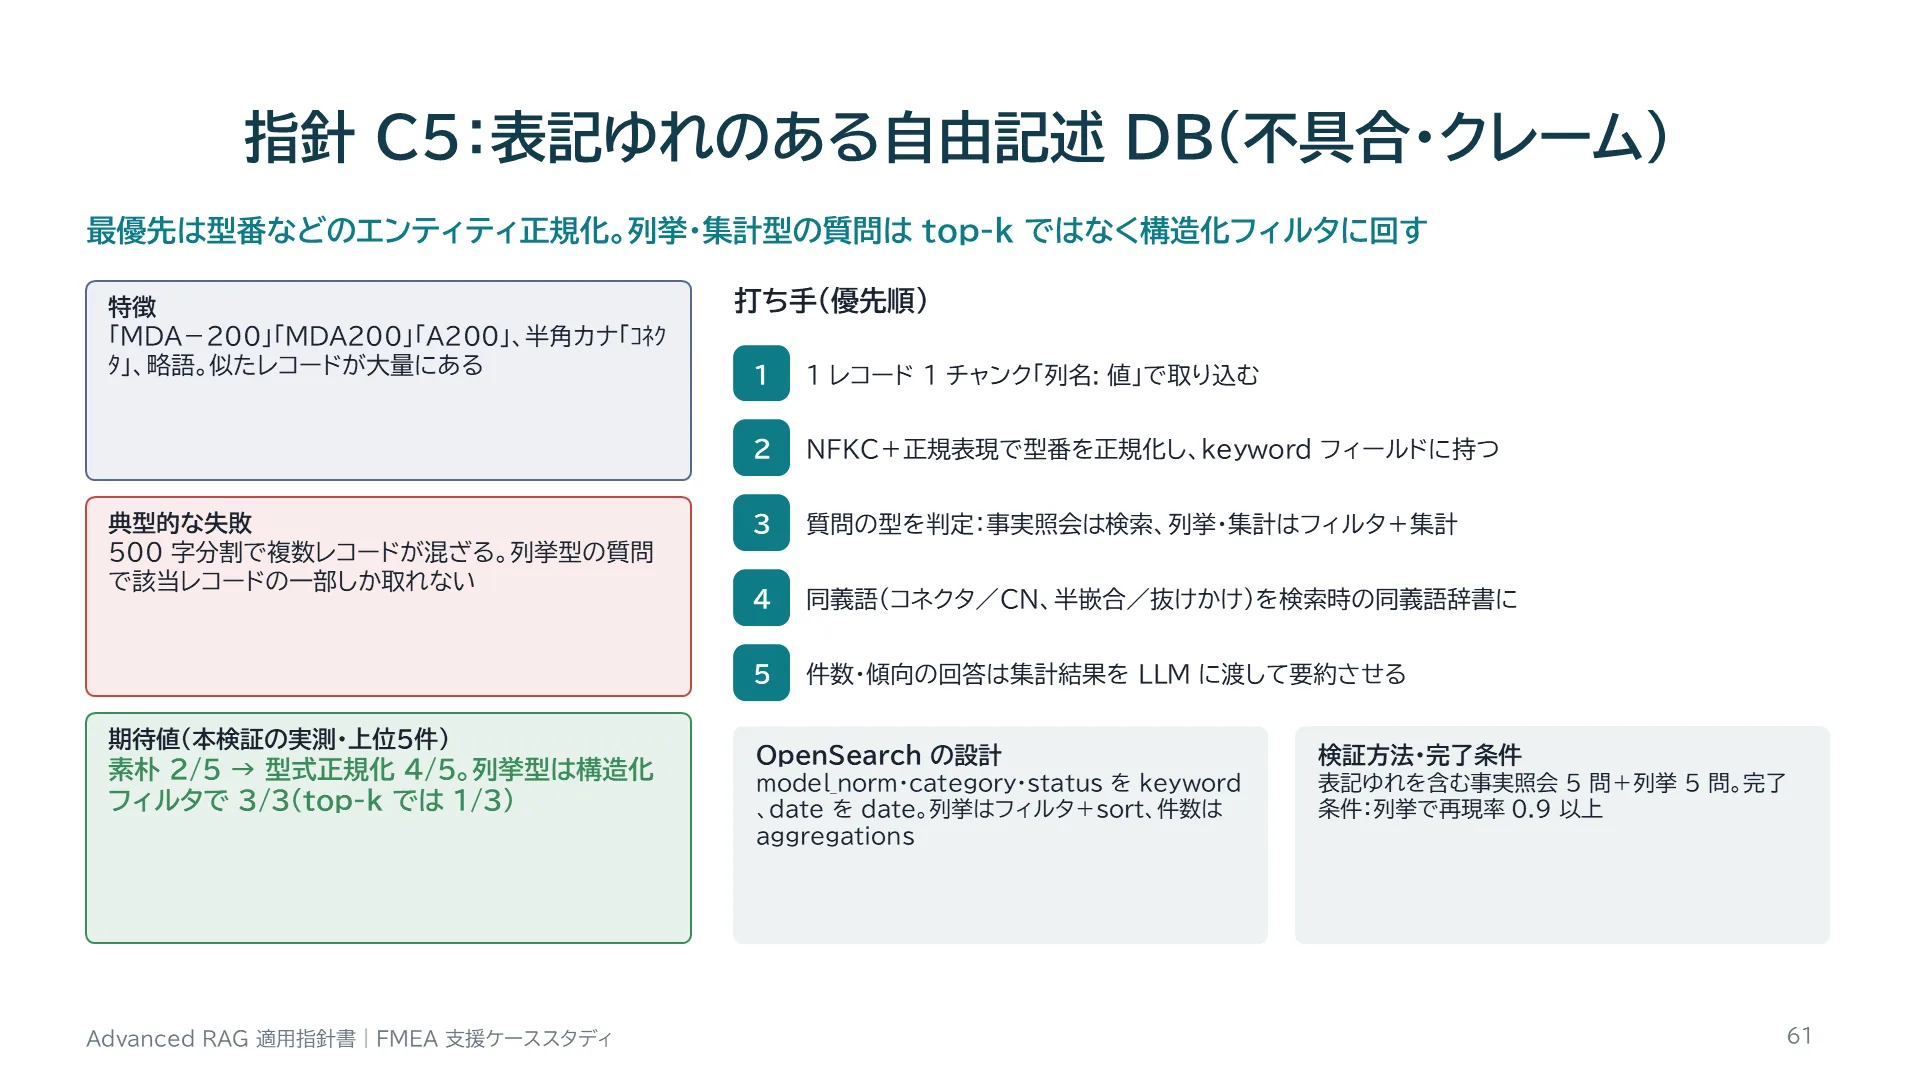
指針 C5:表記ゆれのある自由記述 DB(不具合・クレーム)
スライド 61 のテキストと解説
指針 C5:表記ゆれのある自由記述 DB(不具合・クレーム) 最優先は型番などのエンティティ正規化。列挙・集計型の質問は top-k ではなく構造化フィルタに回す 特徴 「MDA-200」「MDA200」「A200」、半角カナ「コネクタ」、略語。似たレコードが大量にある 典型的な失敗 500 字分割で複数レコードが混ざる。列挙型の質問で該当レコードの一部しか取れない 期待値(本検証の実測・上位5件) 素朴 2/5 → 型式正規化 4/5。列挙型は構造化フィルタで 3/3(top-k では 1/3) 打ち手(優先順) 1 1 レコード 1 チャンク「列名: 値」で取り込む 2 NFKC+正規表現で型番を正規化し、keyword フィールドに持つ 3 質問の型を判定:事実照会は検索、列挙・集計はフィルタ+集計 4 同義語(コネクタ/CN、半嵌合/抜けかけ)を検索時の同義語辞書に 5 件数・傾向の回答は集計結果を LLM に渡して要約させる OpenSearch の設計 model_norm・category・status を keyword、date を date。列挙はフィルタ+sort、件数は aggregations 検証方法・完了条件 表記ゆれを含む事実照会 5 問+列挙 5 問。完了条件:列挙で再現率 0.9 以上 61
解説

表記ゆれDBの指針です。型番の正規化で2/5から4/5に改善しました。残った1問は列挙型の質問で、top-k検索では3件中1件しか取れませんでしたが、正規化型式によるフィルタでは3件すべて取れました。不具合DBは本来データベースなので、全部をRAGで扱わず、質問の型に応じて構造化検索とRAGを使い分けるのが正解です。
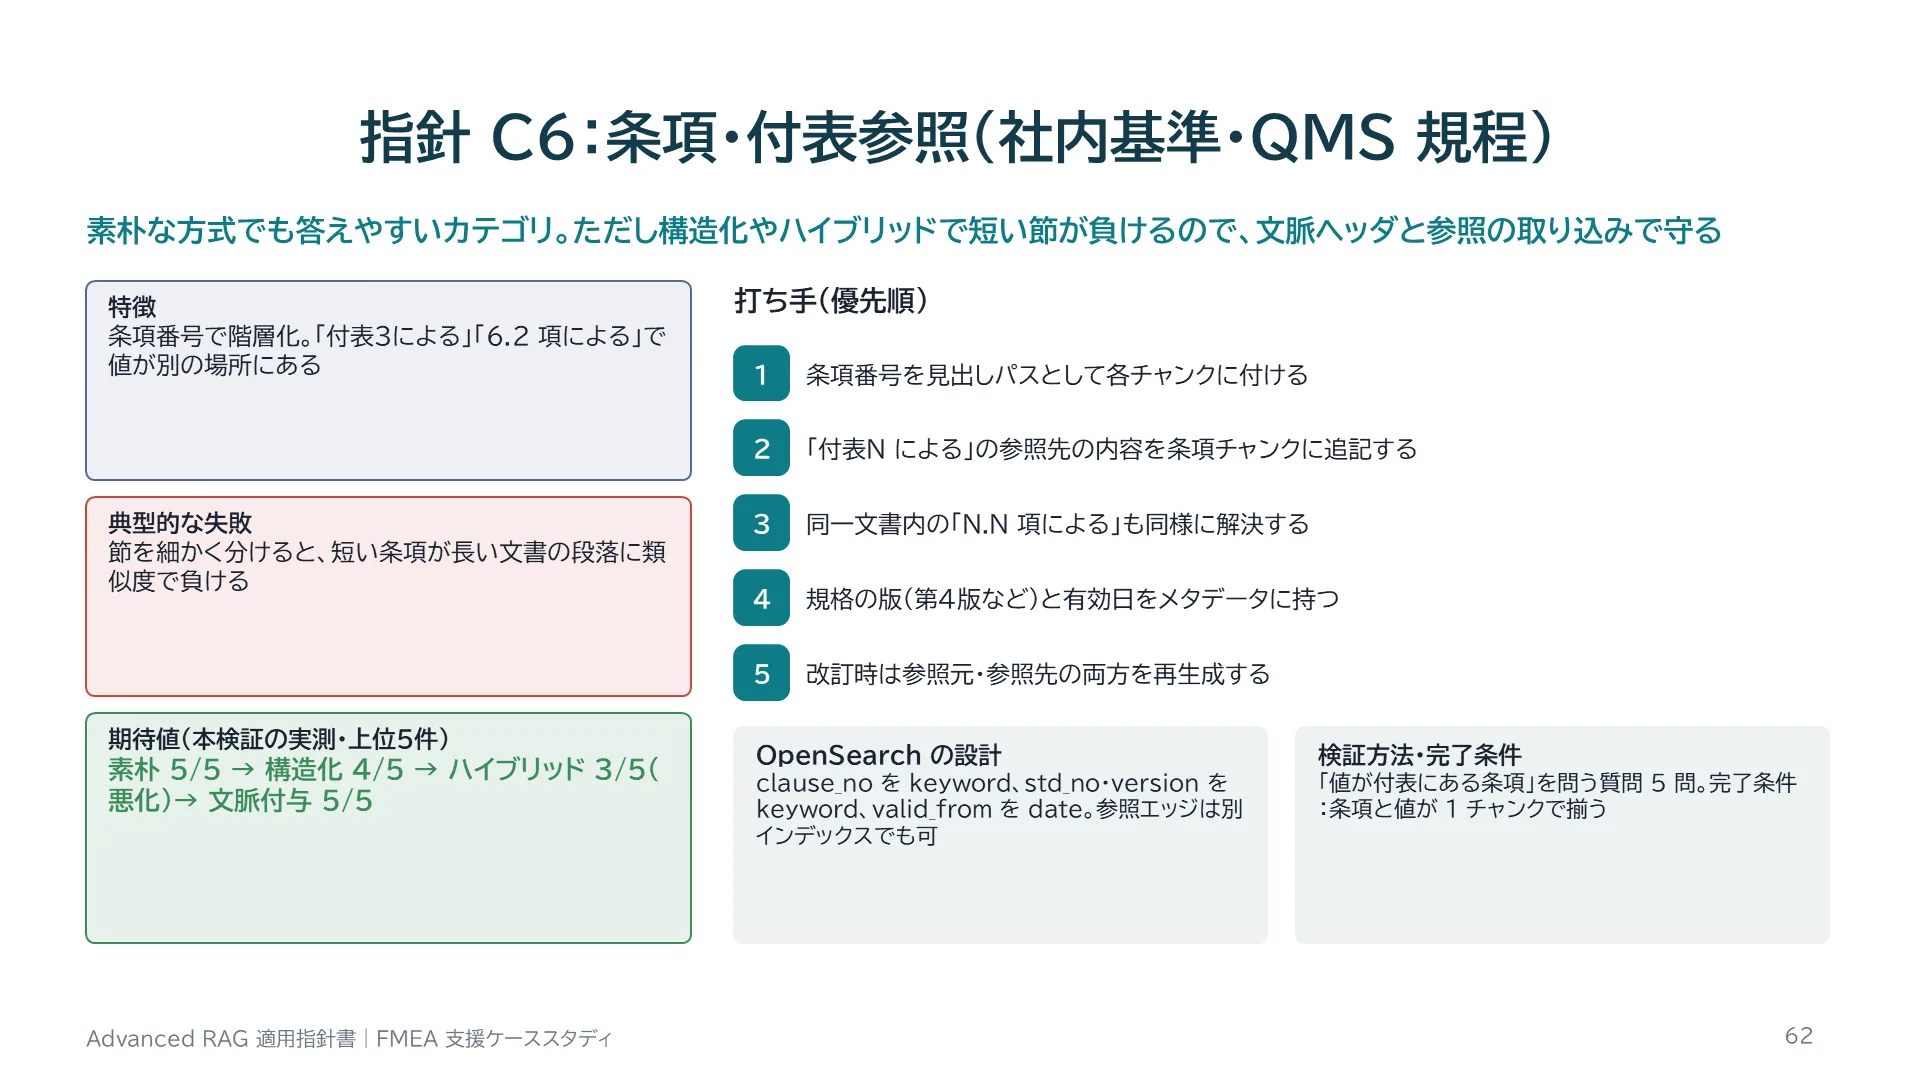
指針 C6:条項・付表参照(社内基準・QMS 規程)
スライド 62 のテキストと解説
指針 C6:条項・付表参照(社内基準・QMS 規程) 素朴な方式でも答えやすいカテゴリ。ただし構造化やハイブリッドで短い節が負けるので、文脈ヘッダと参照の取り込みで守る 特徴 条項番号で階層化。「付表3による」「6.2 項による」で値が別の場所にある 典型的な失敗 節を細かく分けると、短い条項が長い文書の段落に類似度で負ける 期待値(本検証の実測・上位5件) 素朴 5/5 → 構造化 4/5 → ハイブリッド 3/5(悪化)→ 文脈付与 5/5 打ち手(優先順) 1 条項番号を見出しパスとして各チャンクに付ける 2 「付表N による」の参照先の内容を条項チャンクに追記する 3 同一文書内の「N.N 項による」も同様に解決する 4 規格の版(第4版など)と有効日をメタデータに持つ 5 改訂時は参照元・参照先の両方を再生成する OpenSearch の設計 clause_no を keyword、std_no・version を keyword、valid_from を date。参照エッジは別インデックスでも可 検証方法・完了条件 「値が付表にある条項」を問う質問 5 問。完了条件:条項と値が 1 チャンクで揃う 62
解説

条項・付表参照の指針です。もともと文書が短いので素朴な方式でも5/5でしたが、構造化とハイブリッドで一時的に3/5まで下がりました。短い条項のチャンクが、他の長い文書の段落に類似度やBM25で負けたためです。文脈ヘッダで文書名と条項番号を付けて回復しました。改善の途中で既存の正答が失われることがあるので、カテゴリ別の回帰確認が必須です。
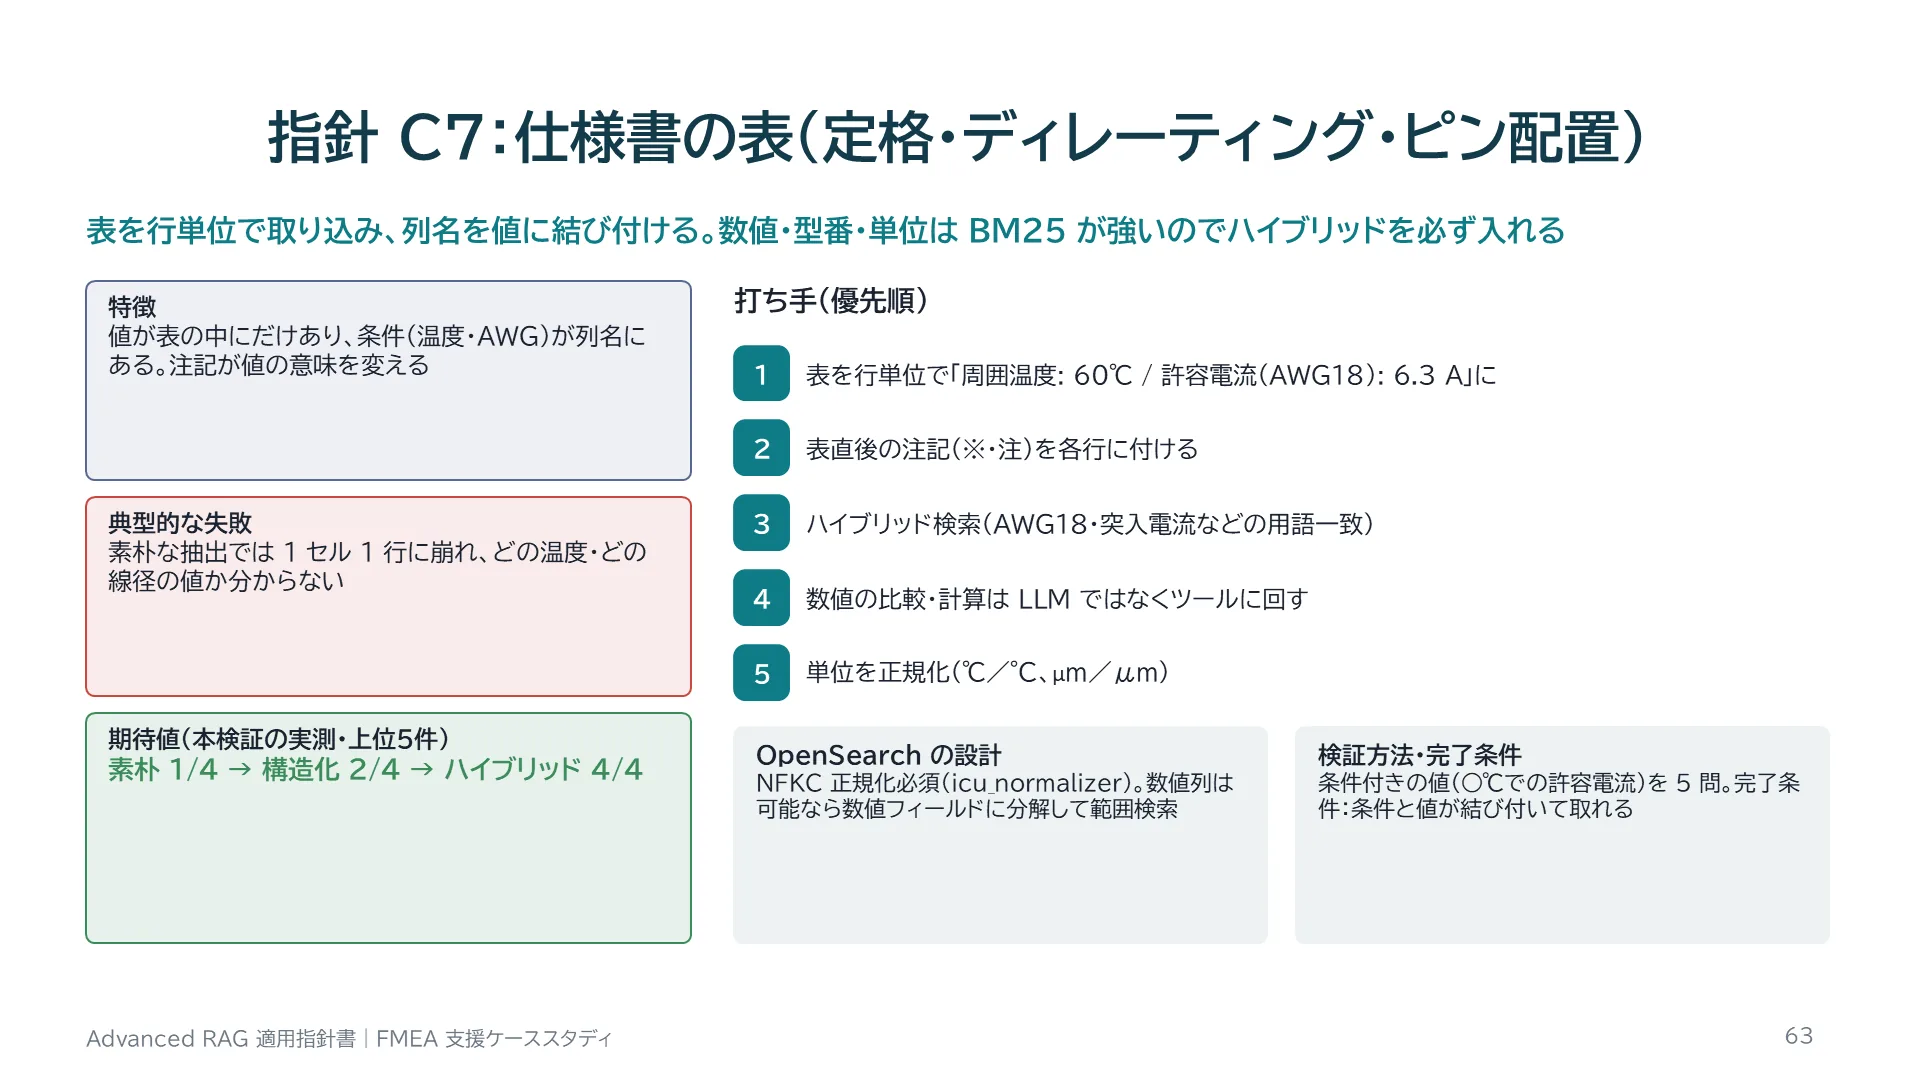
指針 C7:仕様書の表(定格・ディレーティング・ピン配置)
スライド 63 のテキストと解説
指針 C7:仕様書の表(定格・ディレーティング・ピン配置) 表を行単位で取り込み、列名を値に結び付ける。数値・型番・単位は BM25 が強いのでハイブリッドを必ず入れる 特徴 値が表の中にだけあり、条件(温度・AWG)が列名にある。注記が値の意味を変える 典型的な失敗 素朴な抽出では 1 セル 1 行に崩れ、どの温度・どの線径の値か分からない 期待値(本検証の実測・上位5件) 素朴 1/4 → 構造化 2/4 → ハイブリッド 4/4 打ち手(優先順) 1 表を行単位で「周囲温度: 60℃ / 許容電流(AWG18): 6.3 A」に 2 表直後の注記(※・注)を各行に付ける 3 ハイブリッド検索(AWG18・突入電流などの用語一致) 4 数値の比較・計算は LLM ではなくツールに回す 5 単位を正規化(℃/°C、µm/μm) OpenSearch の設計 NFKC 正規化必須(icu_normalizer)。数値列は可能なら数値フィールドに分解して範囲検索 検証方法・完了条件 条件付きの値(○℃での許容電流)を 5 問。完了条件:条件と値が結び付いて取れる 63
解説

仕様書の表の指針です。表を行単位で取り込み、ハイブリッド検索を入れると4/4になりました。AWG18や突入電流のような用語は、意味の埋め込みよりBM25の文字列一致が得意です。表の注記が値の意味を変えることが多いので、注記を各行に付けることも重要です。
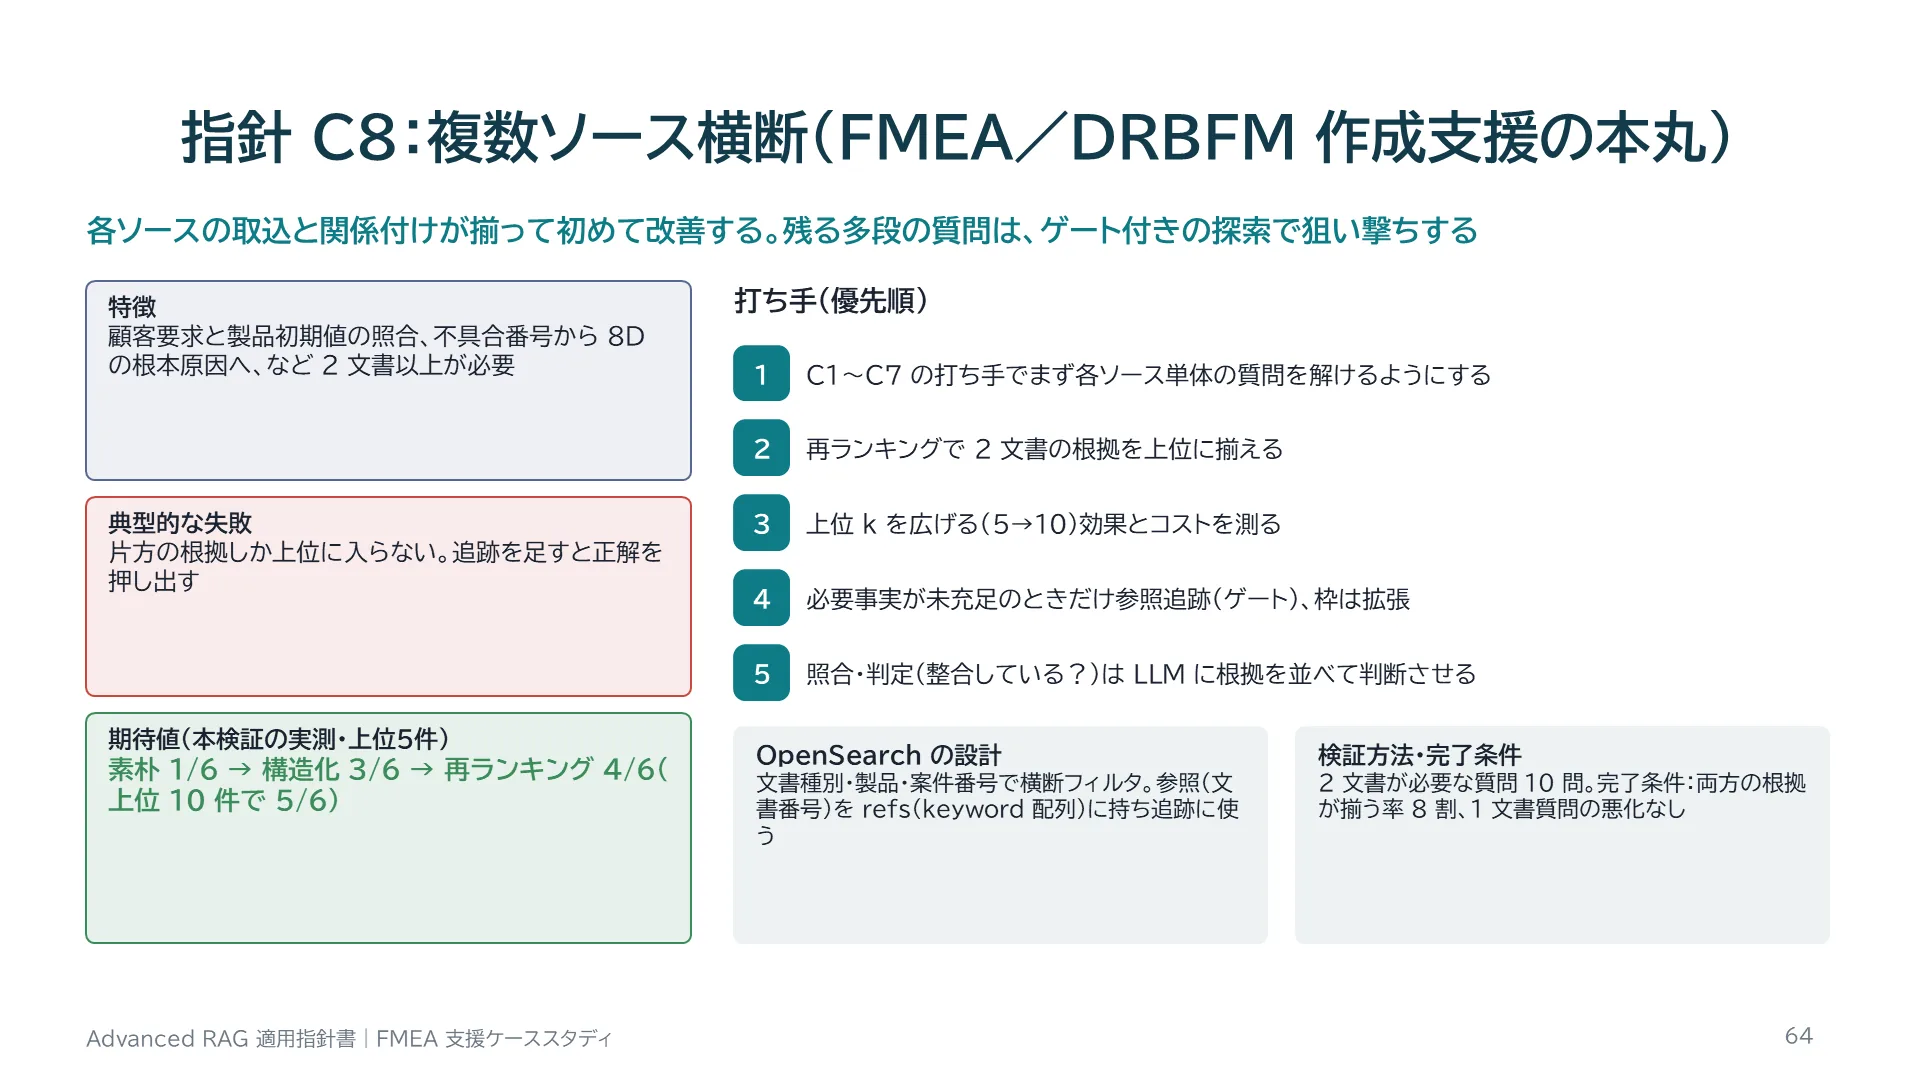
指針 C8:複数ソース横断(FMEA/DRBFM 作成支援の本丸)
スライド 64 のテキストと解説
指針 C8:複数ソース横断(FMEA/DRBFM 作成支援の本丸) 各ソースの取込と関係付けが揃って初めて改善する。残る多段の質問は、ゲート付きの探索で狙い撃ちする 特徴 顧客要求と製品初期値の照合、不具合番号から 8D の根本原因へ、など 2 文書以上が必要 典型的な失敗 片方の根拠しか上位に入らない。追跡を足すと正解を押し出す 期待値(本検証の実測・上位5件) 素朴 1/6 → 構造化 3/6 → 再ランキング 4/6(上位 10 件で 5/6) 打ち手(優先順) 1 C1〜C7 の打ち手でまず各ソース単体の質問を解けるようにする 2 再ランキングで 2 文書の根拠を上位に揃える 3 上位 k を広げる(5→10)効果とコストを測る 4 必要事実が未充足のときだけ参照追跡(ゲート)、枠は拡張 5 照合・判定(整合している?)は LLM に根拠を並べて判断させる OpenSearch の設計 文書種別・製品・案件番号で横断フィルタ。参照(文書番号)を refs(keyword 配列)に持ち追跡に使う 検証方法・完了条件 2 文書が必要な質問 10 問。完了条件:両方の根拠が揃う率 8 割、1 文書質問の悪化なし 64
解説

複数ソース横断の指針です。FMEAやDRBFM作成支援の本丸で、最も難しいカテゴリでした。素朴なRAGでは1/6、構造化で3/6、再ランキングで4/6、上位10件にすると5/6です。各ソースを単体で正しく取れることが前提で、その上で、多段の探索はゲート付きで狙い撃ちします。参照追跡を無条件に入れると正解を押し出すことを、本検証で確認しています。
PART F
スライド 65 のテキストと解説
PART F OpenSearch の設計 検証で使った最小構成を、本番で使える設計に拡張する このPartで答えられるようになる問い インデックスはソースごとに分けるか、1 つにまとめるか? どんなフィールドを持たせるべきか? クエリはどんな段階を通るか? 65
解説

Part Fは、検証構成から本番構成への拡張です。権限・版・削除の扱いは前作のPart 4を参照してください。
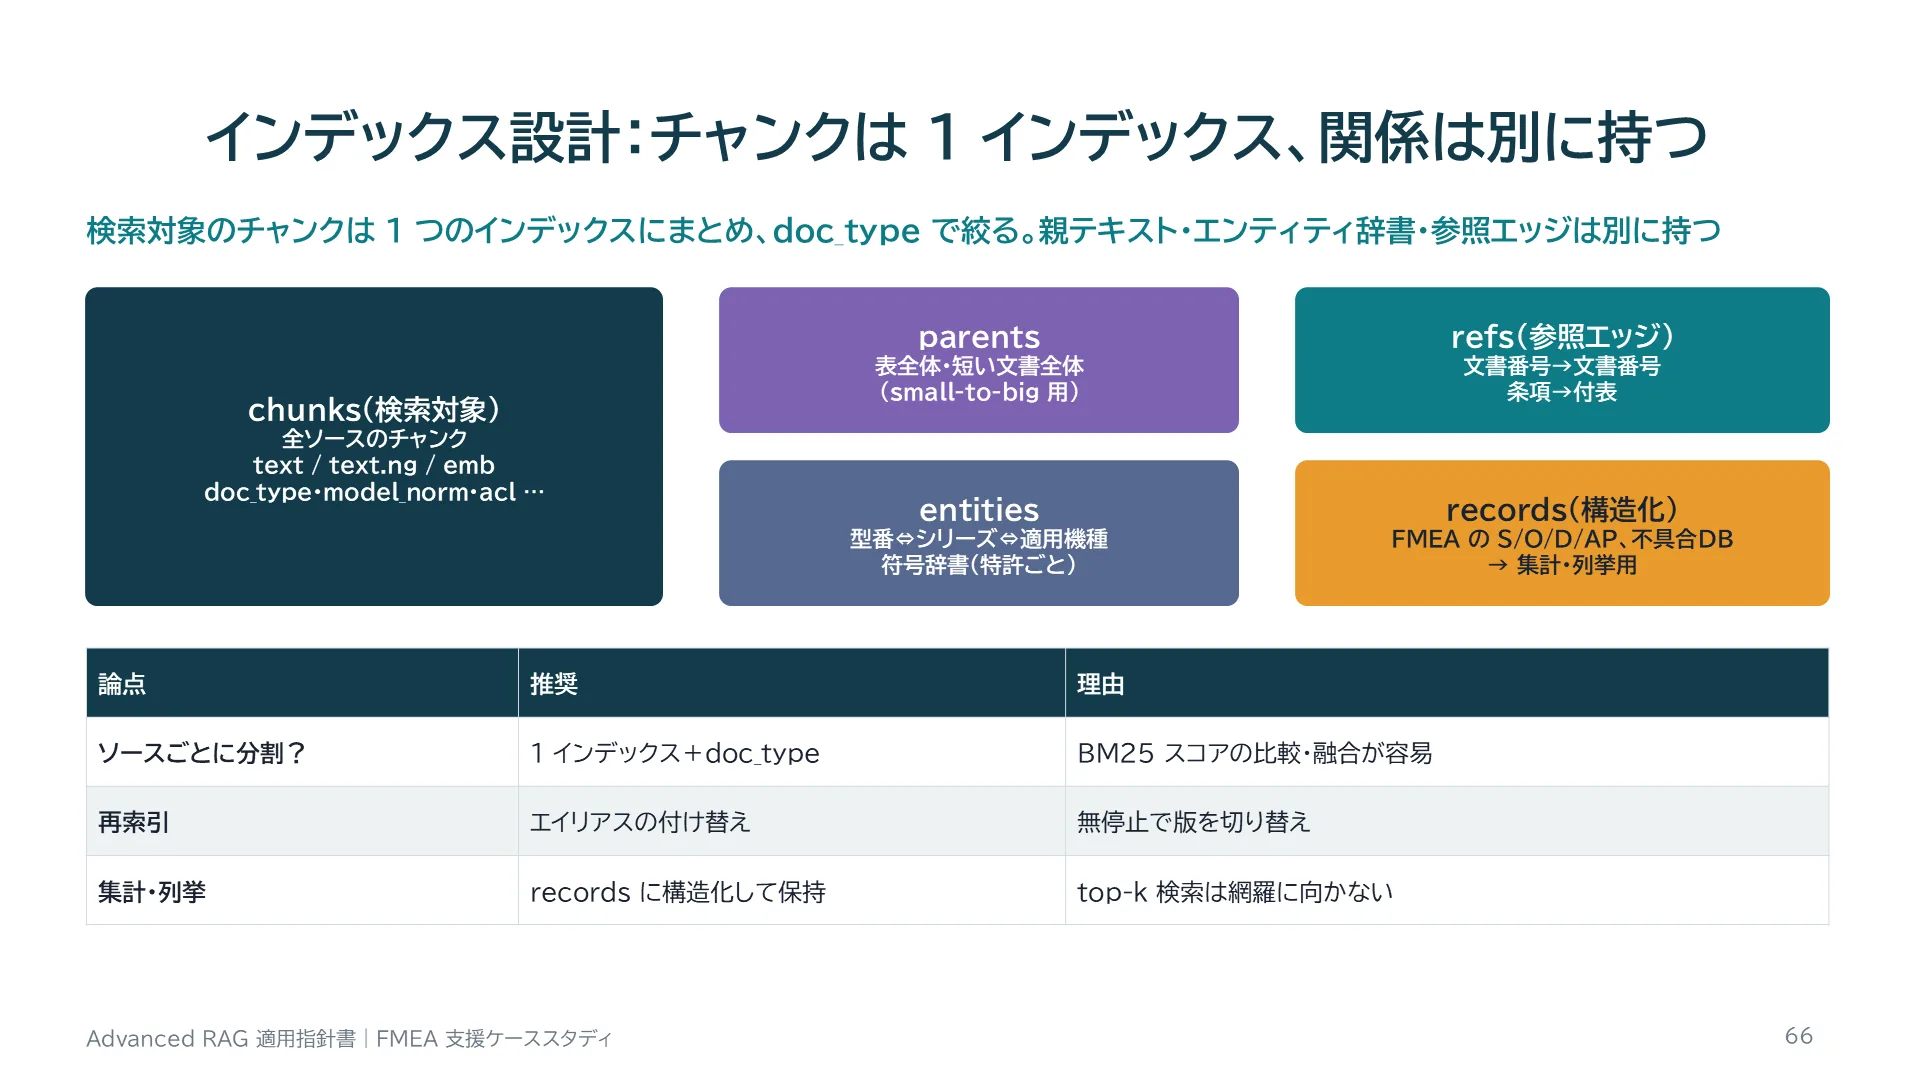
インデックス設計:チャンクは 1 インデックス、関係は別に持つ
スライド 66 のテキストと解説
インデックス設計:チャンクは 1 インデックス、関係は別に持つ 検索対象のチャンクは 1 つのインデックスにまとめ、doc_type で絞る。親テキスト・エンティティ辞書・参照エッジは別に持つ chunks(検索対象) 全ソースのチャンク text / text.ng / emb doc_type・model_norm・acl … parents 表全体・短い文書全体 (small-to-big 用) entities 型番⇔シリーズ⇔適用機種 符号辞書(特許ごと) refs(参照エッジ) 文書番号→文書番号 条項→付表 records(構造化) FMEA の S/O/D/AP、不具合DB → 集計・列挙用 論点 | 推奨 | 理由 ソースごとに分割? | 1 インデックス+doc_type | BM25 スコアの比較・融合が容易 再索引 | エイリアスの付け替え | 無停止で版を切り替え 集計・列挙 | records に構造化して保持 | top-k 検索は網羅に向かない 66
解説

検証では、チャンク集合ごとに1つのインデックスを作りました。本番では、検索対象のチャンクを1つのインデックスにまとめ、文書の種類をdoc_typeフィールドで区別するのを推奨します。ソースごとにインデックスを分けると、BM25のスコアが比較できず、横断検索の融合が難しくなるためです(分けるならRRFで融合)。表全体や文書全体の親テキスト、型番とシリーズの辞書、文書間の参照エッジは、検索対象ではないので別のインデックスやストアに持ちます。版の切り替えは、エイリアスを新しいインデックスに付け替える方式にすると、無停止で再索引できます。
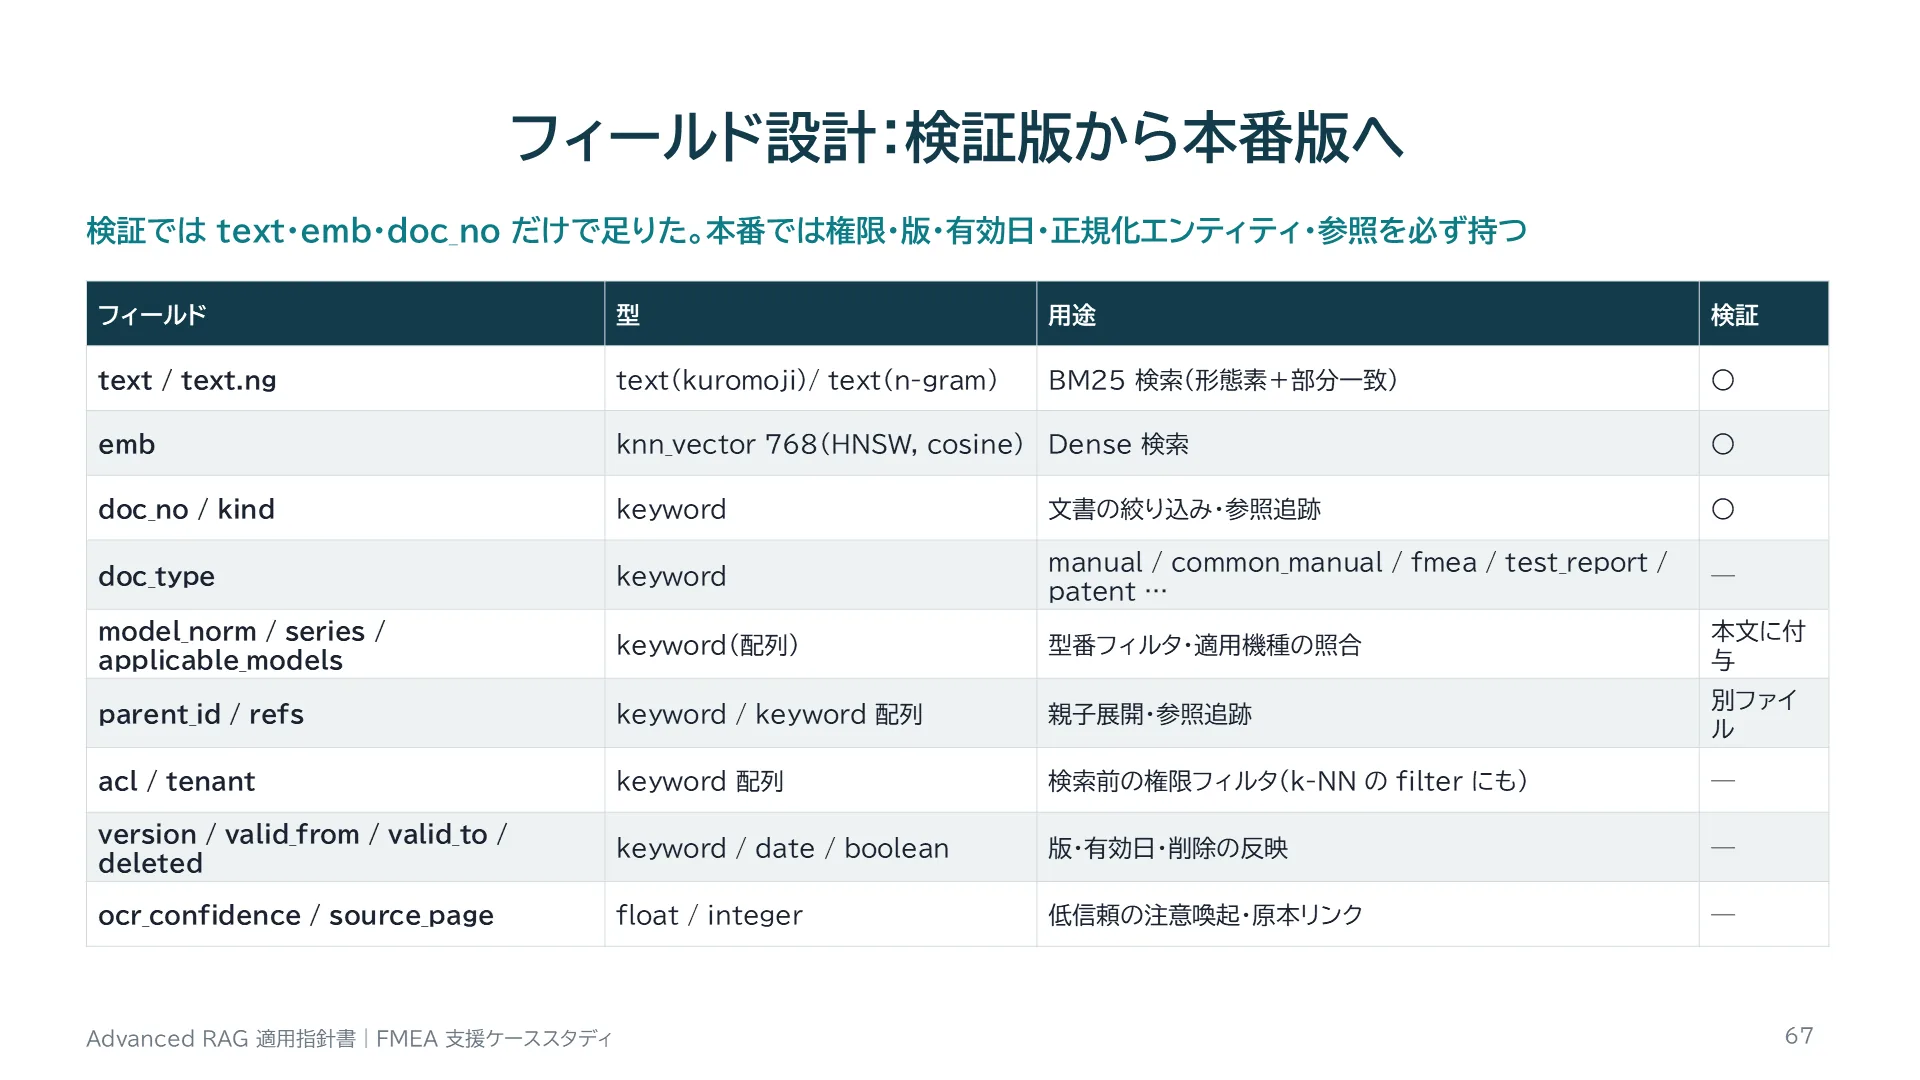
フィールド設計:検証版から本番版へ
スライド 67 のテキストと解説
フィールド設計:検証版から本番版へ 検証では text・emb・doc_no だけで足りた。本番では権限・版・有効日・正規化エンティティ・参照を必ず持つ フィールド | 型 | 用途 | 検証 text / text.ng | text(kuromoji)/ text(n-gram) | BM25 検索(形態素+部分一致) | ○ emb | knn_vector 768(HNSW, cosine) | Dense 検索 | ○ doc_no / kind | keyword | 文書の絞り込み・参照追跡 | ○ doc_type | keyword | manual / common_manual / fmea / test_report / patent … | — model_norm / series / applicable_models | keyword(配列) | 型番フィルタ・適用機種の照合 | 本文に付与 parent_id / refs | keyword / keyword 配列 | 親子展開・参照追跡 | 別ファイル acl / tenant | keyword 配列 | 検索前の権限フィルタ(k-NN の filter にも) | — version / valid_from / valid_to / deleted | keyword / date / boolean | 版・有効日・削除の反映 | — ocr_confidence / source_page | float / integer | 低信頼の注意喚起・原本リンク | — 67
解説

チャンクインデックスのフィールド設計です。検証で使ったのは上4行です。本番では、前作で学んだ権限と鮮度の要件を満たすために、acl、version、valid_from、valid_to、deletedを追加し、検索時にフィルタします。正規化した型番やシリーズ、文書の種類はキーワード型にして、絞り込みと集計に使います。parent_idとrefsは親子展開と参照追跡に使います。ocr_confidenceは、OCR由来のチャンクに注意書きを出すために使います。
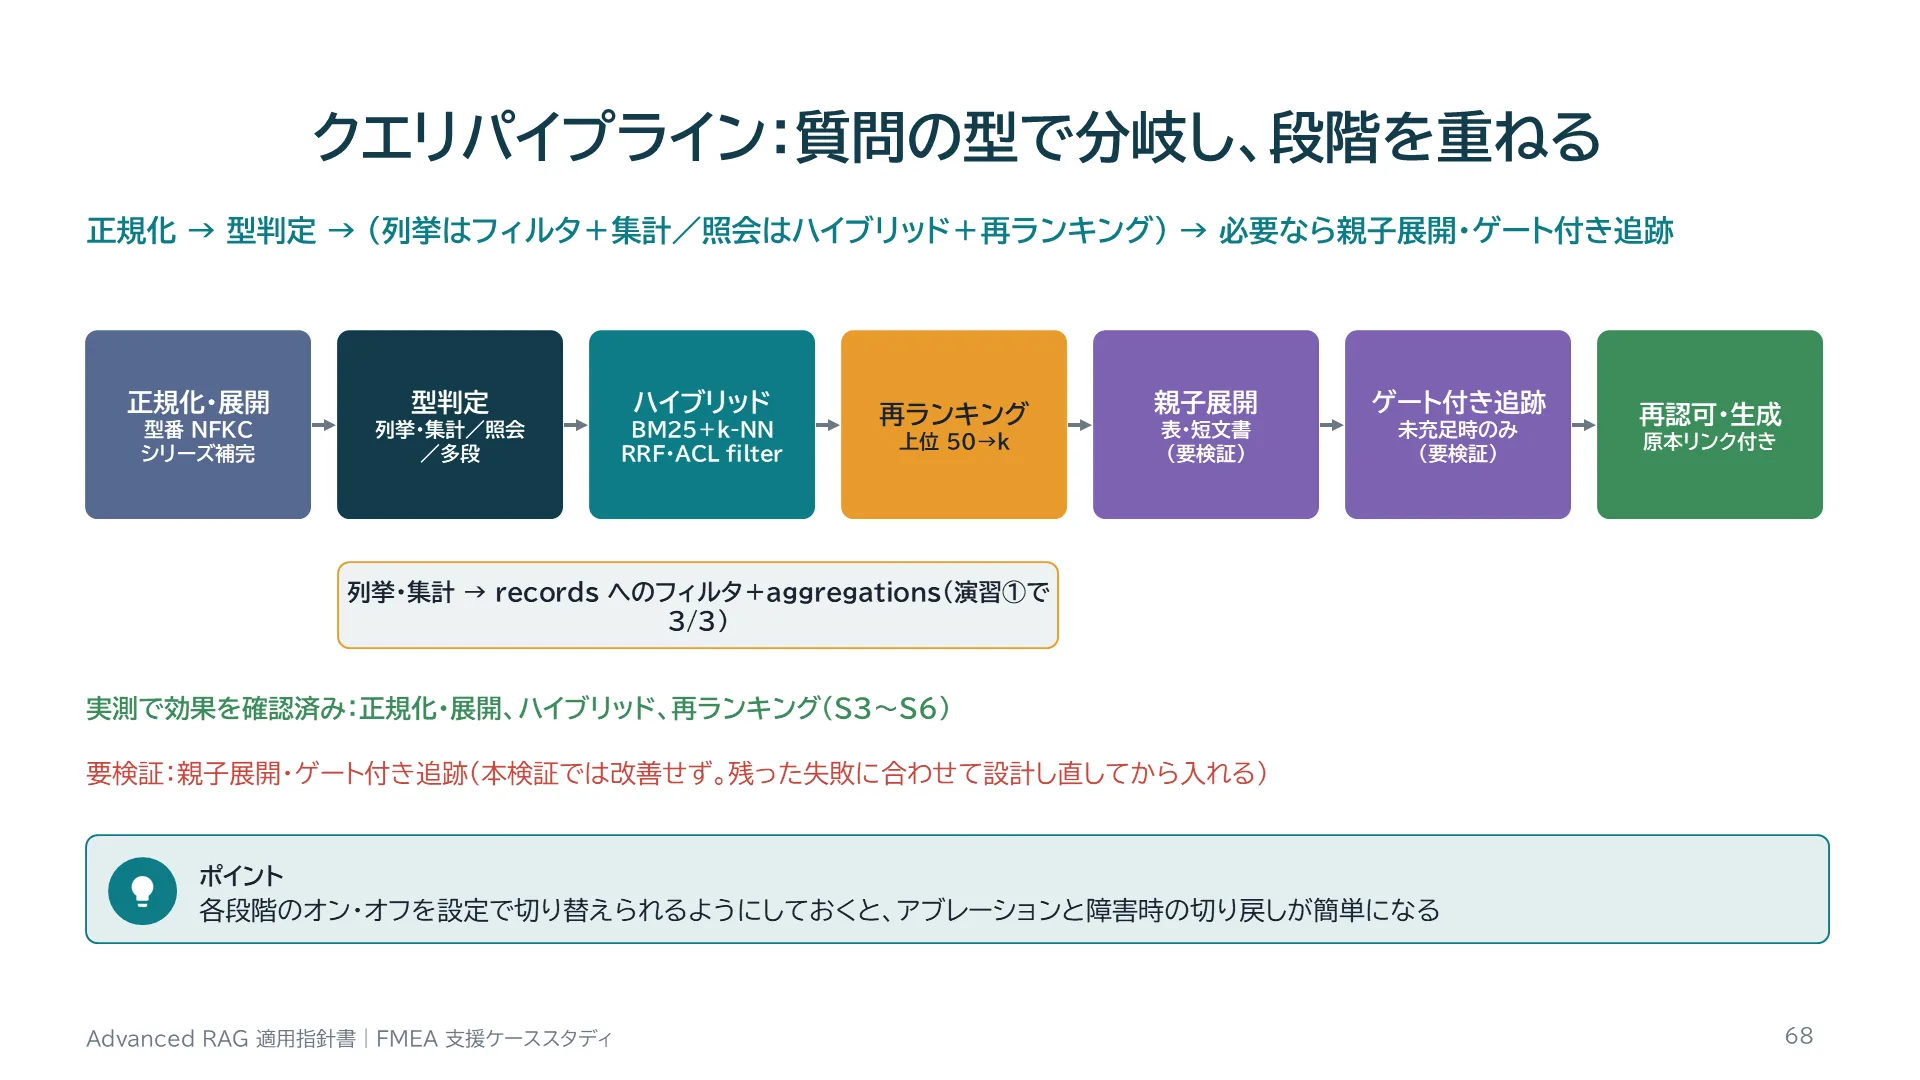
クエリパイプライン:質問の型で分岐し、段階を重ねる
スライド 68 のテキストと解説
クエリパイプライン:質問の型で分岐し、段階を重ねる 正規化 → 型判定 → (列挙はフィルタ+集計/照会はハイブリッド+再ランキング) → 必要なら親子展開・ゲート付き追跡 正規化・展開 型番 NFKC シリーズ補完 型判定 列挙・集計/照会 /多段 ハイブリッド BM25+k-NN RRF・ACL filter 再ランキング 上位 50→k 親子展開 表・短文書 (要検証) ゲート付き追跡 未充足時のみ (要検証) 再認可・生成 原本リンク付き 列挙・集計 → records へのフィルタ+aggregations(演習①で 3/3) 実測で効果を確認済み:正規化・展開、ハイブリッド、再ランキング(S3〜S6) 要検証:親子展開・ゲート付き追跡(本検証では改善せず。残った失敗に合わせて設計し直してから入れる) ポイント 各段階のオン・オフを設定で切り替えられるようにしておくと、アブレーションと障害時の切り戻しが簡単になる 68
解説

本番のクエリパイプラインの全体像です。まず質問の型番を正規化してシリーズを補い、質問の型を判定します。列挙や集計の質問は構造化フィルタと集計に回し、事実照会はハイブリッド検索と再ランキングで上位k件を取ります。表や短い報告書は親子展開で全体を読ませ、必要な事実が足りないと判定されたときだけ参照追跡を行います。最後に権限を再確認して、根拠のリンク付きでLLMに渡します。本検証で効果が確認できたのは、正規化からハイブリッド+再ランキングまでです。親子展開とゲート付き追跡は、残った失敗に合わせて検証してから入れます。
PART G
スライド 69 のテキストと解説
PART G テックリーダーの進め方 本ケースの経験を、部下への指示・期待値の伝え方・レビュー・計画に落とし込む このPartで答えられるようになる問い 部下にどう指示を出すか? ステークホルダーに期待値をどう伝えるか? パーサや評価をどうレビューするか? この検証の限界は何か? 69
解説

Part Gでは、本ケースを実プロジェクトの進め方に翻訳します。

部下への指示テンプレート:仮説・打ち手・指標・完了条件
スライド 70 のテキストと解説
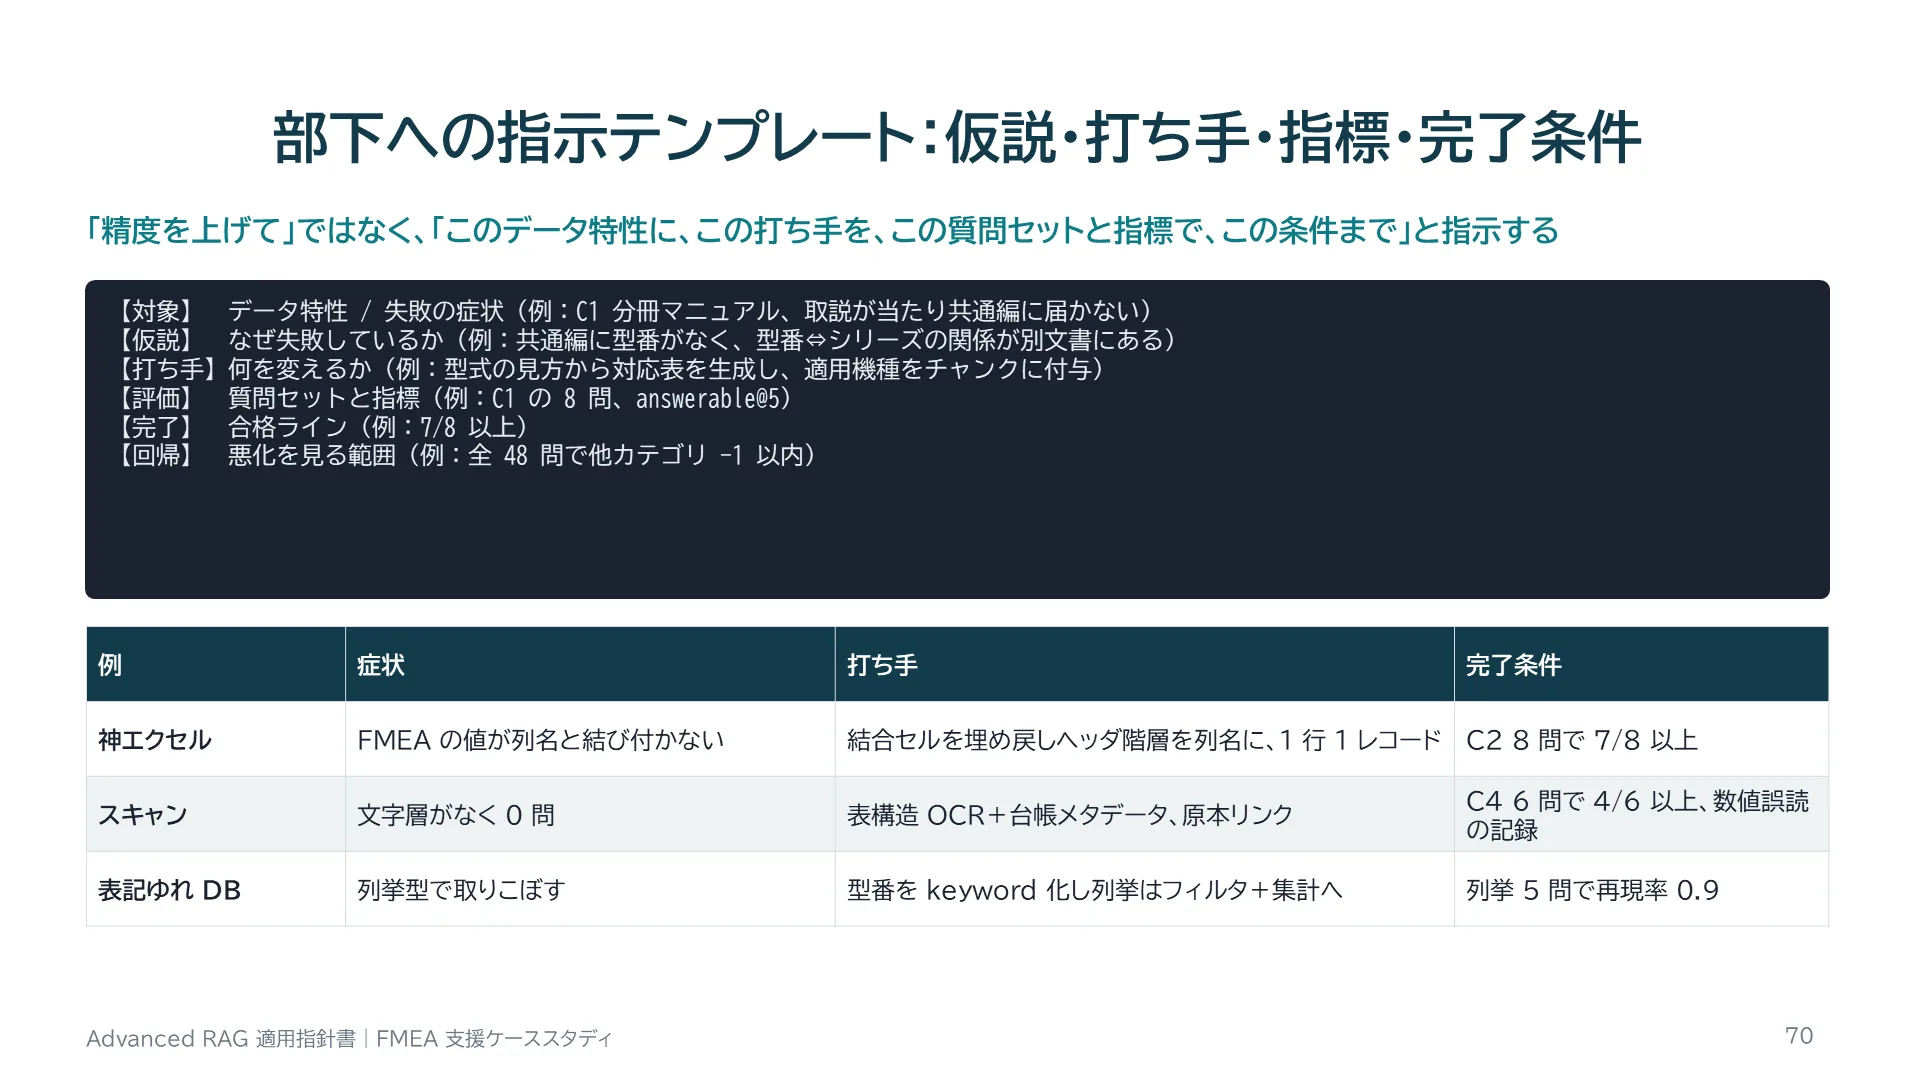
部下への指示テンプレート:仮説・打ち手・指標・完了条件 「精度を上げて」ではなく、「このデータ特性に、この打ち手を、この質問セットと指標で、この条件まで」と指示する 【対象】 データ特性 / 失敗の症状(例:C1 分冊マニュアル、取説が当たり共通編に届かない) 【仮説】 なぜ失敗しているか(例:共通編に型番がなく、型番⇔シリーズの関係が別文書にある) 【打ち手】何を変えるか(例:型式の見方から対応表を生成し、適用機種をチャンクに付与) 【評価】 質問セットと指標(例:C1 の 8 問、answerable@5) 【完了】 合格ライン(例:7/8 以上) 【回帰】 悪化を見る範囲(例:全 48 問で他カテゴリ −1 以内) 例 | 症状 | 打ち手 | 完了条件 神エクセル | FMEA の値が列名と結び付かない | 結合セルを埋め戻しヘッダ階層を列名に、1 行 1 レコード | C2 8 問で 7/8 以上 スキャン | 文字層がなく 0 問 | 表構造 OCR+台帳メタデータ、原本リンク | C4 6 問で 4/6 以上、数値誤読の記録 表記ゆれ DB | 列挙型で取りこぼす | 型番を keyword 化し列挙はフィルタ+集計へ | 列挙 5 問で再現率 0.9 70
解説

部下への指示のテンプレートと、本ケースから作った3つの例です。指示には、対象のデータ特性と失敗の症状、仮説、打ち手、評価に使う質問セットと指標、完了条件、そして悪化の確認範囲を必ず入れます。とくに最後の悪化の確認を入れないと、本検証のS2やS4で起きたように、あるカテゴリを改善して別のカテゴリを壊すことに気付けません。
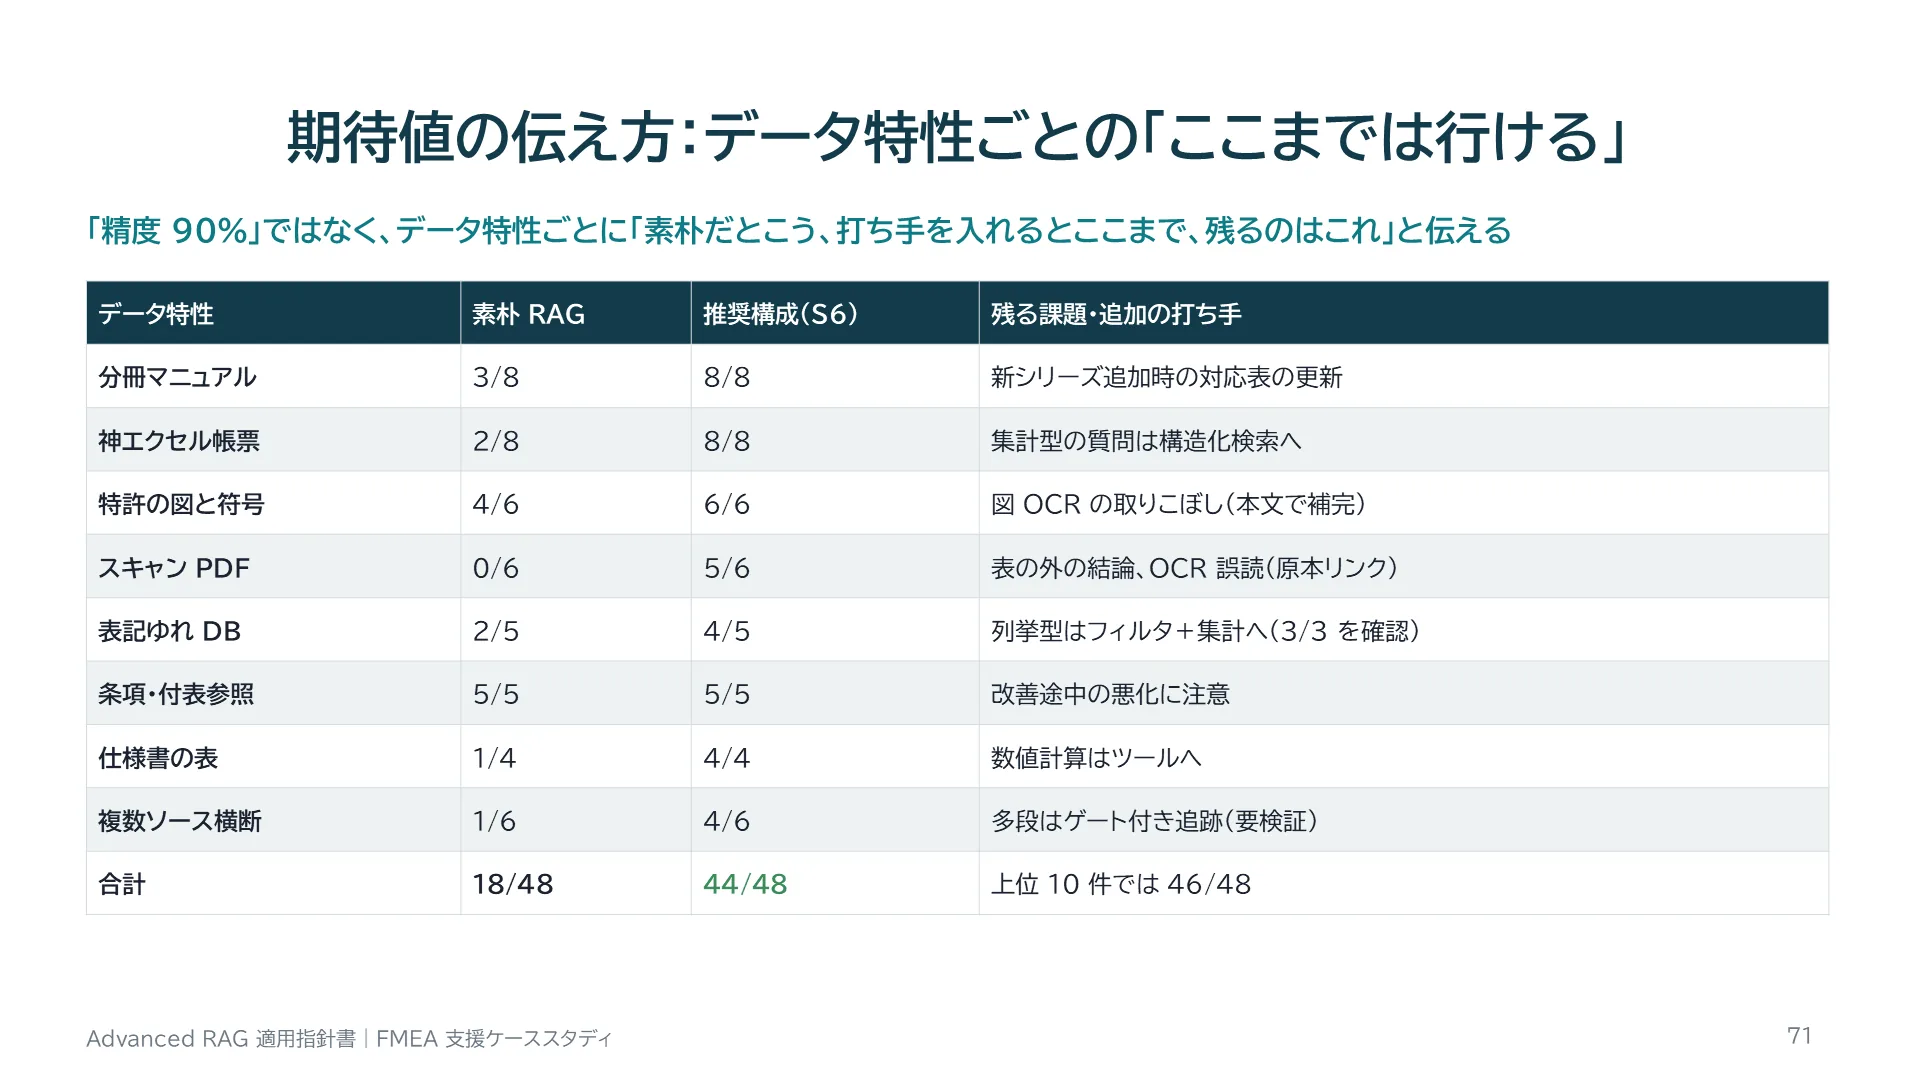
期待値の伝え方:データ特性ごとの「ここまでは行ける」
スライド 71 のテキストと解説
期待値の伝え方:データ特性ごとの「ここまでは行ける」 「精度 90%」ではなく、データ特性ごとに「素朴だとこう、打ち手を入れるとここまで、残るのはこれ」と伝える データ特性 | 素朴 RAG | 推奨構成(S6) | 残る課題・追加の打ち手 分冊マニュアル | 3/8 | 8/8 | 新シリーズ追加時の対応表の更新 神エクセル帳票 | 2/8 | 8/8 | 集計型の質問は構造化検索へ 特許の図と符号 | 4/6 | 6/6 | 図 OCR の取りこぼし(本文で補完) スキャン PDF | 0/6 | 5/6 | 表の外の結論、OCR 誤読(原本リンク) 表記ゆれ DB | 2/5 | 4/5 | 列挙型はフィルタ+集計へ(3/3 を確認) 条項・付表参照 | 5/5 | 5/5 | 改善途中の悪化に注意 仕様書の表 | 1/4 | 4/4 | 数値計算はツールへ 複数ソース横断 | 1/6 | 4/6 | 多段はゲート付き追跡(要検証) 合計 | 18/48 | 44/48 | 上位 10 件では 46/48 71
解説

ステークホルダーへの期待値の伝え方の例です。本検証の実測を、データ特性ごとに「素朴なRAG」「推奨構成(S6)」「残る課題」の3列でまとめました。数字は架空のデータでの実測なので、そのまま約束には使えませんが、「どのデータが難しく、何をすればどこまで行けるか」という見通しを示すには十分です。実プロジェクトでは、最初の2〜3週間で自社データの代表的な質問を集め、この表の自社版を作ってから計画を合意します。
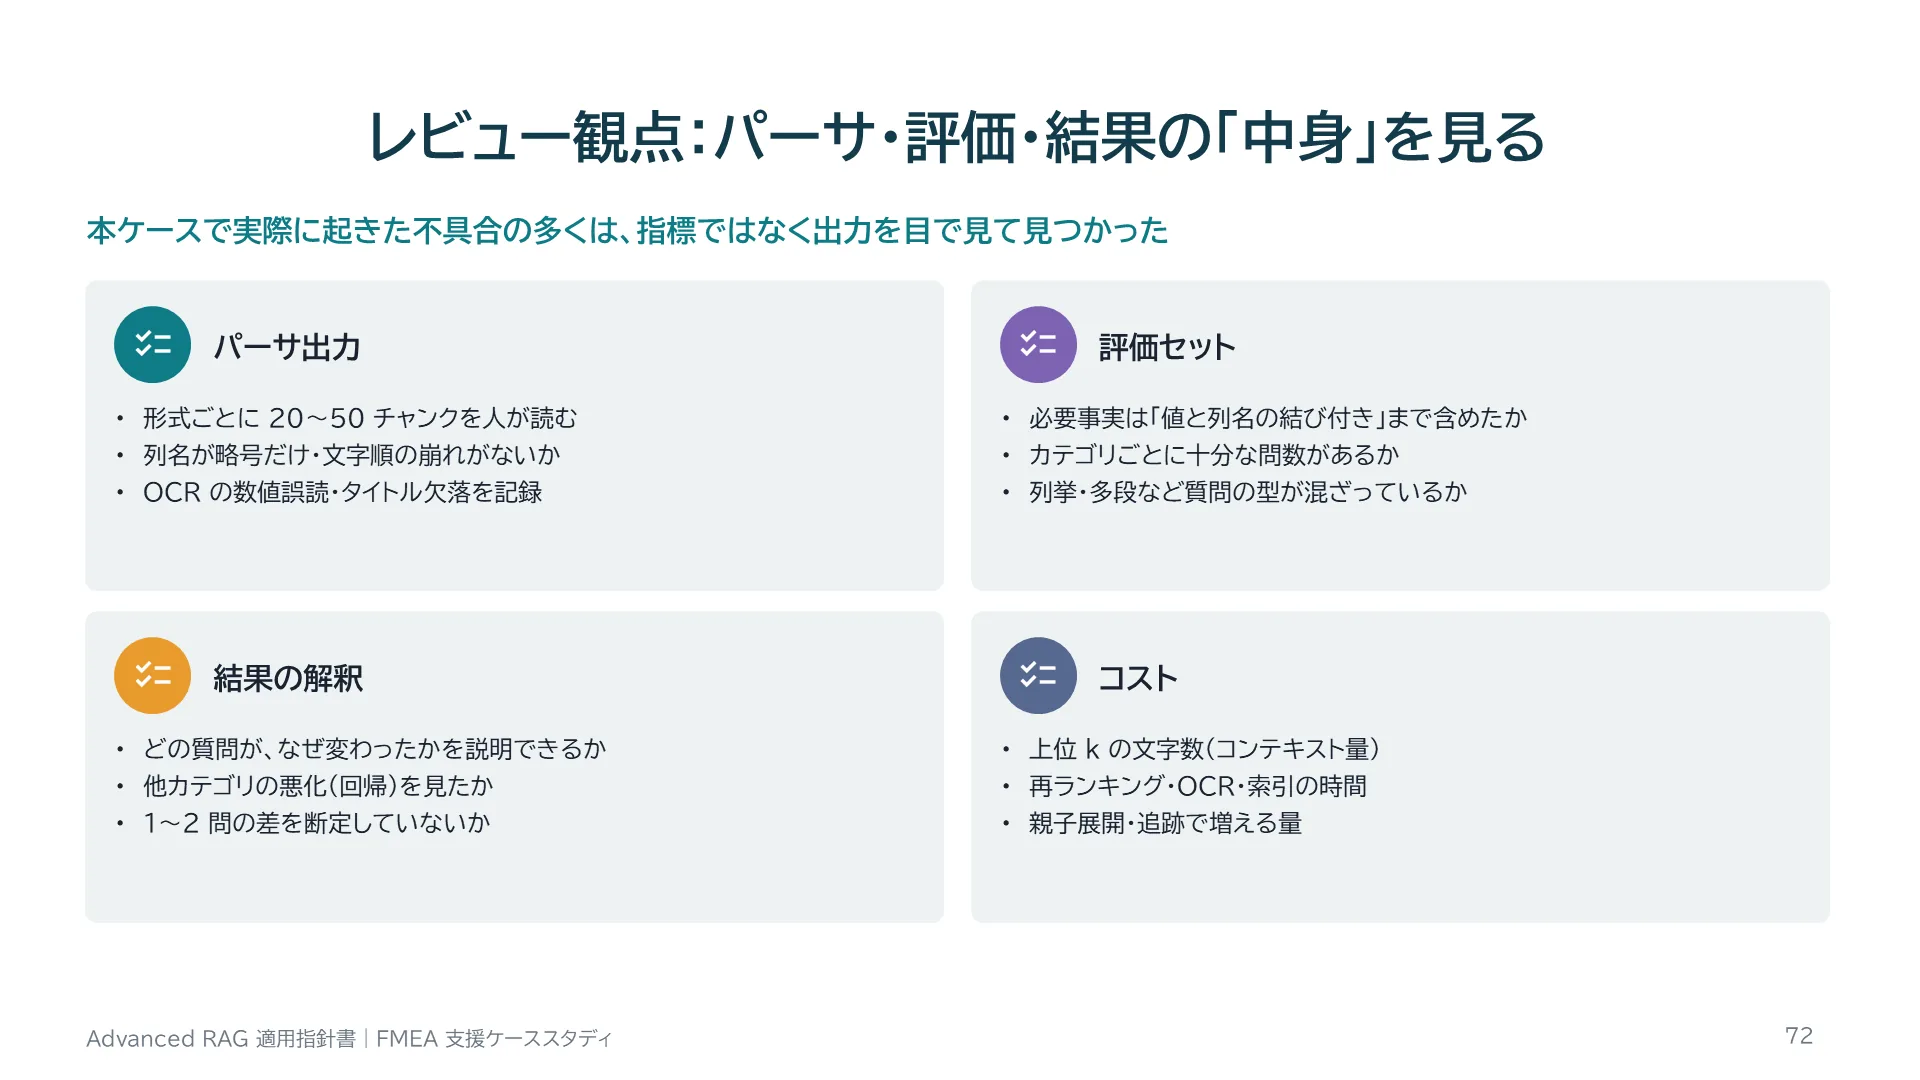
レビュー観点:パーサ・評価・結果の「中身」を見る
スライド 72 のテキストと解説
レビュー観点:パーサ・評価・結果の「中身」を見る 本ケースで実際に起きた不具合の多くは、指標ではなく出力を目で見て見つかった パーサ出力 形式ごとに 20〜50 チャンクを人が読む 列名が略号だけ・文字順の崩れがないか OCR の数値誤読・タイトル欠落を記録 評価セット 必要事実は「値と列名の結び付き」まで含めたか カテゴリごとに十分な問数があるか 列挙・多段など質問の型が混ざっているか 結果の解釈 どの質問が、なぜ変わったかを説明できるか 他カテゴリの悪化(回帰)を見たか 1〜2 問の差を断定していないか コスト 上位 k の文字数(コンテキスト量) 再ランキング・OCR・索引の時間 親子展開・追跡で増える量 72
解説

レビューのチェックリストです。本ケースで起きた不具合は、Excelのヘッダが略号だけになる、PDFの表の文字順が崩れる、OCRでタイトルが消える、親の切り詰めで表の後半が消える、ファイル名のヘッダが質問を取説に引き寄せる、の5つでした。どれも指標が動いている状態で起きていて、出力を目で見て初めて気付きました。レビューでは、数字の前に中身を見ることを習慣にしてください。
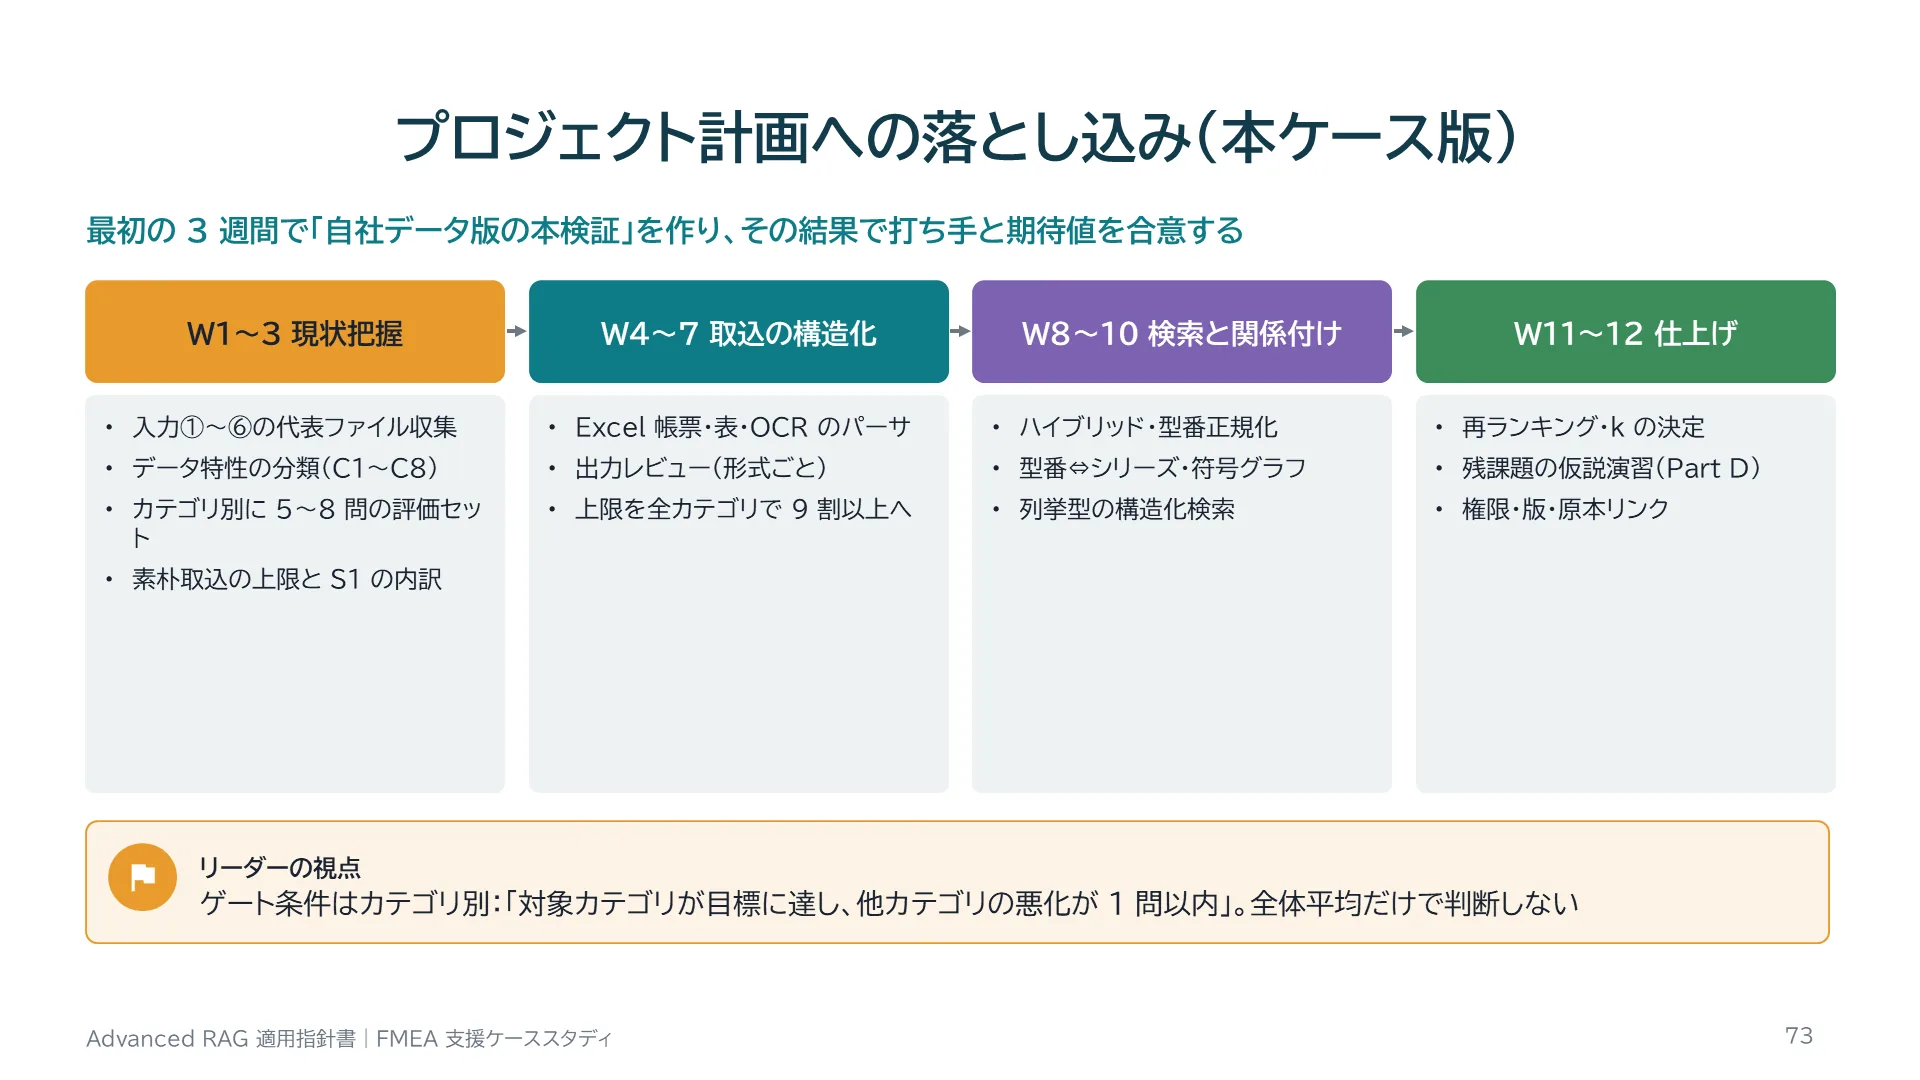
プロジェクト計画への落とし込み(本ケース版)
スライド 73 のテキストと解説
プロジェクト計画への落とし込み(本ケース版) 最初の 3 週間で「自社データ版の本検証」を作り、その結果で打ち手と期待値を合意する W1〜3 現状把握 入力①〜⑥の代表ファイル収集 データ特性の分類(C1〜C8) カテゴリ別に 5〜8 問の評価セット 素朴取込の上限と S1 の内訳 W4〜7 取込の構造化 Excel 帳票・表・OCR のパーサ 出力レビュー(形式ごと) 上限を全カテゴリで 9 割以上へ W8〜10 検索と関係付け ハイブリッド・型番正規化 型番⇔シリーズ・符号グラフ 列挙型の構造化検索 W11〜12 仕上げ 再ランキング・k の決定 残課題の仮説演習(Part D) 権限・版・原本リンク リーダーの視点 ゲート条件はカテゴリ別:「対象カテゴリが目標に達し、他カテゴリの悪化が 1 問以内」。全体平均だけで判断しない 73
解説

本ケースを実プロジェクトの計画に落とした例です。最初の3週間で、6つの入力それぞれから代表ファイルを集め、データ特性を分類し、カテゴリごとに5〜8問の評価セットを業務担当者と作ります。そして素朴な取込での上限と、S1の結果から失敗の内訳を出します。次の段階で、上限を上げる取込の構造化を形式ごとに進め、その後、検索と関係付け、再ランキングと進めます。各段階のゲート条件は、カテゴリ別の目標と、他カテゴリの悪化がないことです。
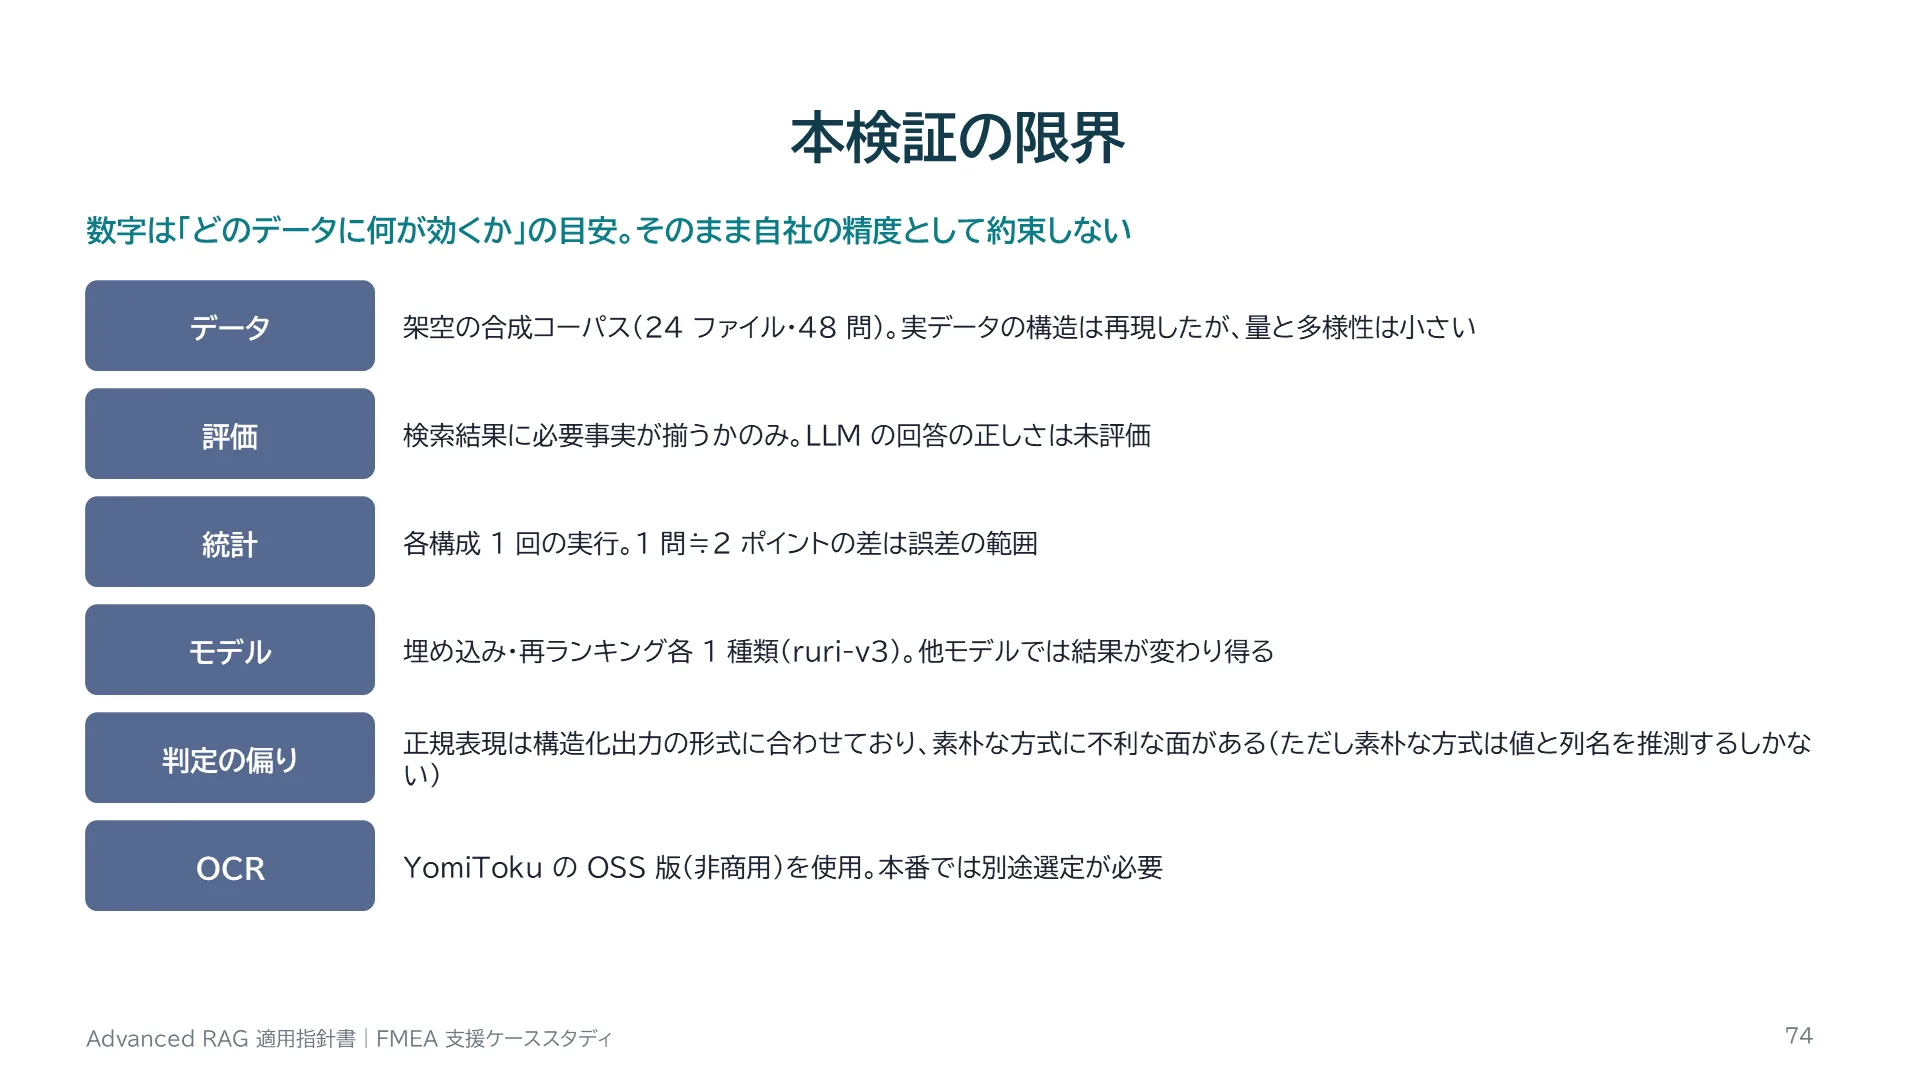
本検証の限界
スライド 74 のテキストと解説
本検証の限界 数字は「どのデータに何が効くか」の目安。そのまま自社の精度として約束しない データ 架空の合成コーパス(24 ファイル・48 問)。実データの構造は再現したが、量と多様性は小さい 評価 検索結果に必要事実が揃うかのみ。LLM の回答の正しさは未評価 統計 各構成 1 回の実行。1 問≒2 ポイントの差は誤差の範囲 モデル 埋め込み・再ランキング各 1 種類(ruri-v3)。他モデルでは結果が変わり得る 判定の偏り 正規表現は構造化出力の形式に合わせており、素朴な方式に不利な面がある(ただし素朴な方式は値と列名を推測するしかない) OCR YomiToku の OSS 版(非商用)を使用。本番では別途選定が必要 74
解説

本検証の限界です。データは実在企業の文書構造を再現した架空のもので、規模は24ファイル・48問と小さく、1問の差は誤差の範囲です。評価は検索結果に必要事実が揃うかであり、LLMの回答の正しさは測っていません。モデルは日本語の埋め込みと再ランキングを1種類ずつ使っただけで、他のモデルでは結果が変わり得ます。各構成は1回ずつ実行しており、乱数による揺らぎは評価していません。また、正解の判定に使う正規表現は、構造化した出力の形式(「発生度(O): 4」)に合わせて書いているので、素朴な方式には不利な面があります。ただし、素朴な方式ではLLMが値と列名を推測するしかないという点は、実務上も同じ問題です。
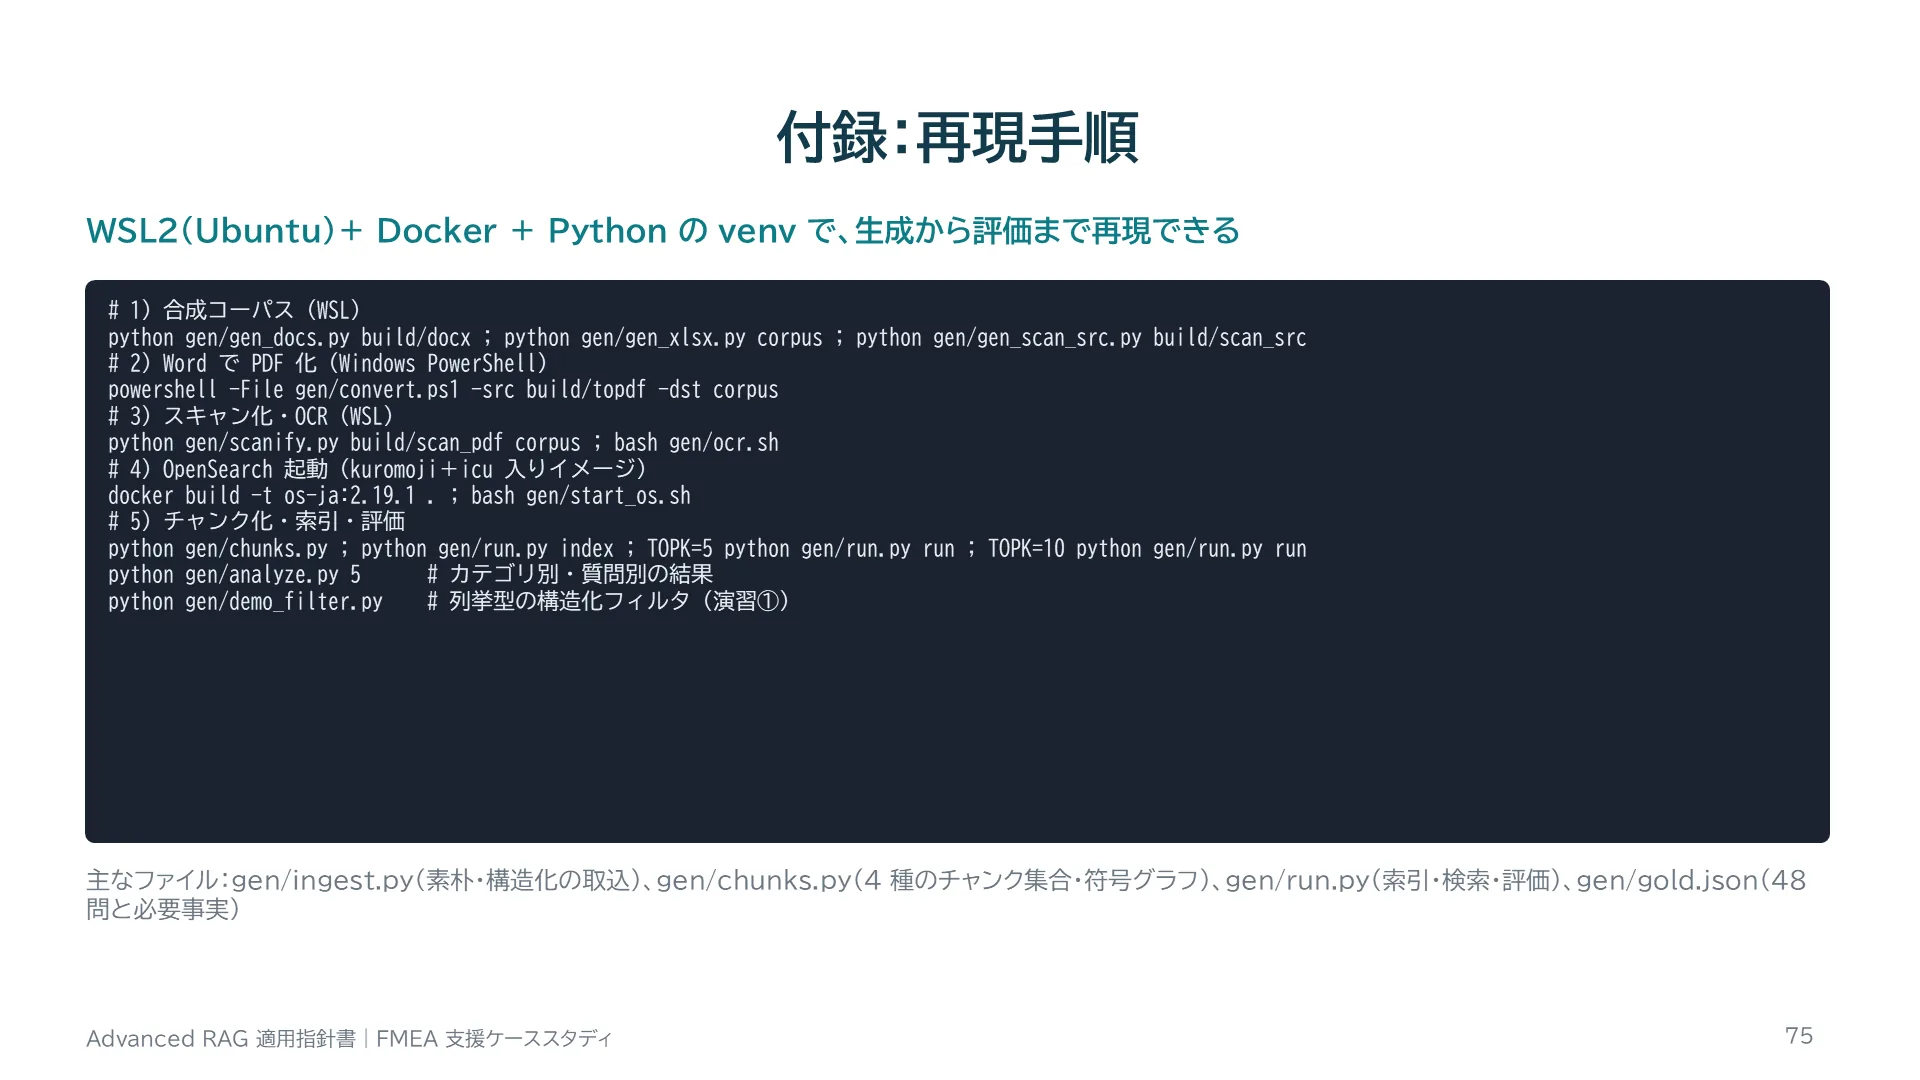
付録:再現手順
スライド 75 のテキストと解説
付録:再現手順 WSL2(Ubuntu)+ Docker + Python の venv で、生成から評価まで再現できる # 1) 合成コーパス(WSL) python gen/gen_docs.py build/docx ; python gen/gen_xlsx.py corpus ; python gen/gen_scan_src.py build/scan_src # 2) Word で PDF 化(Windows PowerShell) powershell -File gen/convert.ps1 -src build/topdf -dst corpus # 3) スキャン化・OCR(WSL) python gen/scanify.py build/scan_pdf corpus ; bash gen/ocr.sh # 4) OpenSearch 起動(kuromoji+icu 入りイメージ) docker build -t os-ja:2.19.1 . ; bash gen/start_os.sh # 5) チャンク化・索引・評価 python gen/chunks.py ; python gen/run.py index ; TOPK=5 python gen/run.py run ; TOPK=10 python gen/run.py run python gen/analyze.py 5 # カテゴリ別・質問別の結果 python gen/demo_filter.py # 列挙型の構造化フィルタ(演習①) 主なファイル:gen/ingest.py(素朴・構造化の取込)、gen/chunks.py(4 種のチャンク集合・符号グラフ)、gen/run.py(索引・検索・評価)、gen/gold.json(48 問と必要事実) 75
解説

再現手順です。生成スクリプトはgenフォルダにあります。コーパスの生成、Wordによる PDF 化、スキャン化、OCR、チャンク化、索引、評価の順に実行します。Word・ExcelのCOMを使う部分はWindows側のPowerShellで実行します。
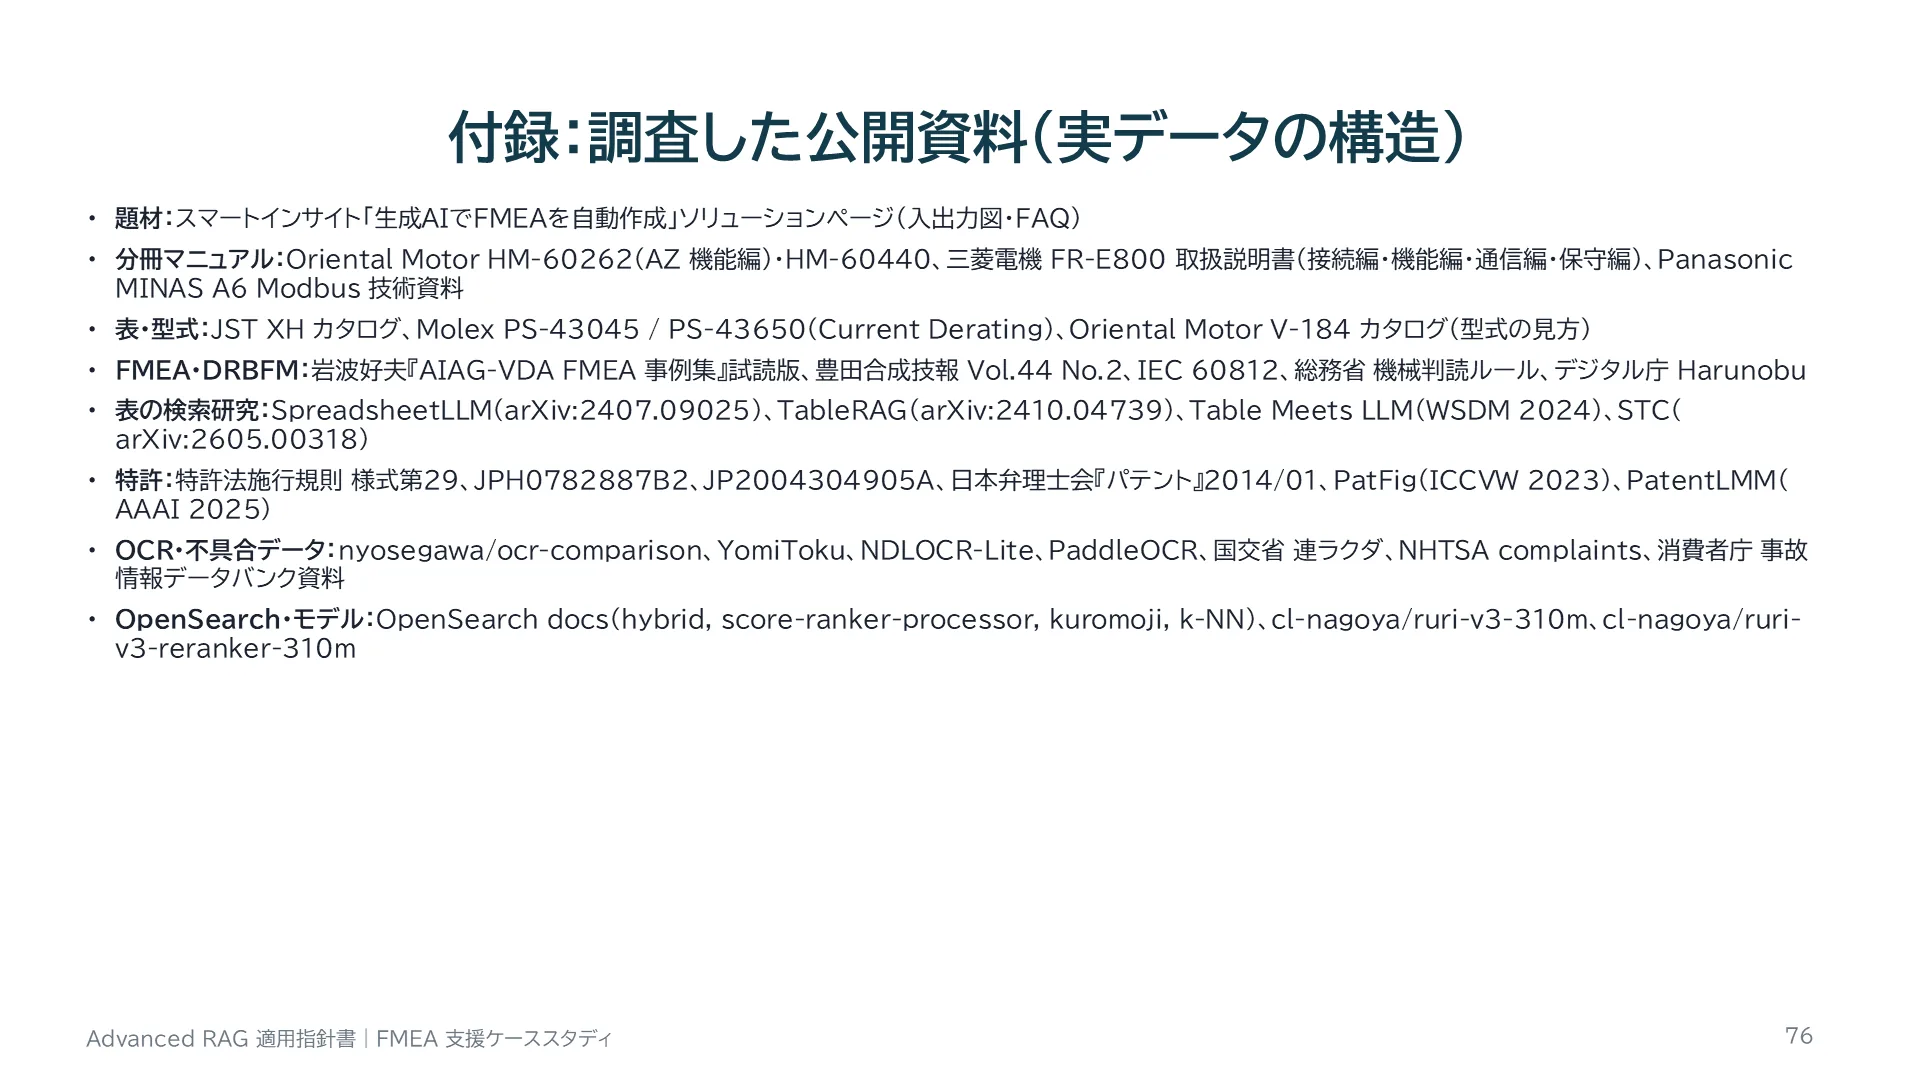
付録:調査した公開資料(実データの構造)
スライド 76 のテキストと解説
付録:調査した公開資料(実データの構造) 題材:スマートインサイト「生成AIでFMEAを自動作成」ソリューションページ(入出力図・FAQ) 分冊マニュアル:Oriental Motor HM-60262(AZ 機能編)・HM-60440、三菱電機 FR-E800 取扱説明書(接続編・機能編・通信編・保守編)、Panasonic MINAS A6 Modbus 技術資料 表・型式:JST XH カタログ、Molex PS-43045 / PS-43650(Current Derating)、Oriental Motor V-184 カタログ(型式の見方) FMEA・DRBFM:岩波好夫『AIAG-VDA FMEA 事例集』試読版、豊田合成技報 Vol.44 No.2、IEC 60812、総務省 機械判読ルール、デジタル庁 Harunobu 表の検索研究:SpreadsheetLLM(arXiv:2407.09025)、TableRAG(arXiv:2410.04739)、Table Meets LLM(WSDM 2024)、STC(arXiv:2605.00318) 特許:特許法施行規則 様式第29、JPH0782887B2、JP2004304905A、日本弁理士会『パテント』2014/01、PatFig(ICCVW 2023)、PatentLMM(AAAI 2025) OCR・不具合データ:nyosegawa/ocr-comparison、YomiToku、NDLOCR-Lite、PaddleOCR、国交省 連ラクダ、NHTSA complaints、消費者庁 事故情報データバンク資料 OpenSearch・モデル:OpenSearch docs(hybrid, score-ranker-processor, kuromoji, k-NN)、cl-nagoya/ruri-v3-310m、cl-nagoya/ruri-v3-reranker-310m 76
解説

実データの構造調査で参照した主な公開資料です。いずれも構造の参考にしたもので、内容は複製していません。