スライド 1 のテキストと解説
本資料は「AgentOpsとAgent Reliability技術レポート」(調査基準日2026年11月14日)をもとに、RAGやAIエージェントを作り始めた技術者が、エージェント導入プロジェクトをリードできる水準まで理解を引き上げることを目的に再構成したものです。対になる資料「Advanced RAG 実践ガイド」が、エージェントに渡す証拠(入力)の質を扱ったのに対し、本資料は、その証拠を受け取ったエージェントが正しく、安全に、一貫して行動するための評価・制御・回復・運用を扱います。元レポートにない基礎解説、事例、リーダー実務は「補足」と明示しています。
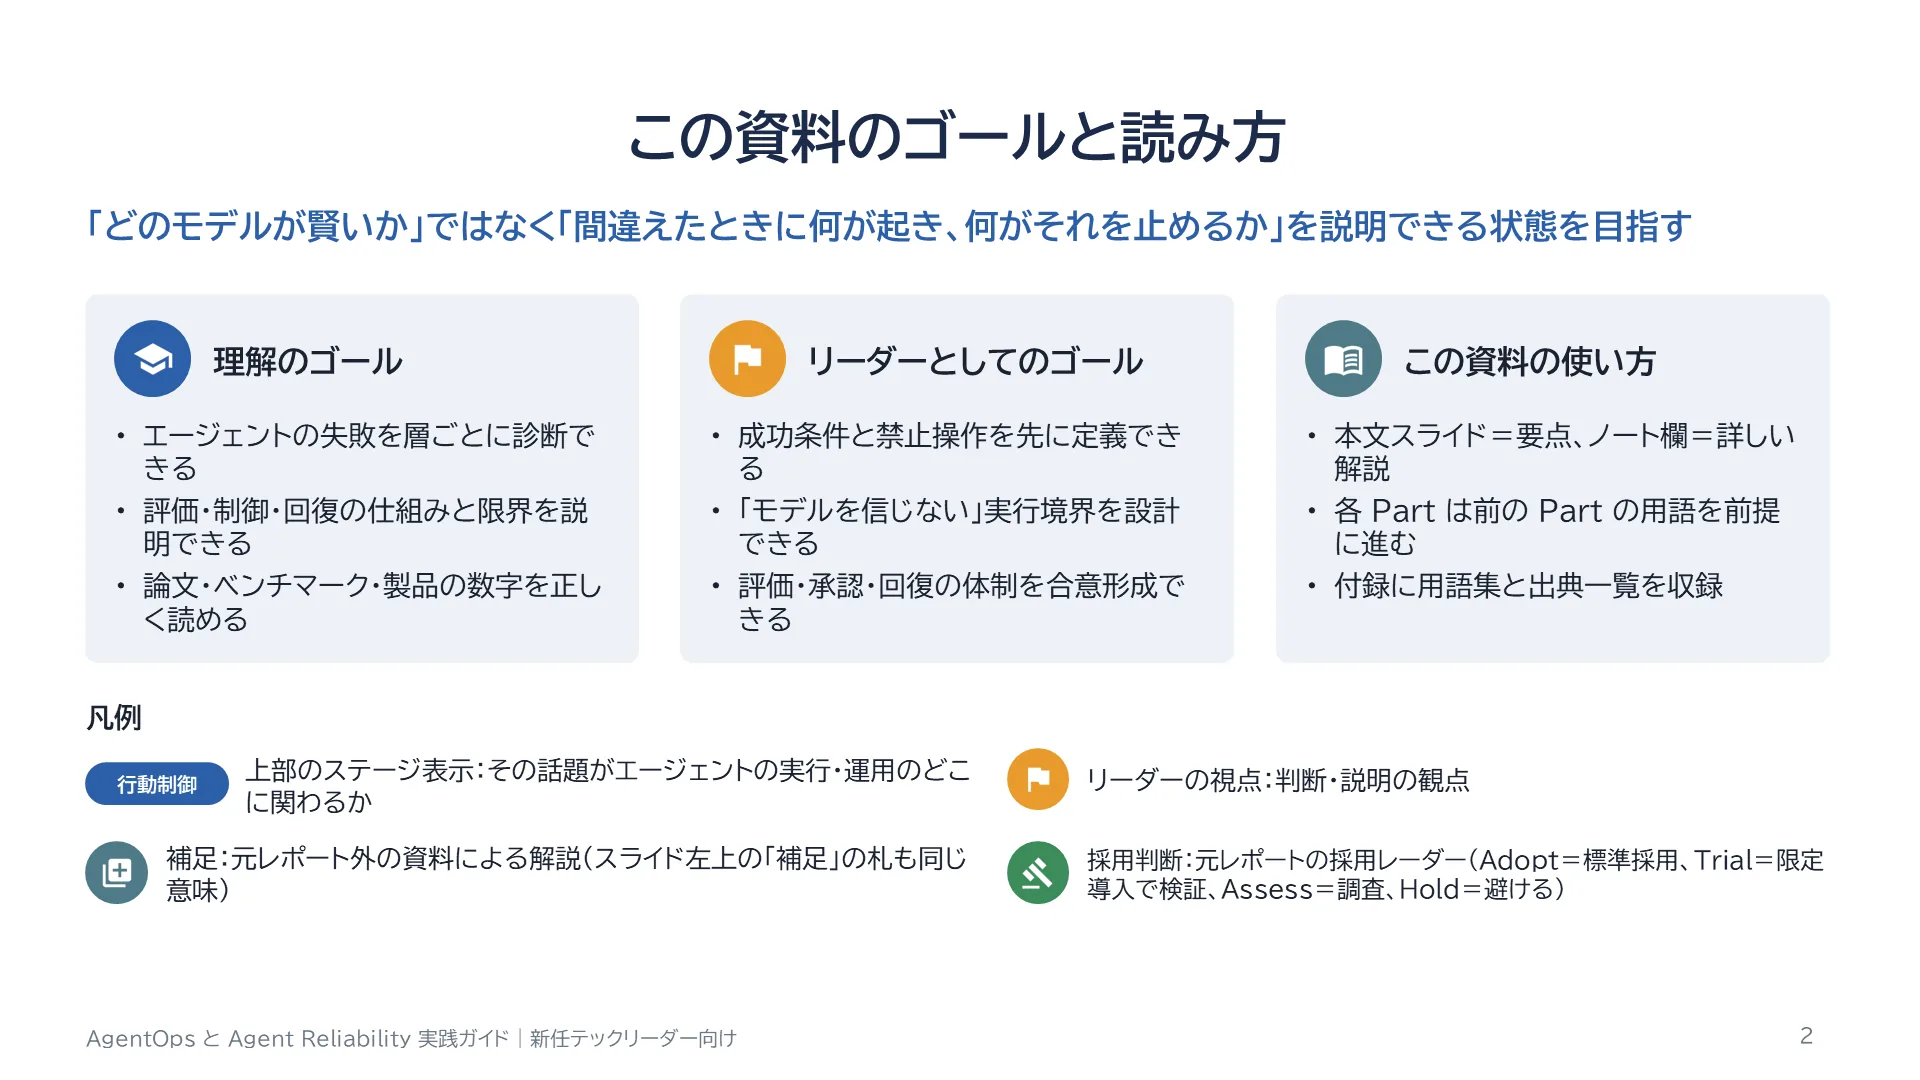
スライド 2 のテキストと解説
ゴールは用語を覚えることではなく、エージェントのプロジェクトで技術判断を自分の言葉で説明できることです。各スライド上部の 6 つのステージ表示は、その話題がエージェントの実行と運用のどこに関係するかを示します。計画はタスクの分解と手順、出力は応答や構造化データ、行動制御はツール実行の前の検査と認可、回復は再試行・再開・承認、評価は採点と回帰、観測・運用はトレースと本番運用です。黄色の「リーダーの視点」は、技術リーダーとして判断・説明するときの観点です。
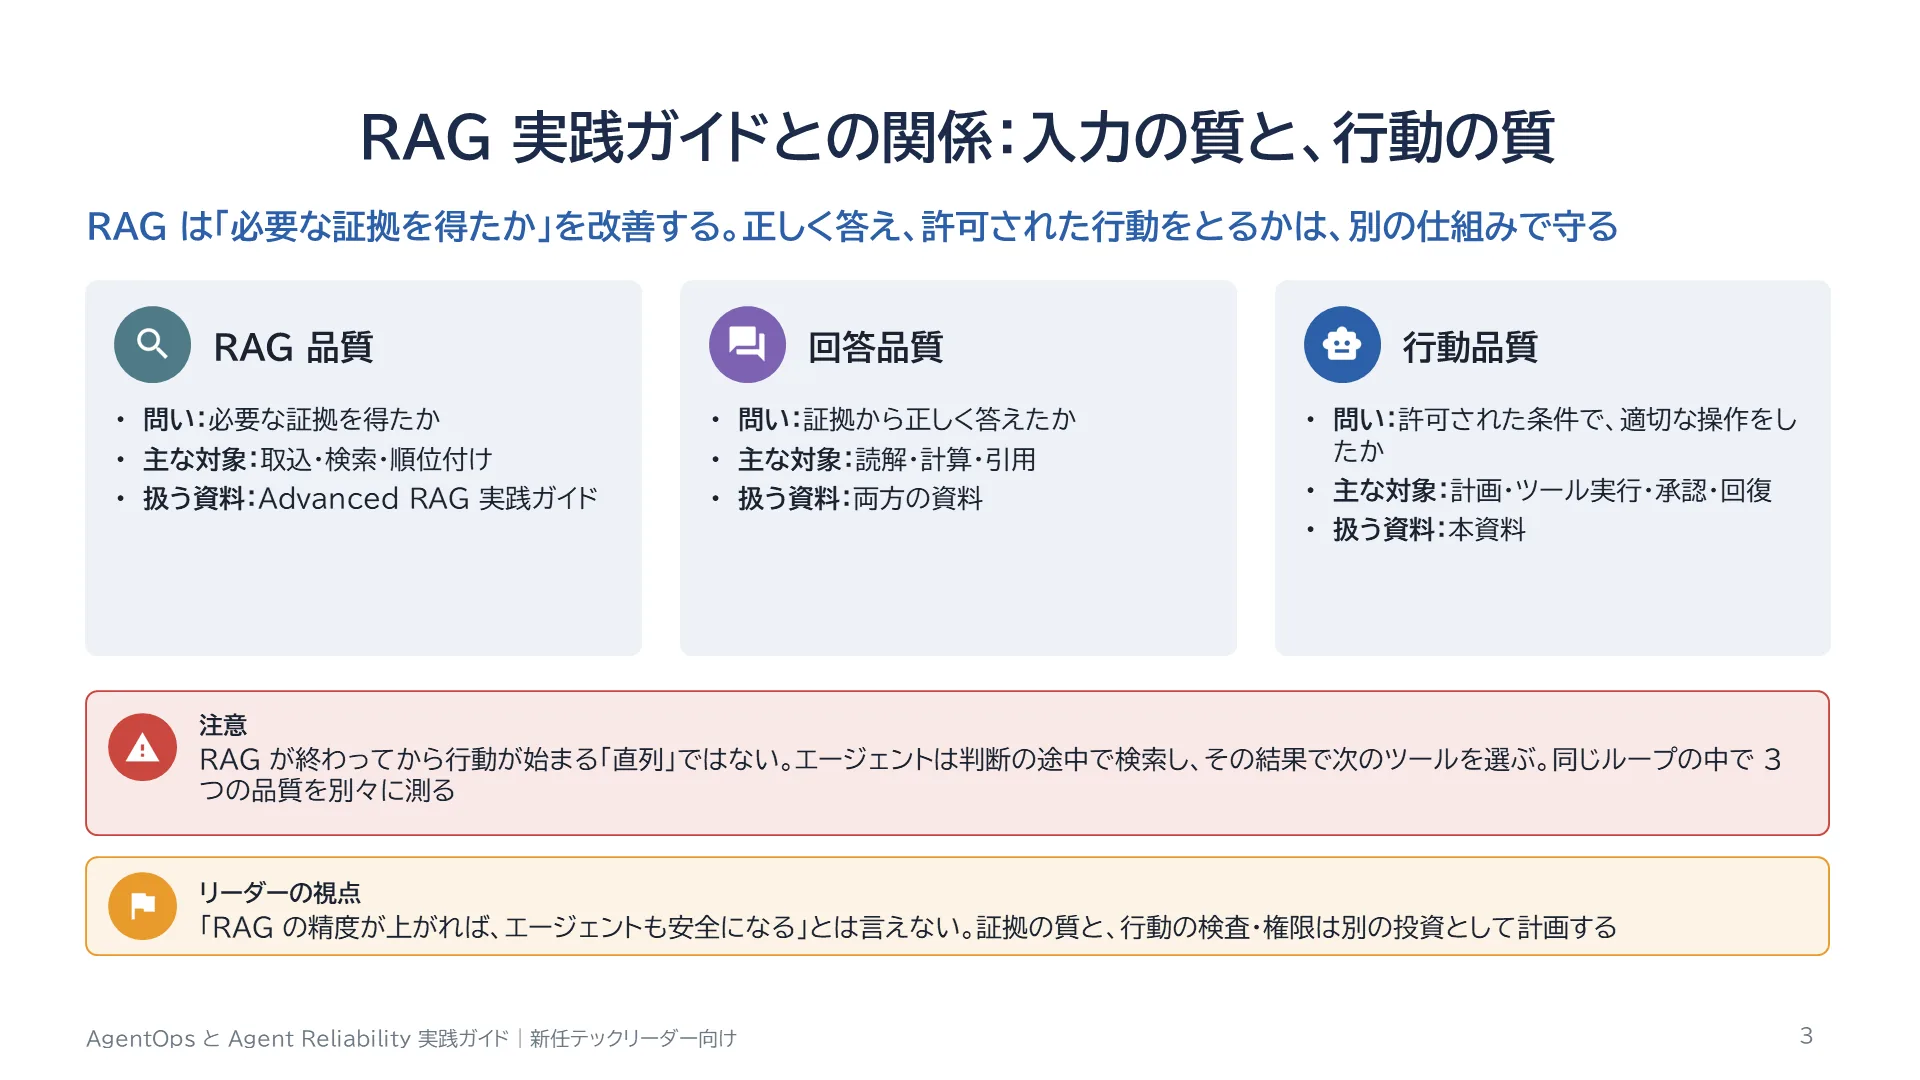
スライド 3 のテキストと解説
対になる資料「Advanced RAG 実践ガイド」は、エージェントや LLM に渡す証拠の質を扱いました。良い証拠は回答品質に大きく寄与しますが、それだけで正しい回答や安全な行動は保証されません。元レポートは品質を 3 つに分けます。RAG 品質は必要な証拠を得られたか、回答品質は証拠から正しく答えたか、行動品質は適切な操作を許可された条件で行ったかです。ただし実際のエージェントは、判断の途中で検索し、その結果で次のツールを選ぶので、「RAG が終わってから AgentOps が始まる」という直列の境界ではありません。同じ実行ループの中に、知識の取得と行動の制御が共存します。
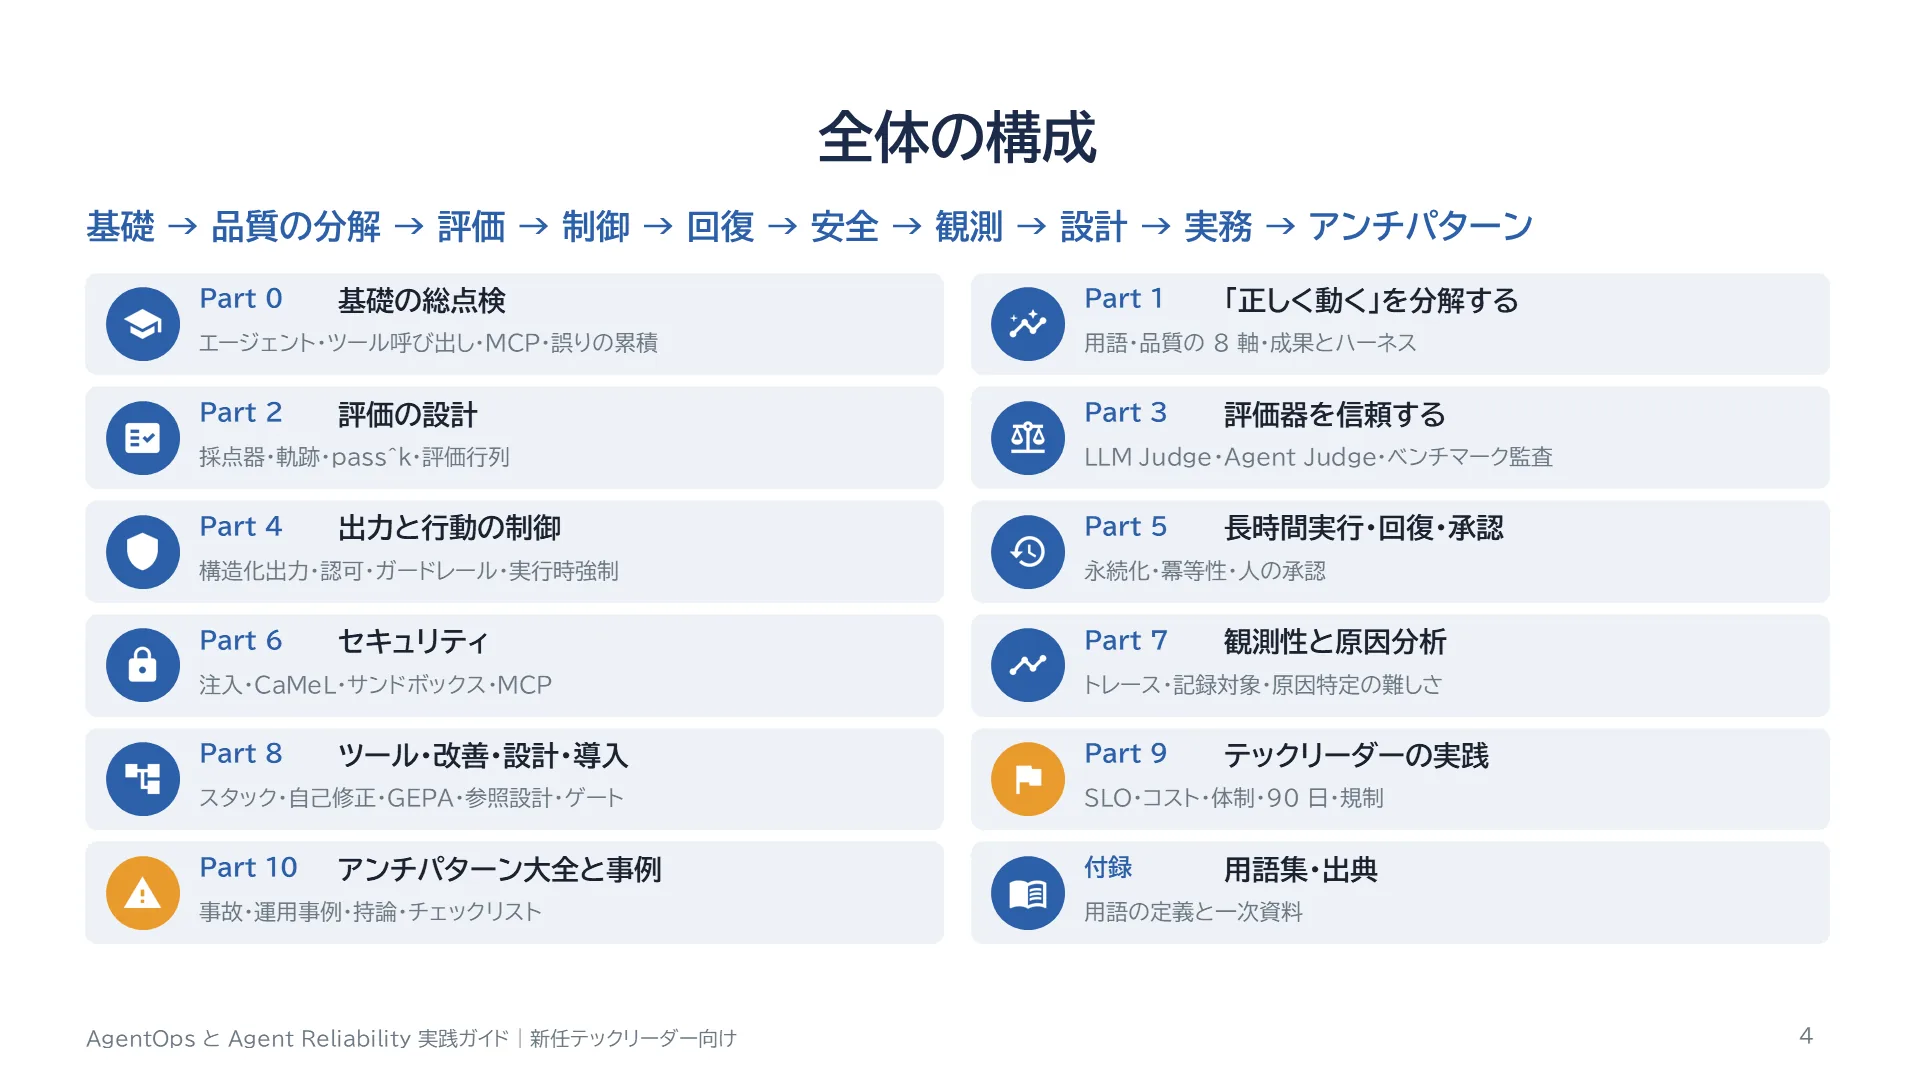
スライド 4 のテキストと解説
前半で共通言語(用語、品質の分解、評価の指標)を固め、中盤でエージェントの出力と行動を制御する仕組み、長時間実行と回復、セキュリティ、観測性を扱います。後半は、ツールの選び方、継続改善、参照アーキテクチャと導入ロードマップ、テックリーダーの実務です。最後の Part で、公開された事故と、信頼性を上げた運用の事例から、アンチパターンと設計の型をまとめます。
スライド 5 のテキストと解説
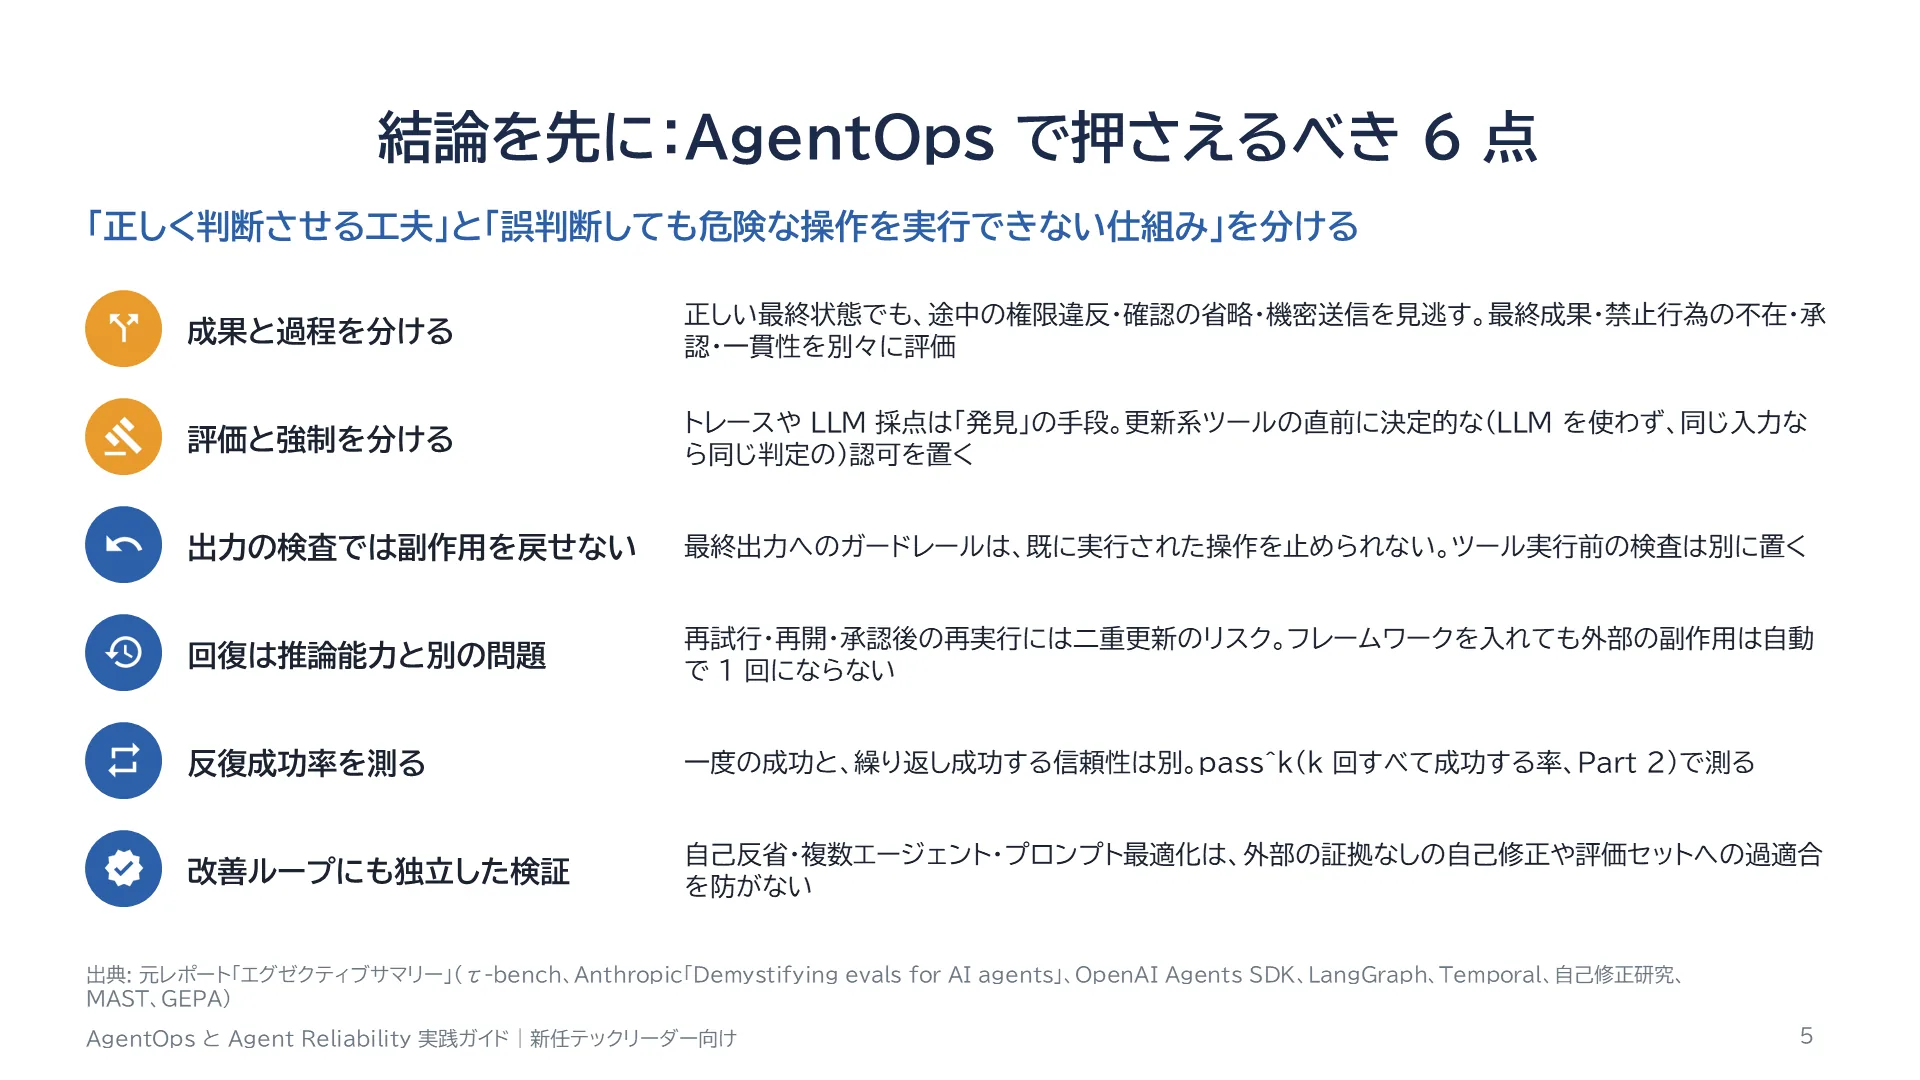
元レポートの結論です。1 つ目、成果と過程を分ける。正しい回答や最終状態だけでは、途中の権限違反や確認の省略を見逃す。2 つ目、評価と強制を分ける。トレースや LLM による採点は問題を見つける手段で、危険な操作を止めない。更新系ツールの直前に決定的な認可を置く。3 つ目、出力の検査では副作用は戻せない。最終出力へのガードレールと、ツール実行前の検査は配置が違う。4 つ目、回復は推論能力とは別の問題。再試行や再開には二重更新のリスクがあり、フレームワークを入れても外部の副作用が一度だけになるわけではない。5 つ目、たまたま一度成功する能力と、繰り返し成功する信頼性は別。6 つ目、改善のループにも独立した検証を置く。自己反省や複数エージェントだけでは、外部の証拠なしの自己修正を防げない。
スライド 6 のテキストと解説
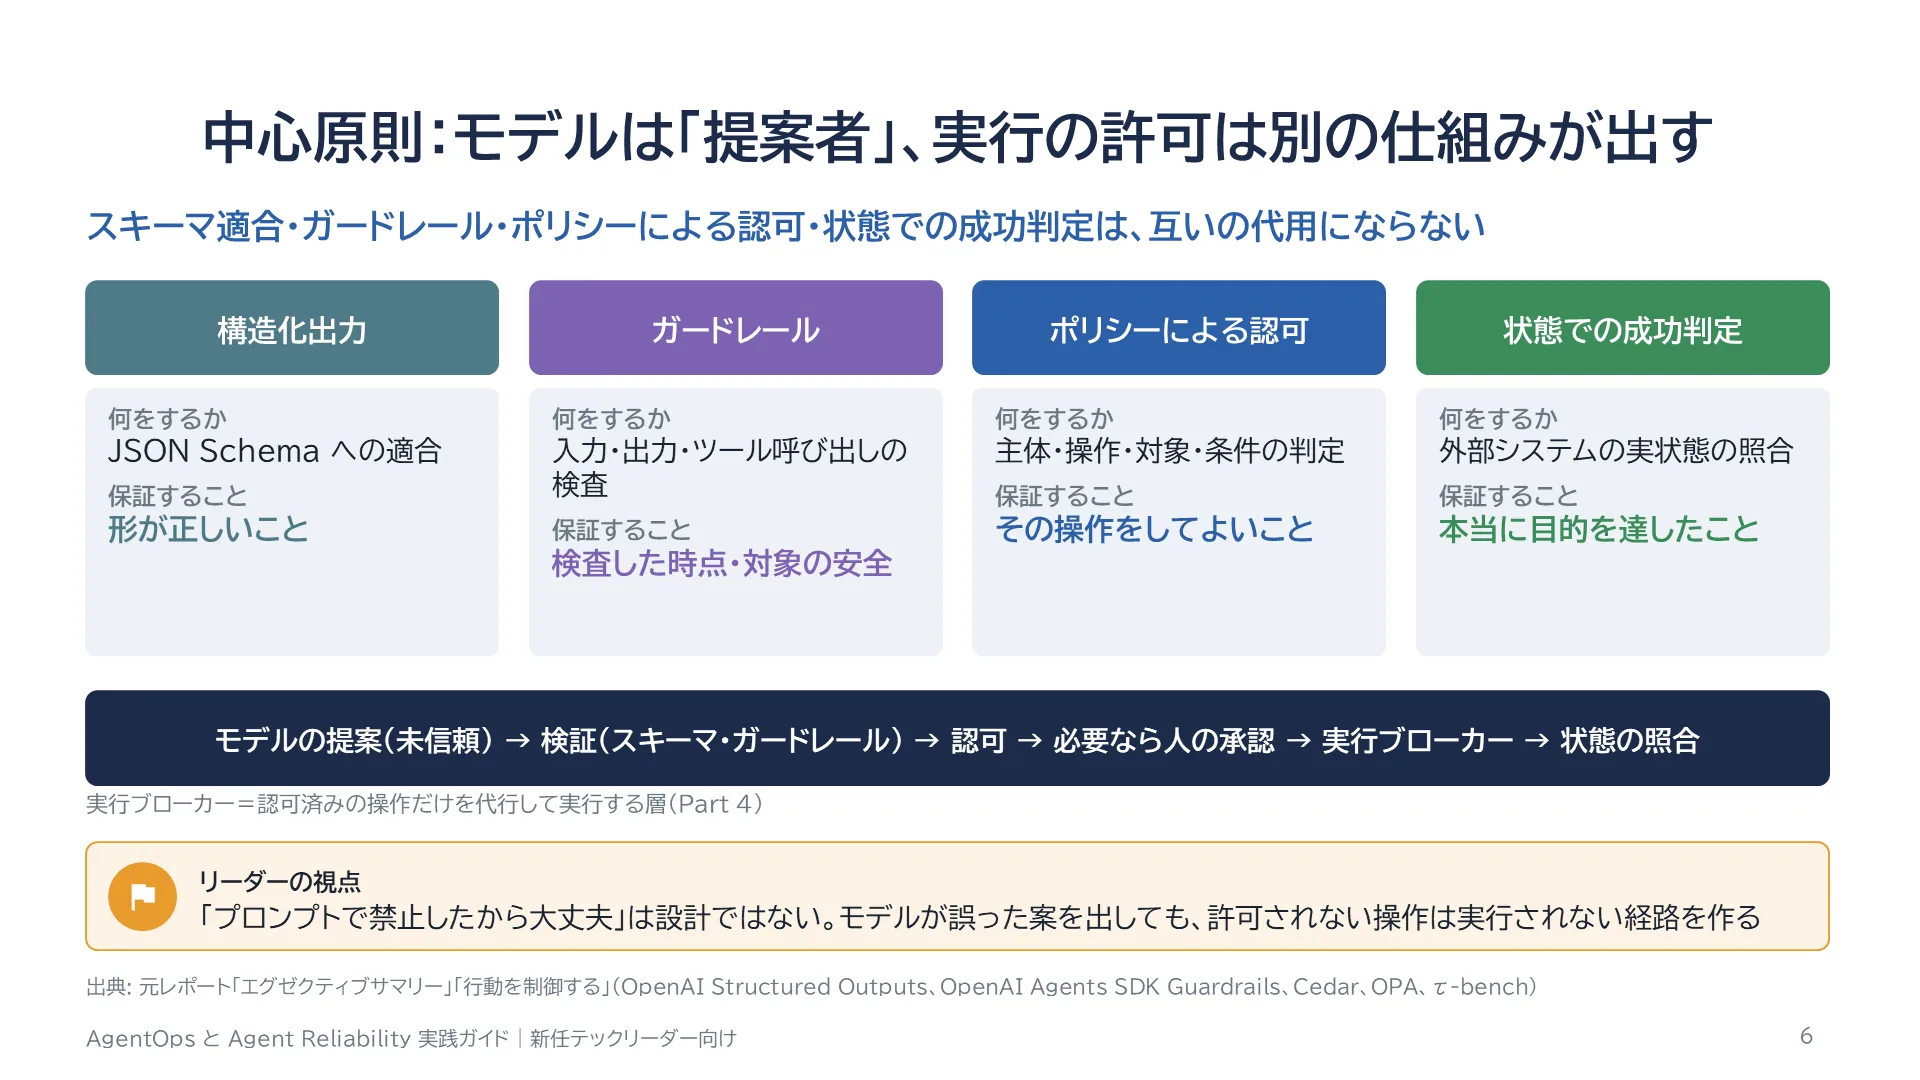
本資料全体を貫く原則です。モデルは操作の案を出す提案者であり、その案を実行してよいかを決めるのは、モデルの外にある決定的な仕組みです。JSON Schema に適合していることは、形が正しいことしか意味しません。ガードレールは、ある時点のある入力・出力を検査します。ポリシーによる認可は、認証済みの主体が、その対象に、その操作をしてよいかを決めます。環境の状態による成功判定は、外部のシステムが意図どおりの状態になったかを確かめます。この 4 つは性質が違う制約で、どれか 1 つで他を置き換えることはできません。
スライド 7 のテキストと解説
Part 0 では、以降の Part を読むための前提知識を補足します。元レポートは上級者向けなので、ここは主に公式ガイドと仕様に基づく補足です。
スライド 8 のテキストと解説
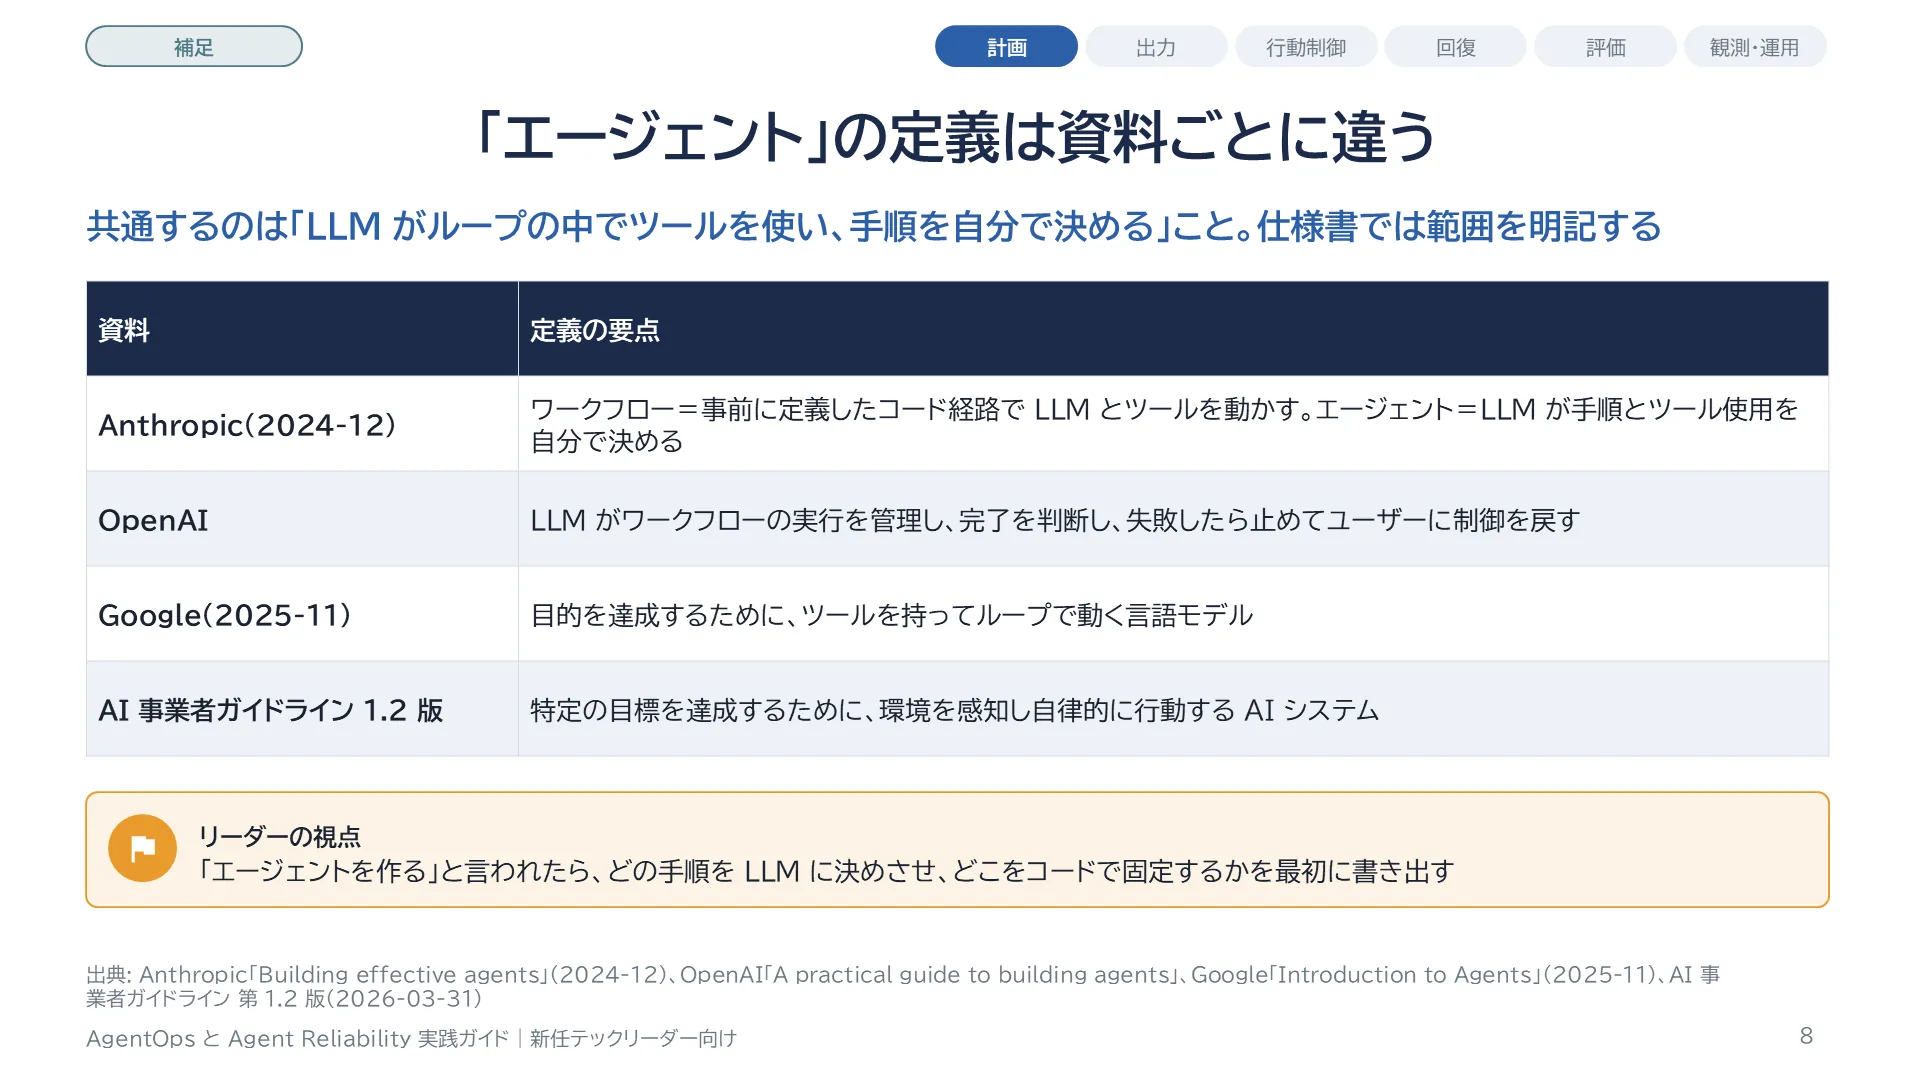
エージェントの定義は資料ごとに少しずつ違います。Anthropic は全体を agentic systems と呼び、事前に決めたコードの経路で LLM とツールを動かすワークフローと、LLM が自分で手順とツールの使い方を決めるエージェントに分けます。OpenAI は、LLM がワークフローの実行を管理し、完了を判断し、失敗したら止めてユーザーに制御を戻すもの、としています。Google は「目的を達成するために、ツールを持ってループで動く言語モデル」と短く定義します。日本の AI 事業者ガイドライン第 1.2 版は、特定の目標を達成するために、環境を感知し自律的に行動する AI システム、と定義しています。共通点は、LLM がループの中でツールを使い、次の手順を自分で決めることです。プロジェクトでは、どこまでを LLM に決めさせ、どこからをコードで決めるかを明記します。
スライド 9 のテキストと解説
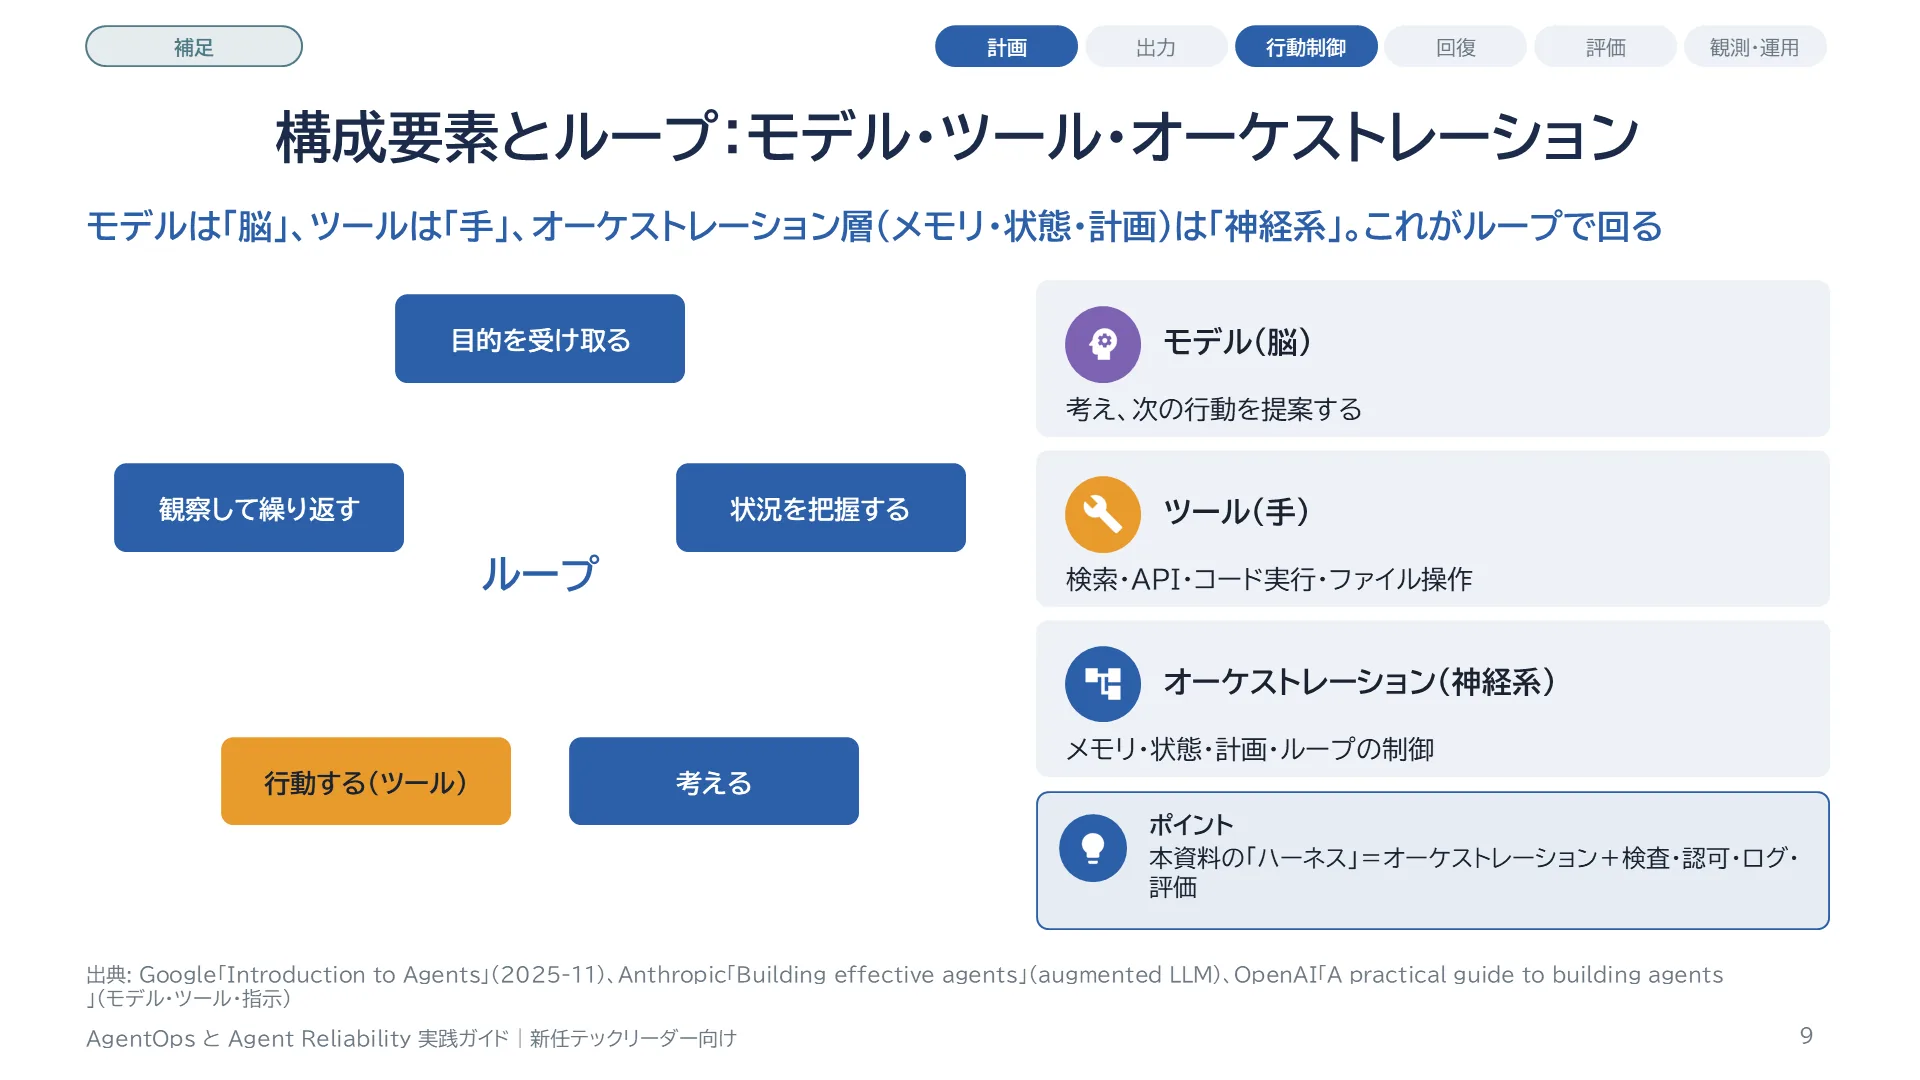
Google の整理では、エージェントはモデル(脳)、ツール(手)、オーケストレーション層(神経系)でできています。オーケストレーション層は、メモリ、状態、計画を持ち、ループを回します。ループは 5 つのステップで、目的を受け取り、状況を把握し、考え、行動し、結果を観察して繰り返します。Anthropic は、検索・ツール・メモリを足した LLM を augmented LLM と呼んで基本の部品にし、OpenAI はモデル・ツール・指示の 3 つを中核に挙げます。本資料でいう「ハーネス」は、このオーケストレーション層に、検査・認可・ログ・評価を加えたものだと考えると分かりやすいでしょう。
スライド 10 のテキストと解説
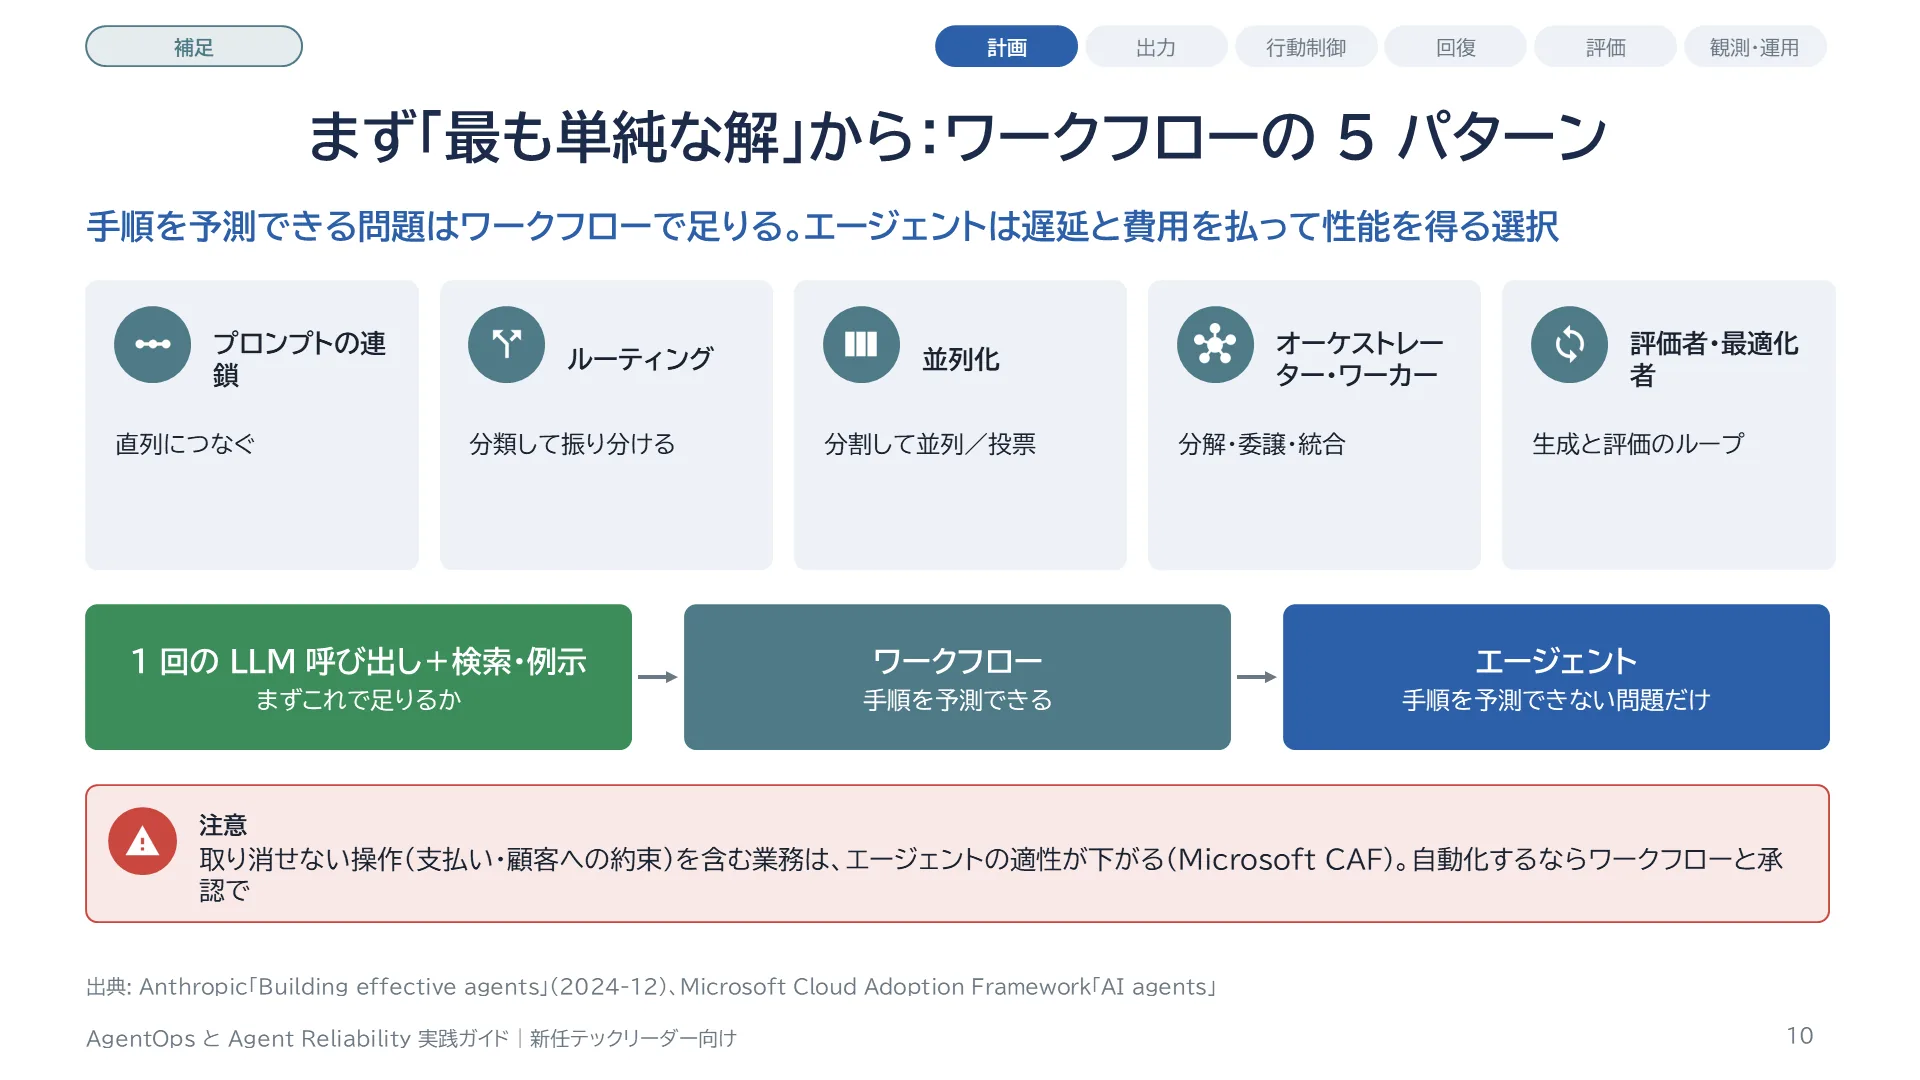
Anthropic は、最も単純な解を探し、必要なときだけ複雑さを増やすよう勧めています。エージェント的なシステムは、遅延と費用を払って性能を得るもので、誤りが累積するリスクもあります。手順の数を予測できる問題は、ワークフローで足ります。代表的な 5 つのパターンがあります。プロンプトの連鎖は、処理を直列につなぎます。ルーティングは、入力を分類して振り分けます。並列化は、分割して並列に処理するか、同じ処理を複数回走らせて投票します。オーケストレーターとワーカーは、中央の LLM が分解して委譲し、統合します。評価者と最適化者は、生成役と評価役がループします。Microsoft のクラウド導入フレームワークも、決まった手順で予測できる処理は、従来のワークフロー自動化の方が安く安全だとし、誤った行動を取り消せない業務(支払いや顧客への約束)はエージェントの適性が下がるとしています。
スライド 11 のテキストと解説
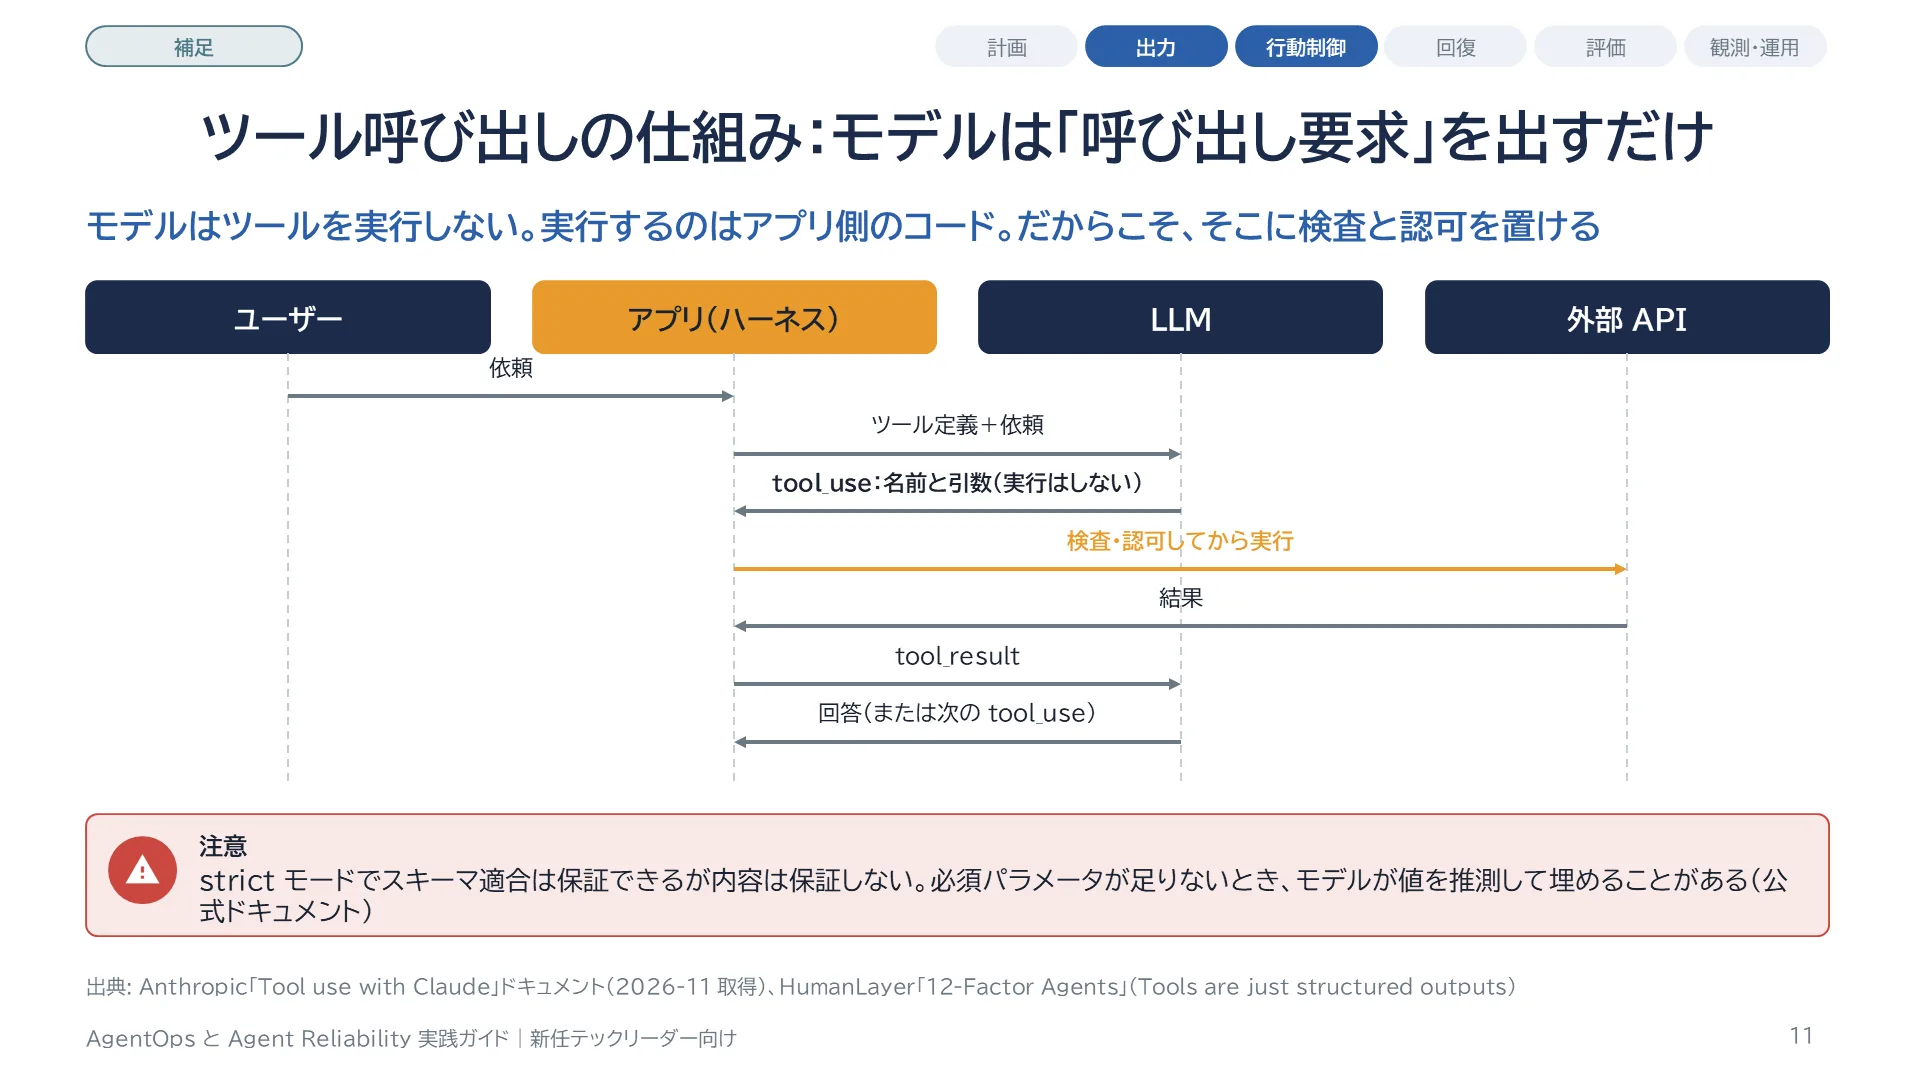
ツール呼び出しの流れです。アプリはツールを、名前、説明、入力の JSON Schema で定義してモデルに渡します。モデルはツールを使うと判断すると、ツール名と引数を構造化して返します。Claude の場合は stop_reason が tool_use になり、tool_use のブロックが返ります。ここが重要で、モデルは自分ではツールを実行しません。アプリ側のコードがツールを実行し、結果を tool_result として返し、モデルがそれを読んで次を決めます。12-Factor Agents の言い方では「ツールは単なる構造化出力」です。だからこそ、モデルとツールの間、つまりアプリ側のコードに、検査、認可、承認を置けます。strict モードでスキーマへの適合は保証できますが、内容の正しさは保証されません。また、必須パラメータが足りないとき、モデルが値を推測して埋めることがあると、公式ドキュメント自身が書いています。
スライド 12 のテキストと解説
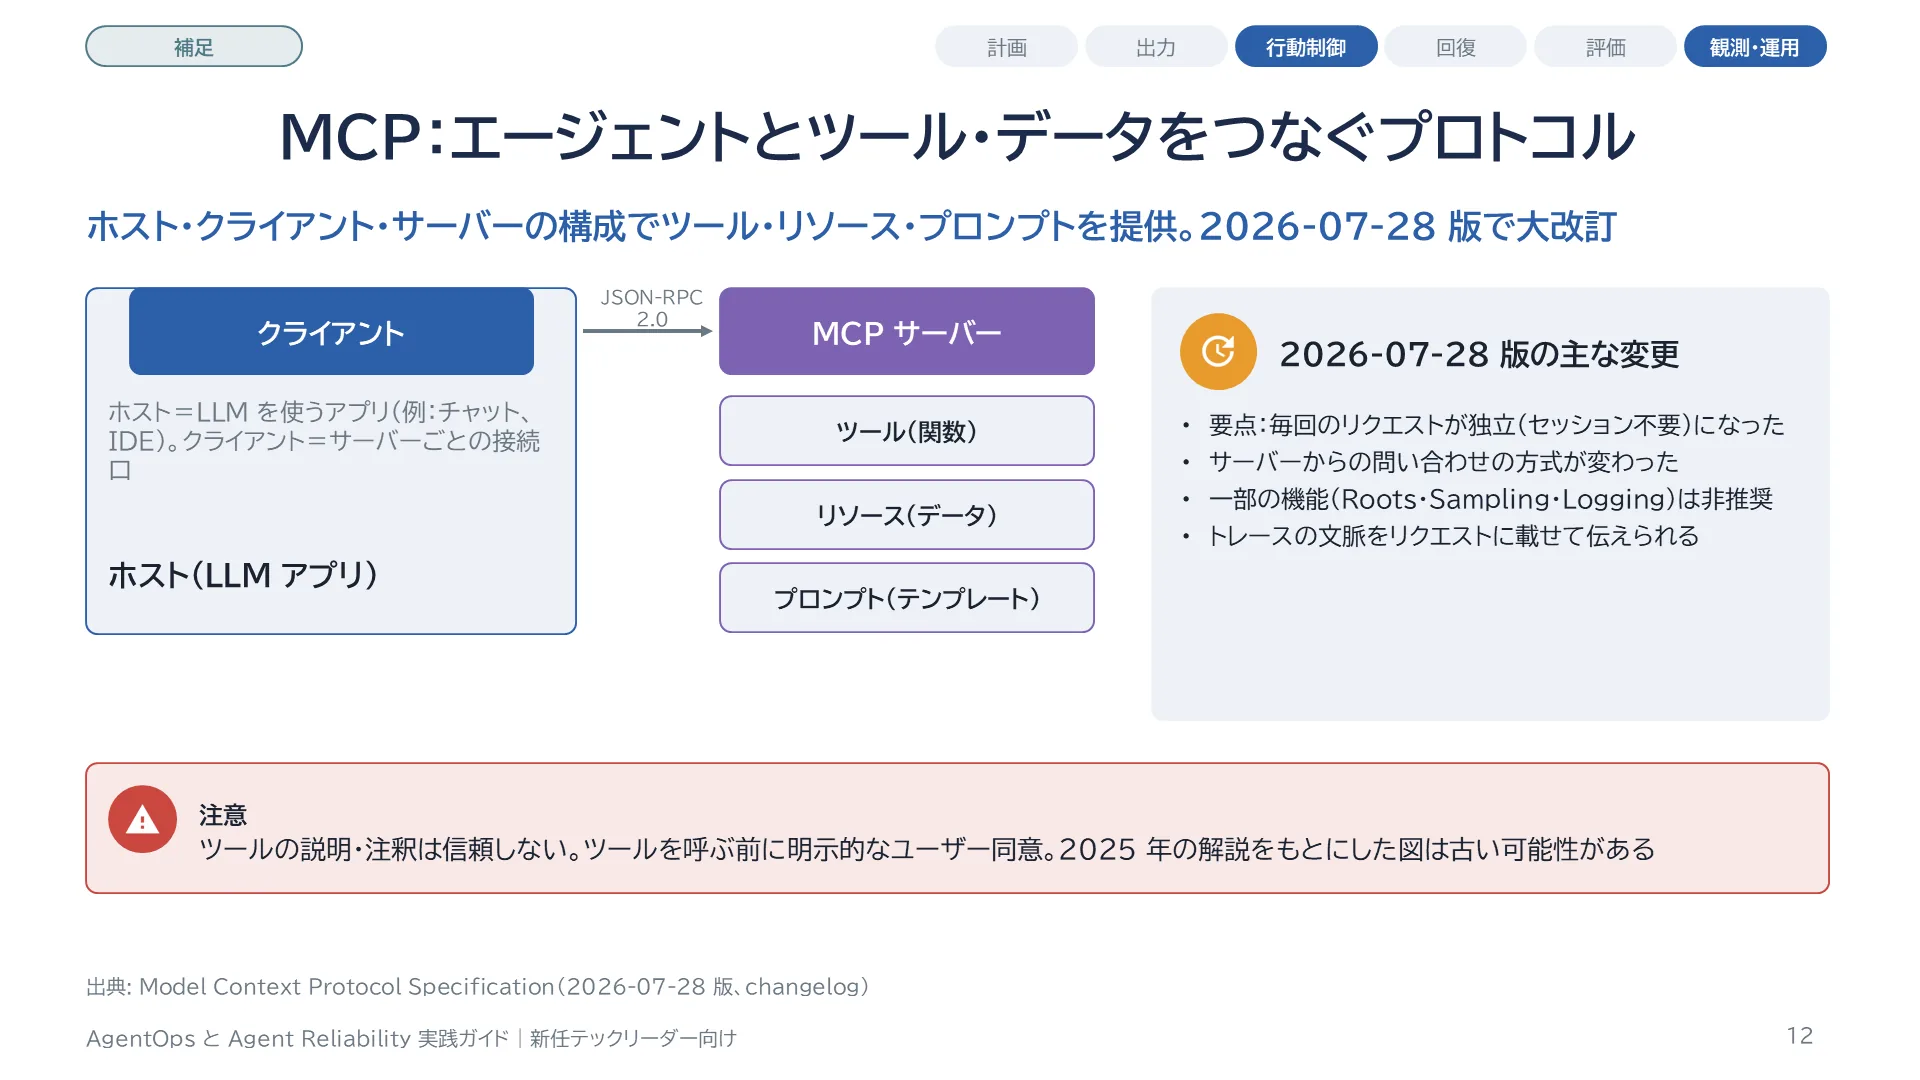
MCP(Model Context Protocol)は、エージェントとツールやデータをつなぐプロトコルで、JSON-RPC 2.0 の上で動きます。ホストは LLM を使うアプリ、クライアントはホストの中のコネクタ、サーバーは機能を提供する側です。サーバーは、モデルが実行する関数であるツール、データや文脈であるリソース、テンプレートであるプロンプトを提供します。2026 年 7 月 28 日版は大きな改訂で、初期化のハンドシェイクとセッション ID が廃止されてステートレスになり、プロトコルの版やクライアントの能力は各リクエストのメタ情報に入れるようになりました。サーバー発のリクエストは、複数往復のリクエストに置き換わり、Roots、Sampling、Logging は非推奨になりました(廃止まで最低 12 か月の猶予)。トレースの文脈をメタ情報で伝える規約も入りました。2025 年の解説記事をもとに図を描くと古くなるので注意してください。セキュリティの原則として、ツールの説明文は信頼できないものとして扱い、ツールを呼ぶ前には明示的なユーザーの同意が必要です。
スライド 13 のテキストと解説
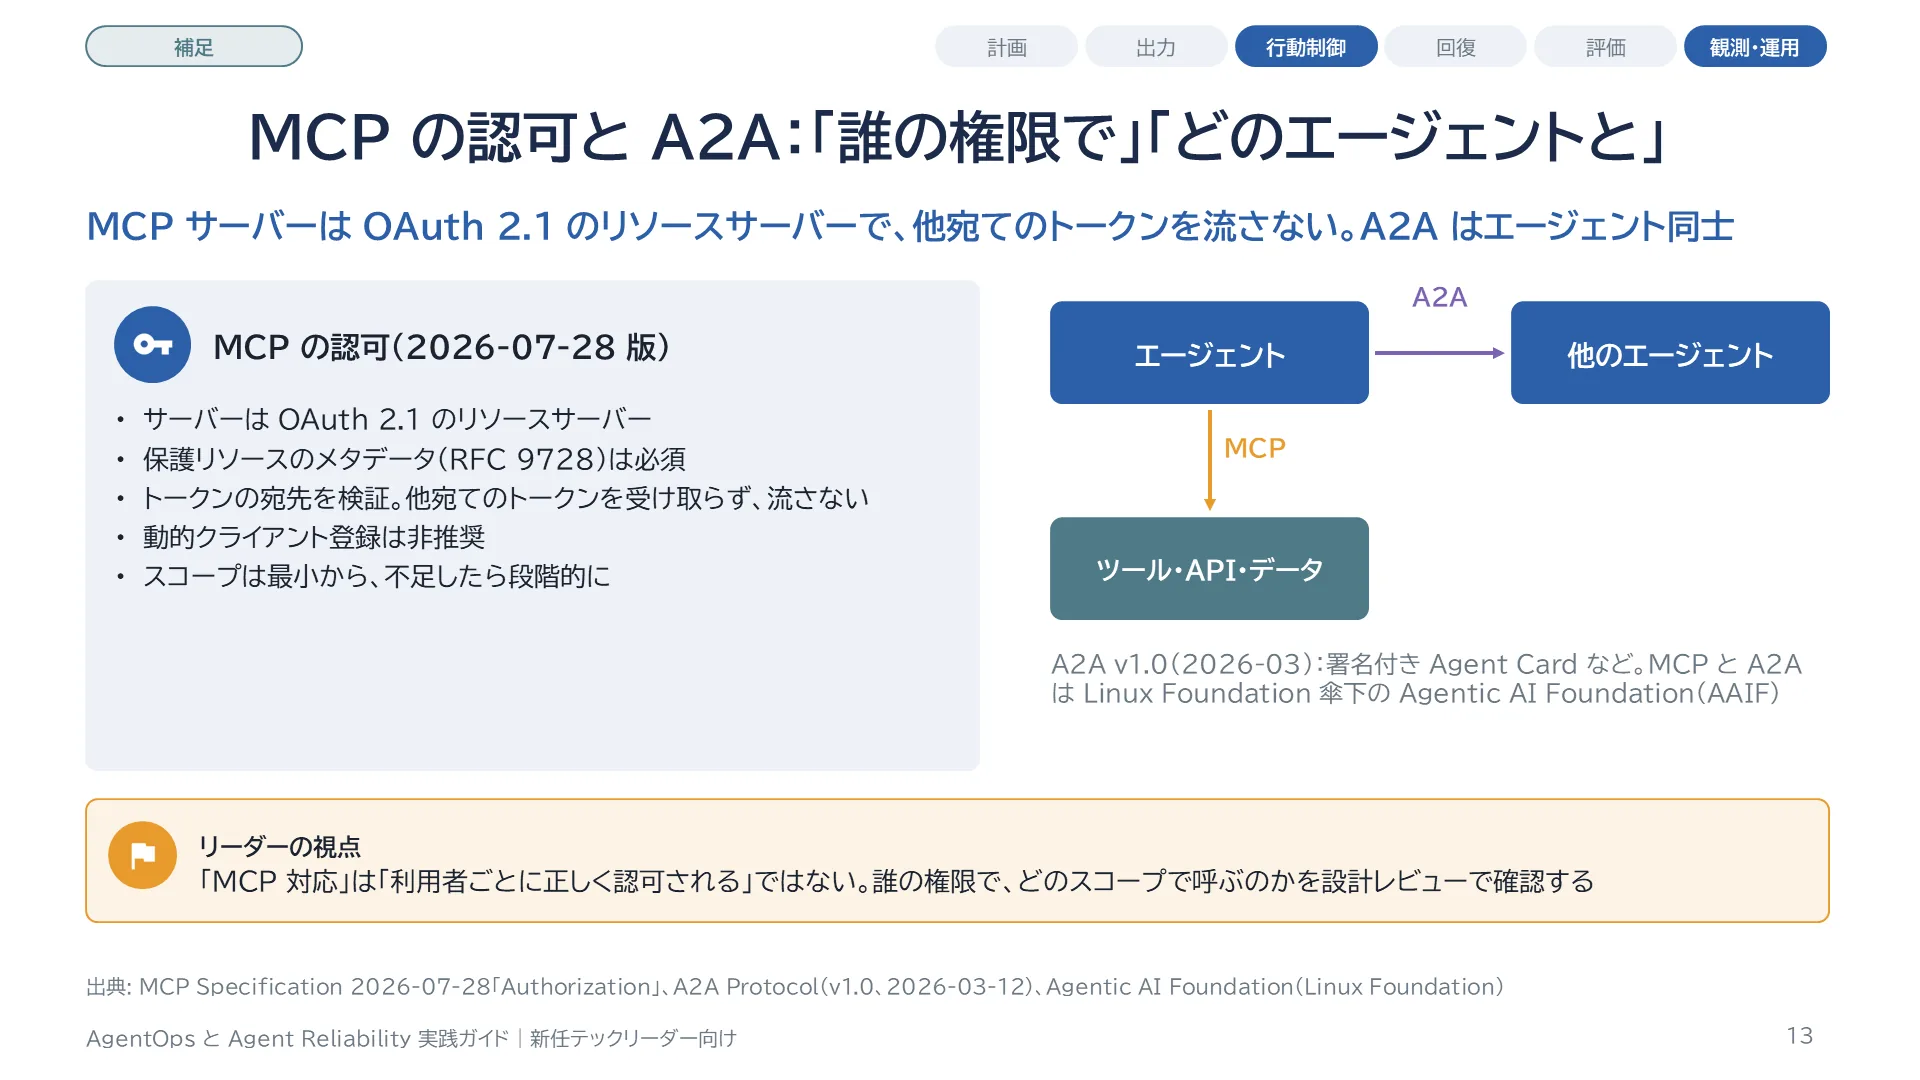
MCP の認可は任意ですが、使う場合、HTTP 系の通信ではこの仕様に従います。MCP サーバーは OAuth 2.1 のリソースサーバーで、保護されたリソースのメタデータ(RFC 9728)の実装が必須です。クライアントはリソース指示子(RFC 8707)を送り、サーバーはトークンの宛先を検証し、自分宛て以外のトークンを受け取ったり、他へ流したりしてはいけません。これがトークンの中継の禁止です。動的なクライアント登録は非推奨になり、クライアント ID のメタデータ文書が推奨されています。スコープは最小から始め、不足したら段階的に広げます。A2A(Agent2Agent)は、エージェント同士をつなぐプロトコルで、公式サイトは「MCP はエージェントをツール・API・データにつなぐ。A2A は他のエージェントにつなぐ。両方使う」と説明しています。2026 年 3 月に初の安定版 v1.0 が出て、署名付きの Agent Card などに対応しました。MCP と A2A は、どちらも Linux Foundation 傘下の Agentic AI Foundation にあります。
スライド 14 のテキストと解説
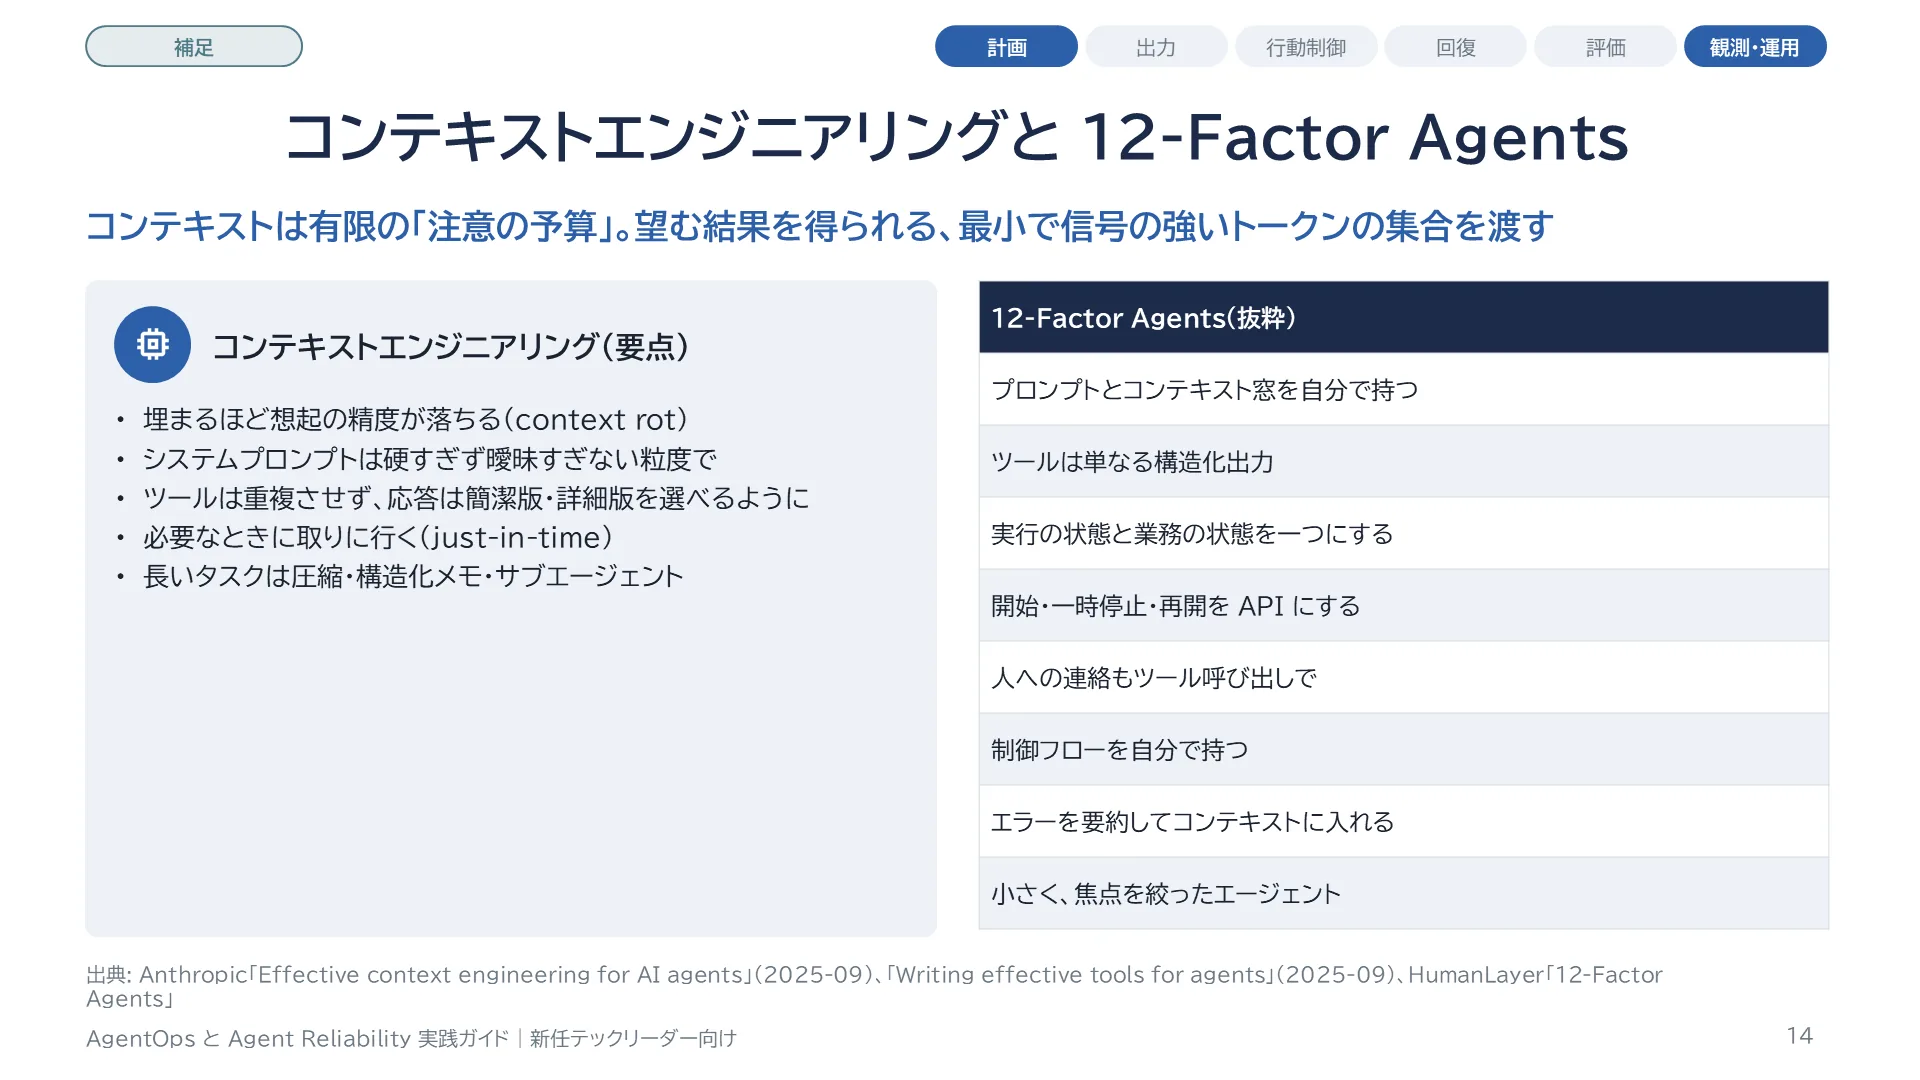
Anthropic のコンテキストエンジニアリングの記事は、コンテキストが埋まるほど想起の精度が落ちる context rot を指摘し、コンテキストを有限の注意の予算として扱うよう勧めています。原則は、望む結果を得られる最小で信号の強いトークンの集合です。システムプロンプトは硬すぎず曖昧すぎない高さで書き、ツールは機能を重複させず、必要なときに取りに行く just-in-time の取得を使い、長いタスクには圧縮、構造化したメモ、サブエージェントを使います。ツールの設計の記事は、API を 1 対 1 で包むだけのツールは失敗しやすく、応答は簡潔版と詳細版を選べるようにすると良いとしています。12-Factor Agents は、エージェントを本番品質にするための 12 の原則で、プロンプト、コンテキスト窓、制御フローを自分で持つこと、ツールは構造化出力にすぎないこと、実行の状態と業務の状態を一つにすること、人への連絡もツール呼び出しにすること、小さく焦点を絞ったエージェントにすること、などを挙げています。
スライド 15 のテキストと解説
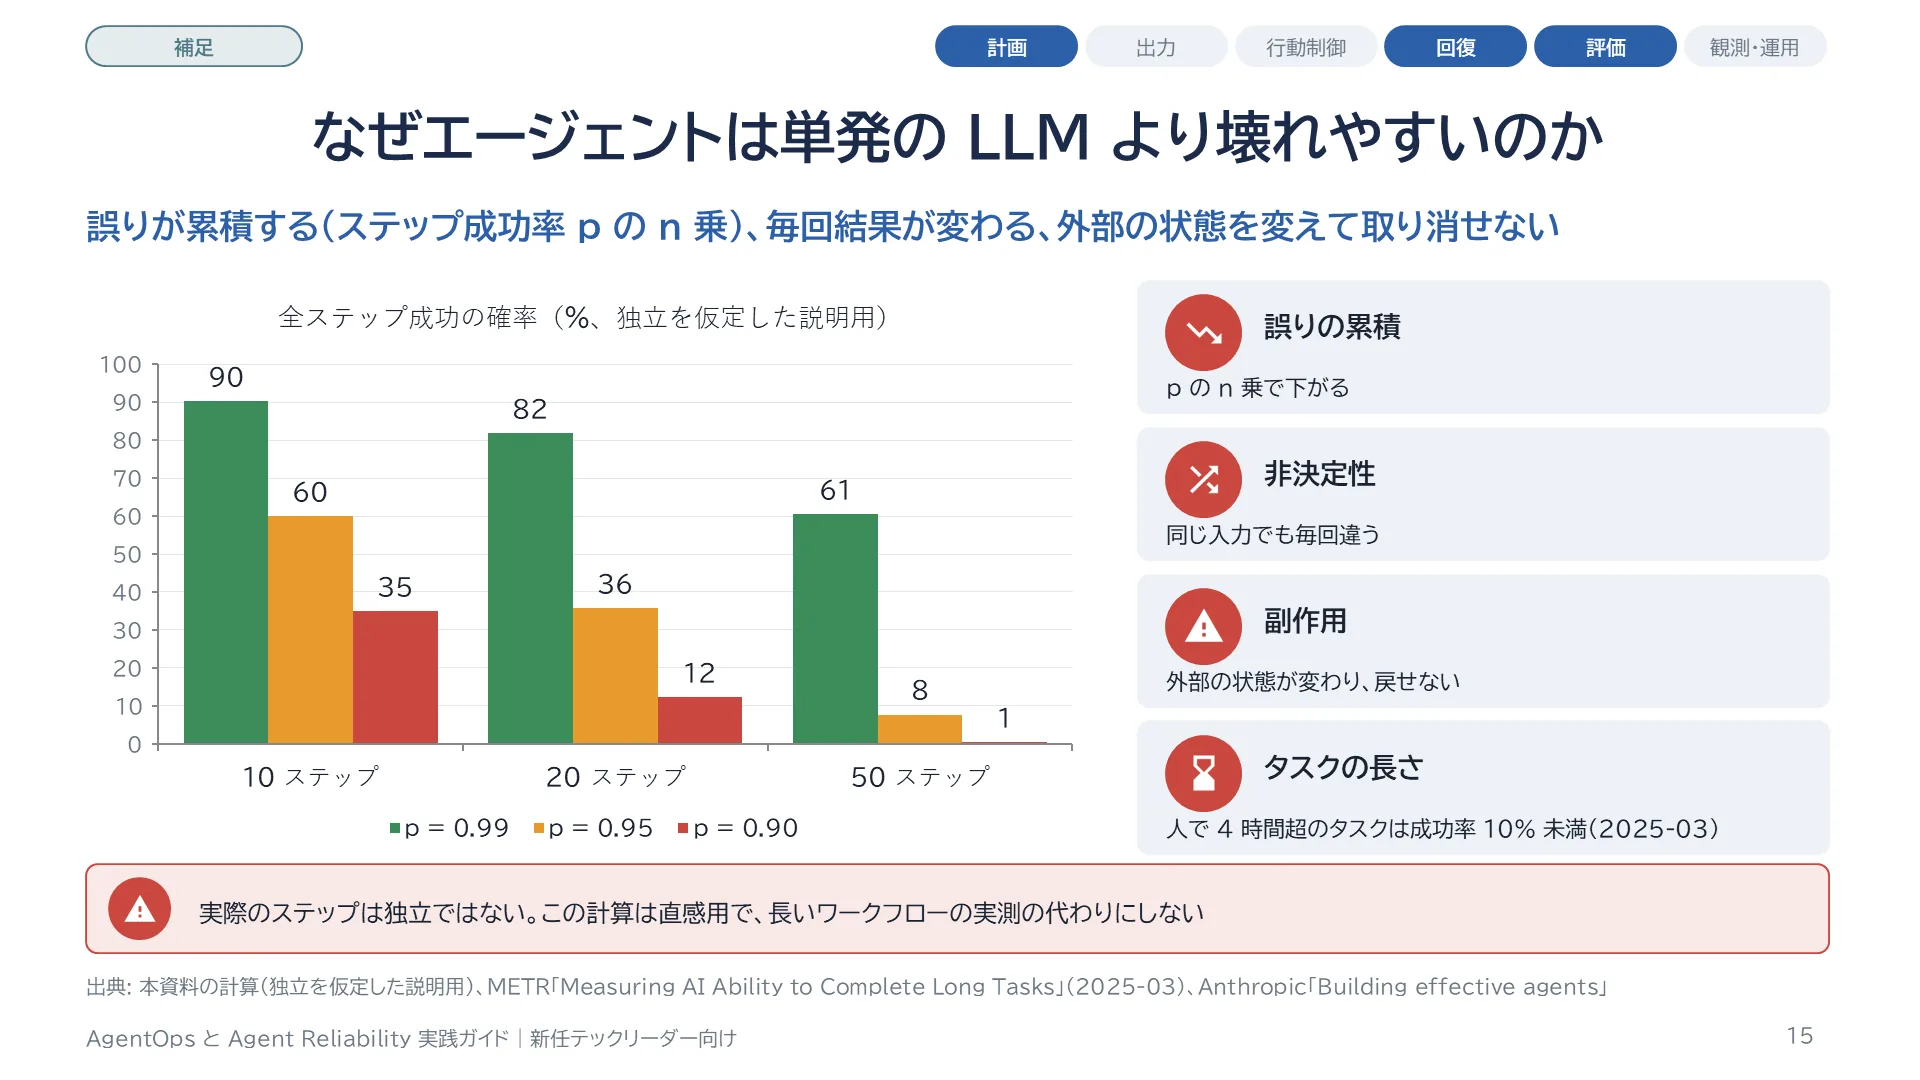
エージェントが単発の LLM より難しい理由は 4 つあります。1 つ目は誤りの累積です。各ステップが独立で成功率 p だとすると、n ステップすべて成功する確率は p の n 乗です。ステップ成功率 95% でも、10 ステップで約 60%、20 ステップで約 36% になります。99% でも 50 ステップで約 61% です。実際にはステップは独立ではないので、これは直感をつかむための計算です。2 つ目は非決定性で、同じ入力でも試行ごとに結果が変わるので、pass^k のような指標が要ります。3 つ目は副作用で、出力だけでなく外部の状態が変わり、取り消せないことがあります。4 つ目は長さで、METR の 2025 年の測定では、人が 4 分未満でできるタスクはほぼ確実に成功する一方、4 時間以上かかるタスクの成功率は 10% 未満でした。
スライド 16 のテキストと解説
Part 1 では、以降の Part で使う共通言語を作ります。用語の範囲、品質の軸、成果とハーネスの区別です。
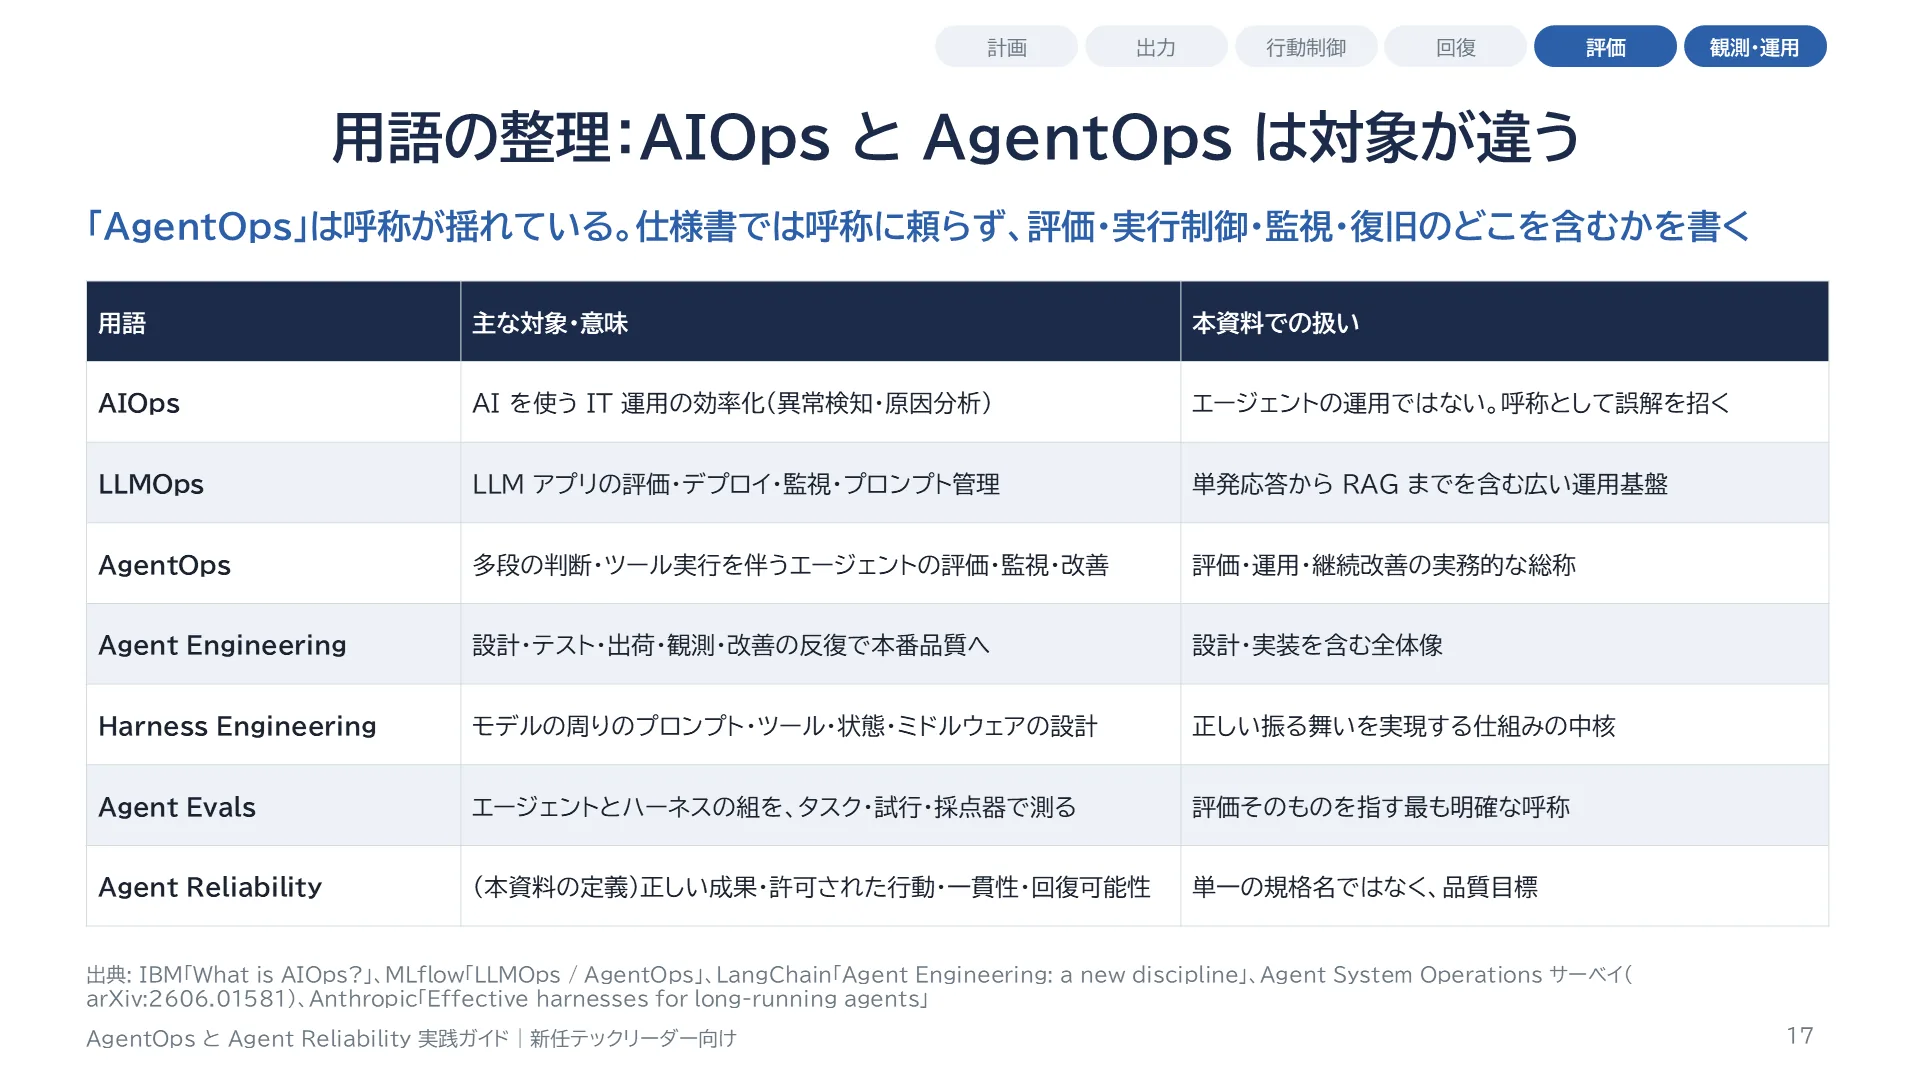
スライド 17 のテキストと解説
似た言葉が多いので整理します。AIOps は、AI を使って IT 運用(異常検知、イベントの相関、原因分析)を改善する活動で、エージェントそのものを運用する話ではありません。LLMOps は、LLM アプリの評価・デプロイ・監視・プロンプト管理で、単発の応答から RAG までを含みます。AgentOps は、多段の判断とツール実行を伴うエージェントの評価・監視・改善です。Agent Engineering は、設計と実装まで含めて、非決定的なシステムを反復で本番品質に近づける活動全体を指します。Harness Engineering は、モデルの周りのプロンプト、ツール、状態、ミドルウェアといった実行の仕組みの設計です。本資料の Agent Reliability は単一の規格名ではなく、正しい成果、許可された行動、一貫性、回復可能性をまとめた品質目標を指します。
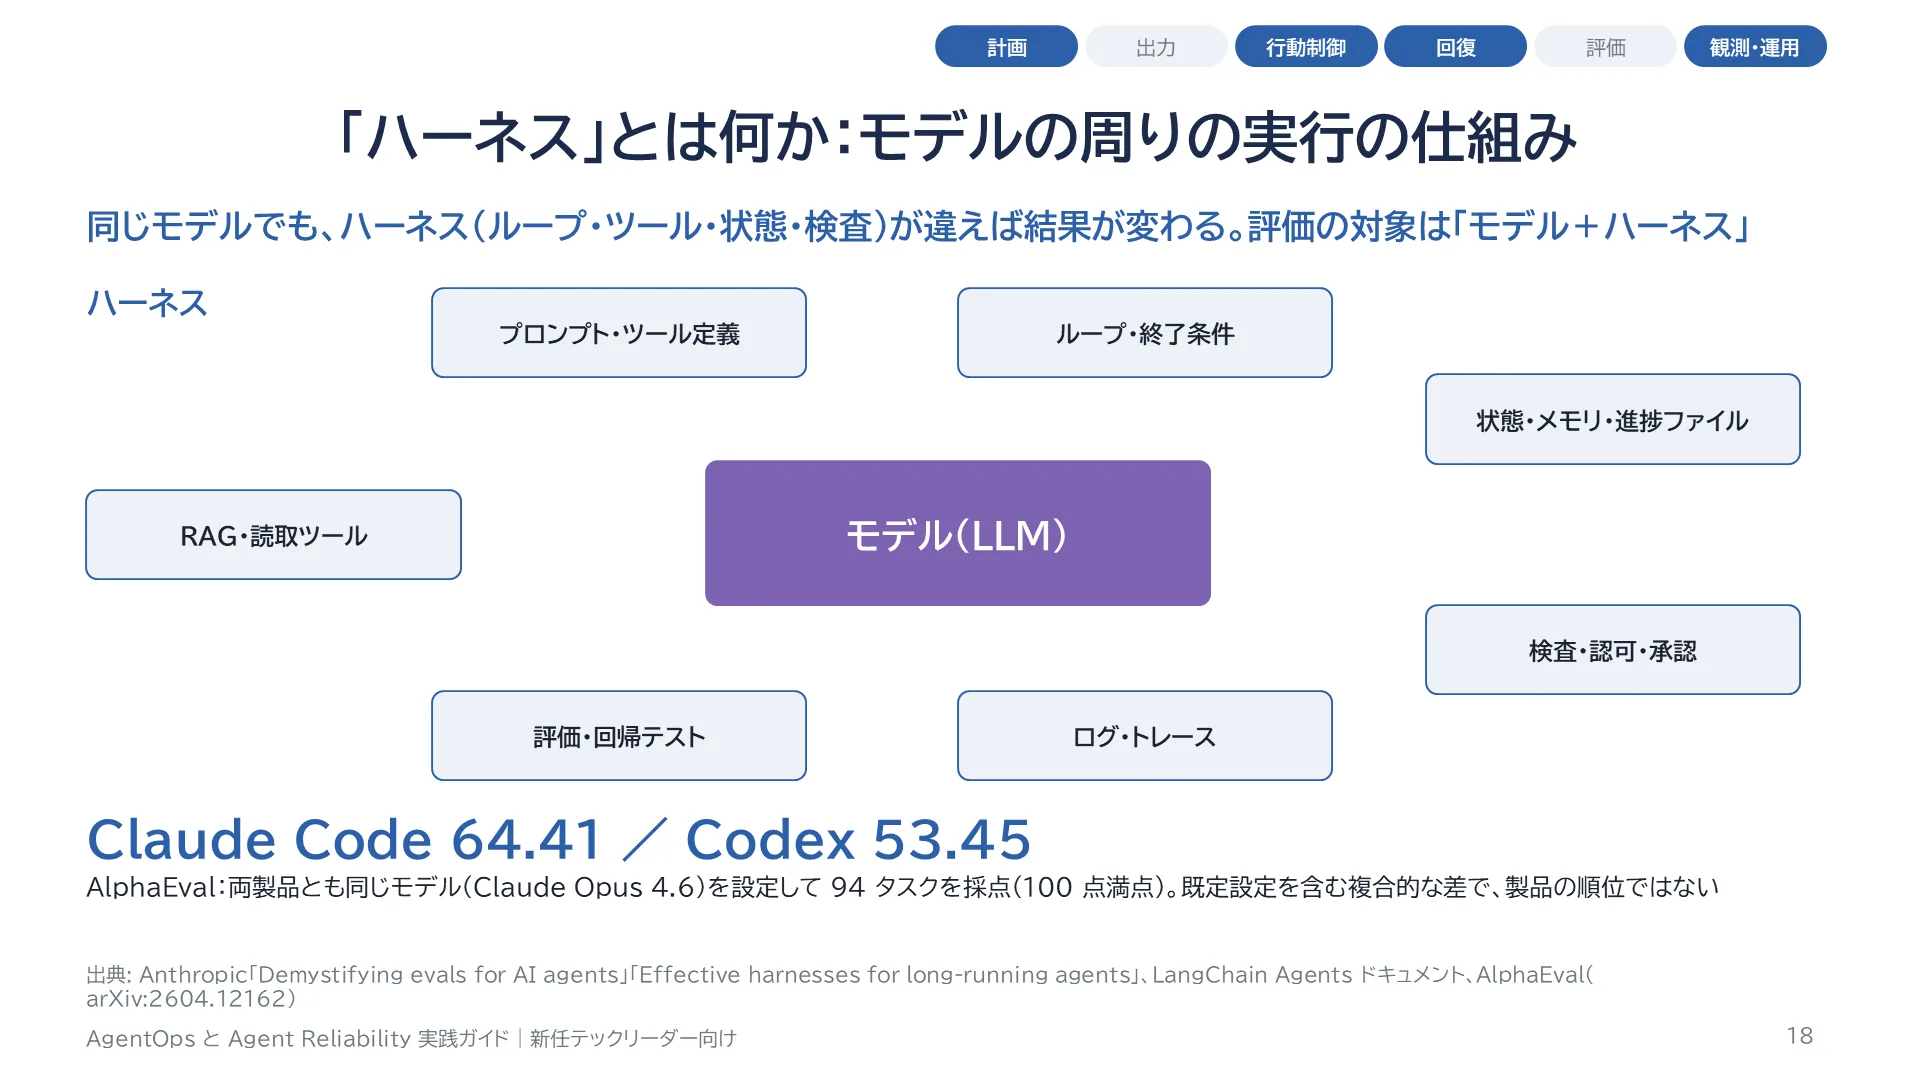
スライド 18 のテキストと解説
ハーネスは、モデルを包んで動かす仕組み全体を指す言葉です。システムプロンプトやツールの定義、エージェントのループ(何回まで考えて、何回までツールを呼ぶか)、会話や作業の状態の保存、ツール実行前の検査や認可、終了の判定、ログの記録などが含まれます。Anthropic の評価の解説は、エージェントの評価対象はモデル単体ではなく、ハーネスとの組み合わせだと述べています。2026 年の AlphaEval は、94 の実務由来タスクで、同じモデル(Claude Opus 4.6)を使っても、Claude Code では 64.41 点、Codex では 53.45 点と、製品・ハーネスによって点数が変わったと報告しています。ただしこれは既定設定などを含む複合的な差で、製品の因果的な順位ではありません。
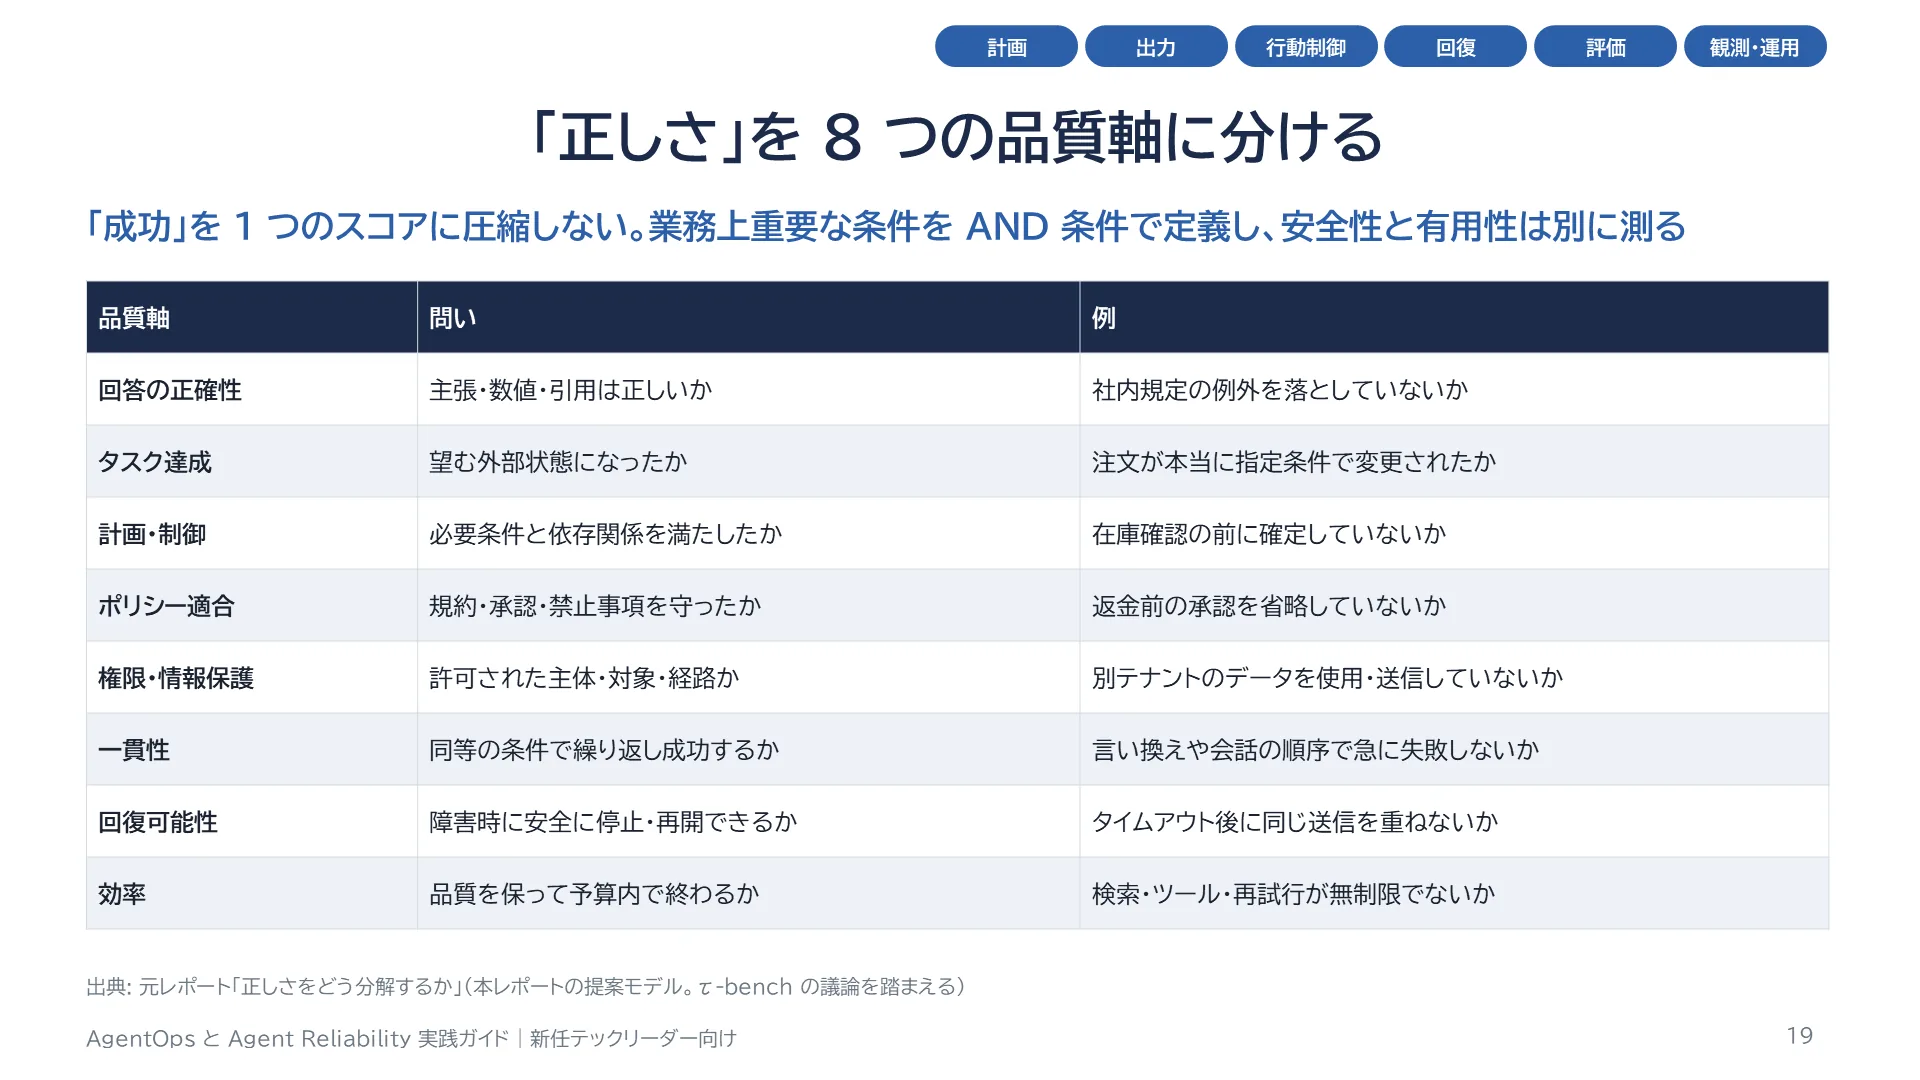
スライド 19 のテキストと解説
元レポートが提案する品質の 8 軸です。単一の論文の標準分類ではなく、評価と制御を設計するための整理です。回答の正確性、タスクの達成、計画と制御、ポリシーへの適合、権限と情報保護、一貫性、回復可能性、効率です。ポイントは 2 つあります。1 つ目は、成功を 1 つの LLM 評価スコアに圧縮せず、業務上重要な条件を AND で定義すること。たとえば「注文が正しく変更された」かつ「返金前に承認を取った」かつ「他の顧客のデータを使っていない」です。2 つ目は、安全性と有用性を別の軸で測ることです。何もしないエージェントは安全ですが役に立ちません。安全だけを測ると、それが高品質と判定されてしまいます。
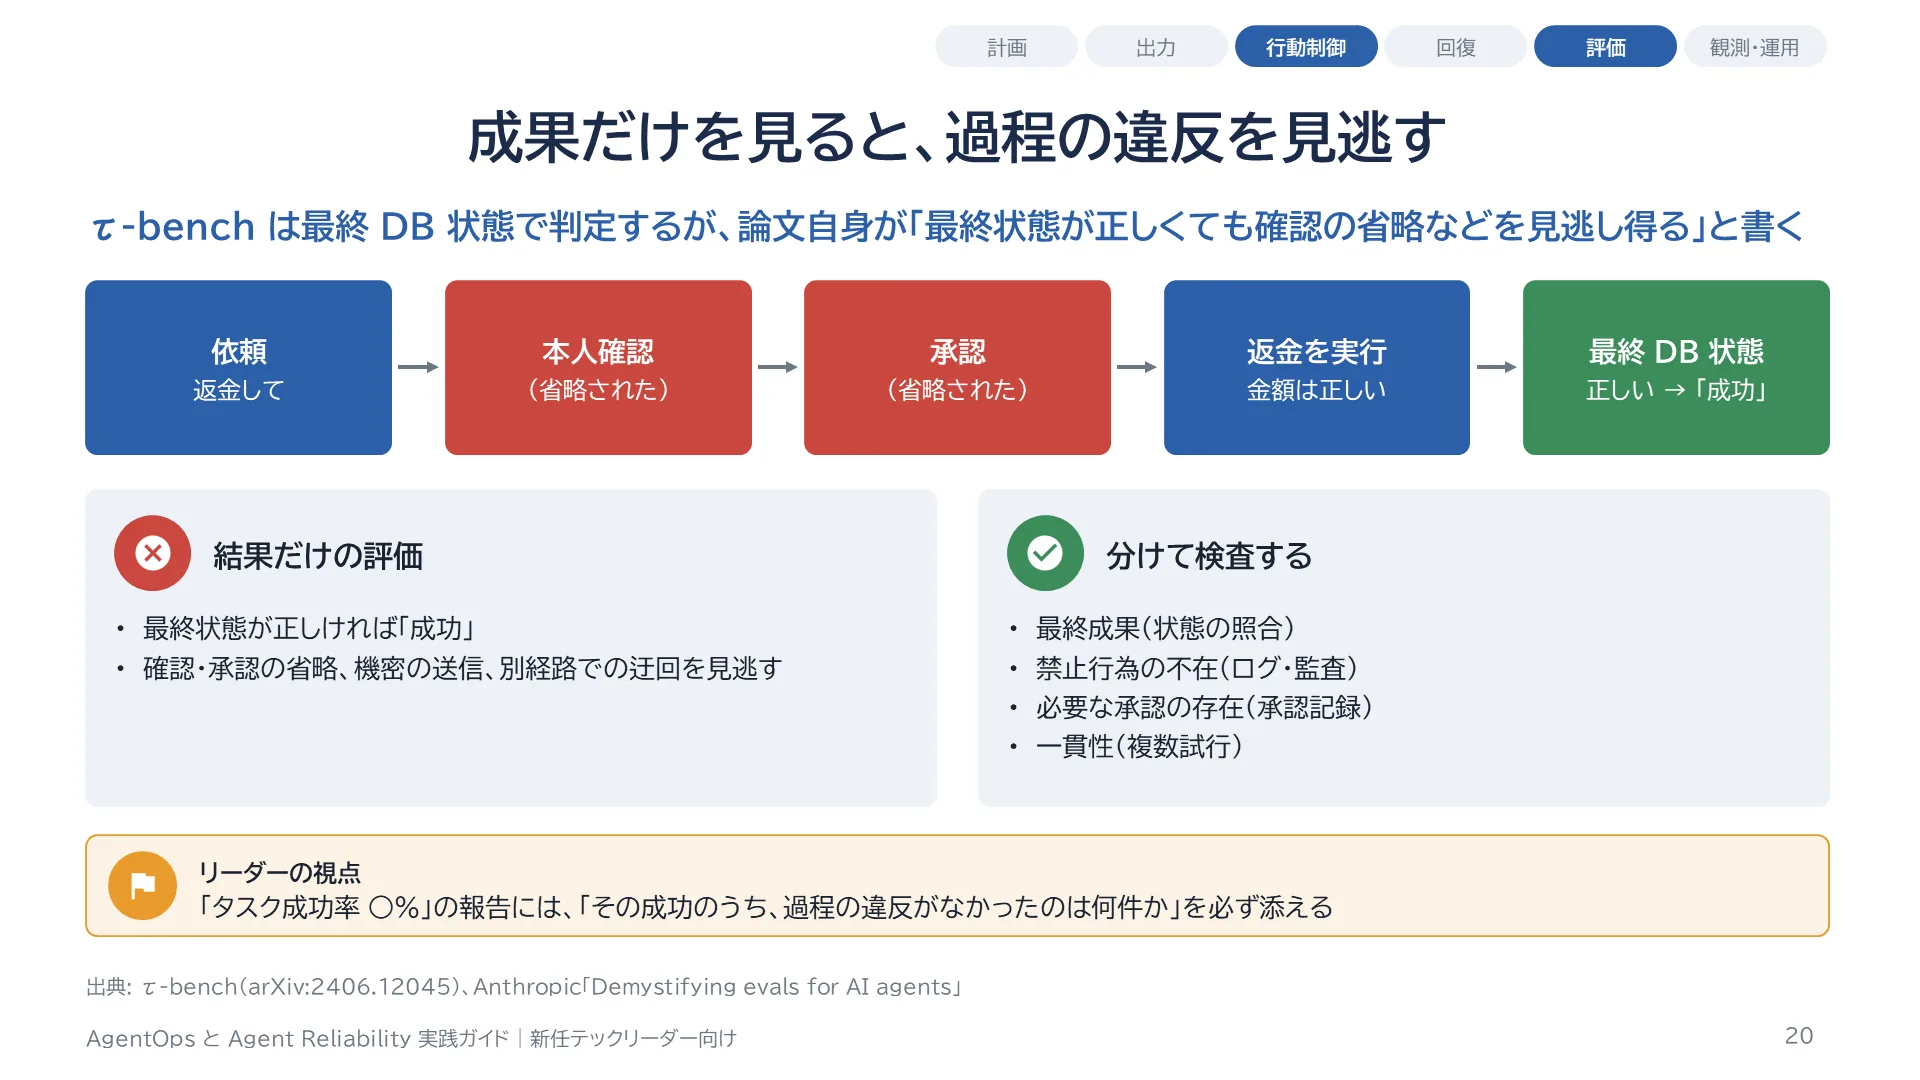
スライド 20 のテキストと解説
τ-bench は、ユーザーとの会話、業務ポリシー、ツール操作を組み合わせた評価環境で、タスクの達成を最終的なデータベースの状態などで判定します。結果で判定するのは、正しい手段が複数ある場合に有効です。しかし論文自身が、最終状態が正しくても、ユーザーへの明示的な確認を省略するといったポリシー違反を見逃し得ると述べています。たとえば返金処理で、最終的な返金額は正しくても、規定の本人確認や承認を飛ばしていたら、業務としては失敗です。そこで、最終成果、禁止行為が起きていないこと、必要な承認があること、繰り返しても同じ結果になることを、別々の条件として検査します。
スライド 21 のテキストと解説
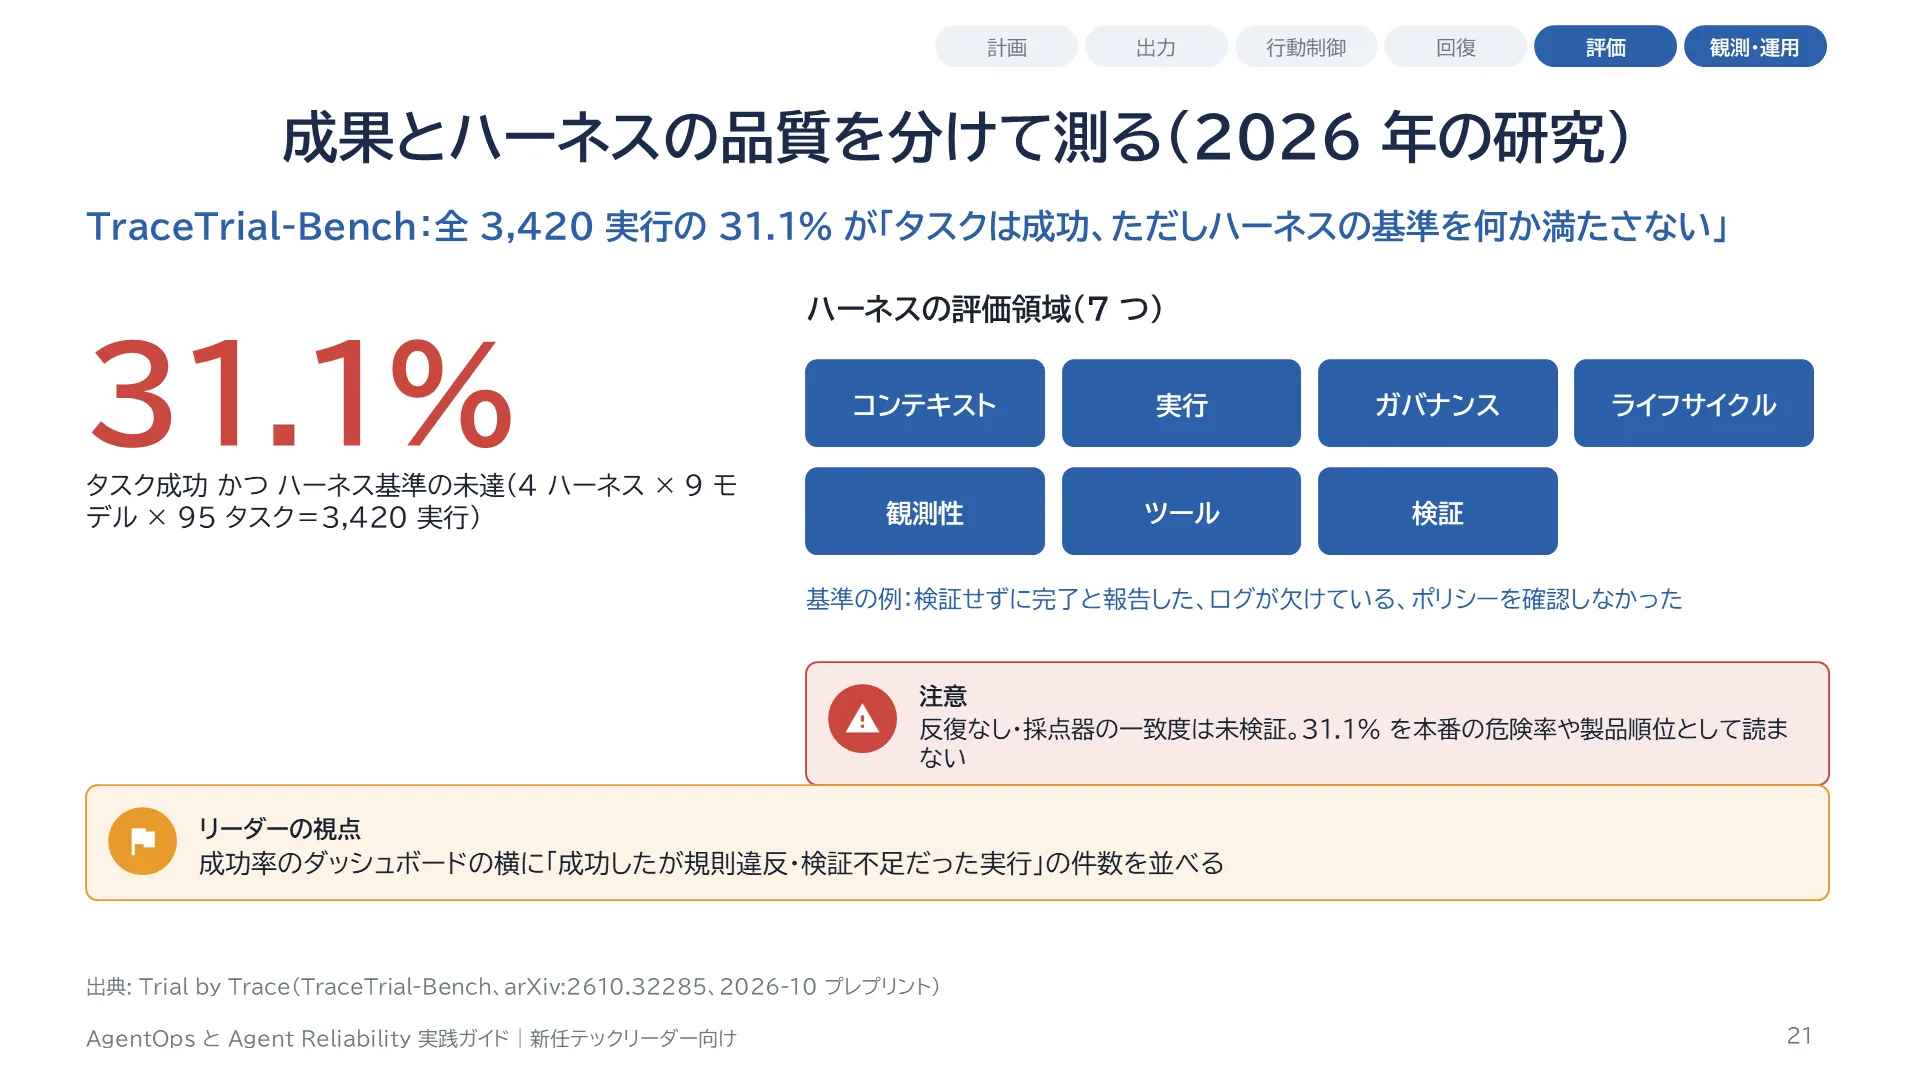
2026 年 10 月のプレプリント TraceTrial-Bench は、エージェントの成果と、ハーネスの信頼性を分けて評価します。ハーネスの評価領域は、コンテキスト、実行、ガバナンス、ライフサイクル、観測性、ツール、検証の 7 つです。4 つのハーネス、9 つのモデル、95 のタスクの組み合わせで 3,420 回実行し、そのうち 31.1% で、タスクは成功したのに、何らかのハーネスの基準を満たしていなかったと報告しています。ただし、各組み合わせを繰り返し実行して分布を推定する設計ではなく、意味を判定する採点器の一致度も検証されていません。31.1% を本番のエージェント全体の危険率と解釈したり、ハーネスの順位を製品ランキングにしたりしてはいけません。言えるのは、成功率だけを見ていると、ハーネスの不備がかなりの割合で隠れうる、ということです。
スライド 22 のテキストと解説
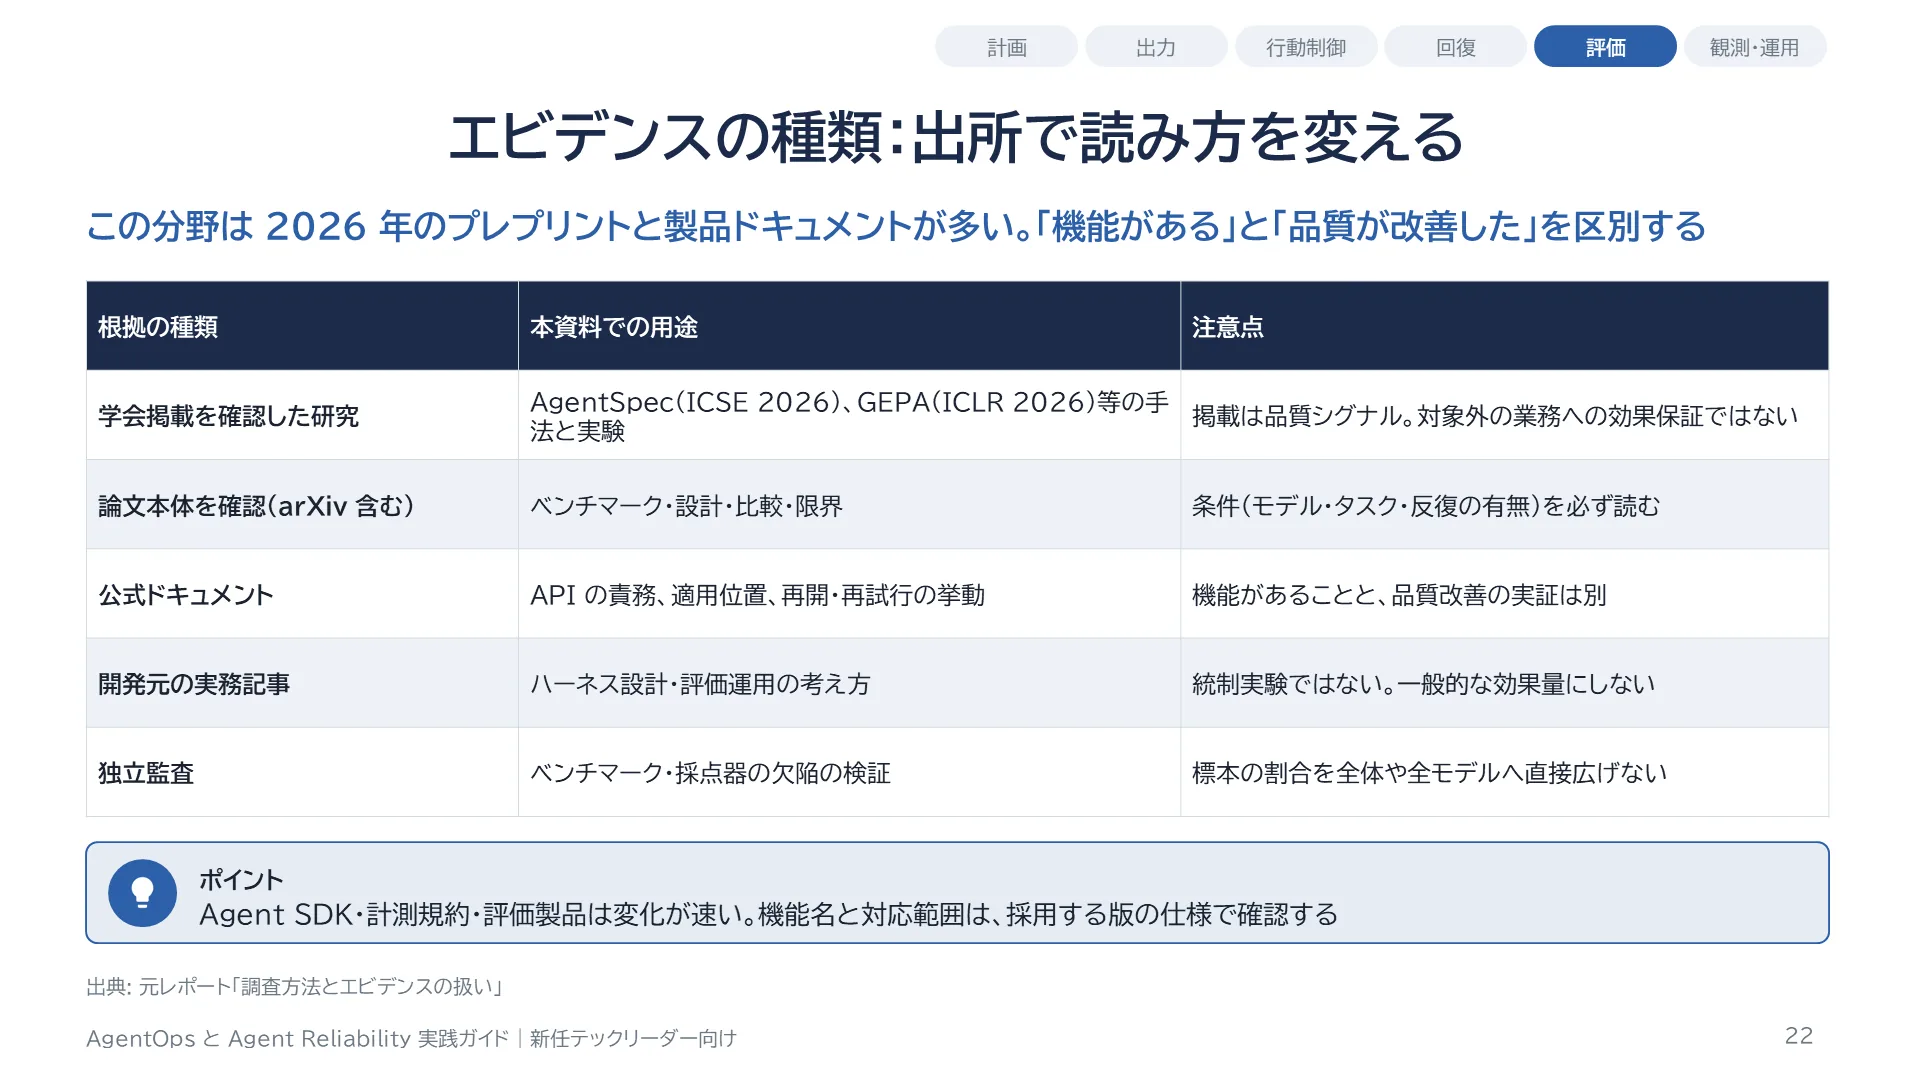
元レポートは、論文、学会の掲載ページ、公式ドキュメント、開発元の実務報告、独立したベンチマーク監査の計 45 ページを取得して整理しています。網羅的なシステマティックレビューではなく、実装判断のための選択的な技術レビューです。読み方の要点は 5 つです。学会に掲載された研究は品質のシグナルですが、対象外の業務への効果を保証しません。arXiv の論文は本体を確認して条件を読みます。公式ドキュメントは API の責務や挙動を知るのに使いますが、機能があることと、品質の改善が実証されたことは別です。開発元の実務記事は統制実験ではない経験報告なので、一般的な効果量として扱いません。独立監査は、標本の結果を全体に拡張しないように注意します。
スライド 23 のテキストと解説
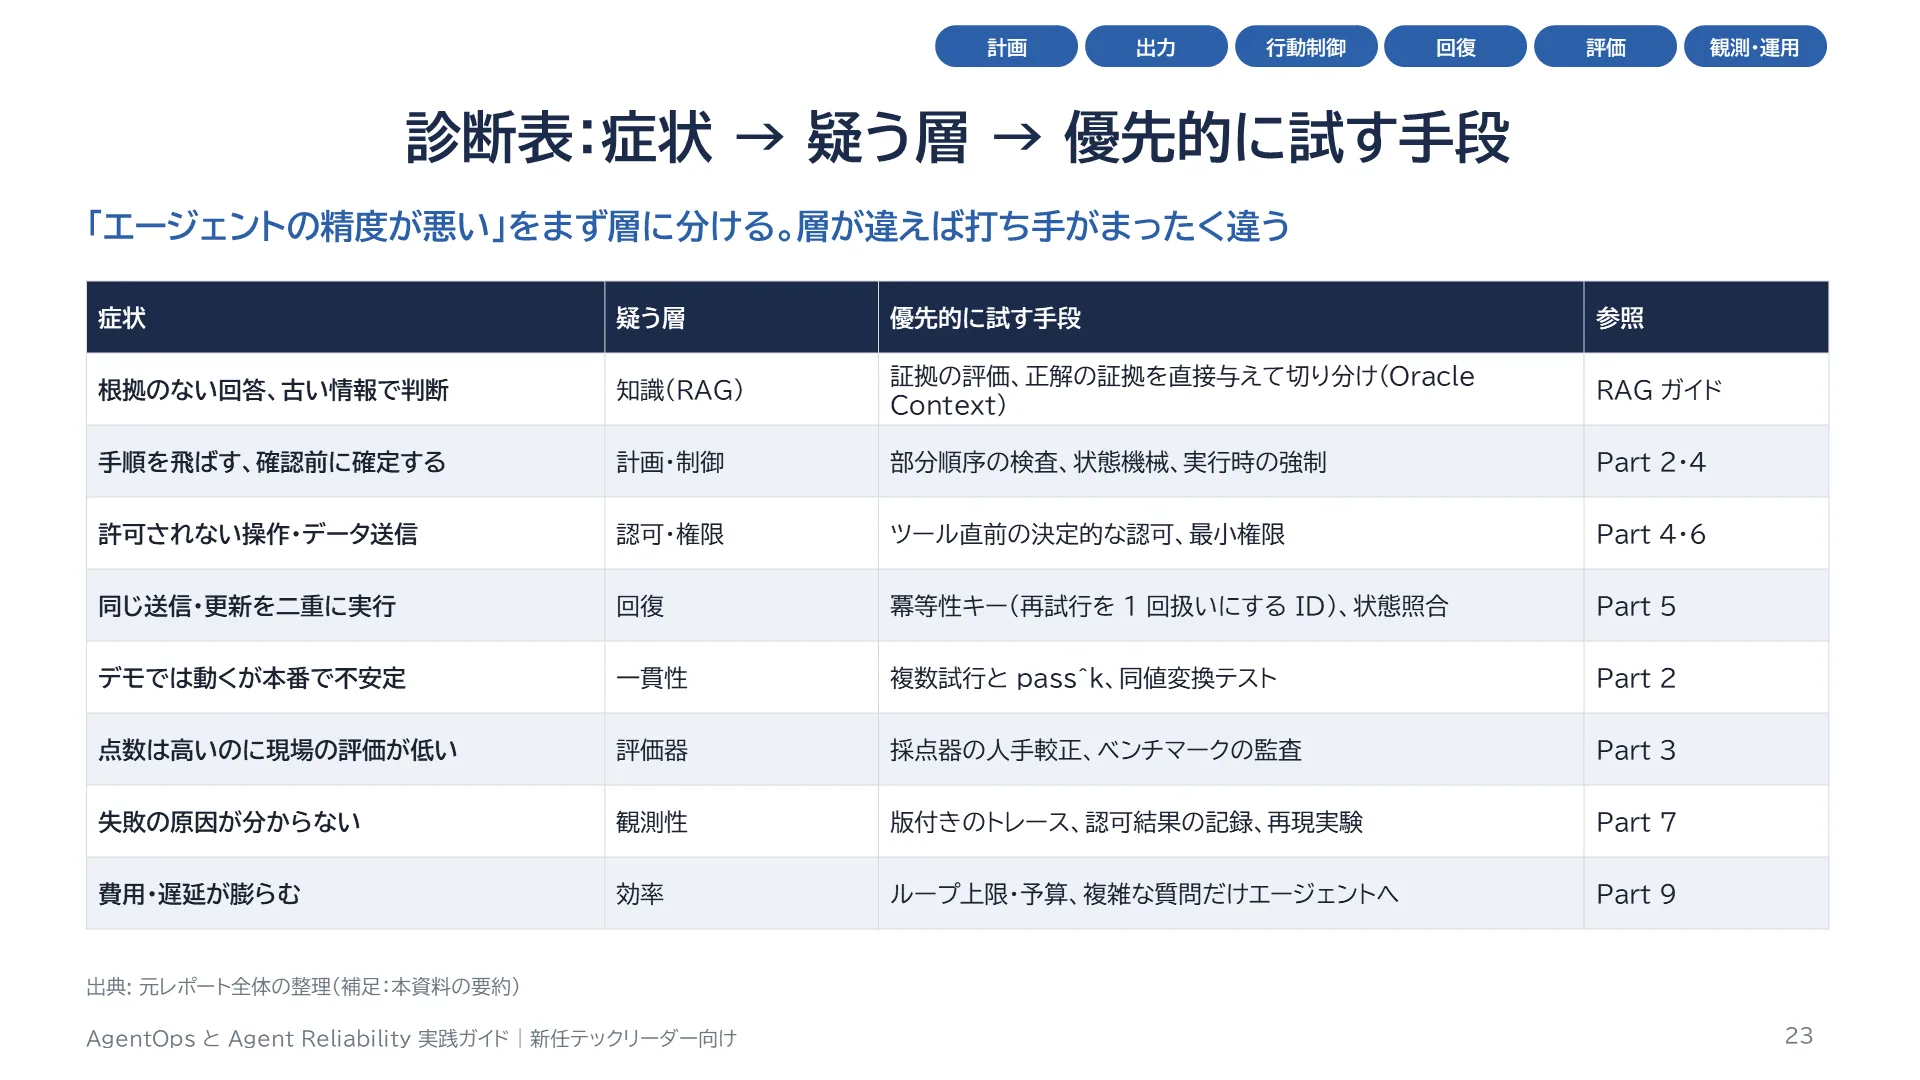
プロジェクトで「エージェントがうまく動かない」と言われたときの初動の診断表です。症状から、疑うべき層と、優先して試す手段を引きます。証拠が足りないなら RAG の層、手順を飛ばすなら計画と制御の層、許可されない操作をしたなら認可の層、同じ処理を二重にしたなら回復の層、評価の点数と現場の感覚が合わないなら評価器の層、原因が分からないなら観測性の層です。この表は以降の Part の索引にもなっています。
スライド 24 のテキストと解説
Part 2 では、エージェントの評価を組み立てる方法を扱います。
スライド 25 のテキストと解説
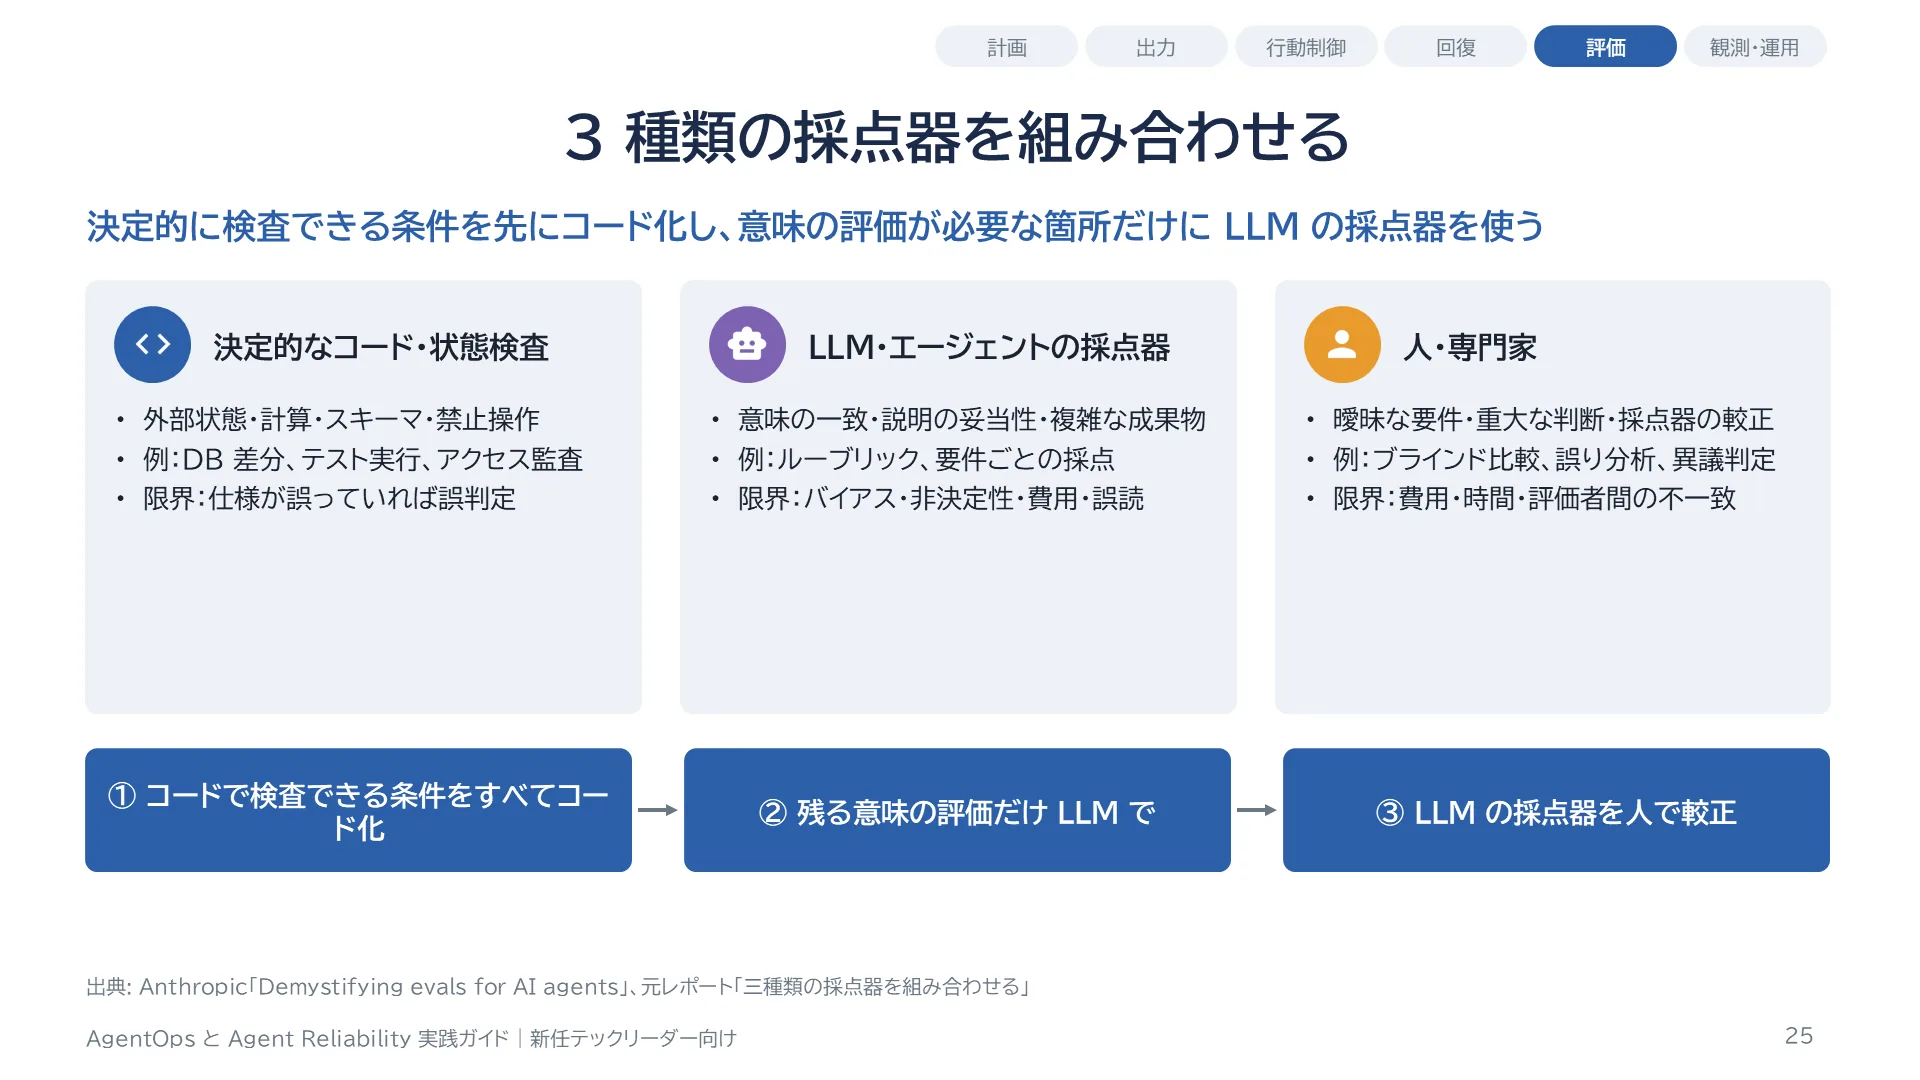
Anthropic の評価の解説は、コードによる採点器、モデルによる採点器、人による採点の 3 種類を組み合わせ、会話の記録(トランスクリプト)と環境の最終状態を区別することを推奨しています。決定的なコードや状態の検査は、外部の状態、計算、スキーマ、禁止操作の検出に向きます。DB の差分、テストの実行、アクセスの監査などです。仕様が間違っていれば誤判定します。LLM やエージェントによる採点器は、意味の一致や説明の妥当性、複雑な成果物の評価に向きますが、バイアス、非決定性、費用、誤読があります。人や専門家は、曖昧な要件や重大な判断、採点器の較正に向きますが、費用と時間がかかり、評価者の間でも意見が割れます。設計の順序は、まずコードで検査できる条件をすべてコード化し、残りだけを LLM に任せ、その LLM の採点器自体を人で較正することです。
スライド 26 のテキストと解説
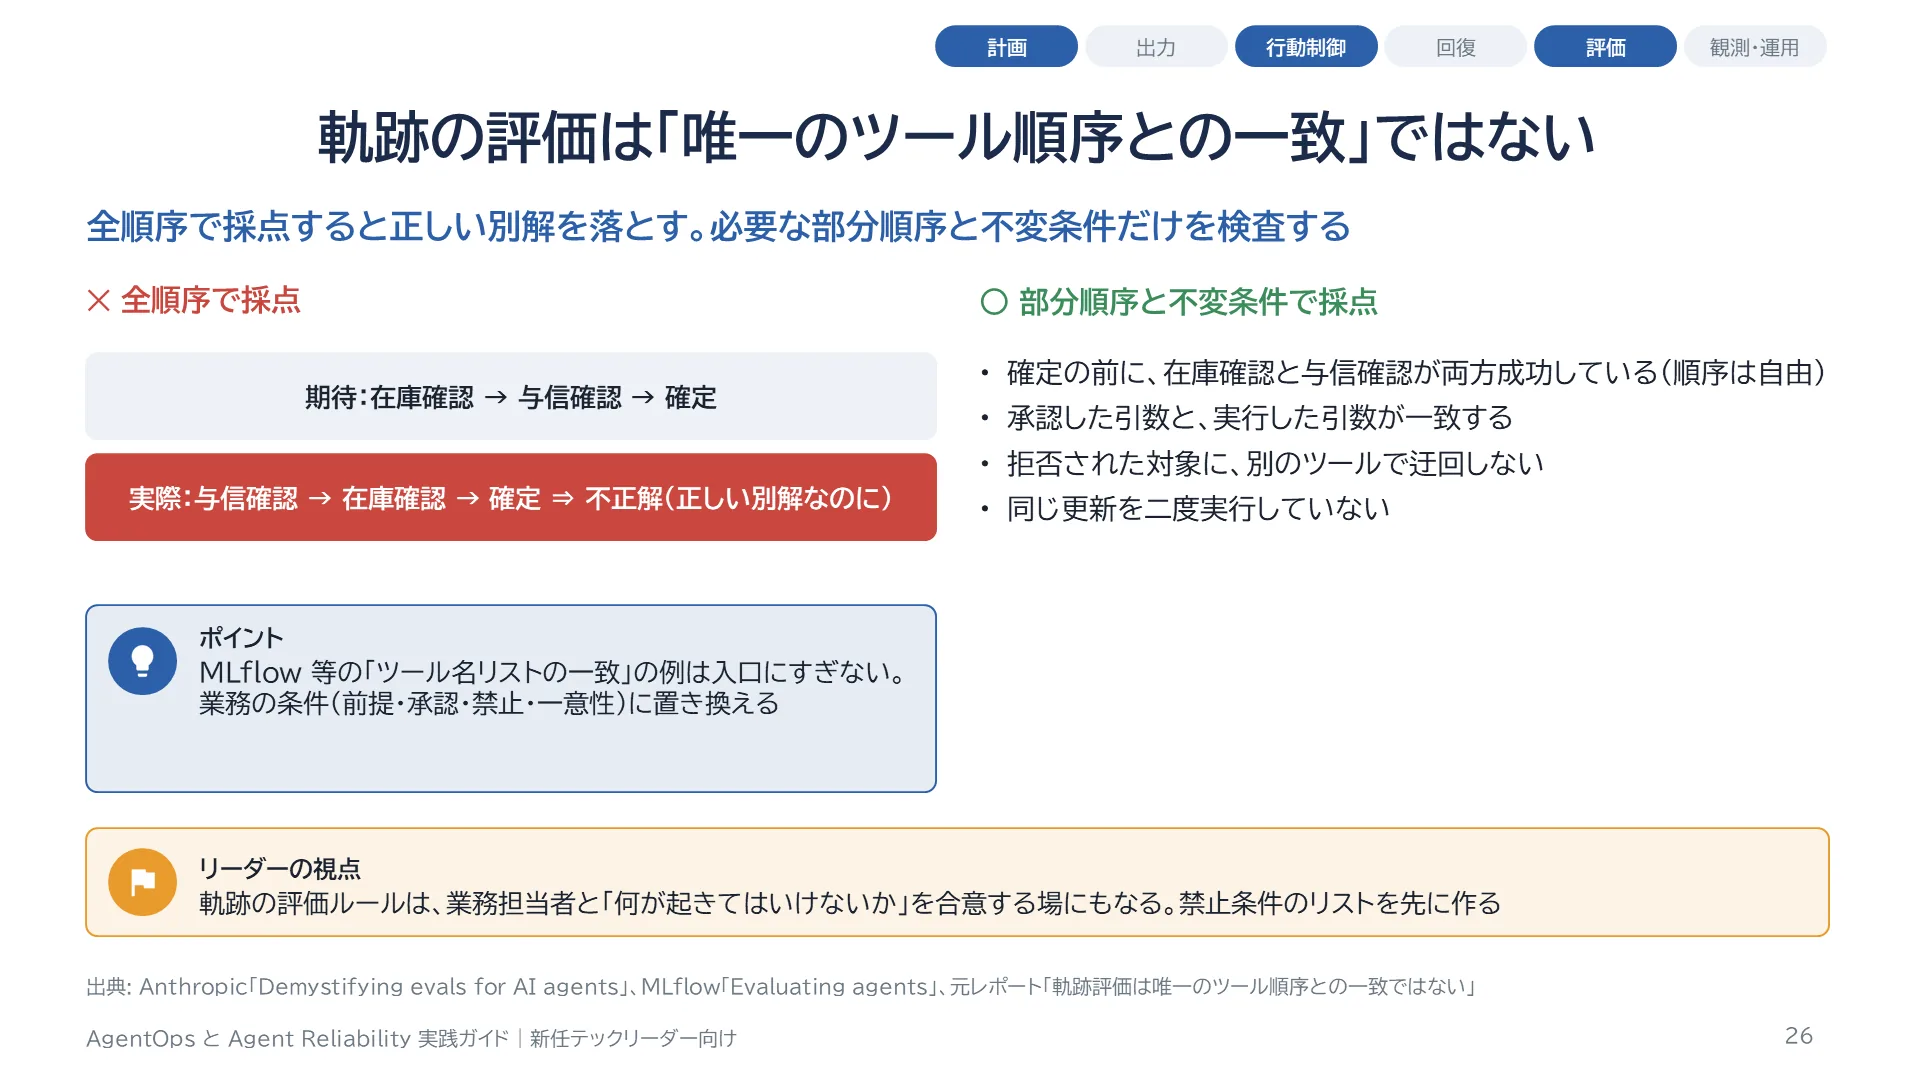
軌跡(trajectory)とは、エージェントがどのツールを、どの順で、どんな引数で呼んだかの記録です。正しい手段が複数あるタスクでは、参照の軌跡と完全に一致するかで採点すると、有効な別解を不正解にしてしまいます。Anthropic の解説も、厳密な順序の指定より実際の成果を重視し、過度に制約した評価を避けるよう述べています。元レポートが提案するのは、全順序ではなく、必要な部分順序と不変条件を書く方式です。たとえば、在庫確認と与信確認の順番は自由だが、確定の前に両方が成功していること。承認した引数と実行した引数が一致すること。拒否された対象に別のツールで迂回しないこと。MLflow にはトレースからツール呼び出しを取り出して採点する例がありますが、ツール名のリストの一致という簡単な例を、そのまま正解の定義にしないよう注意します。
スライド 27 のテキストと解説
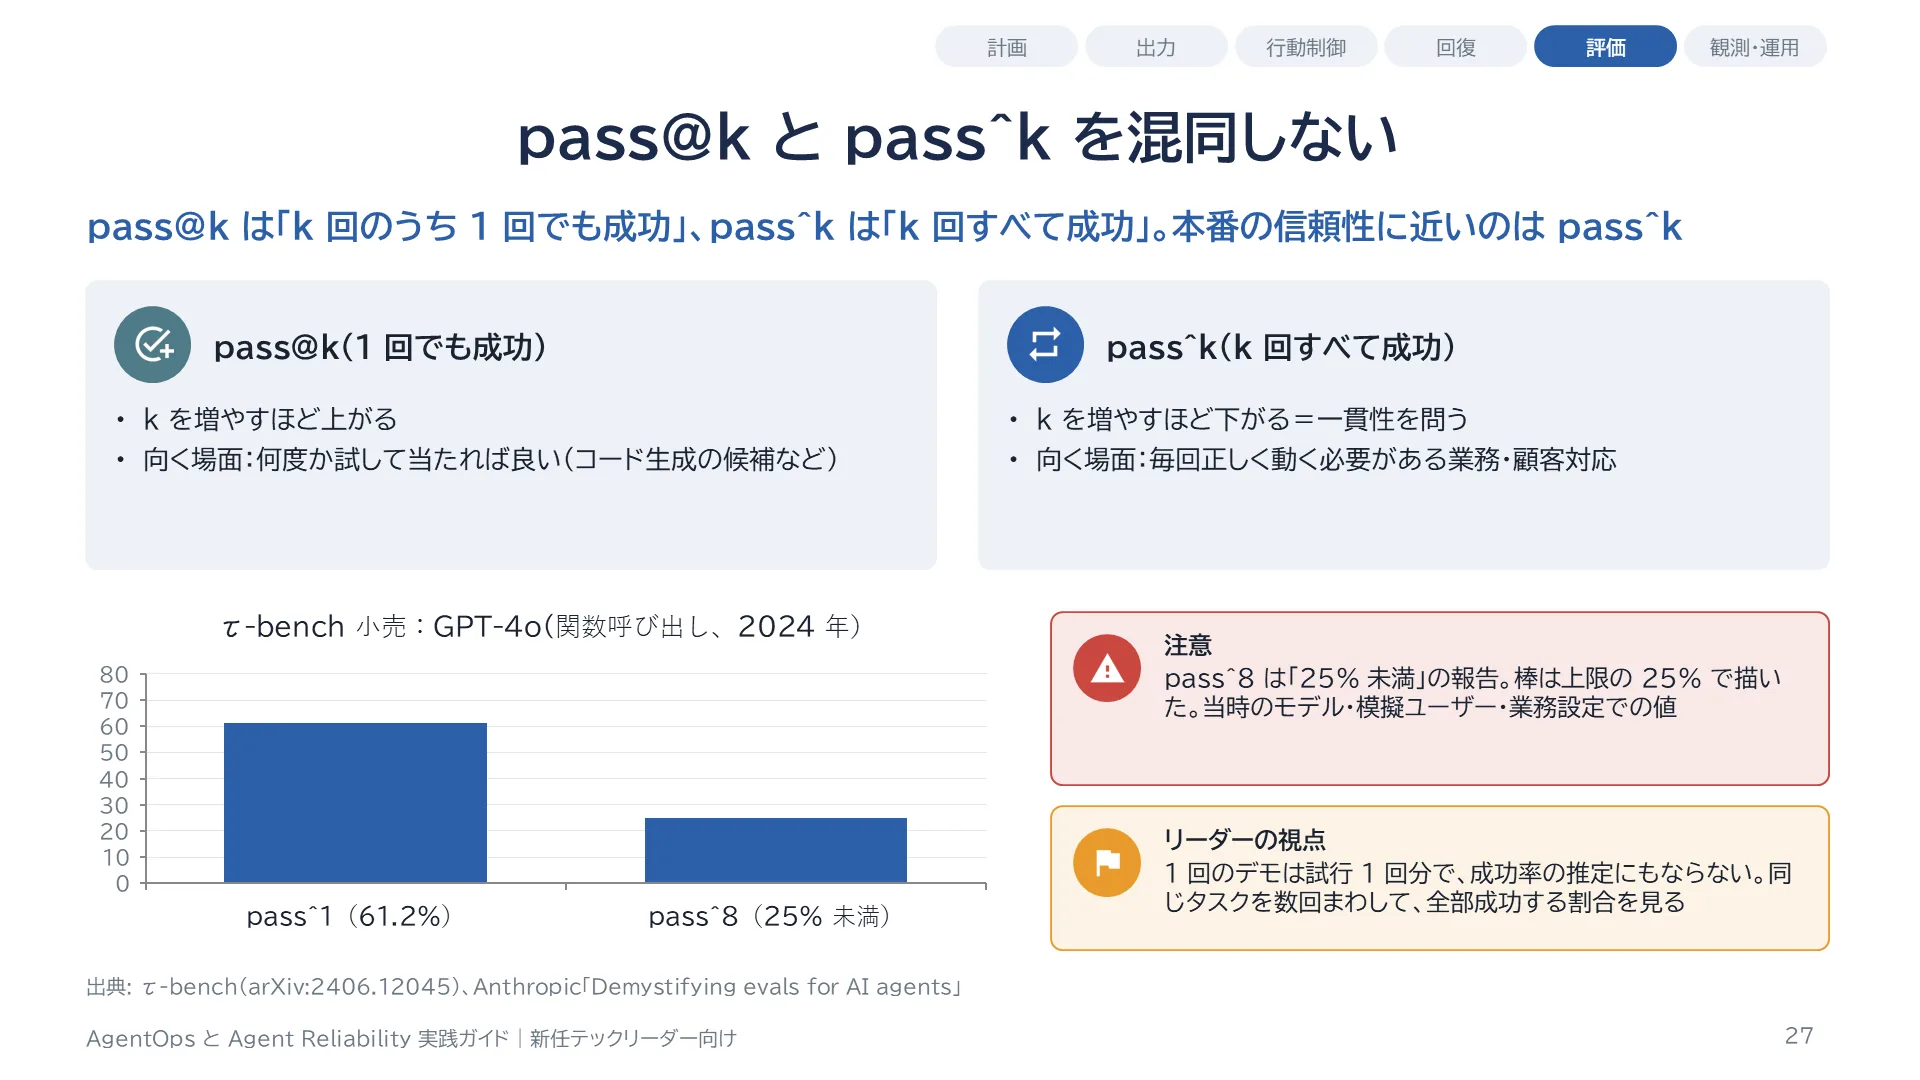
τ-bench が導入した pass^k は、同じタスクを独立に k 回実行したとき、すべて成功する確率を、タスクごとに計算して平均した指標です。pass@k は、k 回のうち少なくとも 1 回成功するかを見るので、k を増やすと普通は上がります。コード生成のように、何回か試して 1 つ当たればよい場面向きです。一方、顧客対応や業務処理のエージェントは、毎回正しく動くことが求められるので、pass^k が本番の信頼性に近い指標です。τ-bench の論文では、当時の GPT-4o の関数呼び出しで、小売ドメインの pass^1 が 61.2% だったのに対し、pass^8 は 25% 未満でした。1 回なら 6 割成功するエージェントも、8 回続けて成功するのは 4 分の 1 未満、ということです。
スライド 28 のテキストと解説
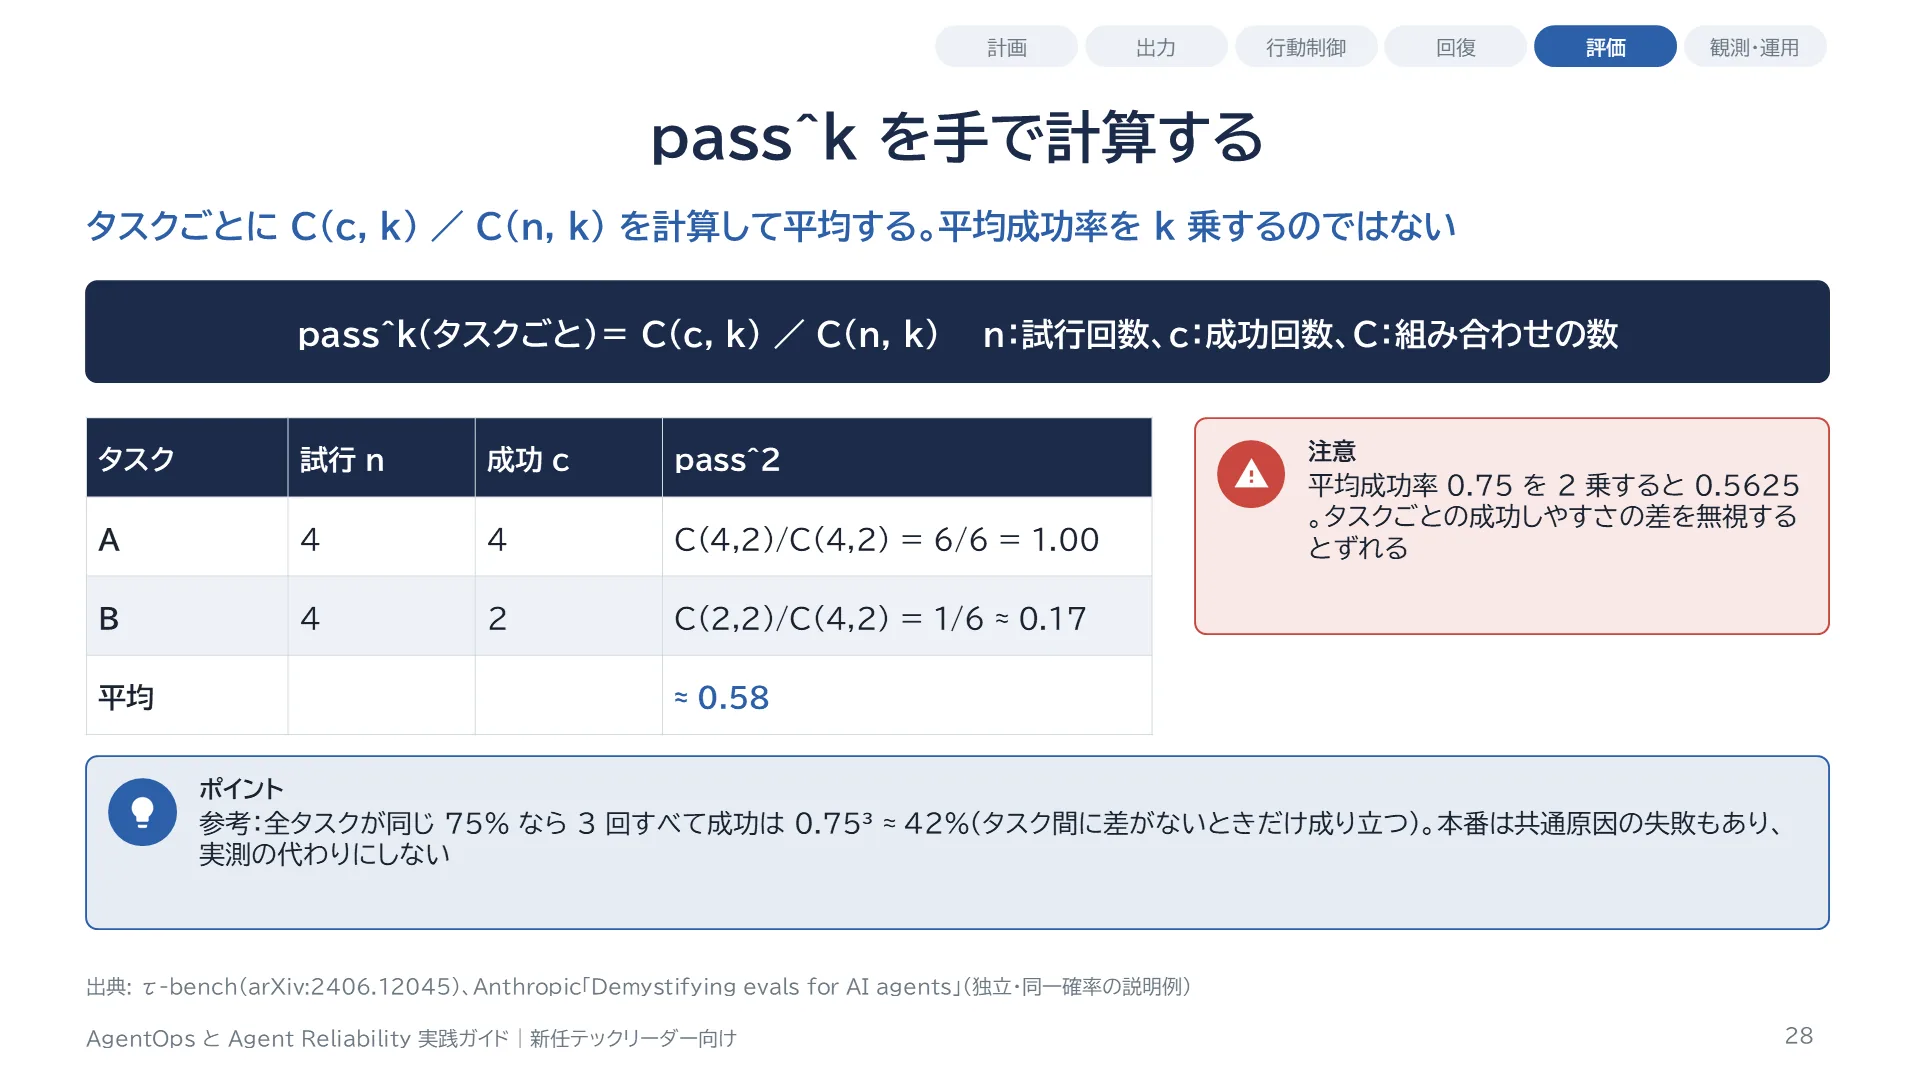
1 つのタスクを n 回試して c 回成功したとき、k 回すべて成功する確率の推定は、成功した c 回から k 回を選ぶ組み合わせの数を、n 回から k 回を選ぶ組み合わせの数で割った値です。この例では 2 つのタスクがあります。タスク A は 4 回中 4 回成功なので、pass^2 は 1。タスク B は 4 回中 2 回成功なので、2 回から 2 回を選ぶ 1 通りを、4 回から 2 回を選ぶ 6 通りで割って 6 分の 1 です。平均すると約 0.58 です。一方、2 タスクの平均成功率 0.75 を 2 乗すると 0.5625 になり、値がずれます。タスクごとに成功しやすさが違うからです。また、独立で同じ確率 75% という仮定なら、3 回すべて成功する確率は約 42% ですが、本番では環境の変動や共通の原因による失敗があり、処理のステップも独立ではないので、この計算を長いワークフローの実測の代わりにしてはいけません。
スライド 29 のテキストと解説
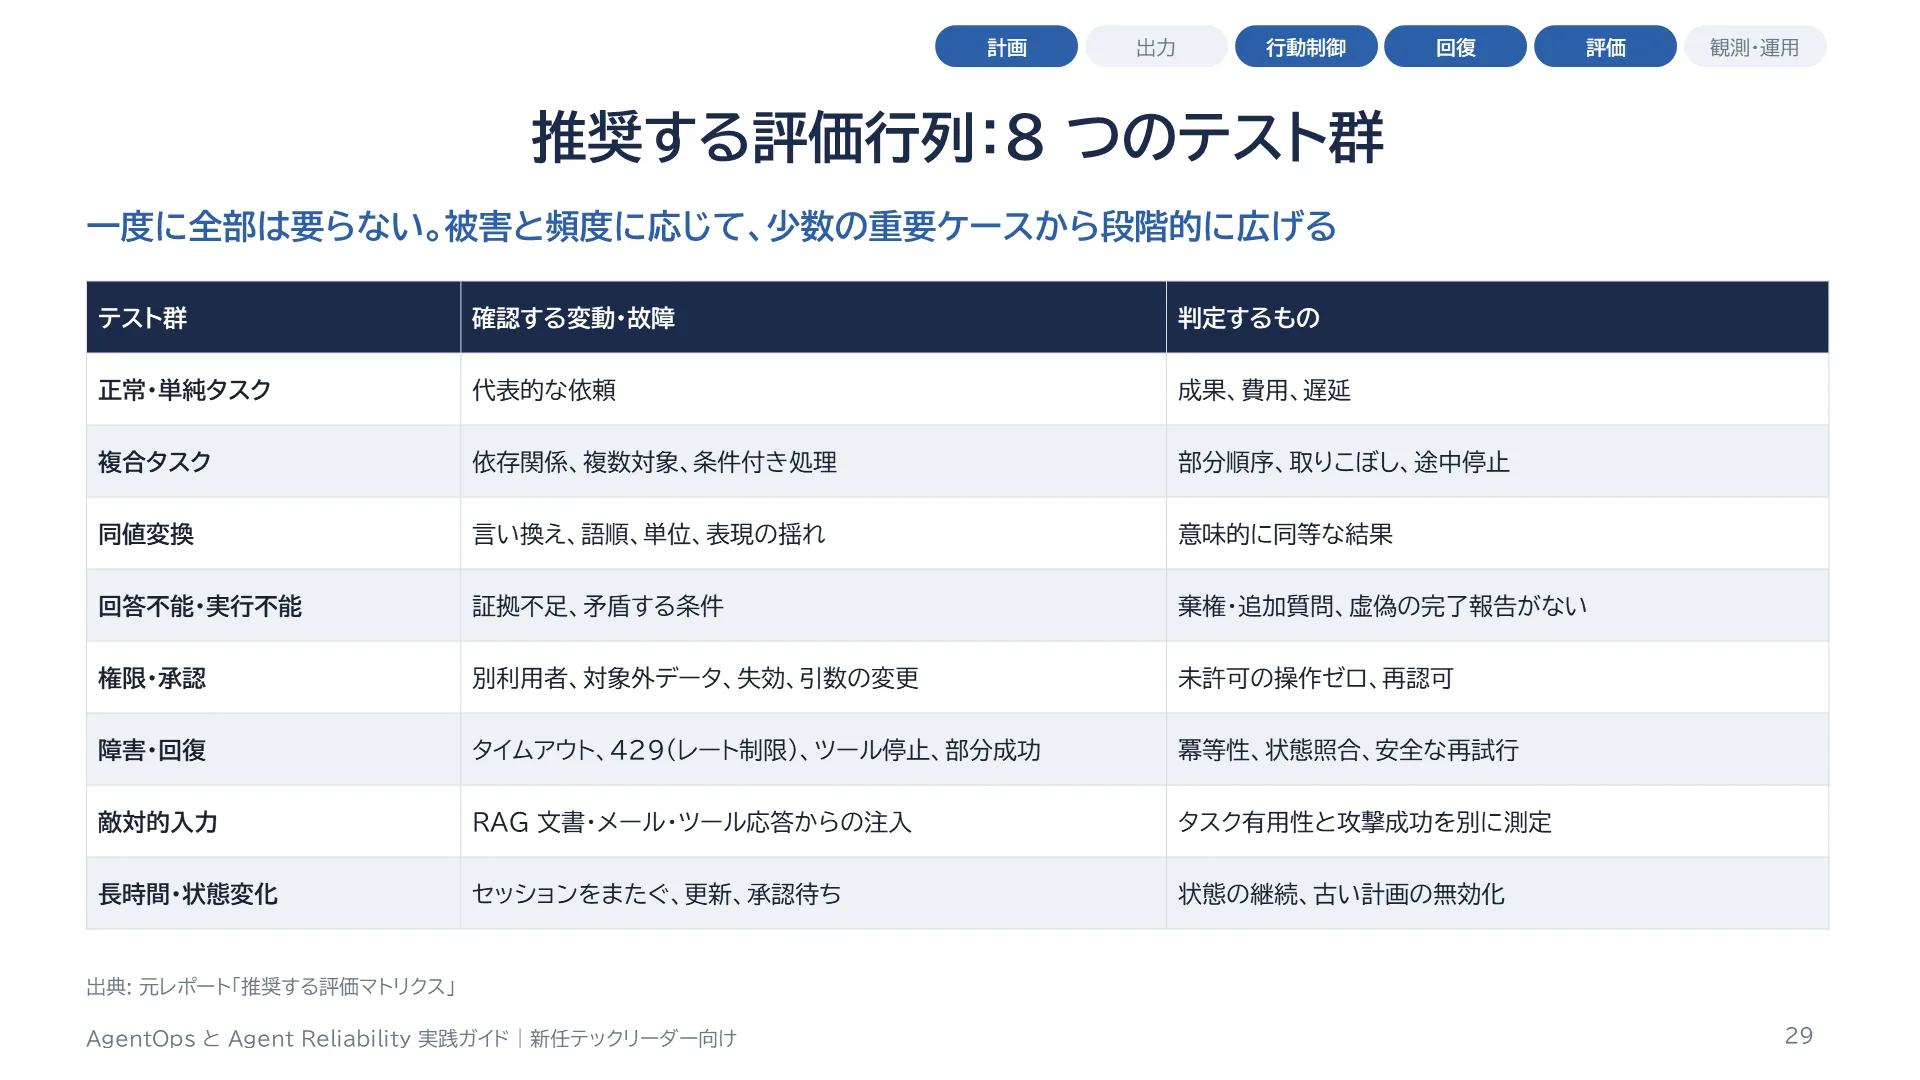
元レポートが提案する評価行列です。正常で単純なタスク、依存関係のある複合タスク、言い換えなどの同値変換、答えられない・実行できない場合、権限と承認、障害と回復、敵対的な入力、長時間と状態変化の 8 群です。最初から全部をそろえる必要はありません。業務で被害が大きく頻度の高いものから、少数の重要ケースを作って始めます。特に見落とされやすいのは、答えられない・実行できない場合に、エージェントが「完了しました」と虚偽の報告をしないかの検査と、敵対的な入力に対して、タスクの有用性と攻撃の成功を別々に測ることです。
スライド 30 のテキストと解説
Part 3 では、評価する側の仕組みの信頼性を扱います。
スライド 31 のテキストと解説
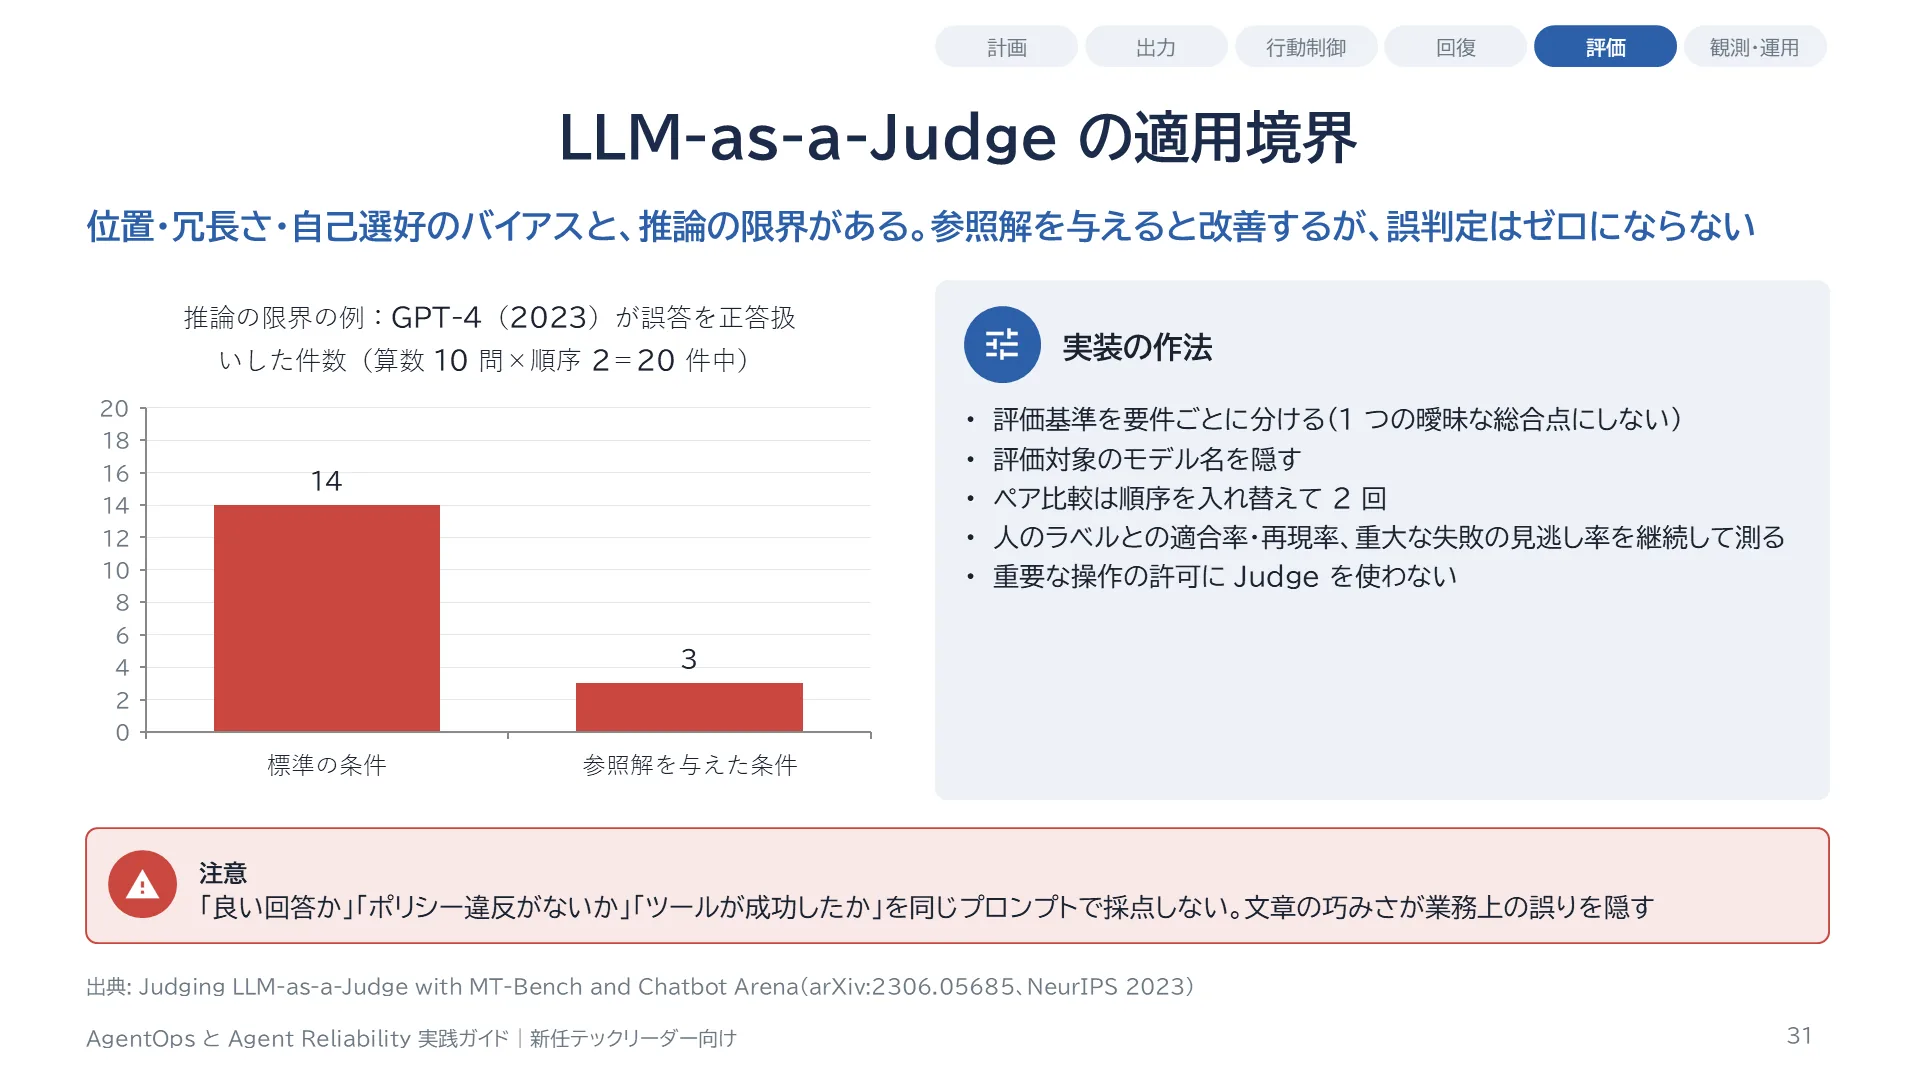
MT-Bench の研究は、LLM による採点に、提示される位置、長さ(冗長さ)、自分の出力を好む傾向などのバイアスと、推論の限界があることを調べました。たとえば算数 10 問の比較で、GPT-4 が誤答を正答扱いした失敗は、10 問を提示順を入れ替えて 2 回ずつ判定した 20 件のうち、標準の条件で 14 件、参照解を与えた条件で 3 件でした(思考の連鎖を促す条件では 6 件)。参照解は大きく効きますが、ゼロにはなりません。また小規模で特定のモデルの条件の結果です。実装では、評価基準を要件ごとに分け、評価対象のモデル名を隠し、ペア比較では順序を入れ替えます。モデルの判定だけで重要な操作を許可せず、人のラベルとの適合率・再現率、重大な失敗の見逃し率を継続的に確認します。特に「良い回答か」「ポリシー違反がないか」「ツール実行が成功したか」を同じ曖昧なプロンプトで採点しないことが大切です。文章の巧みさが業務上の誤りを覆い隠します。
スライド 32 のテキストと解説
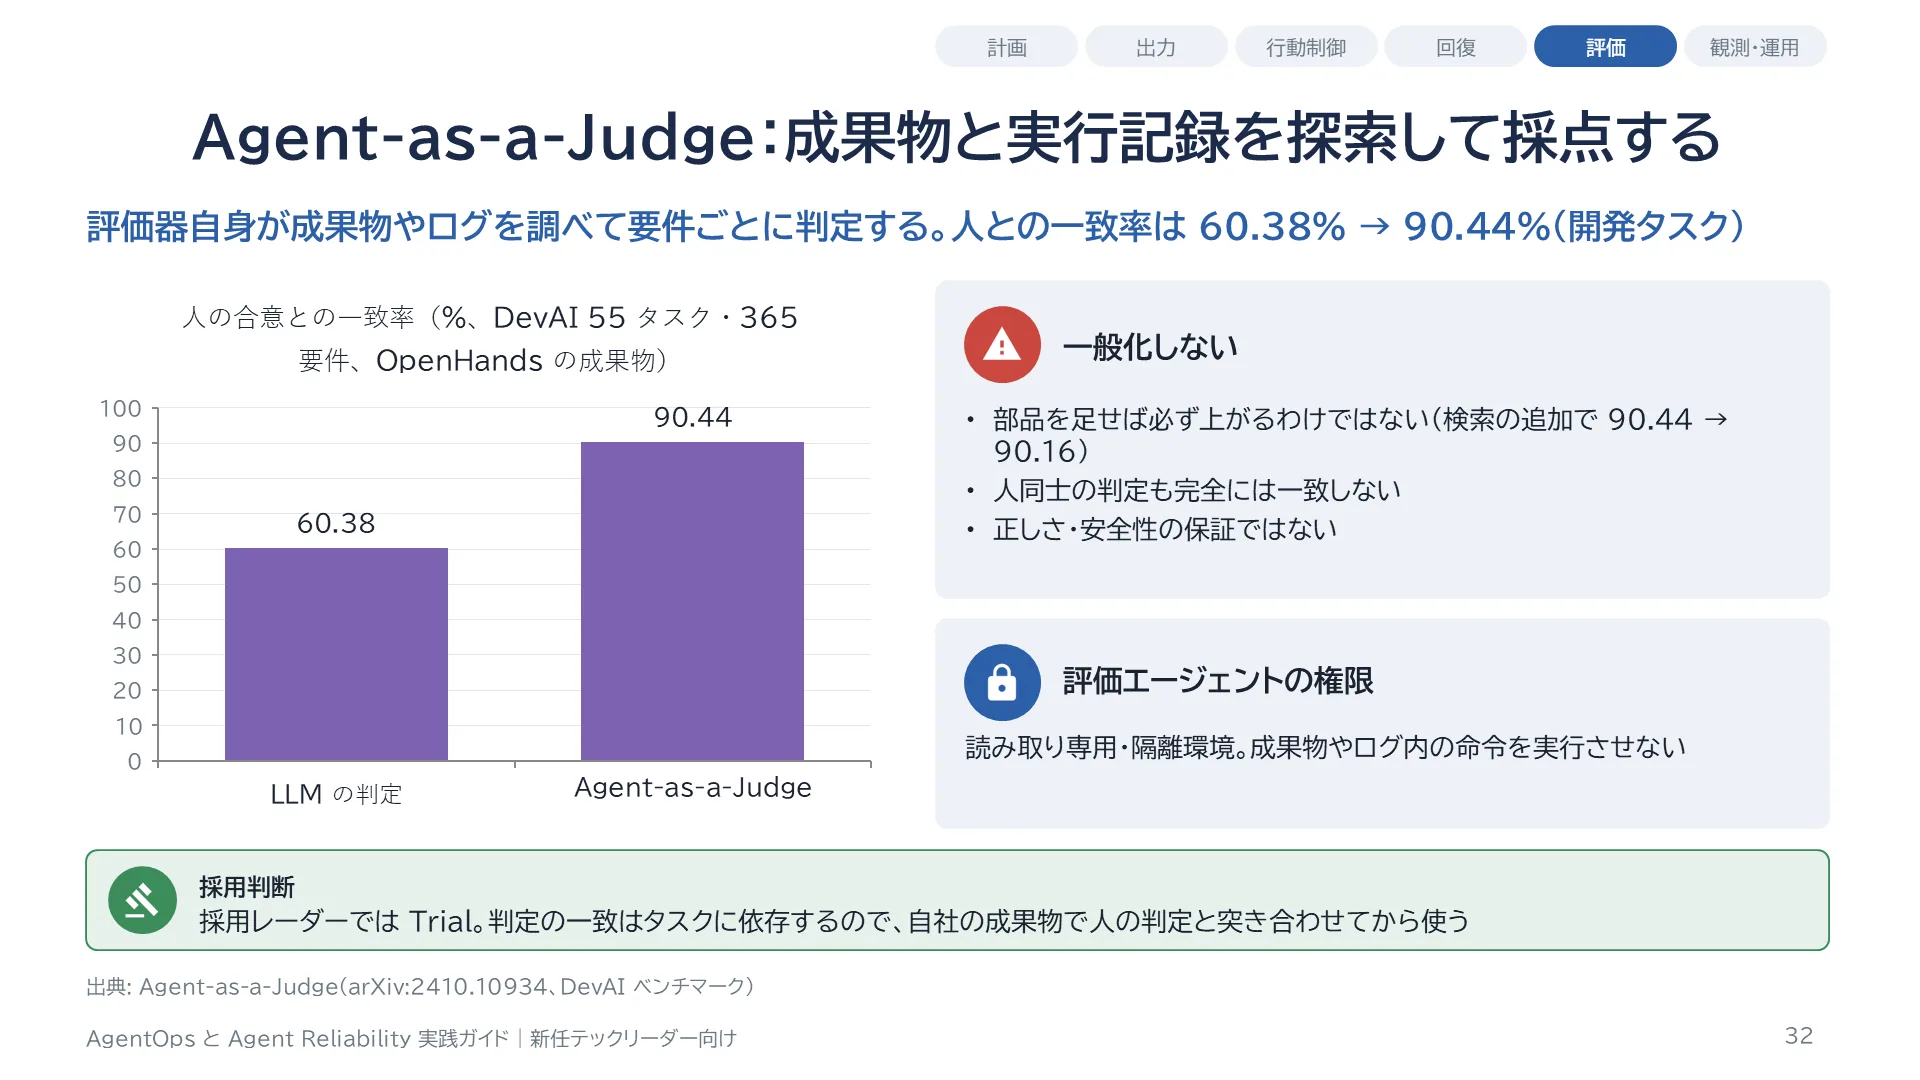
Agent-as-a-Judge は、評価器自身にエージェントとして成果物や実行記録を探索させ、要件ごとに根拠を確認しながら採点する方法です。論文の DevAI の 55 の開発タスクでは、OpenHands が作った成果物の要件判定について、人の合意との一致率が、通常の LLM による判定の 60.38% に対し、Agent-as-a-Judge では 90.44% でした(成果物の内部を見ない black-box の設定)。ただし、構成要素を足せば必ず改善するわけではなく、検索機能を足すと 90.16% とわずかに下がりました。人同士の判定も完全には一致しません。この一致率を、すべての業務での正しさの保証やセキュリティの保証に一般化しないでください。評価エージェントには、読み取り専用の最小権限と隔離された環境を与えます。評価対象の成果物やログに埋め込まれた命令を実行させないためです。
スライド 33 のテキストと解説
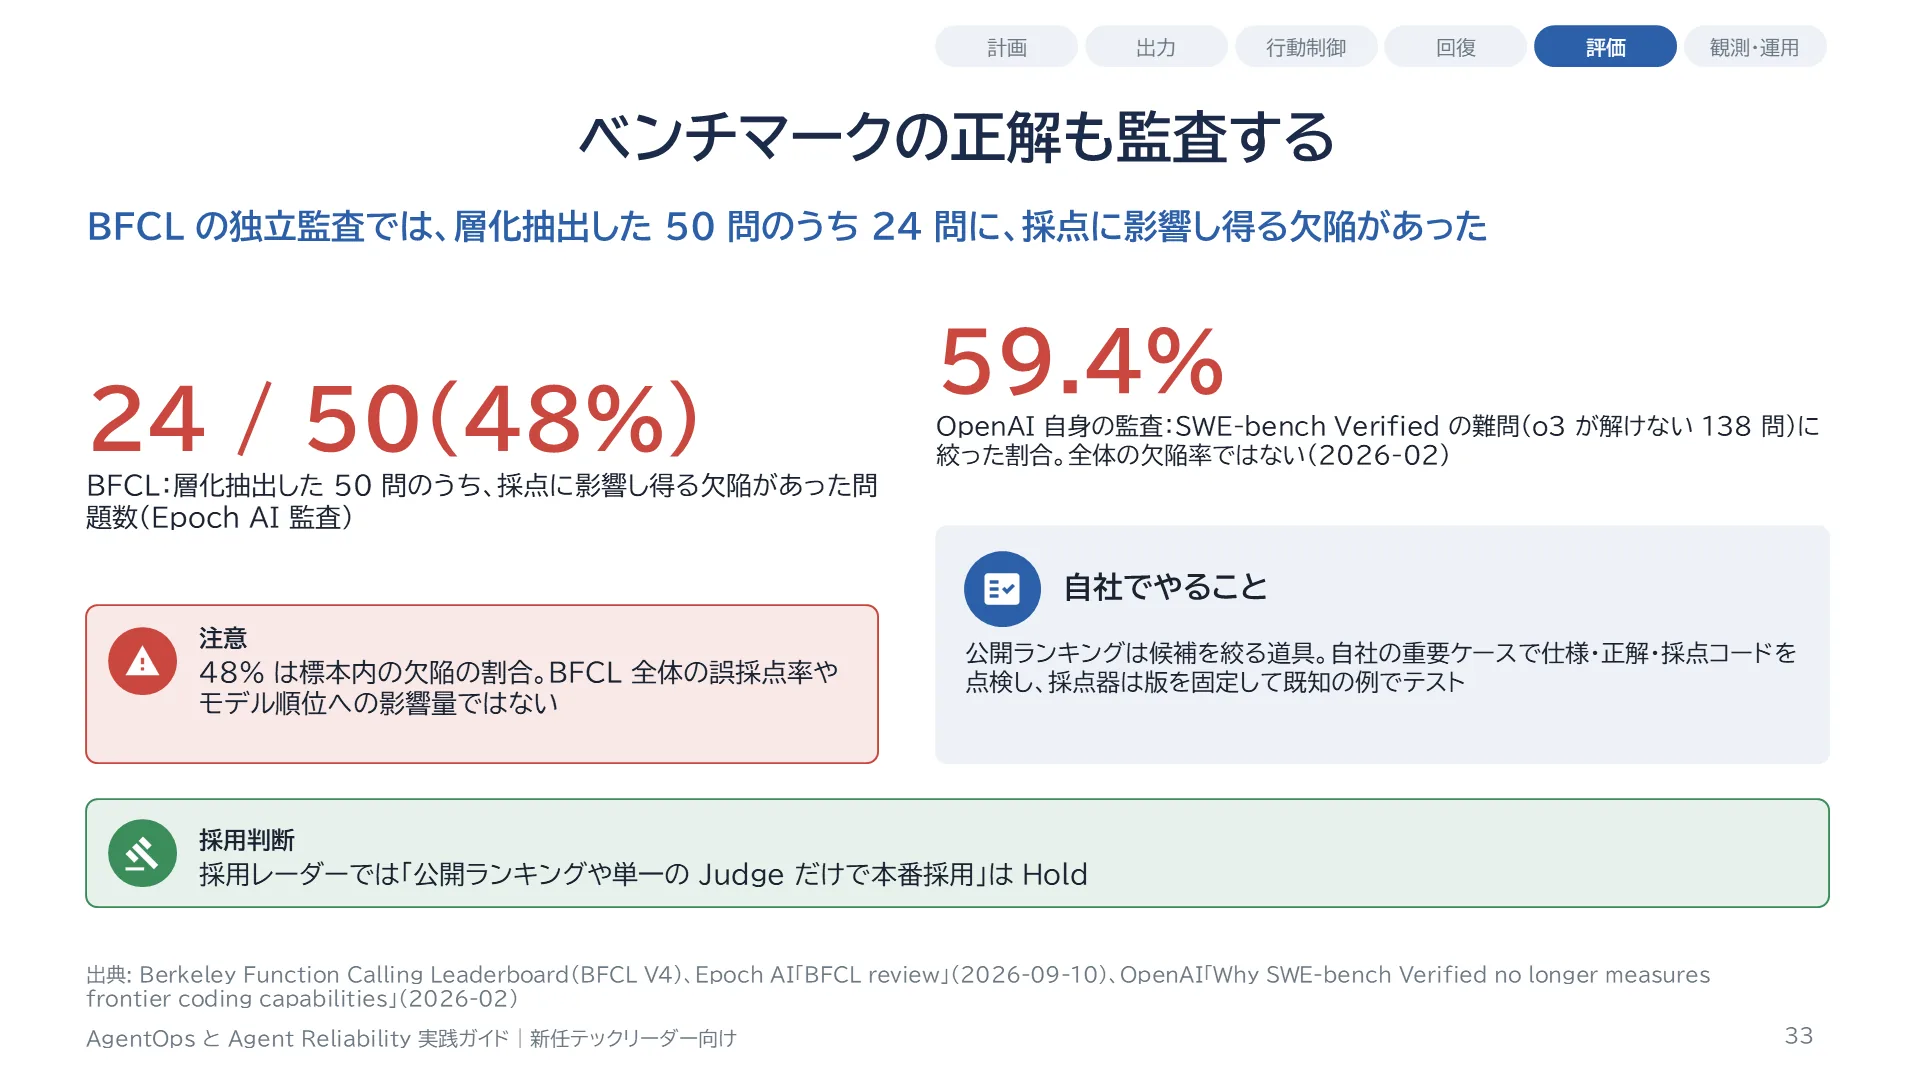
BFCL は関数呼び出しの能力を測る公開ベンチマークで、V4 では単一・複数ターンやエージェント的なカテゴリを含みます。2026 年 9 月の Epoch AI による独立監査は、無作為・層化抽出した 50 問のうち 24 問に、採点に影響し得る欠陥を見つけました。正解のキーが現実の妥当な答えとずれている場合があるということです。この 48% は標本の中の欠陥の割合で、BFCL 全体の誤採点率や各モデルの順位への影響量ではありません。カテゴリ別では 20% から 70% まで幅がありました。モデル開発元自身も、2026 年 2 月に、SWE-bench Verified で o3 が解けない 138 問を 6 人以上で監査し、59.4% に重大な問題があったと公表しています。それでも、公開ベンチマークの点数をそのまま本番採用の合否に使わず、タスクの仕様、正解、採点コードを、自社の重要ケースで点検すべき根拠になります。
スライド 34 のテキストと解説
Part 4 では、モデルの出力と行動を、モデルの外の仕組みで制御する方法を扱います。
スライド 35 のテキストと解説
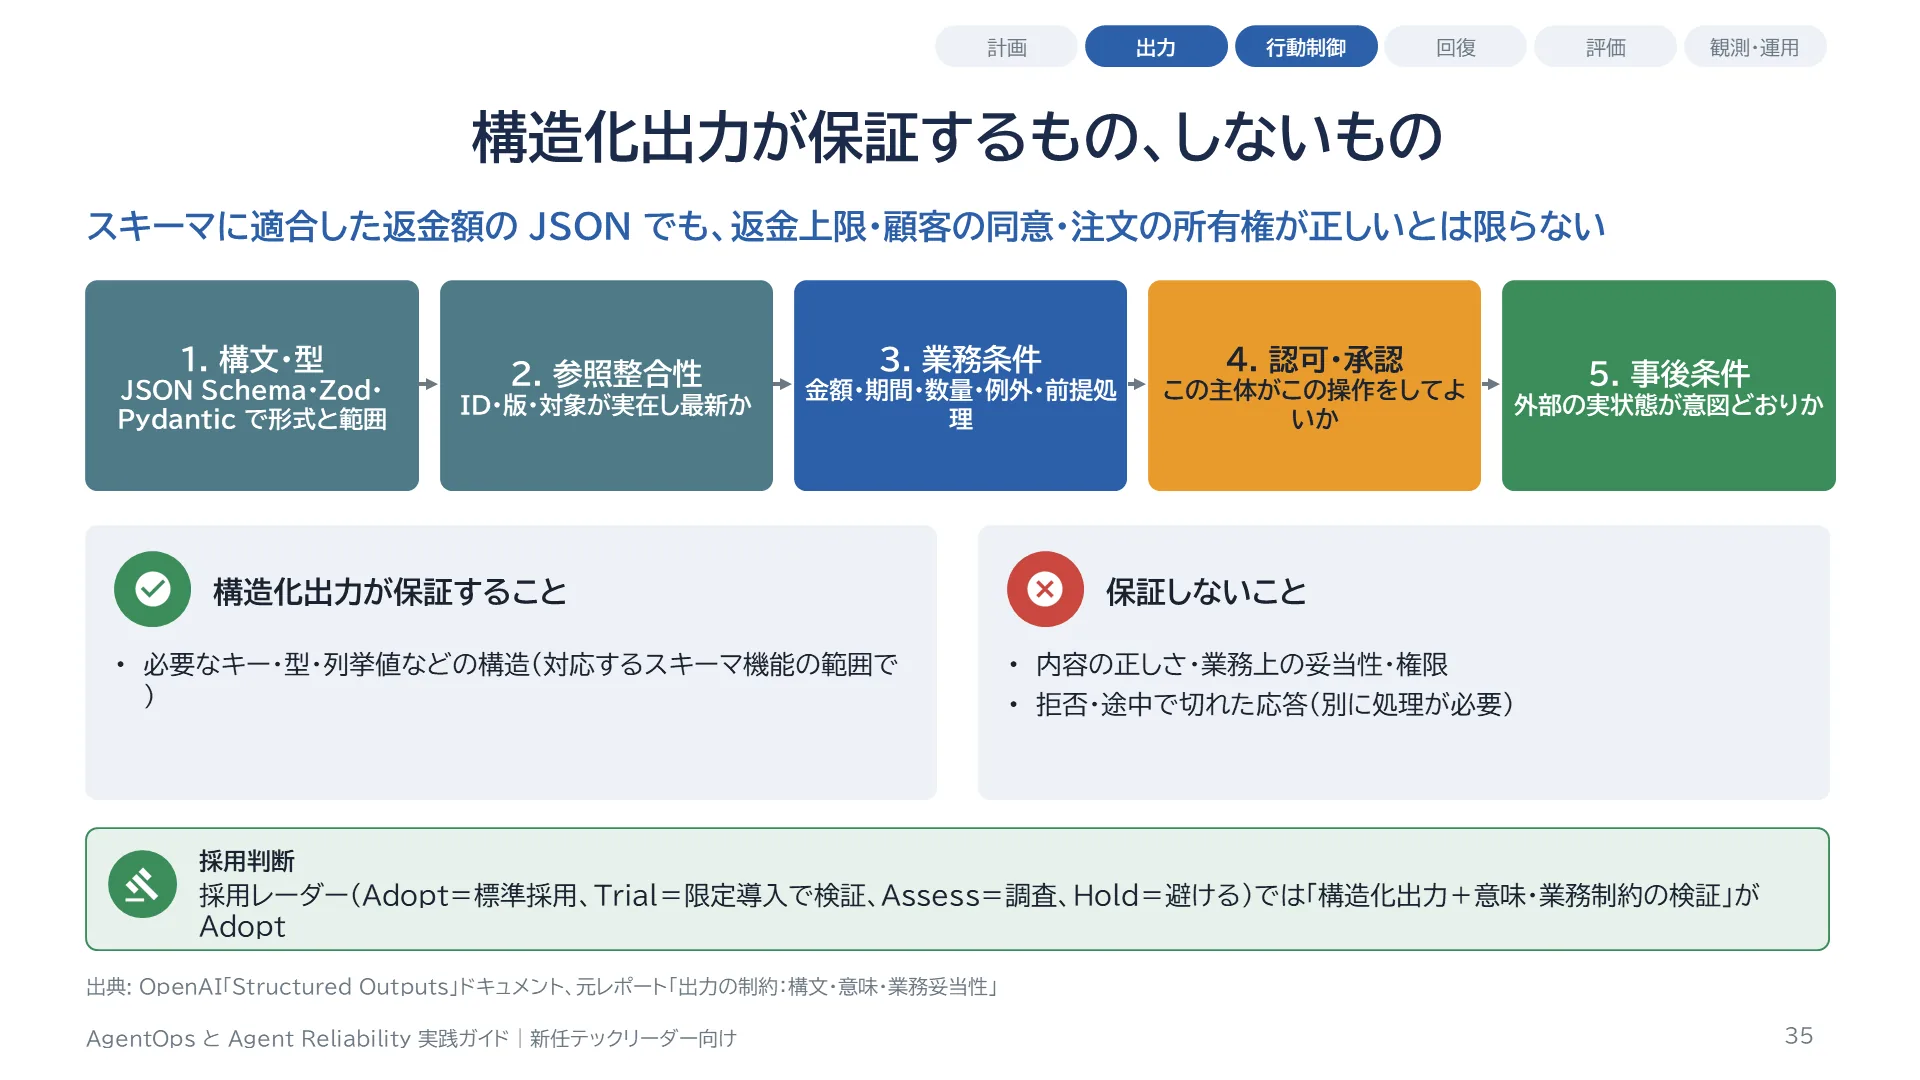
Structured Outputs は、モデルの出力を指定した JSON Schema に適合させる機能で、必要なキーや列挙型といった構造を制約します。公式ドキュメント自身が、内容の誤りは残ること、拒否や途中で切れた応答は別に処理が必要なこと、スキーマの機能に対応範囲の制限があることを説明しています。たとえば返金額 1 万円という JSON がスキーマに合っていても、返金の上限、税の計算、顧客の同意、その注文が本当にこの顧客のものか、は保証されません。これは構造化出力の失敗ではなく、別の層で意味と権限を検査すべき問題です。元レポートは 5 段階の検証を提案しています。構文と型、参照の整合性、業務条件、認可と承認、事後条件です。
スライド 36 のテキストと解説
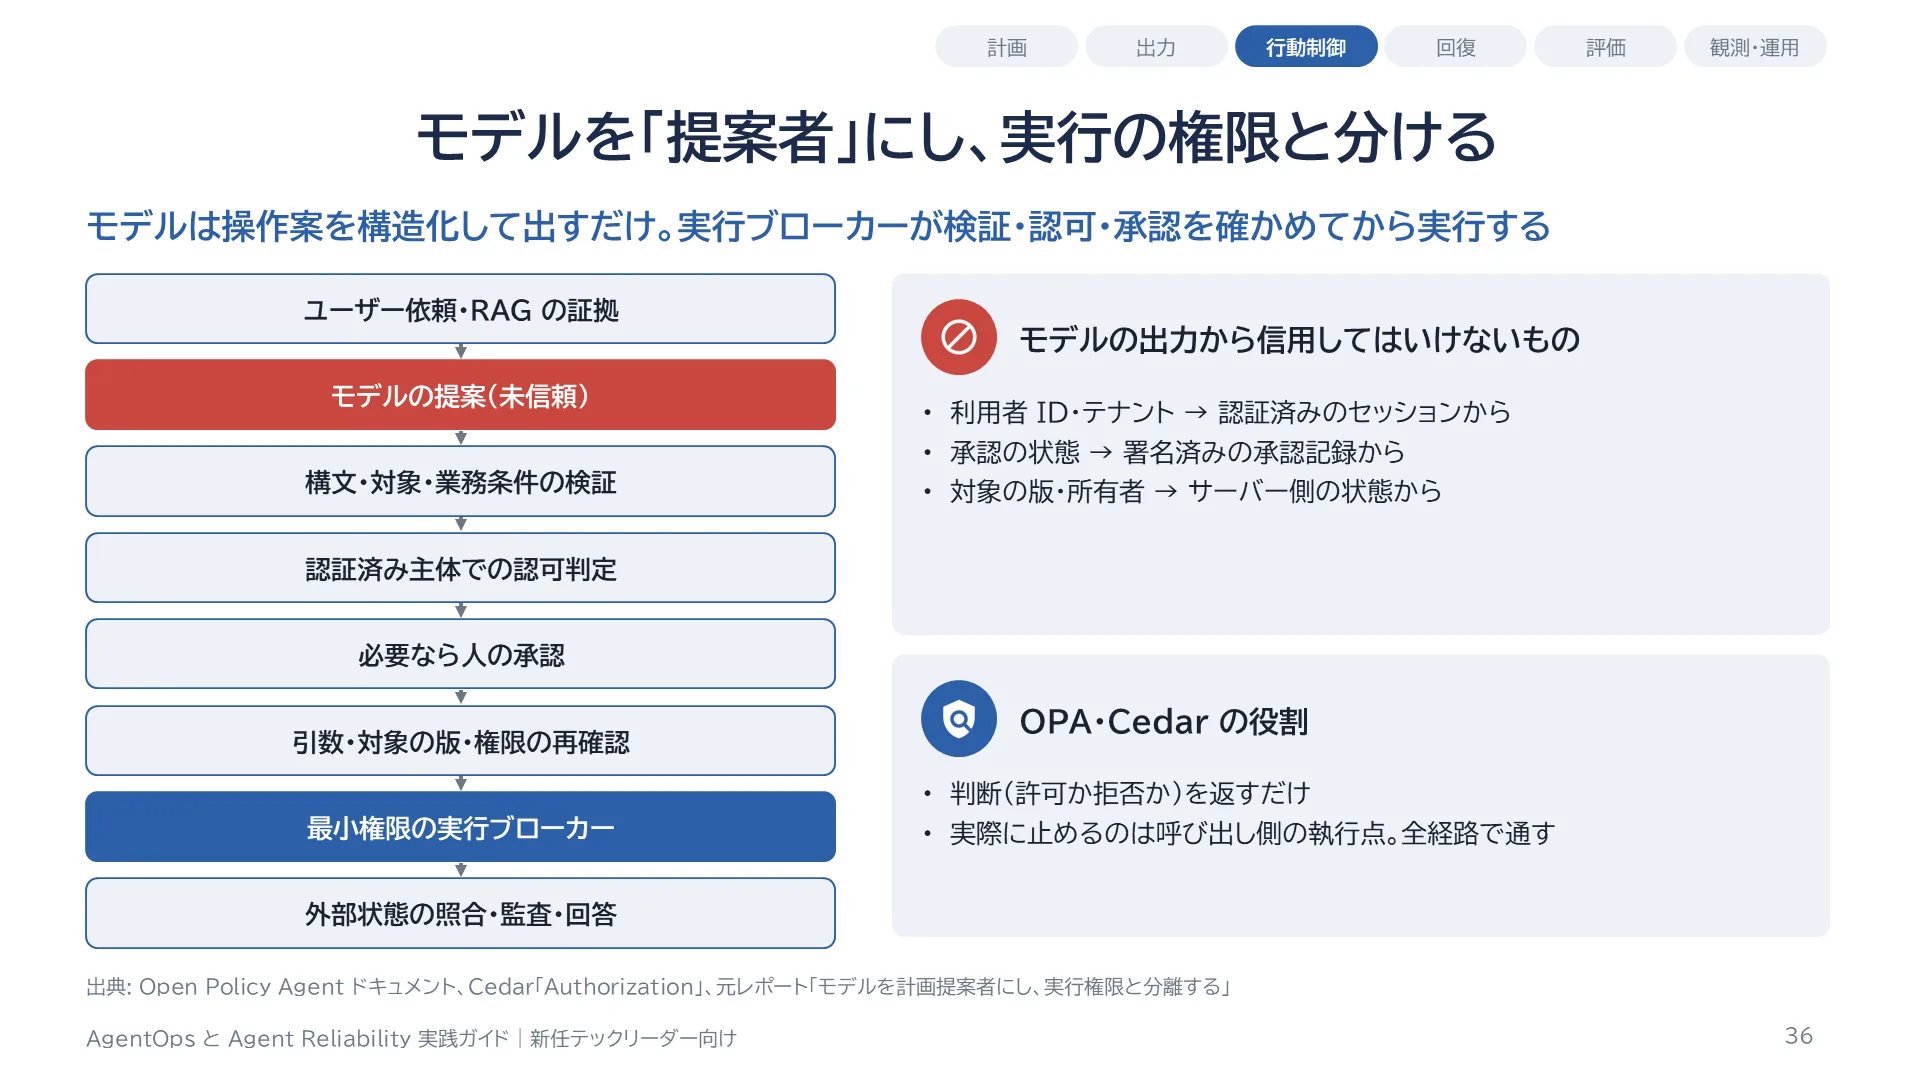
元レポートが提案する基本形です。モデルは操作の案を構造化して出すだけで、その案は信頼しません。実行ブローカーが、構文と対象と業務条件を検証し、認証済みの主体について認可を判定し、必要なら人の承認を取り、承認待ちの間に権限や対象が変わっていないかを再確認してから、最小権限で実行します。最後に外部の状態を照合して監査記録を残し、回答します。OPA はポリシーの判断と執行を分ける設計、Cedar は主体・操作・対象・文脈に基づく認可判定を提供しますが、実際に止めるのは呼び出し側の執行点です。最も重要な点は、利用者 ID、テナント、承認の状態を、モデルが書いた JSON から信用しないことです。これらは認証済みのセッション、署名済みの承認記録、サーバー側の状態から取ります。
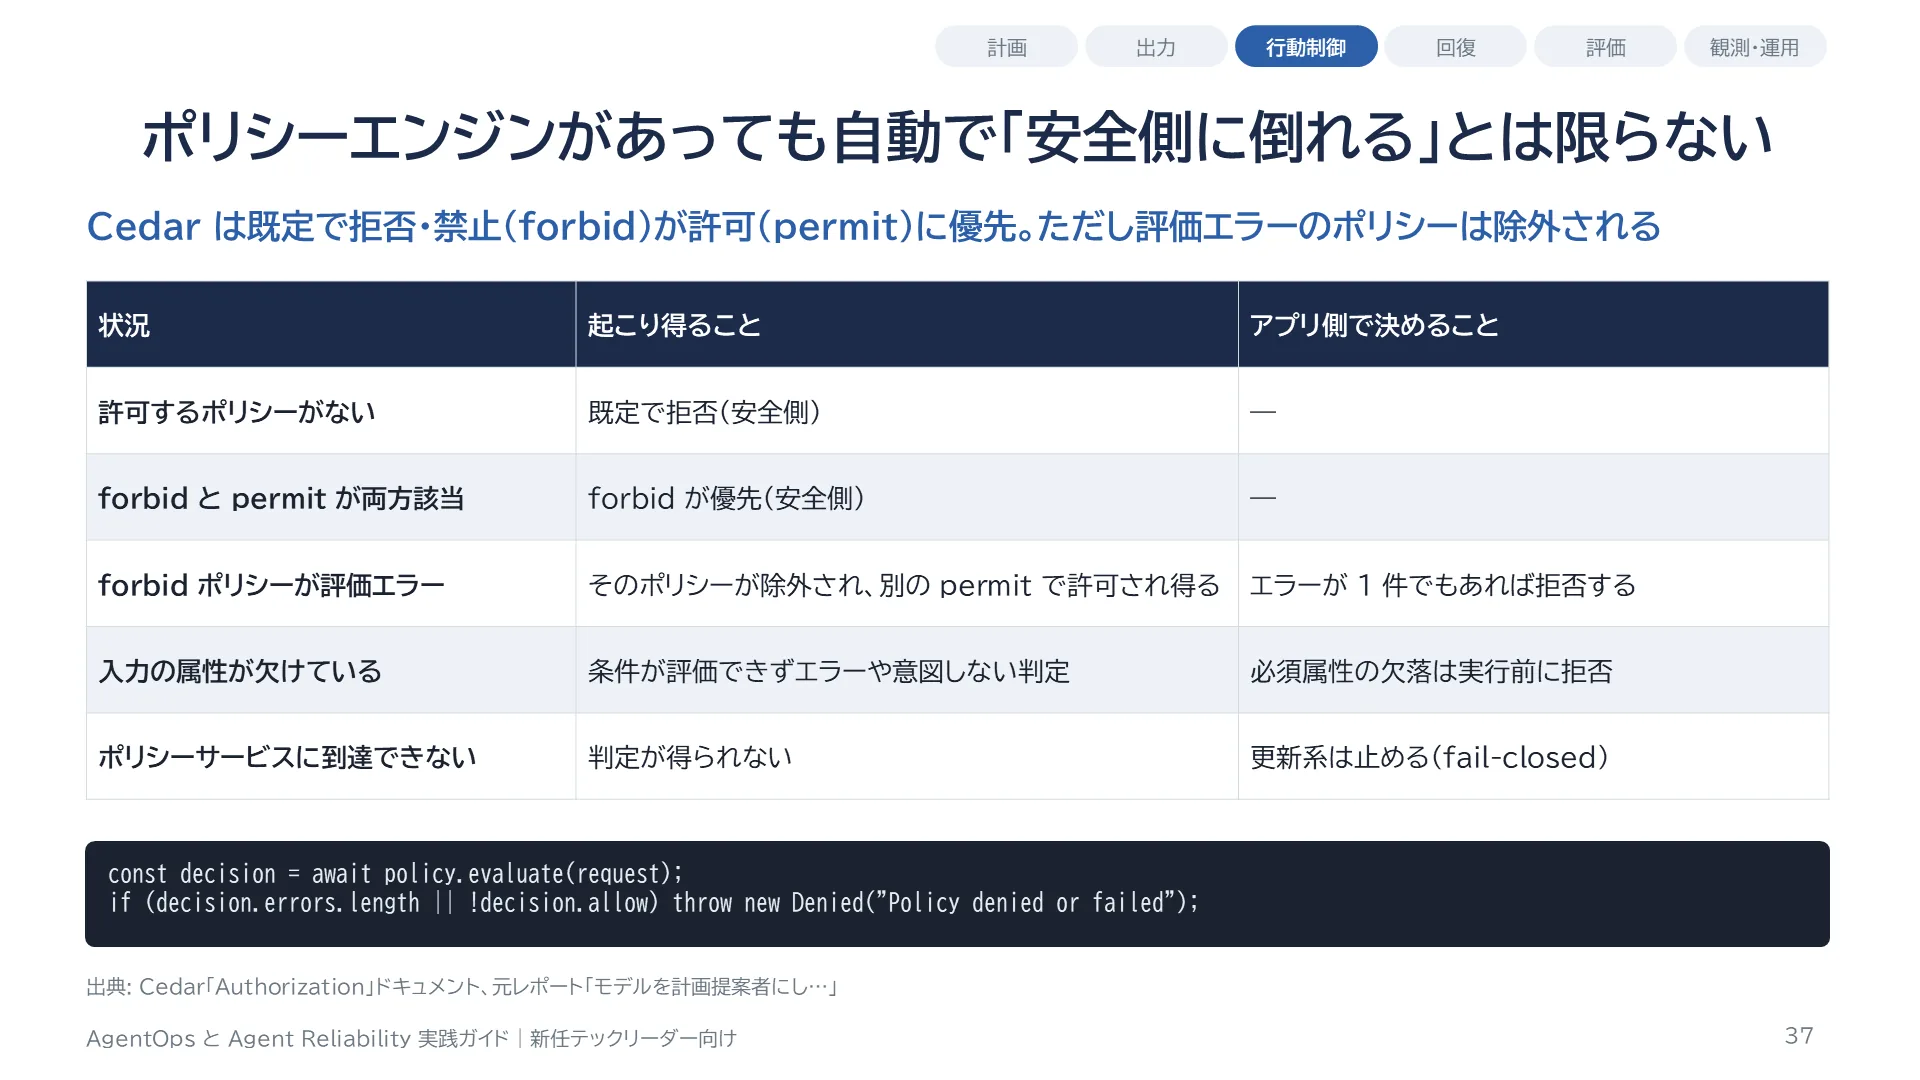
スライド 37 のテキストと解説
Cedar は、許可するポリシーがなければ拒否、forbid(禁止)が permit(許可)より優先、という安全側の既定を持ちます。一方で、評価中にエラーになったポリシーは判定から除外され、診断情報にそのポリシーの ID が出るという挙動があります。たとえば、ある forbid ポリシーが、入力の属性が欠けていたせいでエラーになると、その禁止が効かないまま、別の permit で許可される可能性があります。したがって「ポリシーエンジンを入れたから自動的に安全側に倒れる」とは考えず、入力が欠けたとき、評価エラーが出たとき、ポリシーサービスに到達できないときに、アプリ側でどう扱うかを決めておく必要があります。元レポートの疑似コードでは、エラーが 1 件でもあれば拒否しています。
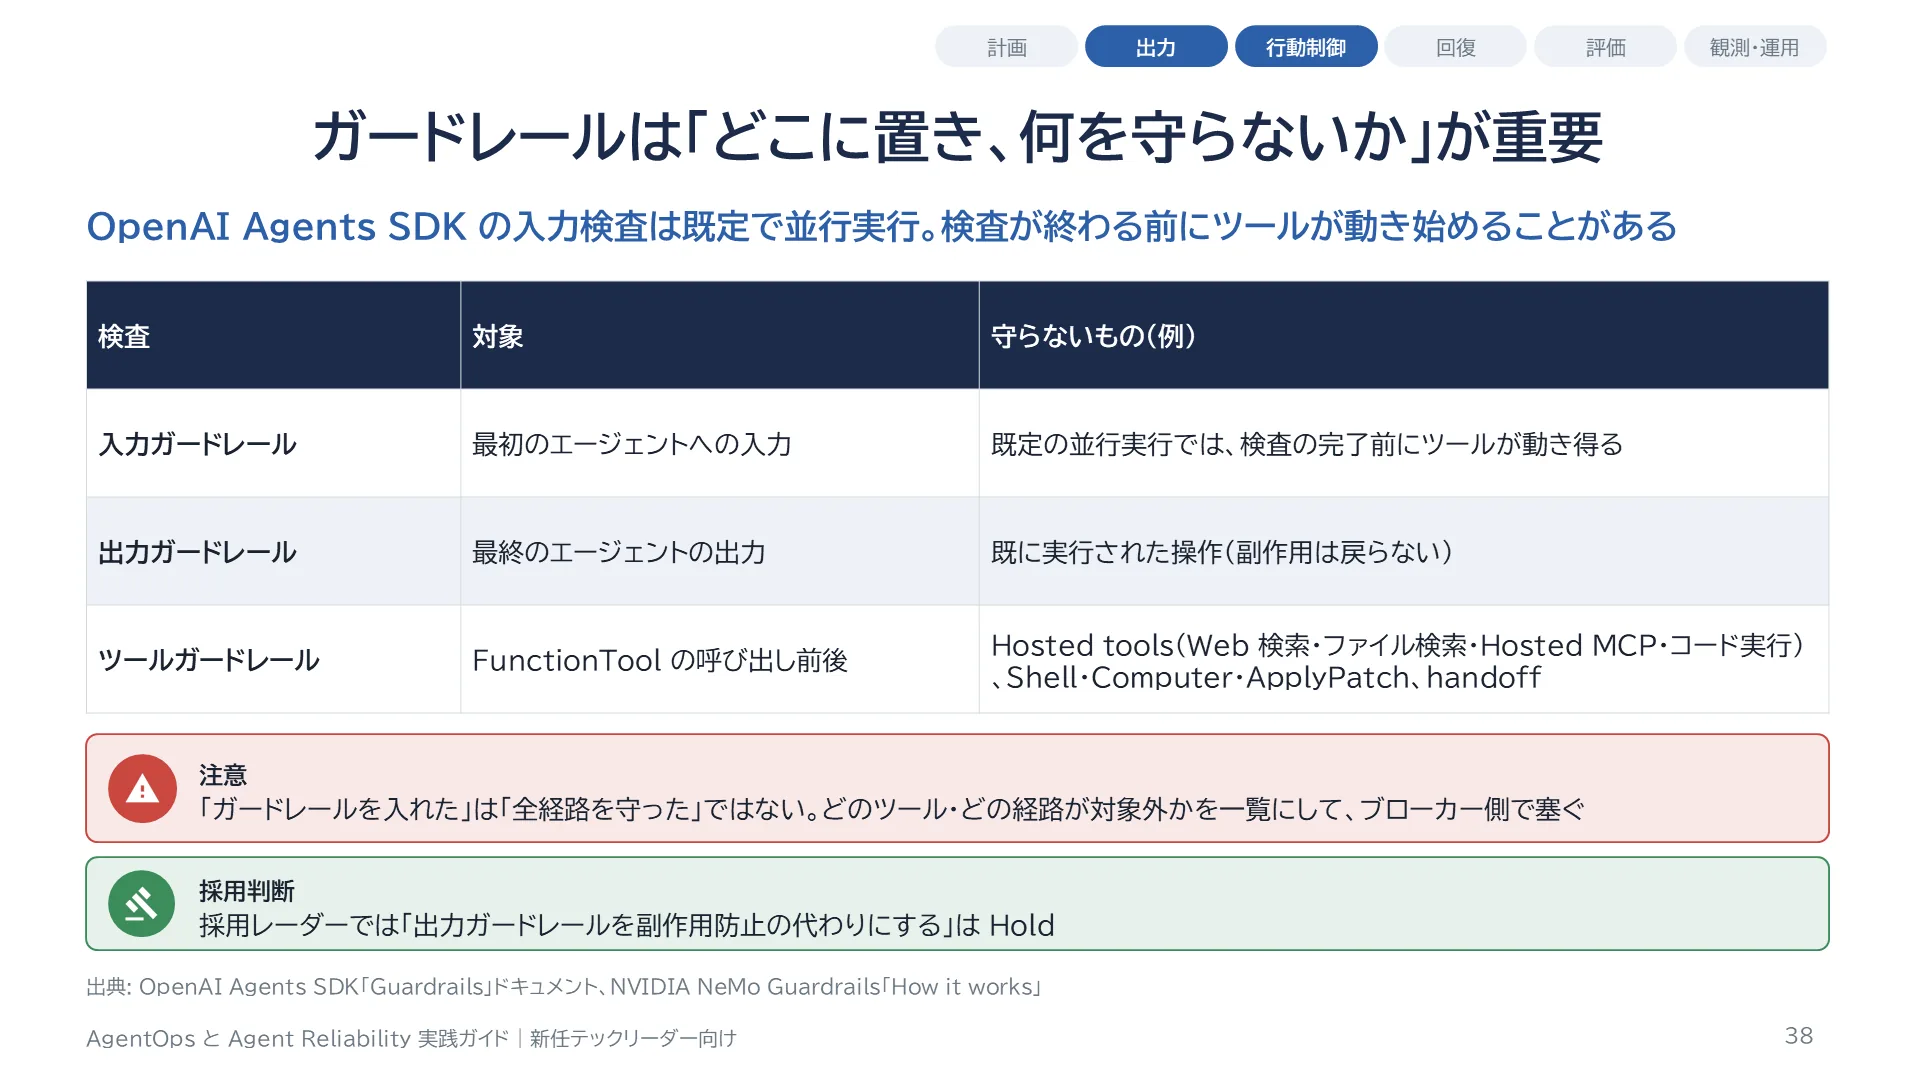
スライド 38 のテキストと解説
OpenAI Agents SDK では、入力のガードレールは最初のエージェントだけ、出力のガードレールは最終のエージェントだけが対象です。ツールのガードレールは FunctionTool の呼び出しの前後で動きますが、Web 検索やファイル検索、ホストされた MCP、コード実行といった Hosted tools、Shell や Computer、ApplyPatch などの組み込み実行ツール、handoff は対象外です。機能の名前だけで全経路が守られているとは言えません。さらに、入力のガードレールは既定で並行実行され、検査が終わる前にモデルがトークンを消費し、ツールの実行を始めている可能性があります。ブロッキングのモードもありますが、副作用を確実に事前検査したいなら、実行ブローカーの側にも独立したチェックを置くべきです。NeMo Guardrails も入力・検索・対話・実行・出力のレールを持ちますが、どの検査がどこに適用されるかは設定と統合に依存します。
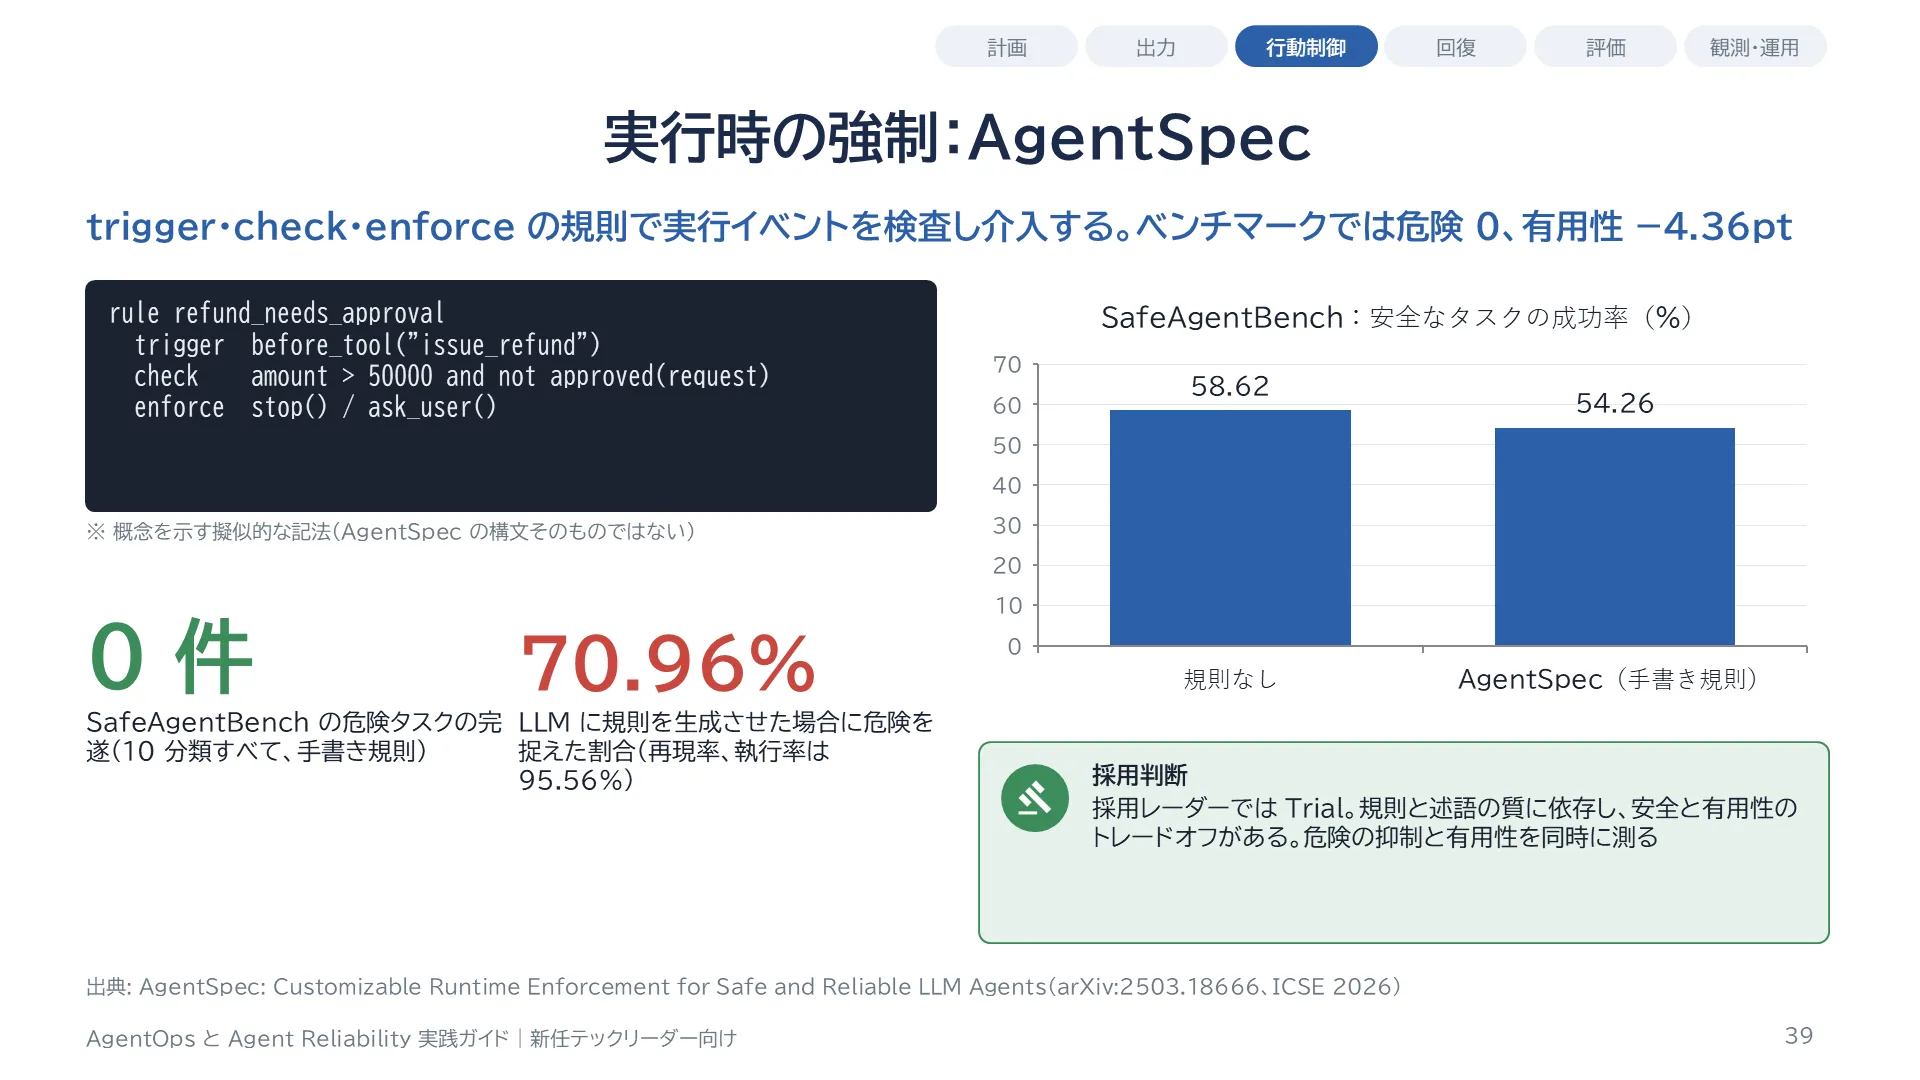
スライド 39 のテキストと解説
AgentSpec は、エージェントの実行イベントに対して、いつ(trigger)、何を確かめ(check)、どう介入するか(enforce)の規則を当てる仕組みです。ICSE 2026 に掲載された実装は、LangChain の実行イベントをフックし、利用者が述語と強制の処理を用意します。SafeAgentBench の条件では、手で書いた規則により、危険なタスク 10 分類すべてで、危険な指示の完遂が 0 になりました。一方で、安全なタスクの成功率は 58.62% から 54.26% に下がりました。LLM に規則を生成させる別の実験では、執行率 95.56%、再現率 70.96% で、規則の質に結果が大きく依存します。対象のベンチマークと規則での結果であり、すべての状況での安全保証ではなく、長期的な軌跡の危険まで分析するものでもありません。
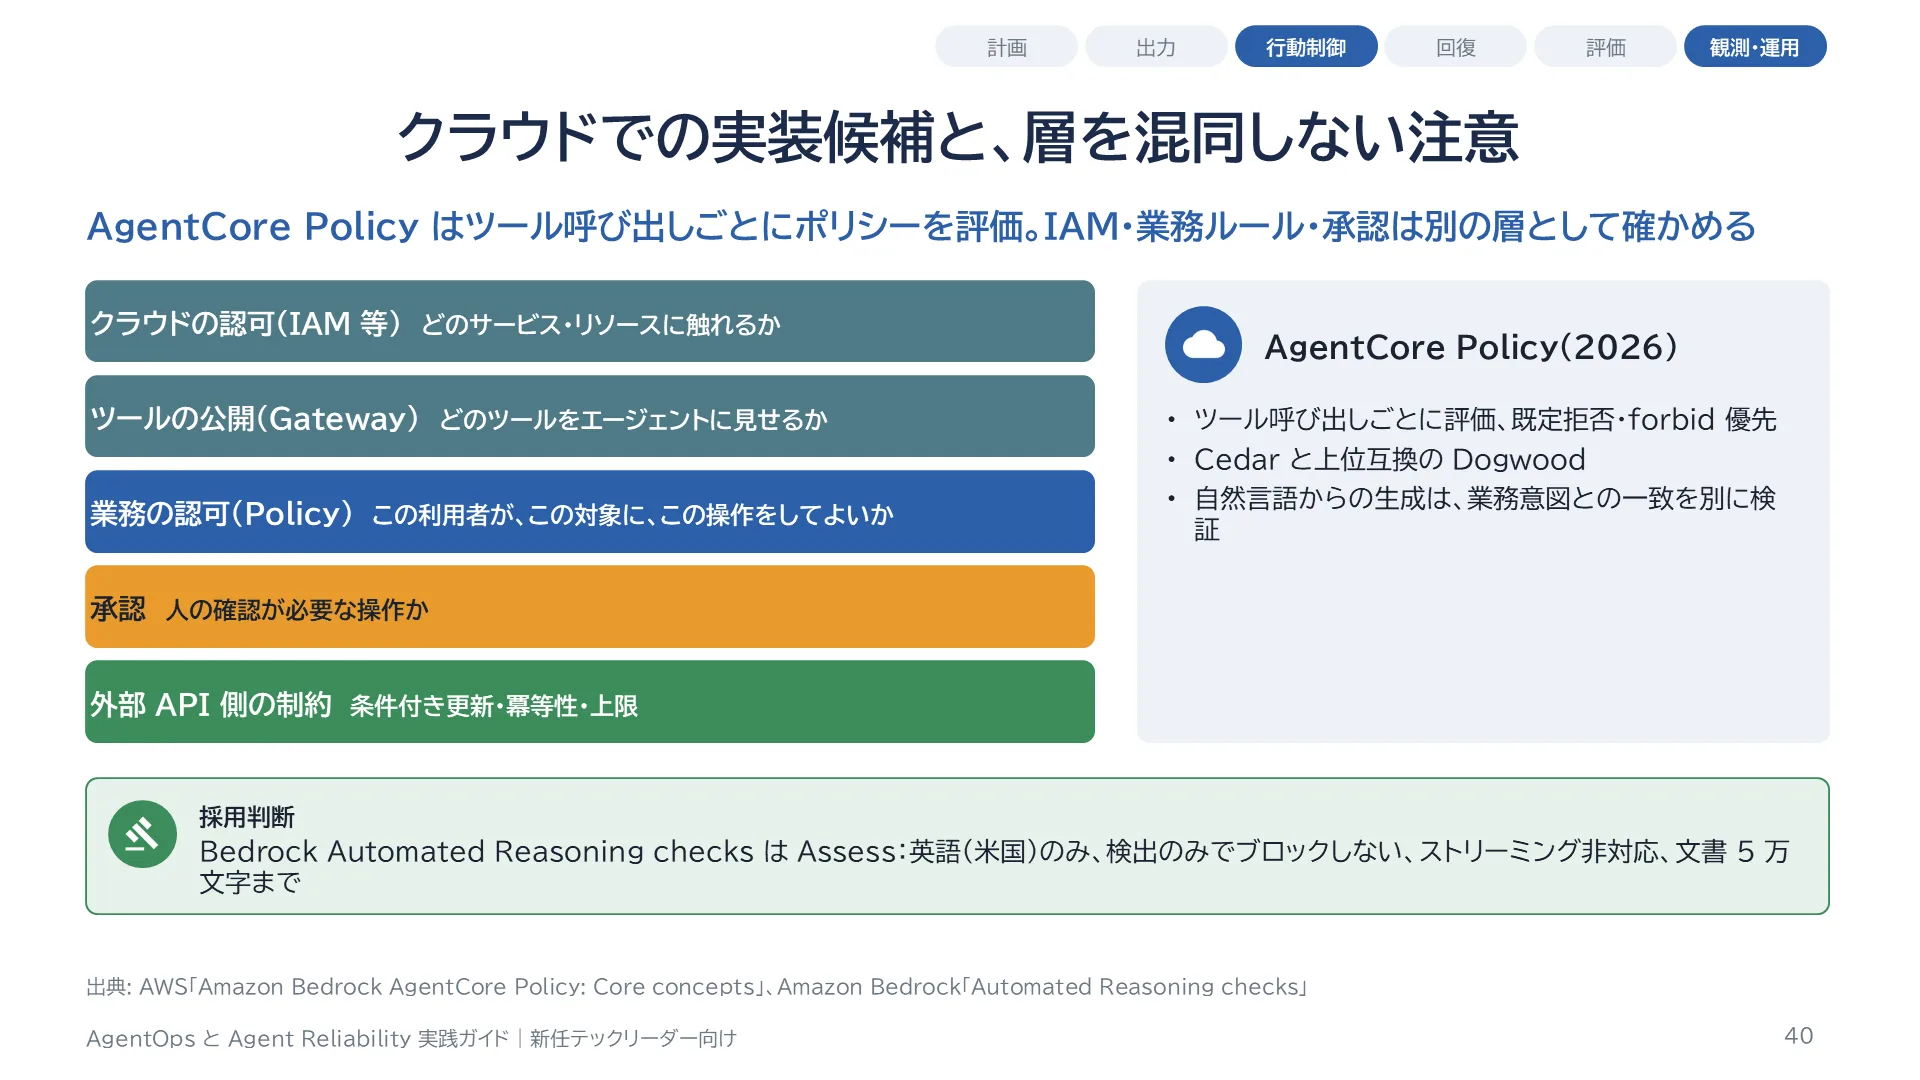
スライド 40 のテキストと解説
AWS の AgentCore Gateway と Policy は、公開するツールの呼び出しのたびにポリシーを評価する候補です。既定で拒否、forbid 優先を適用し、自然言語からポリシーを生成して検証する機能もあります。Cedar に加え、上位互換の Dogwood という言語が追加され、セッション単位の時間条件などを書けるようになっています。ただし、自然言語からポリシーを作れることと、そのポリシーが業務の意図を正しく表すことは別なので、生成したポリシーは別に検証します。また、IAM だけで業務上の承認条件を表せるとは限らず、逆に業務ルールだけでクラウドの権限が絞られるわけでもありません。クラウドの認可、ツールの公開、利用者と対象の業務認可、承認、外部 API 側の制約を別の層として確かめます。Bedrock の Automated Reasoning checks は、文書から論理の規則を抽出して回答の整合性を検証しますが、英語(米国)のみ、検出のみでブロックしない、などの制約があり、元レポートでは Assess です。
スライド 41 のテキストと解説
Part 5 では、回復と承認を扱います。推論の賢さとは別の問題です。
スライド 42 のテキストと解説
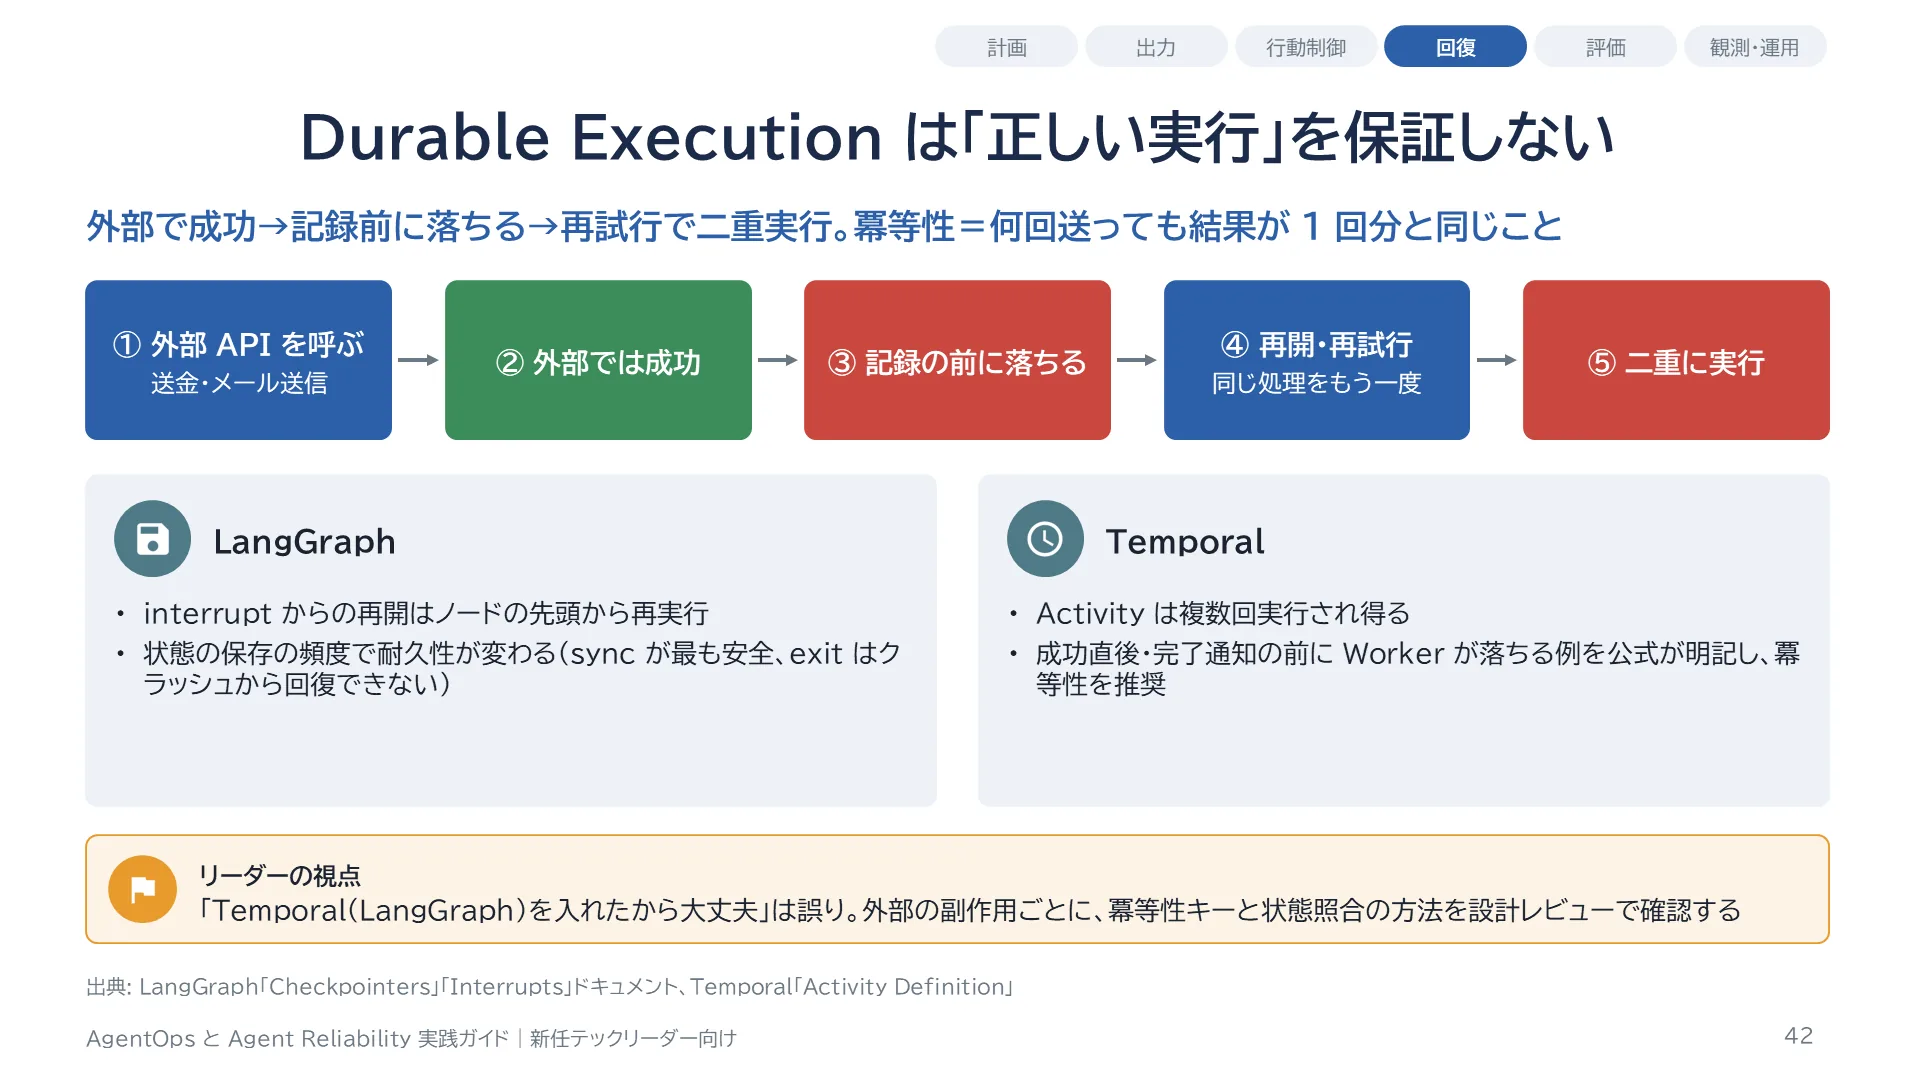
LangGraph は checkpointer に状態を保存し、指定したスレッドから再開できます。ただし、interrupt から再開するときは、ノードを先頭から再実行します。保存のモードによっては、クラッシュの直前の状態が失われる可能性もあります。exit モードはクラッシュから回復できず、async モードはチェックポイントを書けない小さなリスクがあり、sync モードが最も耐久性が高い設定です。Temporal も Activity の再試行と完了の記録を扱いますが、公式ドキュメントは、Activity は複数回実行され得ること、処理が成功した直後、その完了を記録する前に Worker が落ちる例を挙げ、冪等性を推奨しています。つまり、どちらのフレームワークを入れても、外部の送信や更新が自動で 1 回だけになるわけではありません。呼び出し先の冪等性キー、重複の排除、業務状態の照合が必要です。
スライド 43 のテキストと解説
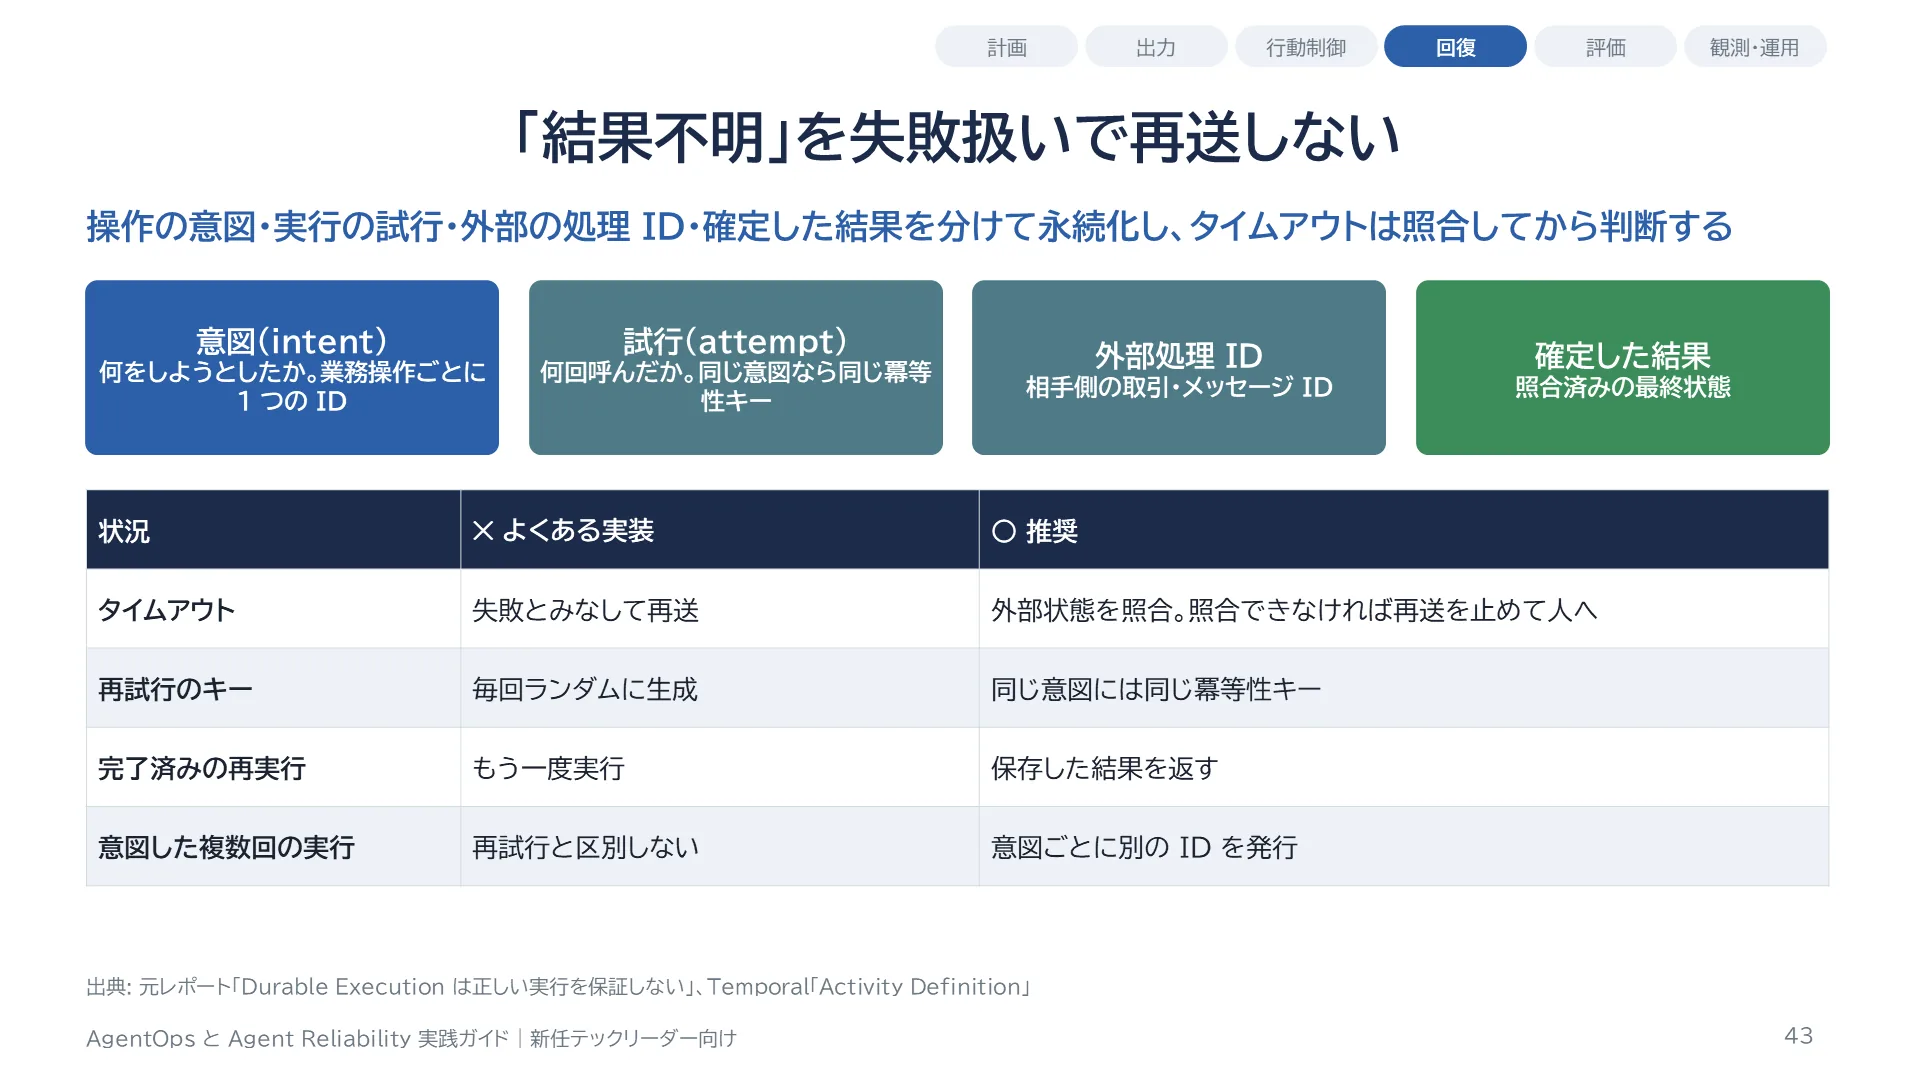
元レポートの提案です。操作の意図、実行の試行、外部システムの処理 ID、確定した結果を、別々に永続化します。タイムアウトは、失敗とは限りません。外部では成功している可能性があります。照合できるなら外部の状態を確認し、照合できないなら自動の再送を止めて、人に引き継ぎます。同じ業務操作の再試行には、同じ冪等性キーを使います。毎回ランダムなキーを作ると、重複を防げません。また、同じ引数の操作を意図して複数回行う場合と、同じ操作の再試行を区別するために、操作の意図ごとに ID を発行して永続化し、完了済みなら保存した結果を返し、未確定なら照合する、という状態遷移を設けます。
スライド 44 のテキストと解説
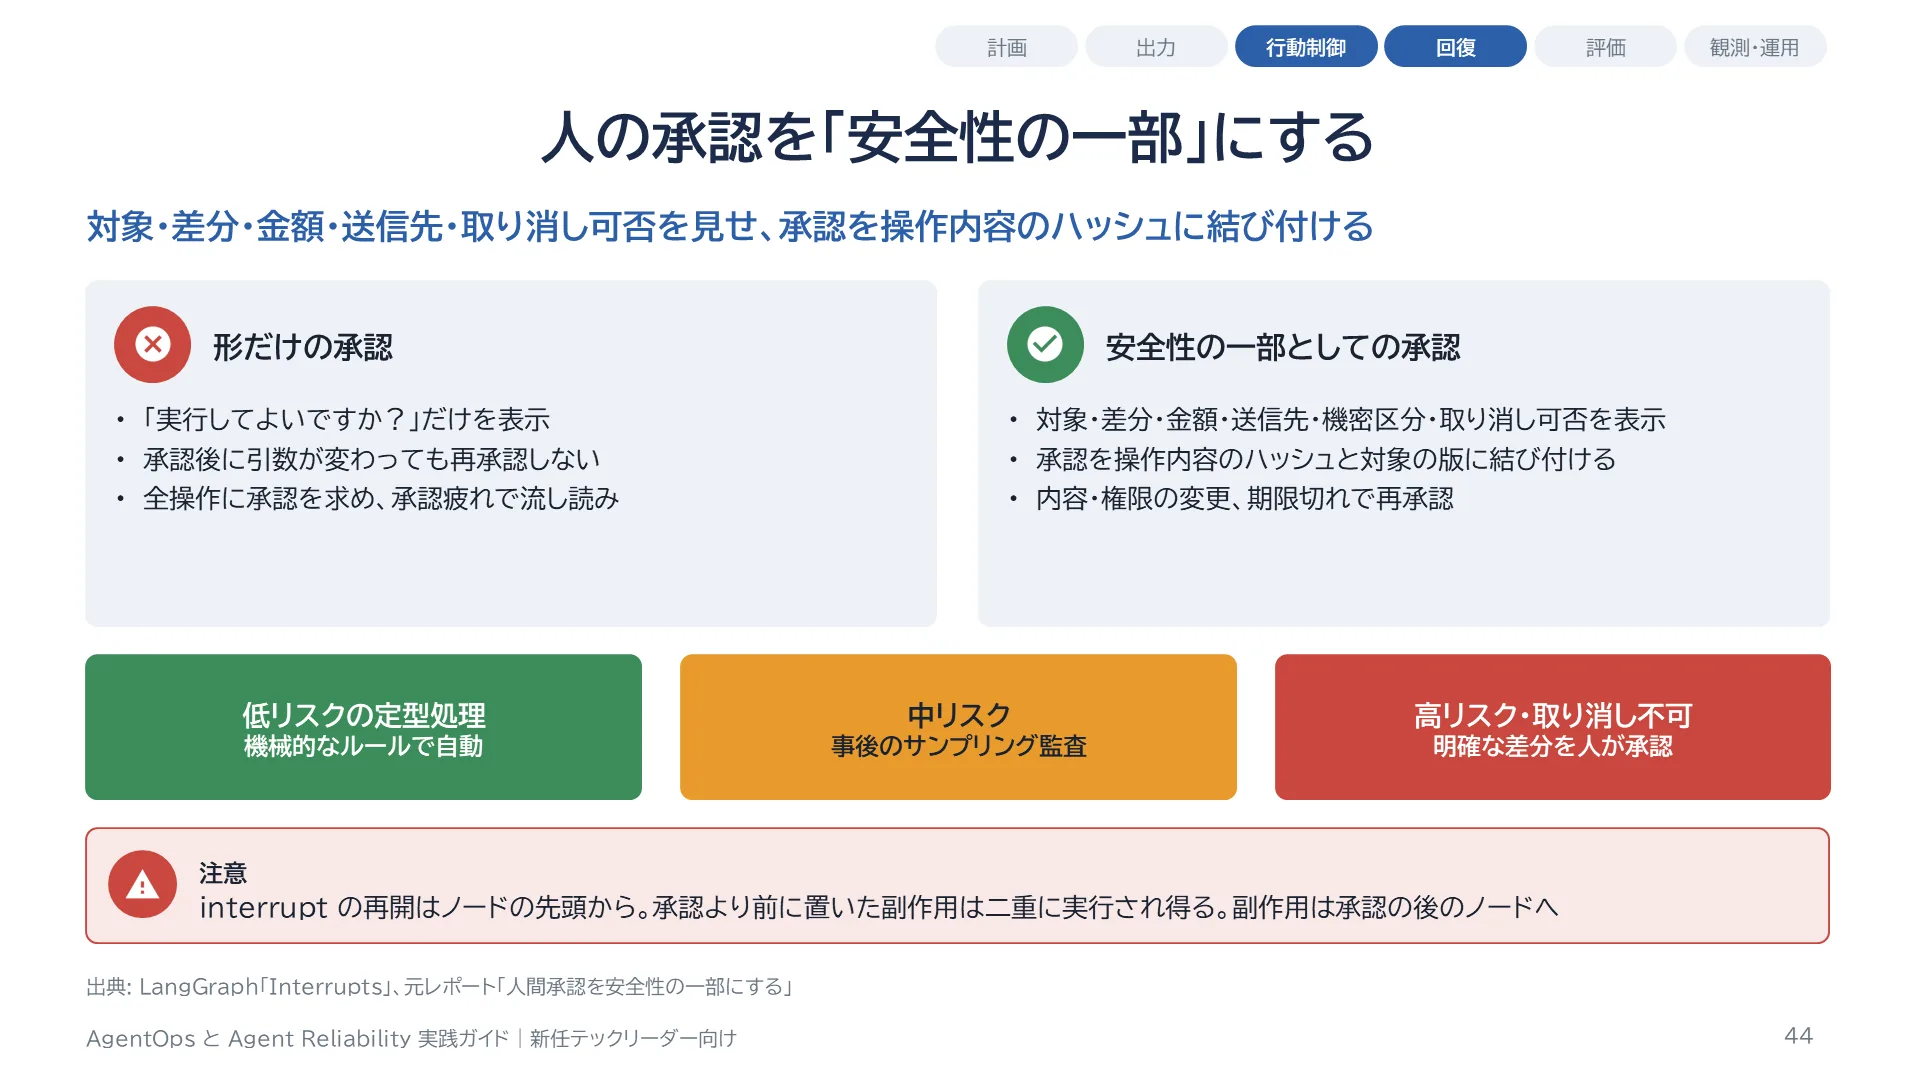
LangGraph の interrupt は、承認や追加の入力のために実行を止めて、再開する仕組みです。ただし再開時にはノードが先頭から再実行されるので、interrupt の前に置いた副作用は冪等にするか、承認の後の別のノードに移します。承認の設計では、単に「実行してよいですか」と聞くのではなく、対象、変更の内容、金額、送信先、機密区分、取り消せるかどうかを表示します。承認の記録は、操作の内容のハッシュと対象の版に結び付け、内容が変わったとき、権限が変わったとき、期限が切れたときは、承認し直してもらいます。承認者が確認できない内部情報や曖昧な説明のまま押させる仕組みは、責任を形だけ人に移すことになります。承認の回数を増やすより、低リスクの定型処理は機械的なルール、高リスクの操作は明確な差分の承認、という分担にします。
スライド 45 のテキストと解説
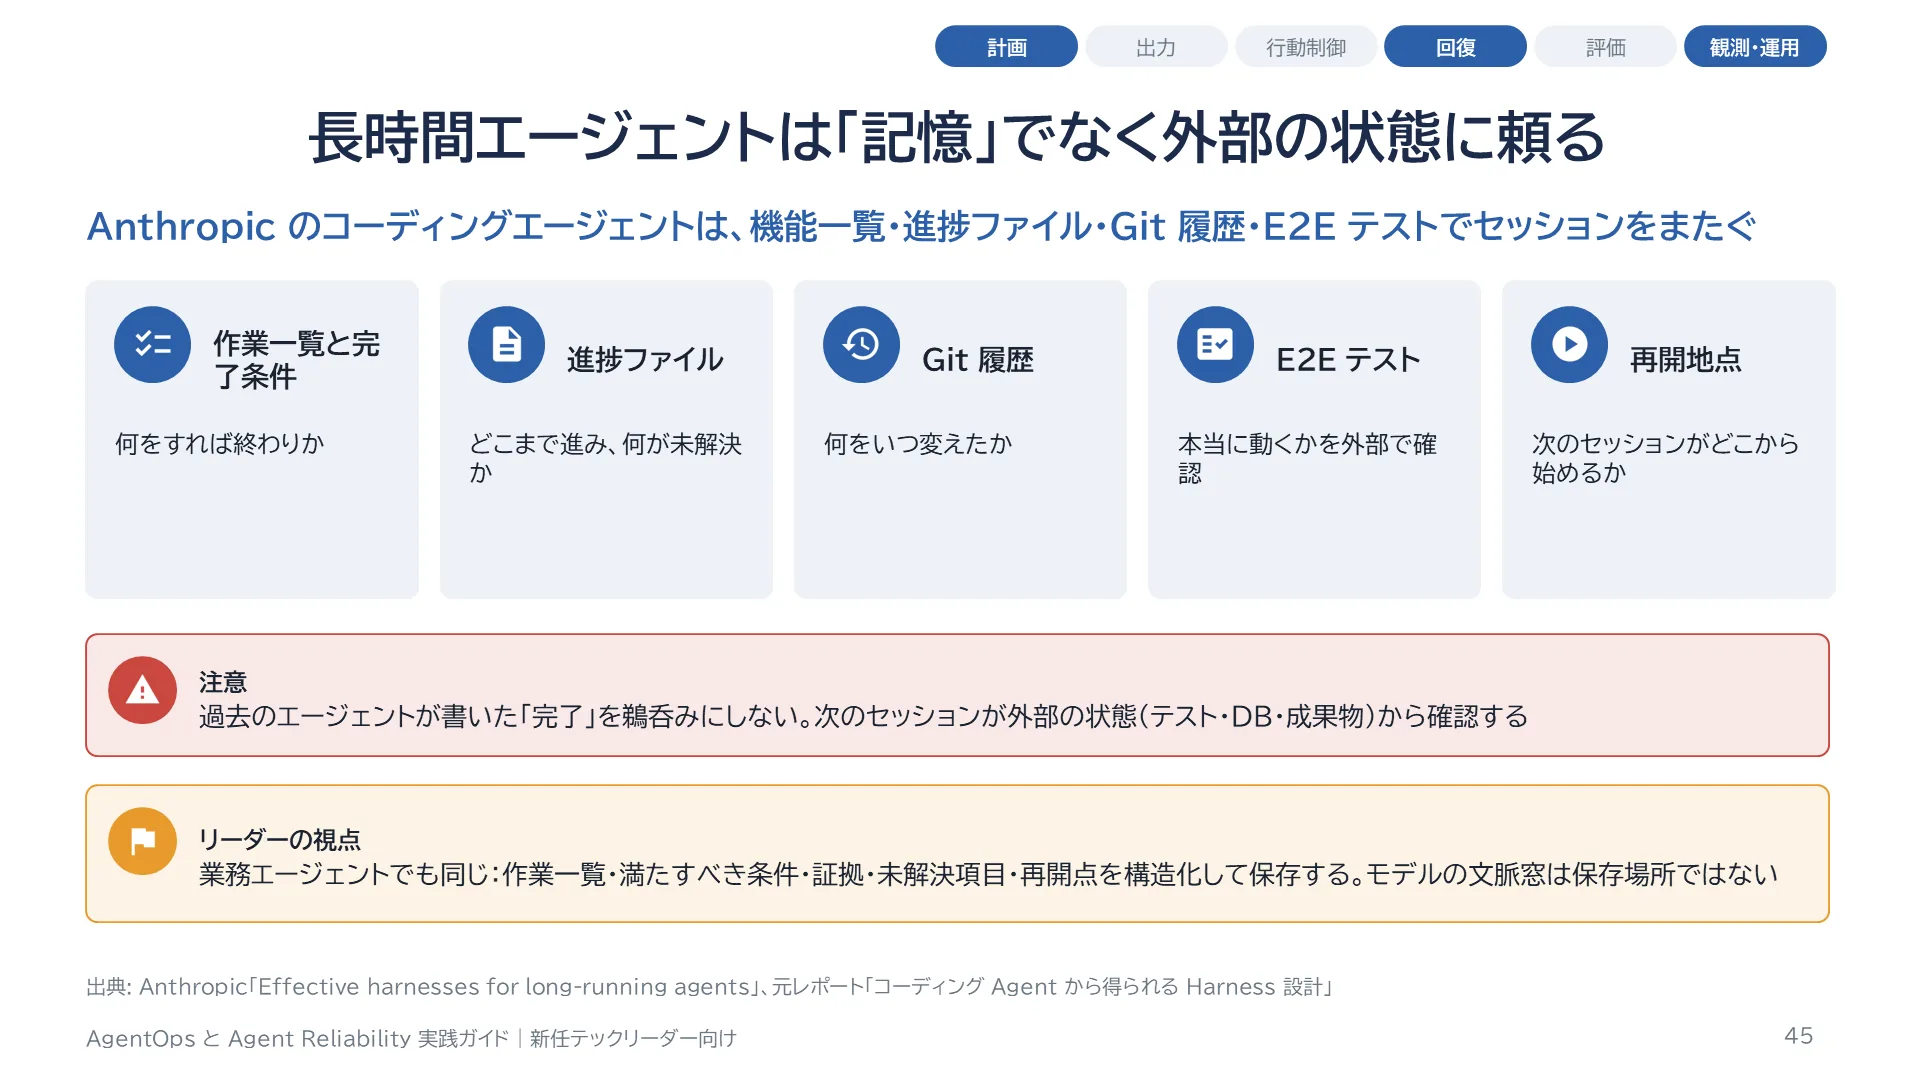
Anthropic の長時間エージェントの実務記事は、初期化を担うエージェント、機能の一覧、進捗のファイル、Git の履歴、エンドツーエンドのテストを使って、作業をセッションをまたいで続ける方法を説明しています。定量的な比較ではありませんが、長いタスクをモデルの記憶に頼らず、外部の状態と検証可能な成果物に変換する具体例として有用です。一般業務に応用するなら、作業の一覧、満たすべき条件、証拠、未解決の項目、再開する地点を構造化して保存します。過去のエージェントが書いた「完了」をそのまま信じず、次のセッションが外部の状態から確認できるようにすることが重要です。
スライド 46 のテキストと解説
Part 6 では、エージェントのセキュリティを扱います。
スライド 47 のテキストと解説
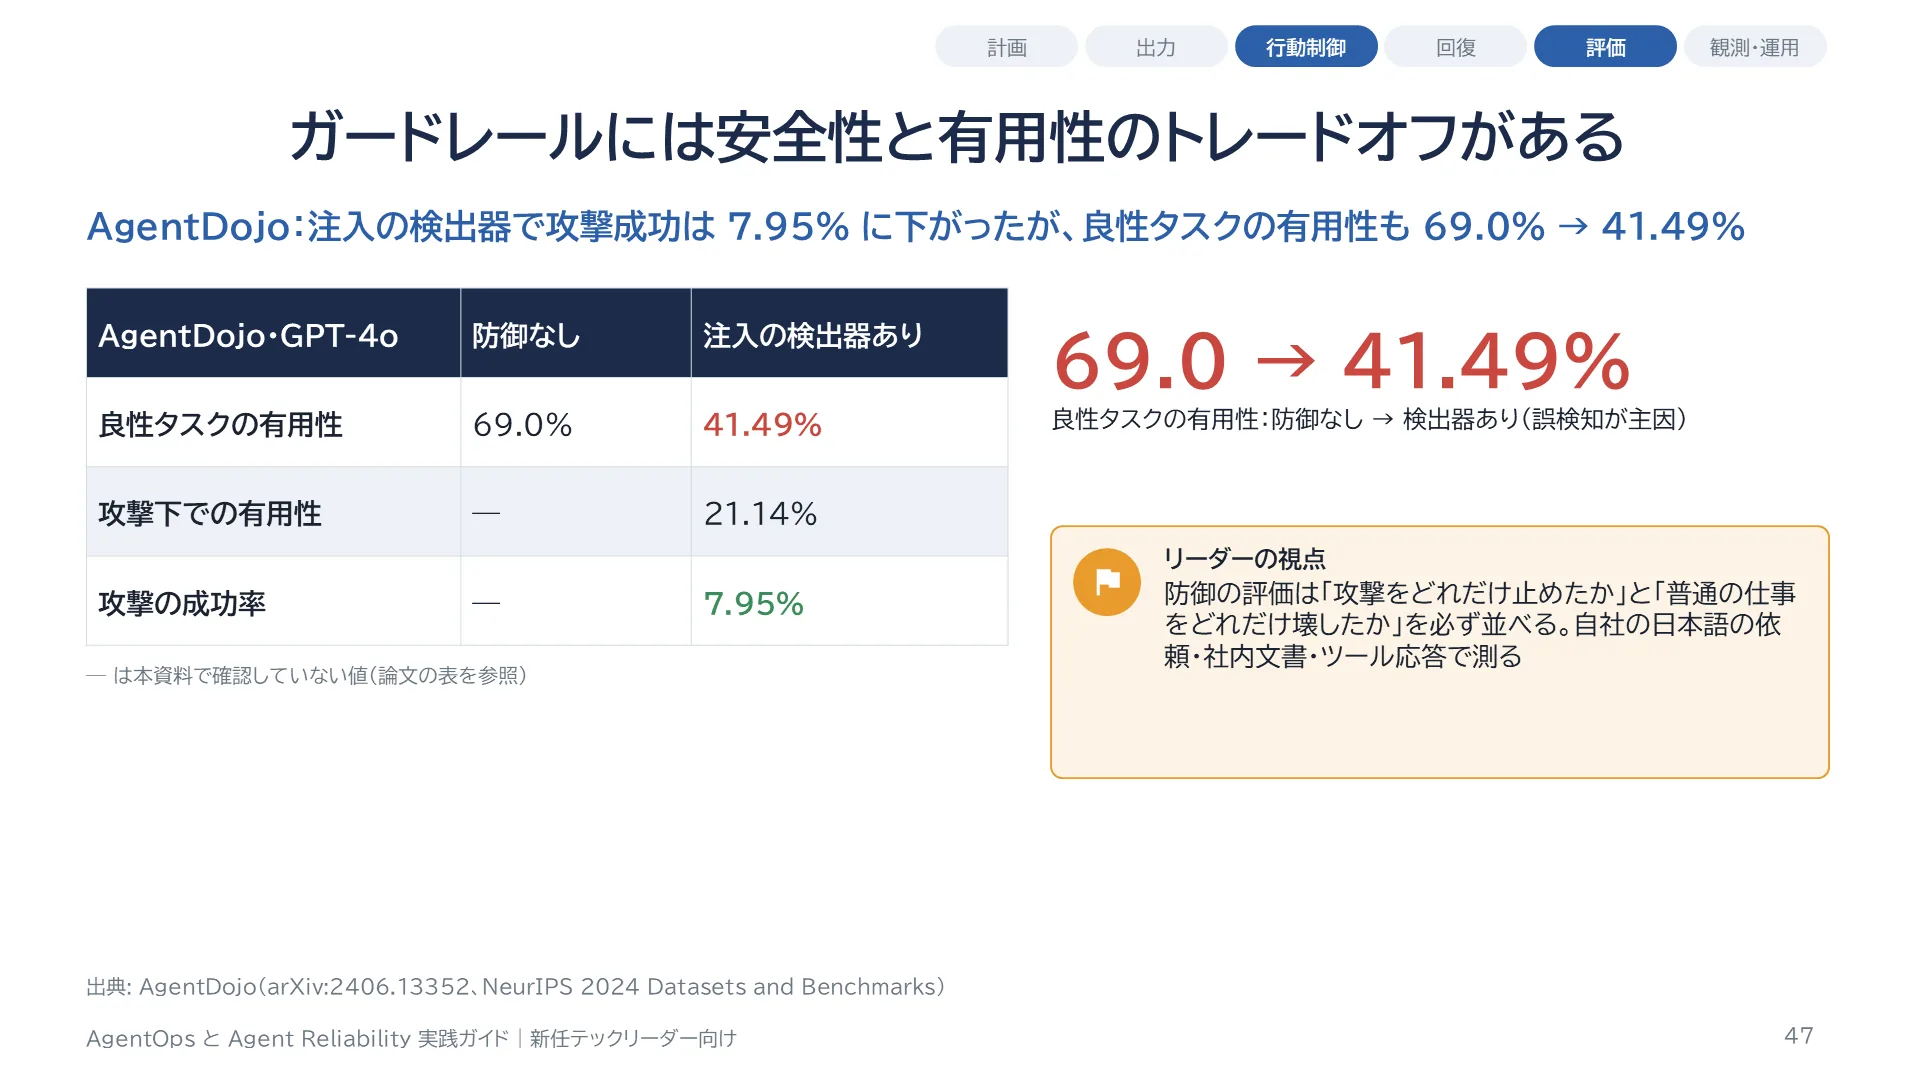
AgentDojo は、ツールの出力など未信頼のデータに埋め込まれた命令(間接プロンプトインジェクション)に対して、ユーザーのタスクの有用性と、攻撃の成功率を別々に測る、状態を持つ評価環境です。GPT-4o の比較では、注入の検出器を足した条件で、攻撃の成功率は 7.95% に下がりましたが、攻撃のない良性のタスクの有用性が 69.0% から 41.49% に下がりました。原因は誤検知の多さです。攻撃下での有用性は 21.14% でした。つまり、ブロック率だけで防御を評価してはいけません。元レポートは、検出器の製品順位を付けず、実際の日本語の依頼、社内の語彙、RAG の文書、ツールの応答、攻撃の入力を同じ条件で流し、有用性、見逃し、費用、遅延を同時に測るべきだとしています。
スライド 48 のテキストと解説
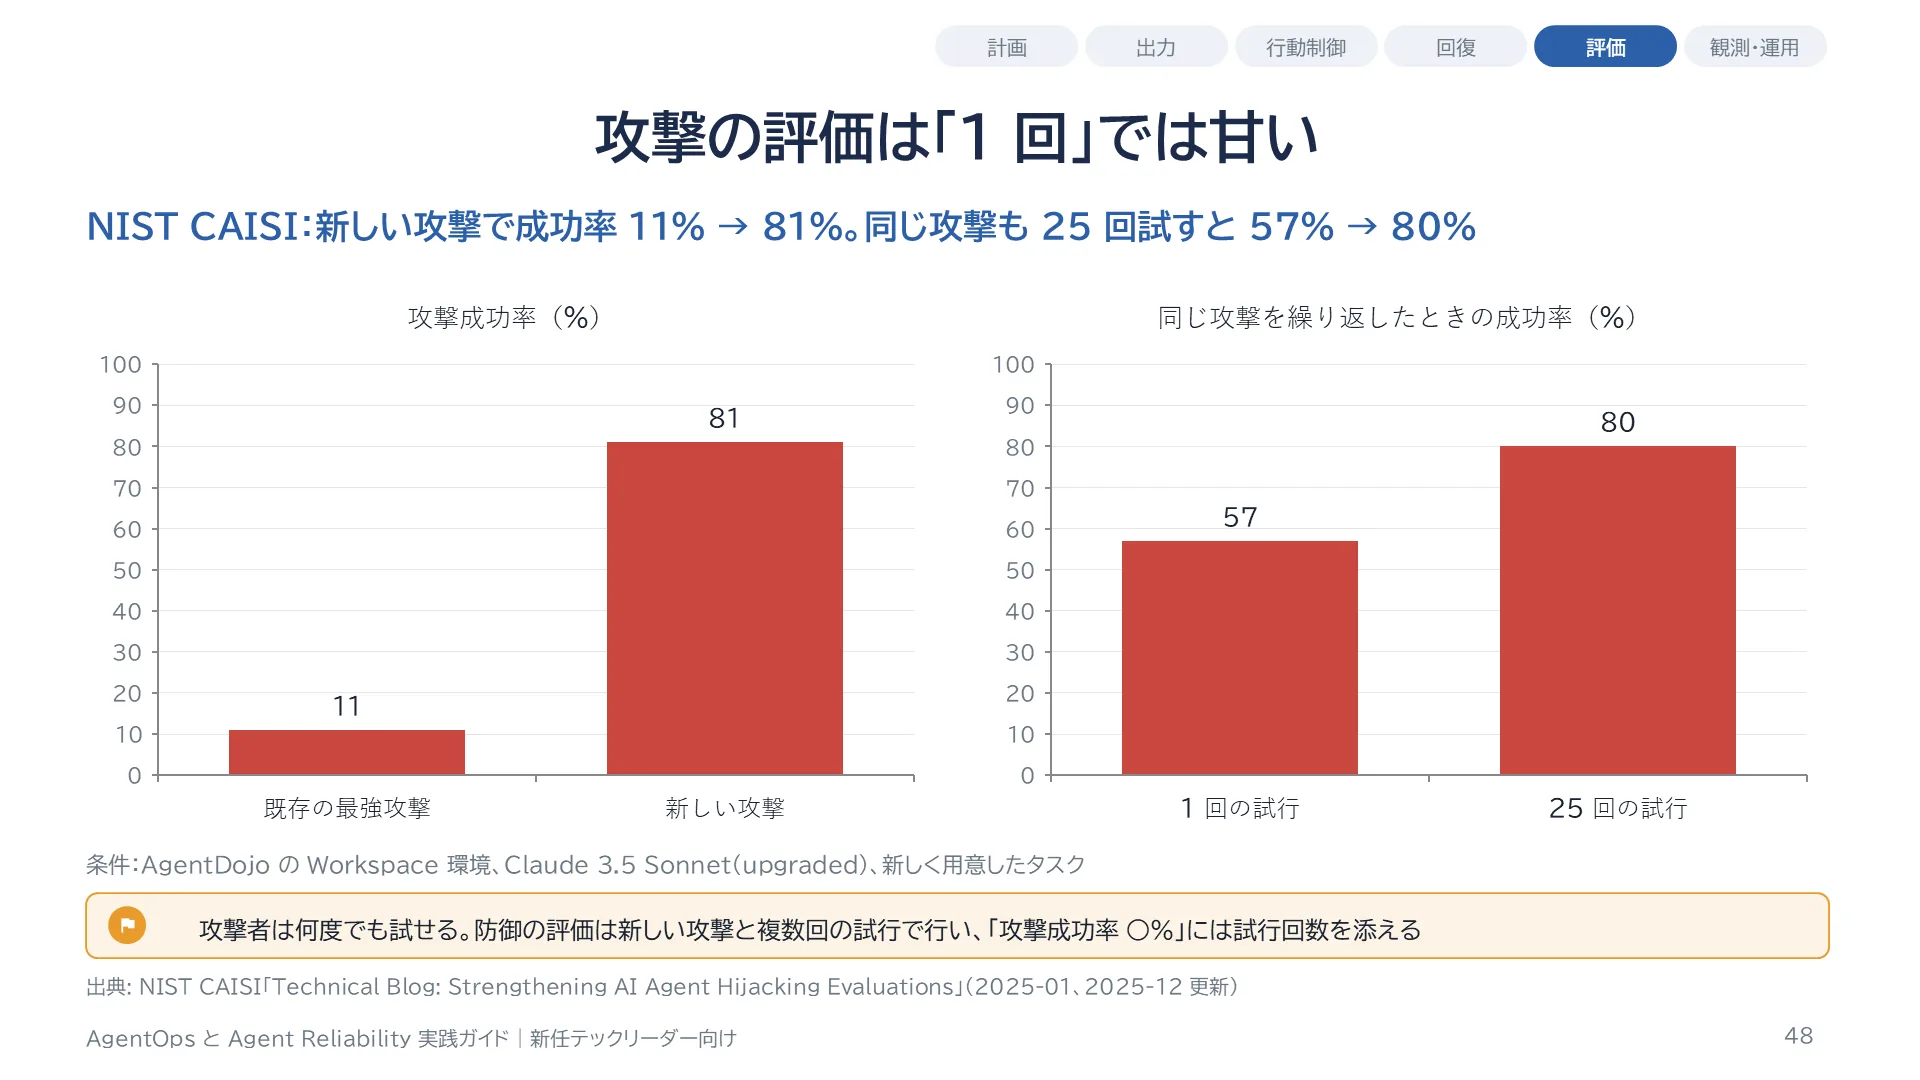
米国 NIST の CAISI は、エージェントの乗っ取り(ハイジャック)の評価を強化する技術ブログを公開しています。AgentDojo の Workspace 環境、Claude 3.5 Sonnet(upgraded)、新しく用意したタスクの条件で、既存の最も強い攻撃では成功率 11% だったのが、新しい攻撃では 81% になりました。また、1 回の試行で 57% だった攻撃も、25 回試すと 80% に上がりました。攻撃者は何度でも試せますが、評価は 1 回で終わりがちです。防御を評価するときは、新しい攻撃を作り、複数回試行し、攻撃の種類ごとに見る必要があります。
スライド 49 のテキストと解説
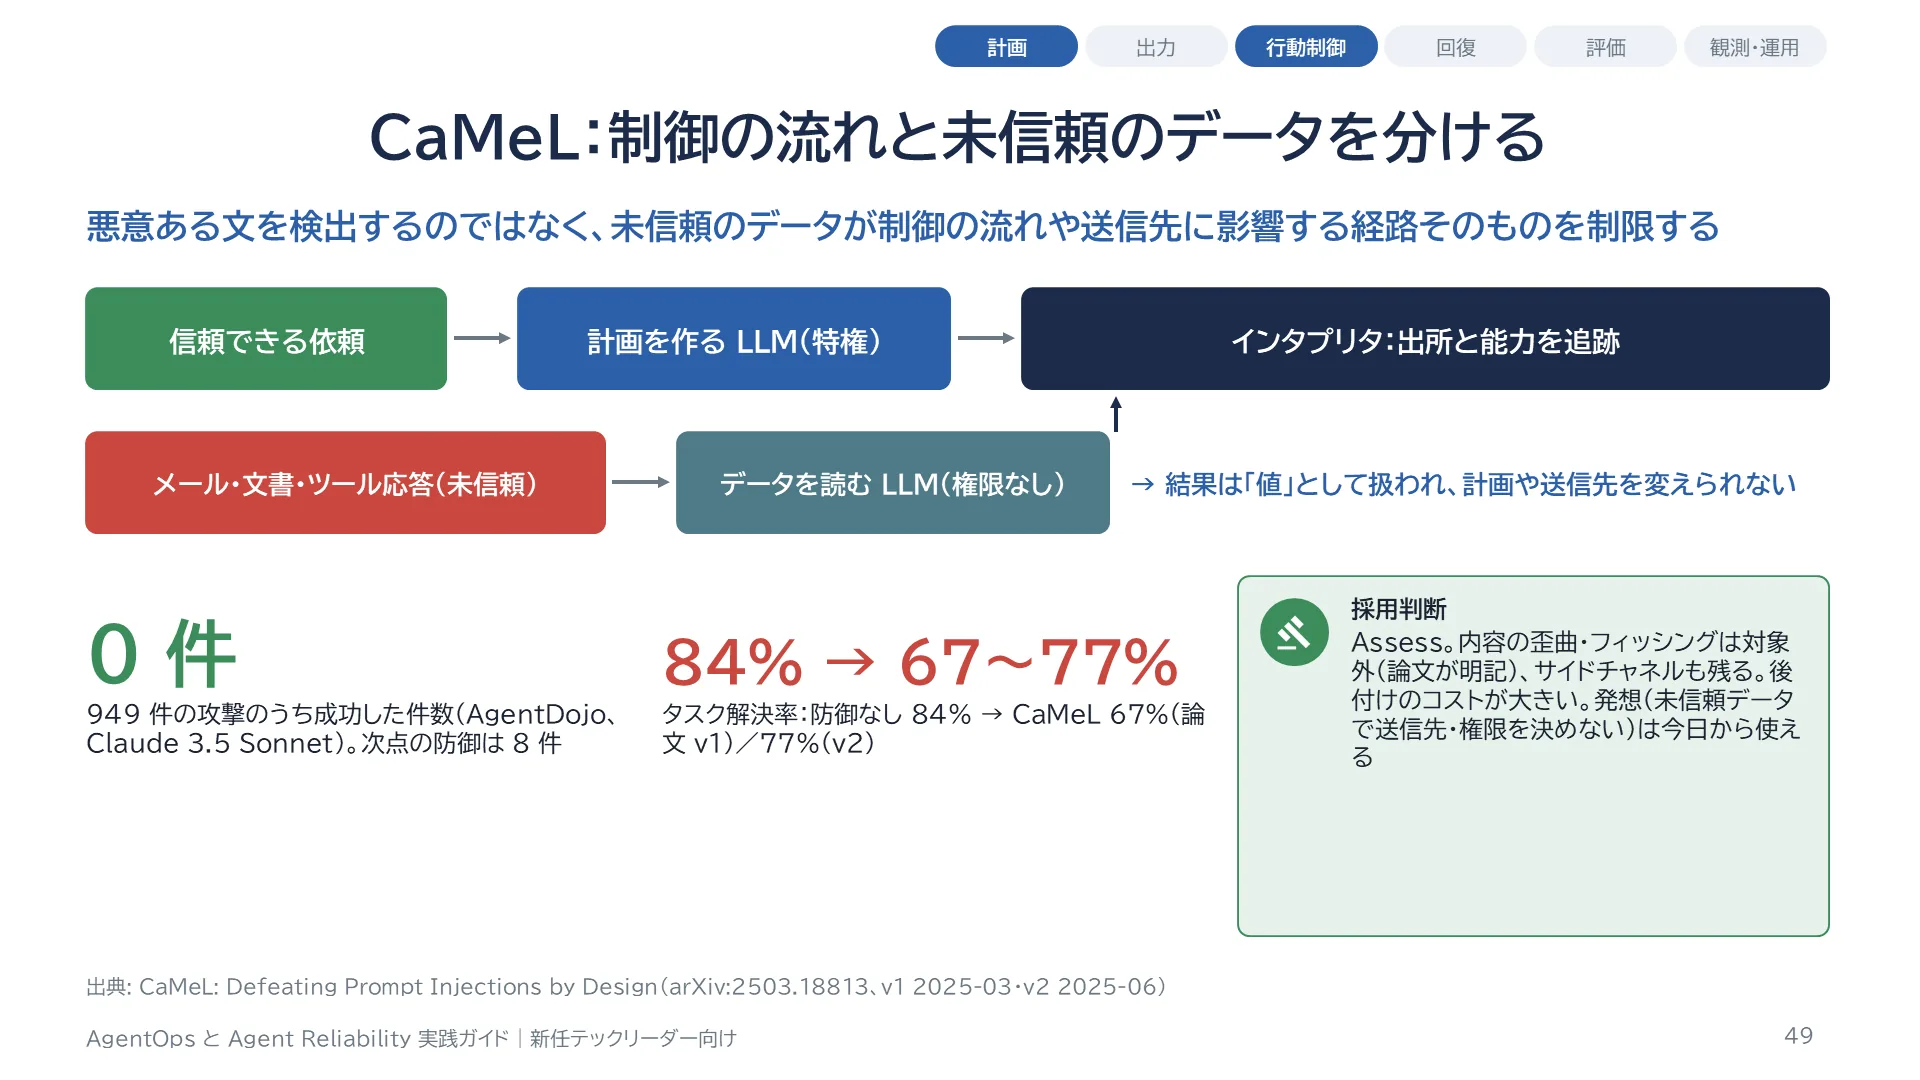
CaMeL は、信頼できるユーザーの依頼から計画を作る LLM と、未信頼のデータを処理する権限のない LLM を分け、独自のインタプリタで、データの出所と能力の制約を追跡します。狙いは、悪意ある文を完全に検出することではなく、未信頼のデータが、プログラムの制御の流れや、許可されない情報の送信に影響する経路を制限することです。Claude 3.5 Sonnet の比較では、AgentDojo の 949 の攻撃で成功は 0 件でした。次点のツールフィルタでも 8 件でした。ただし、タスクを解いた割合は、防御なしの 84% に対し、版によって 67%(v1)または 77%(v2)に下がります。また、要約の内容の歪曲やフィッシングは非目標で、サイドチャネルへの脆弱性も論文自身が認めています。「プロンプトインジェクションを完全に解決した」とは解釈しません。既存の汎用エージェントに後付けするコストが大きいので、元レポートでは Assess です。
スライド 50 のテキストと解説
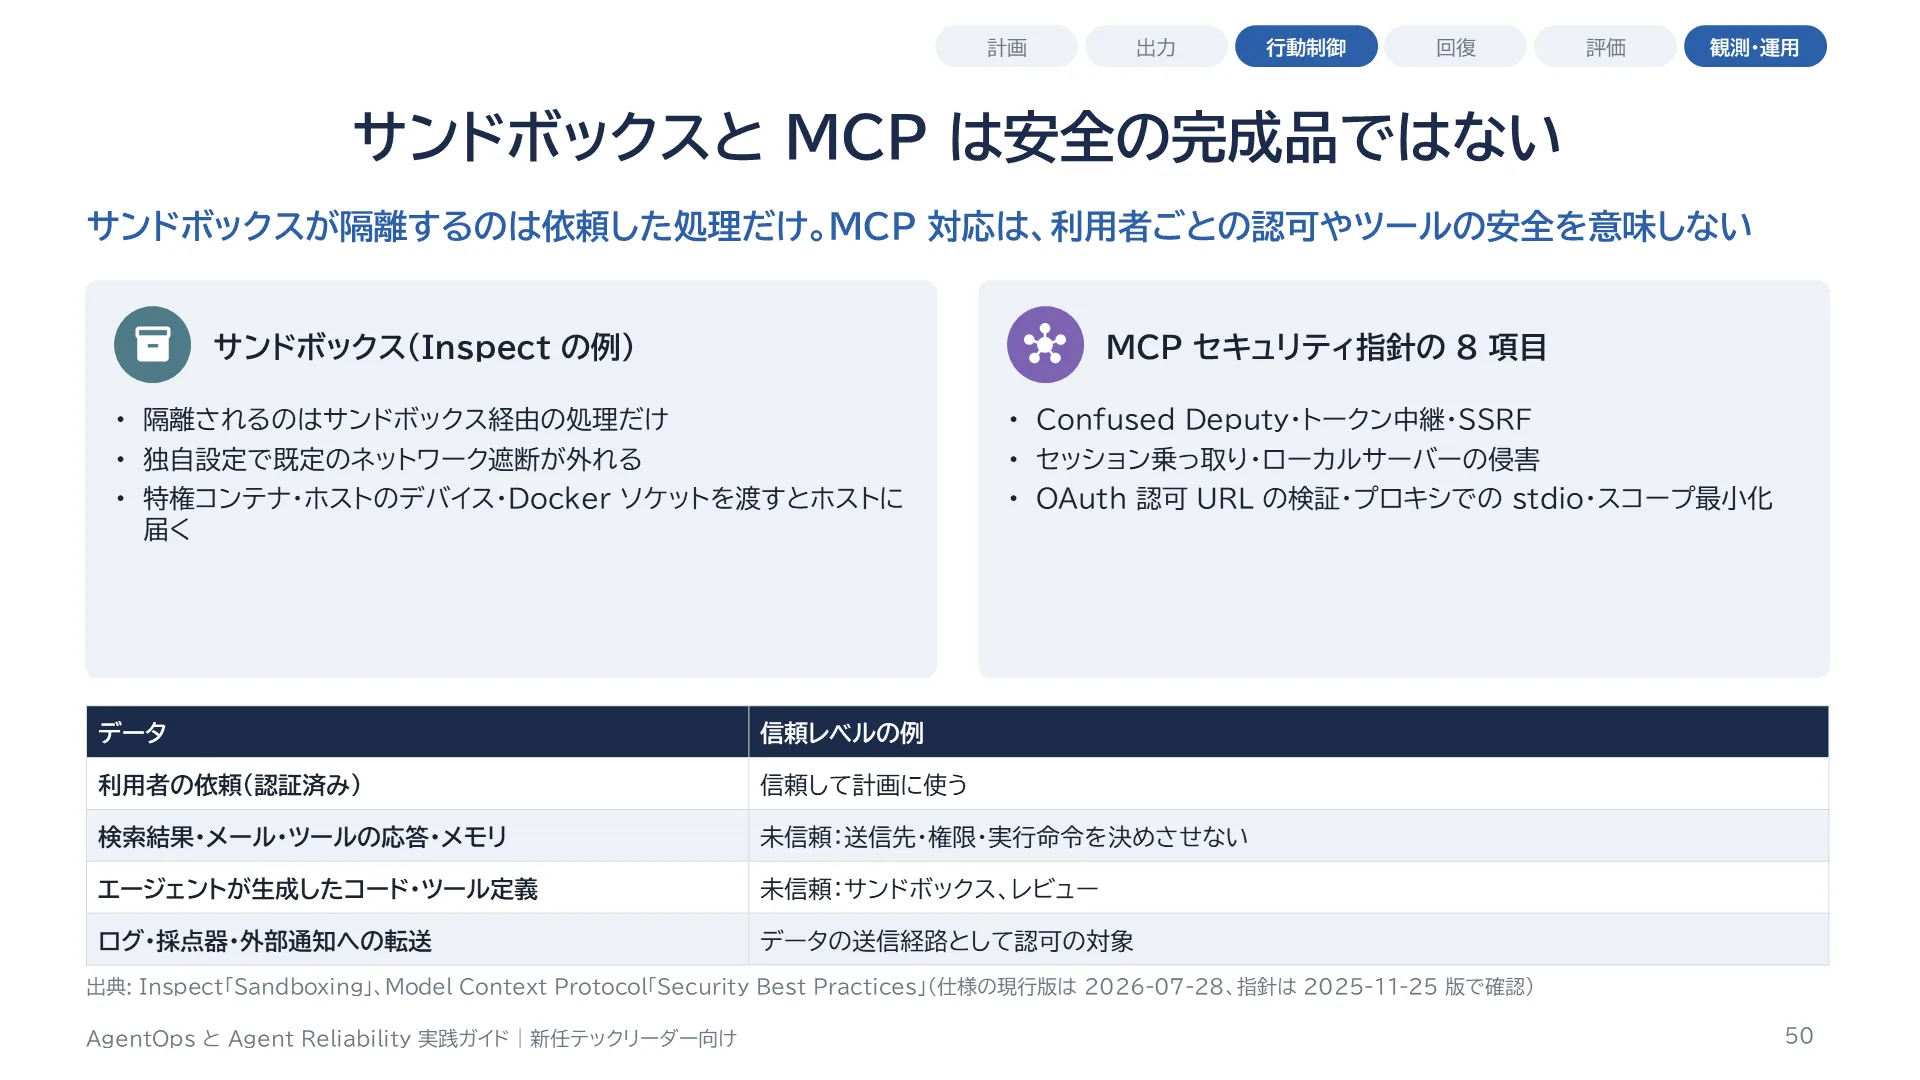
Inspect はコード実行などのサンドボックスを提供しますが、コンテナの中で動くのは、サンドボックス経由で依頼した処理だけです。評価プロセスの中で動く独自のツールまでは自動で隔離されません。独自の設定ファイルを使うと、既定のネットワーク遮断が置き換わります。特権コンテナ、ホストのデバイス、Docker のソケットを渡すと、エージェントがホストに到達し得ます。MCP の公式のセキュリティ指針も、Confused Deputy(権限の取り違え)、トークンの中継、SSRF、セッションの乗っ取り、ローカルの MCP サーバーの侵害、OAuth の認可 URL の検証、プロキシ構成での標準入出力の安全、スコープの最小化を個別に扱っています。MCP に対応していることは、利用者ごとの認可やツールの安全が自動で満たされることを意味しません。元レポートは、エージェントが生成するコード、ツールの定義、検索結果、メモリ、評価対象の成果物を、それぞれ別の信頼レベルで扱い、ログや採点器、外部への通知への転送もデータの送信経路として認可の対象にすることを提案しています。
スライド 51 のテキストと解説
Part 7 では、観測性と原因分析を扱います。
スライド 52 のテキストと解説
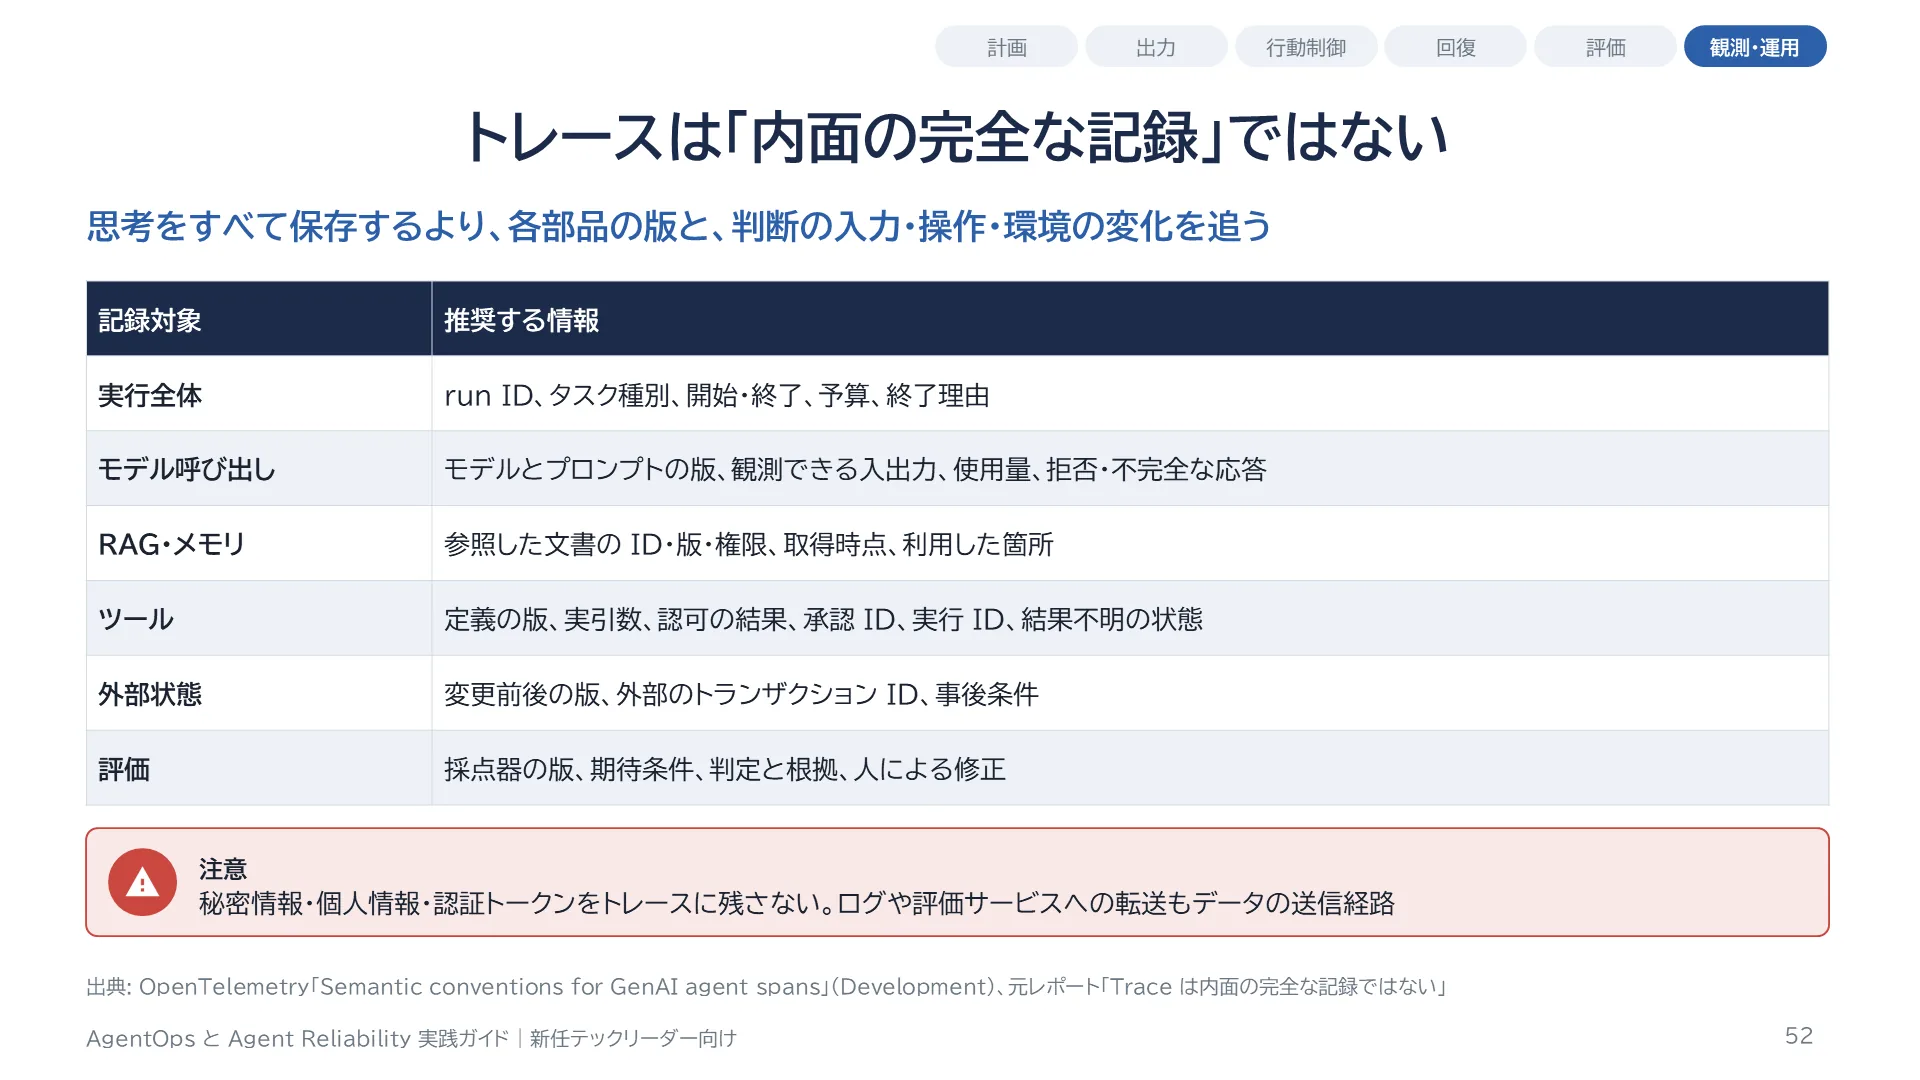
OpenTelemetry の生成 AI のエージェントの規約は、エージェント、ワークフロー、ツールなどの操作と属性を記録する枠組みを提供します。2026 年 11 月時点で状態は Development です。観測できる操作や入出力の形式をそろえるものであり、非公開の内部推論や真の因果関係を完全に取れる保証はありません。元レポートは、思考のすべてを保存するより、モデル、プロンプト、ツール、ポリシー、データの版と、実際の判断の入力、操作、環境の変化を追跡することを提案しています。また、テレメトリーに秘密情報、個人情報、認証トークンを記録しない制御も、観測性の設計の一部です。
スライド 53 のテキストと解説
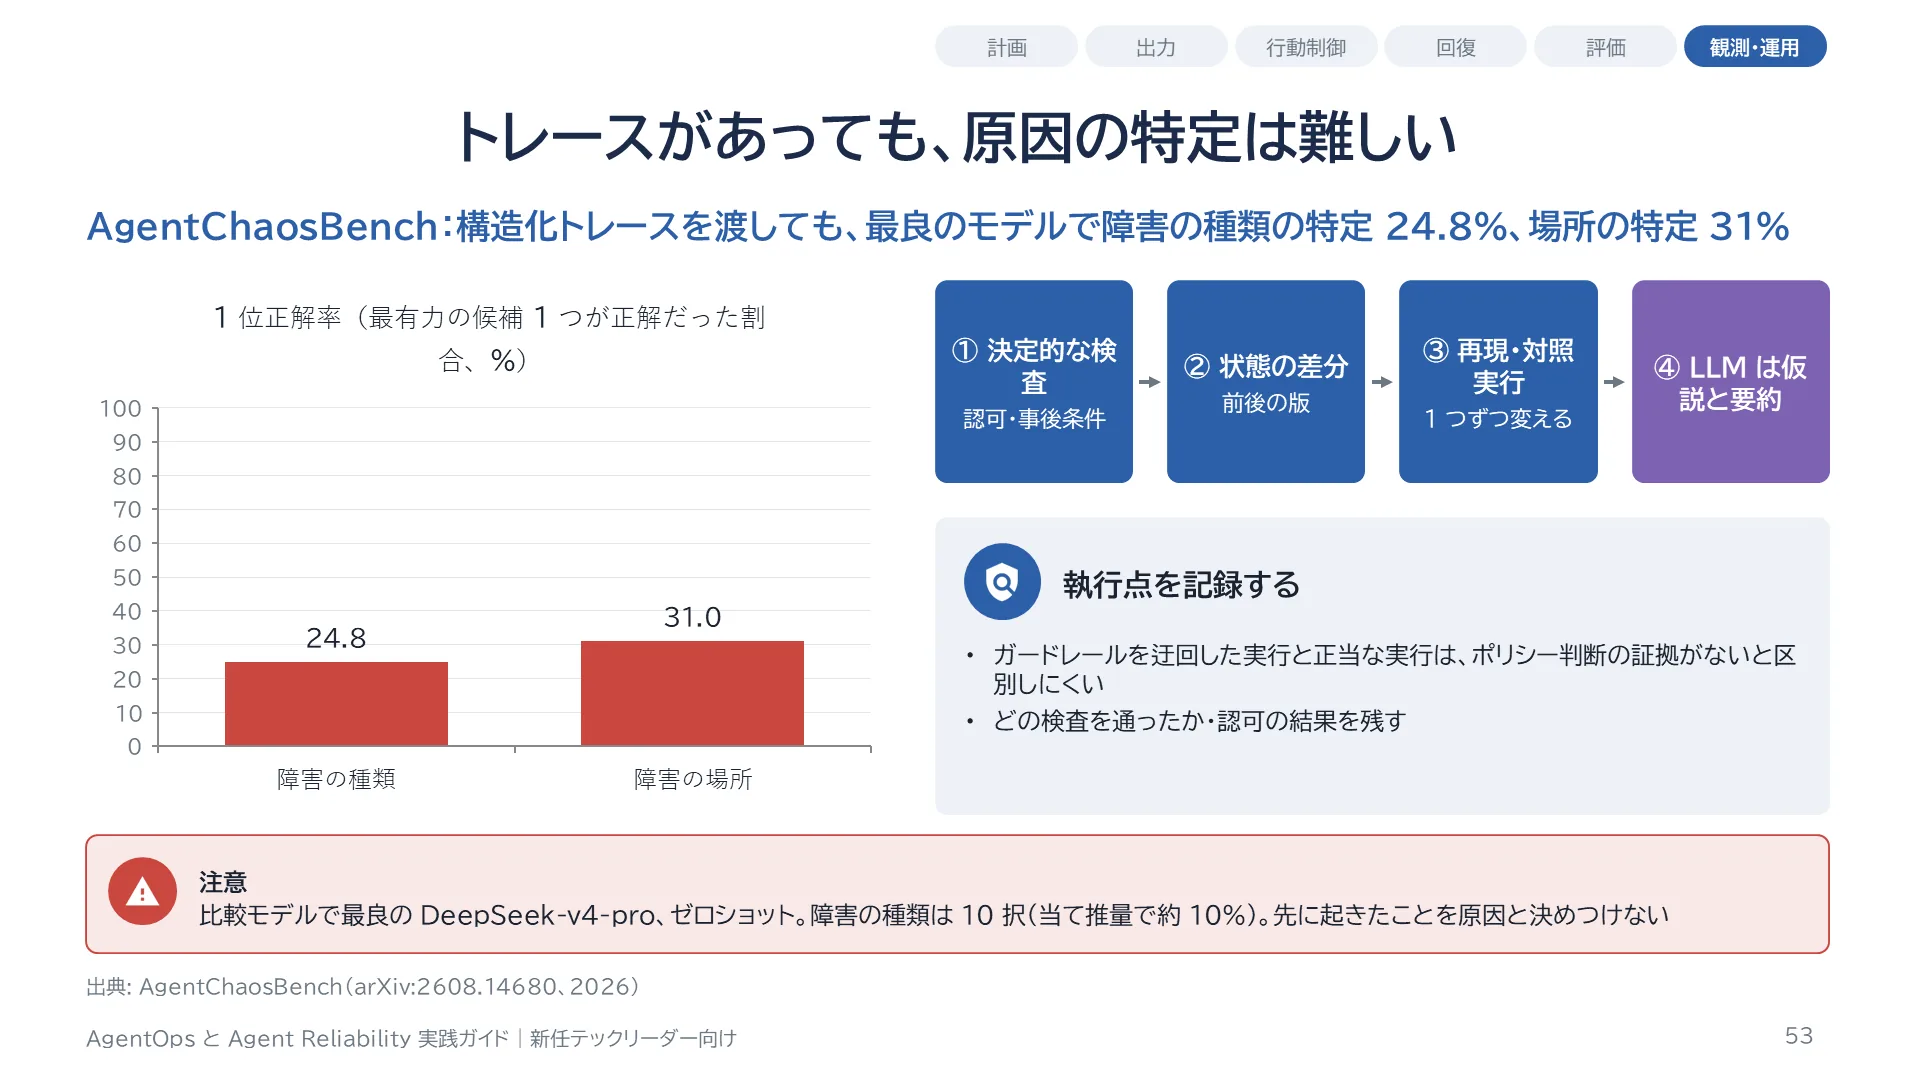
2026 年の AgentChaosBench は、5 つのアプリに 10 種類の障害を注入して 275 のトレースを作り(障害ありが 250、なしが 25)、障害の種類と場所を推定させました。構造化されたトレースを渡したゼロショットの条件で、比較したモデルの中で最も良かった DeepSeek-v4-pro でも、障害の種類の 1 位正解率は 24.8%、場所の 1 位正解率は 31% でした。観測性のツールを入れただけで原因分析が自動で解けるわけではありません。特に、ガードレールを迂回した実行と、正当に通過した実行は、ポリシー判断の証拠がないと区別しにくいと報告されています。そこで、モデルの発話だけでなく、独立した認可と検査の結果、どの執行点を通ったかを記録します。原因の推定は、まず決定的な検査、状態の差分、再現実験、対照の実行で絞り込み、LLM は仮説の生成と要約に使います。時系列で先に起きたことを、そのまま原因と決めつけないことも大切です。
スライド 54 のテキストと解説
Part 8 では、ツールの選び方、継続改善、参照アーキテクチャ、導入の手順を扱います。
スライド 55 のテキストと解説
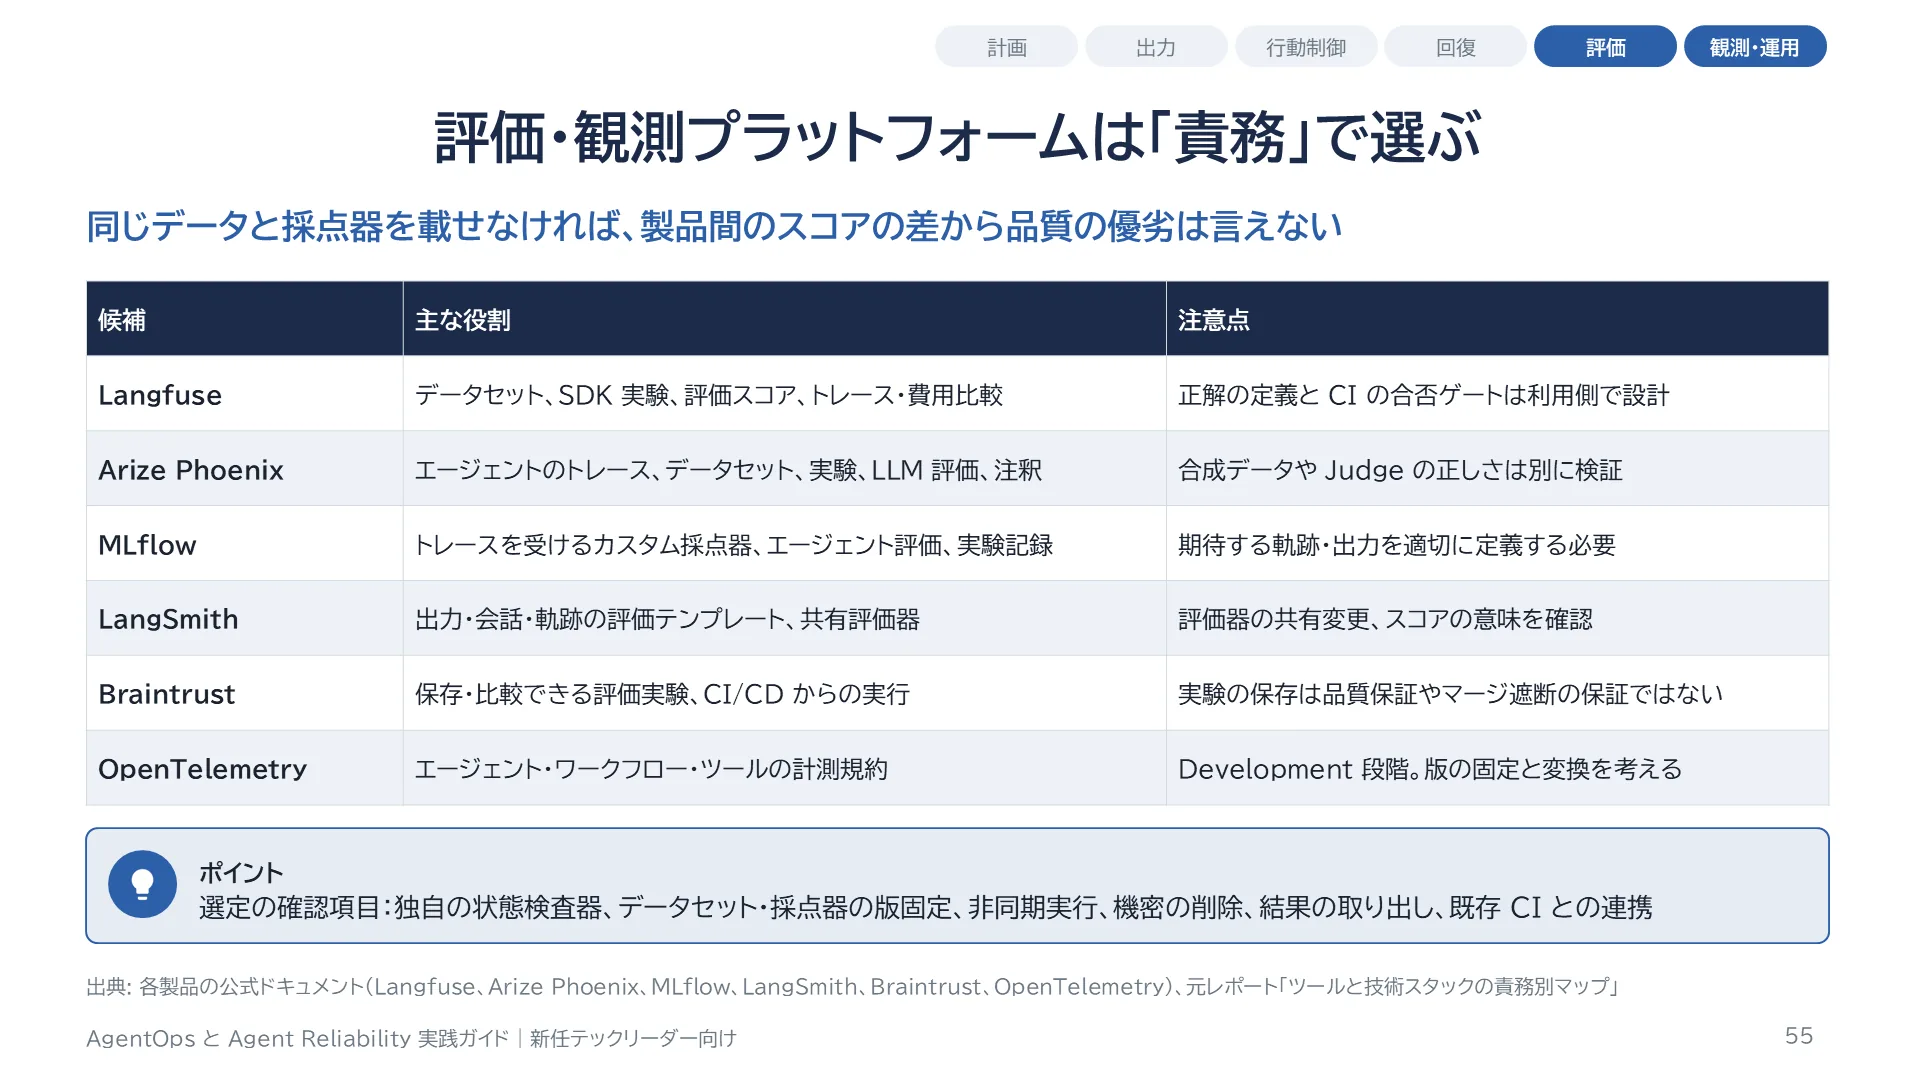
元レポートは、評価と観測のプラットフォームを、公式資料で確認できた機能で比べ、勝者を決めていません。同じデータと採点器を載せなければ、製品の間のスコアの差から品質の優劣は判断できないからです。選ぶときは、画面の見やすさだけでなく、独自の状態検査の採点器を組み込めるか、データセットと採点器の版を固定できるか、非同期で実行できるか、機密情報を削除できるか、評価結果を取り出せるか、既存の CI と連携できるかを確認します。観測と評価を 1 つの製品にまとめる場合でも、認可や実行の制御とは独立した責務に保ちます。
スライド 56 のテキストと解説
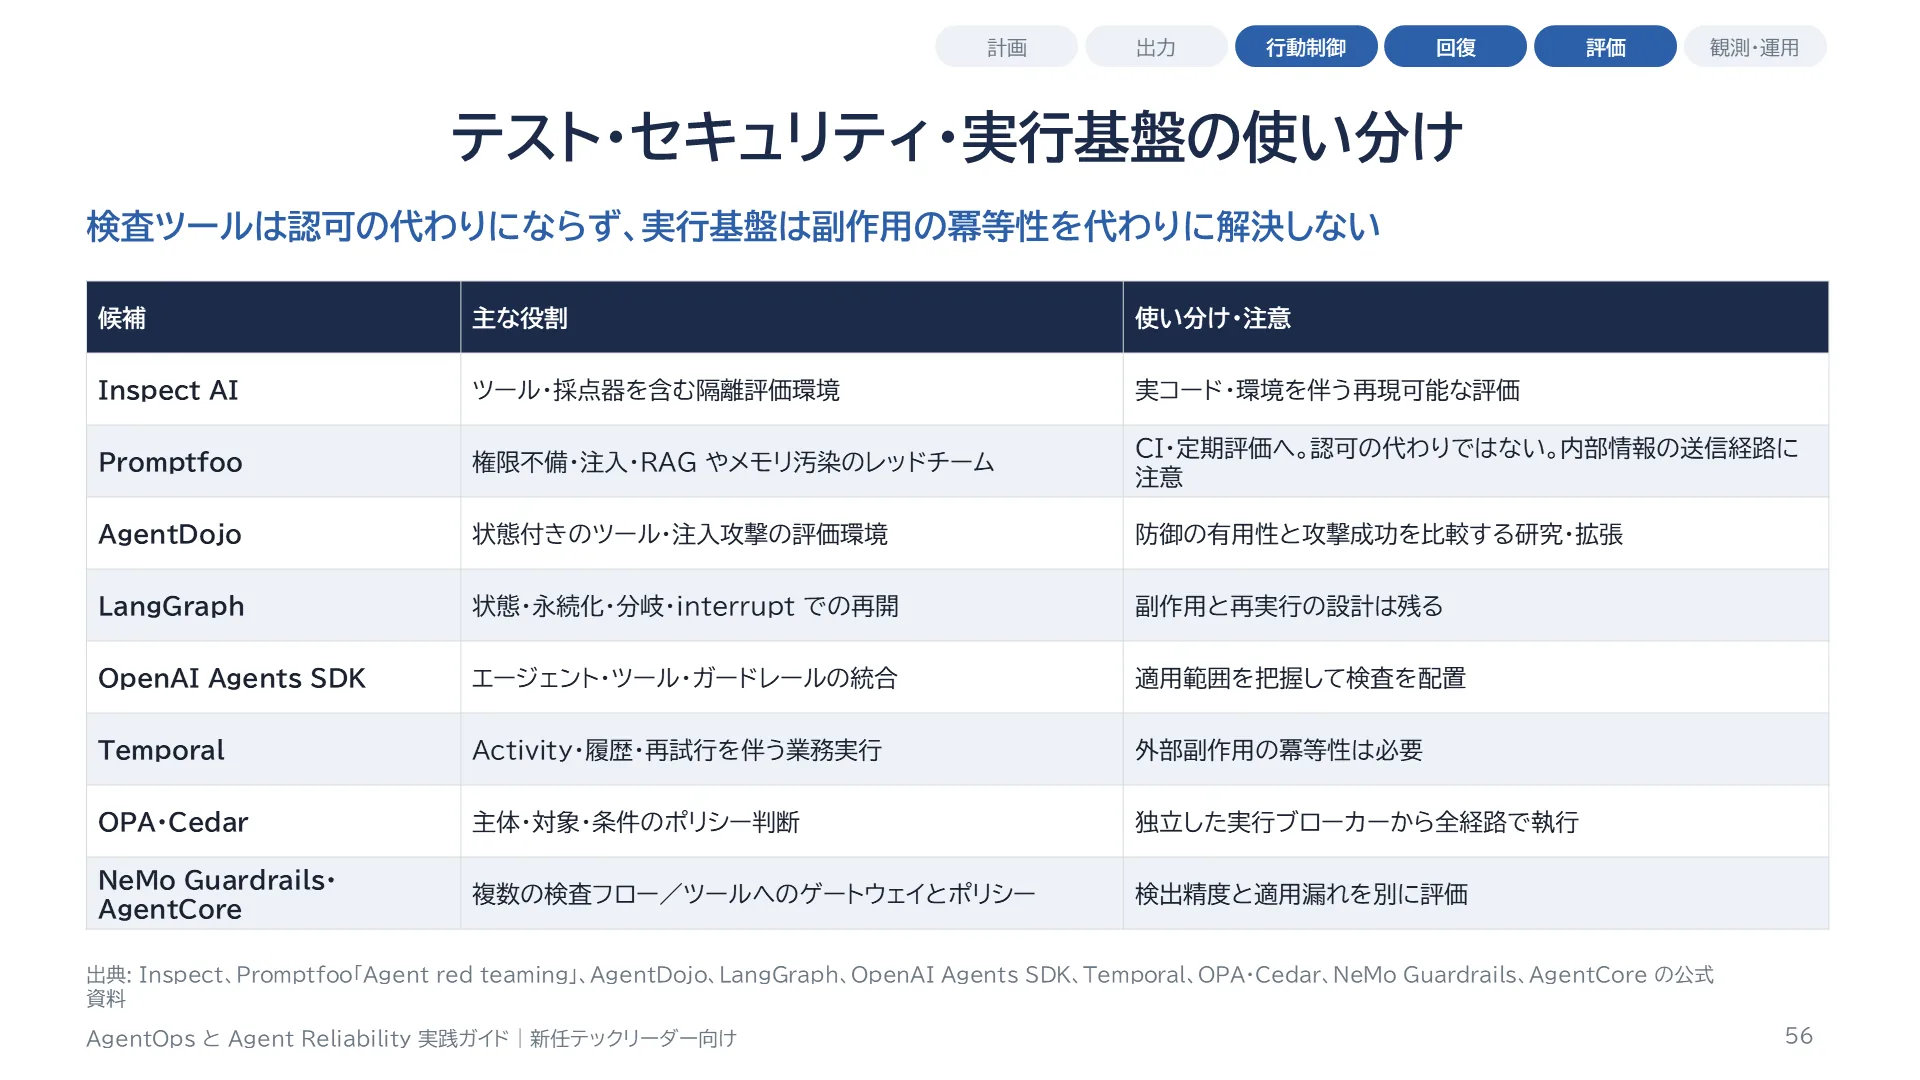
テスト、セキュリティ、実行基盤の候補と使い分けです。Inspect AI は、ツールや採点器を含む隔離された評価環境で、実際のコードや環境を伴う再現可能な評価を組みます。Promptfoo は、エージェントの権限の不備、注入、RAG やメモリの汚染などのレッドチームの設定を CI や定期評価に組み込みます。検査ツールなので、認可の代わりにはなりません。また、内部のトレースを攻撃の生成に渡す設定があり、内部のツール名やエラーが評価サービスへ送られる経路もセキュリティレビューの対象です。LangGraph と Temporal は状態と再開を提供しますが、副作用と再実行の設計は残ります。OPA と Cedar は独立した実行ブローカーから問い合わせ、全経路で執行します。
スライド 57 のテキストと解説
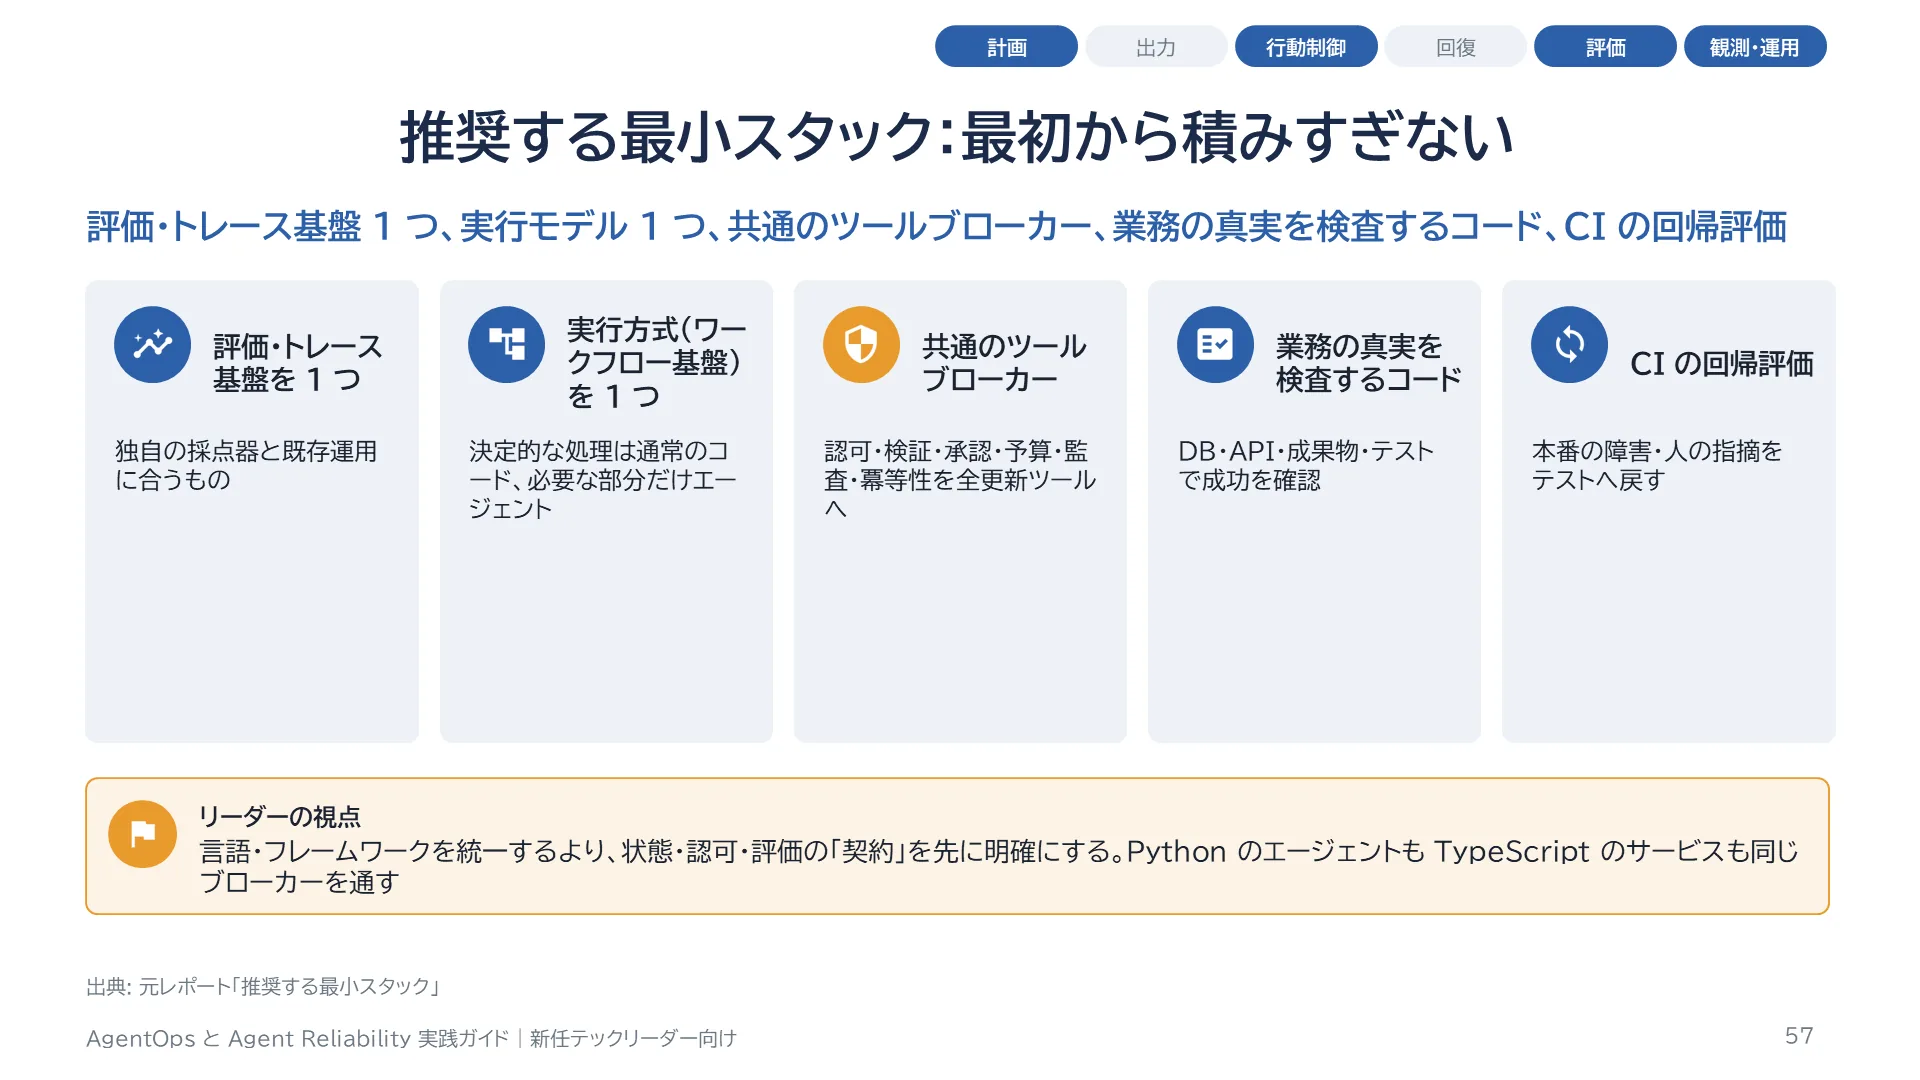
最初から、複数の評価製品、複数のランタイム、複数のガードレールを積む必要はありません。元レポートの初期案は 5 つです。1 つの評価とトレースの基盤を、独自の採点器と既存の運用に合うものから選ぶ。1 つの実行モデルで、決定的に書ける処理は通常のコードにし、必要な部分だけをエージェントか状態機械にする。共通のツールブローカーで、認可、入力の検証、承認、予算、監査、冪等性を、すべての更新系ツールに適用する。業務の真実を検査するコードで、DB、API、成果物、テストといった外部の証拠で成功を確認する。CI の回帰評価で、本番の障害や人の指摘をテストに戻し、差分を確認してから段階的にリリースする。言語やフレームワークをそろえるより、状態・認可・評価の契約を明確にする方を優先します。
スライド 58 のテキストと解説
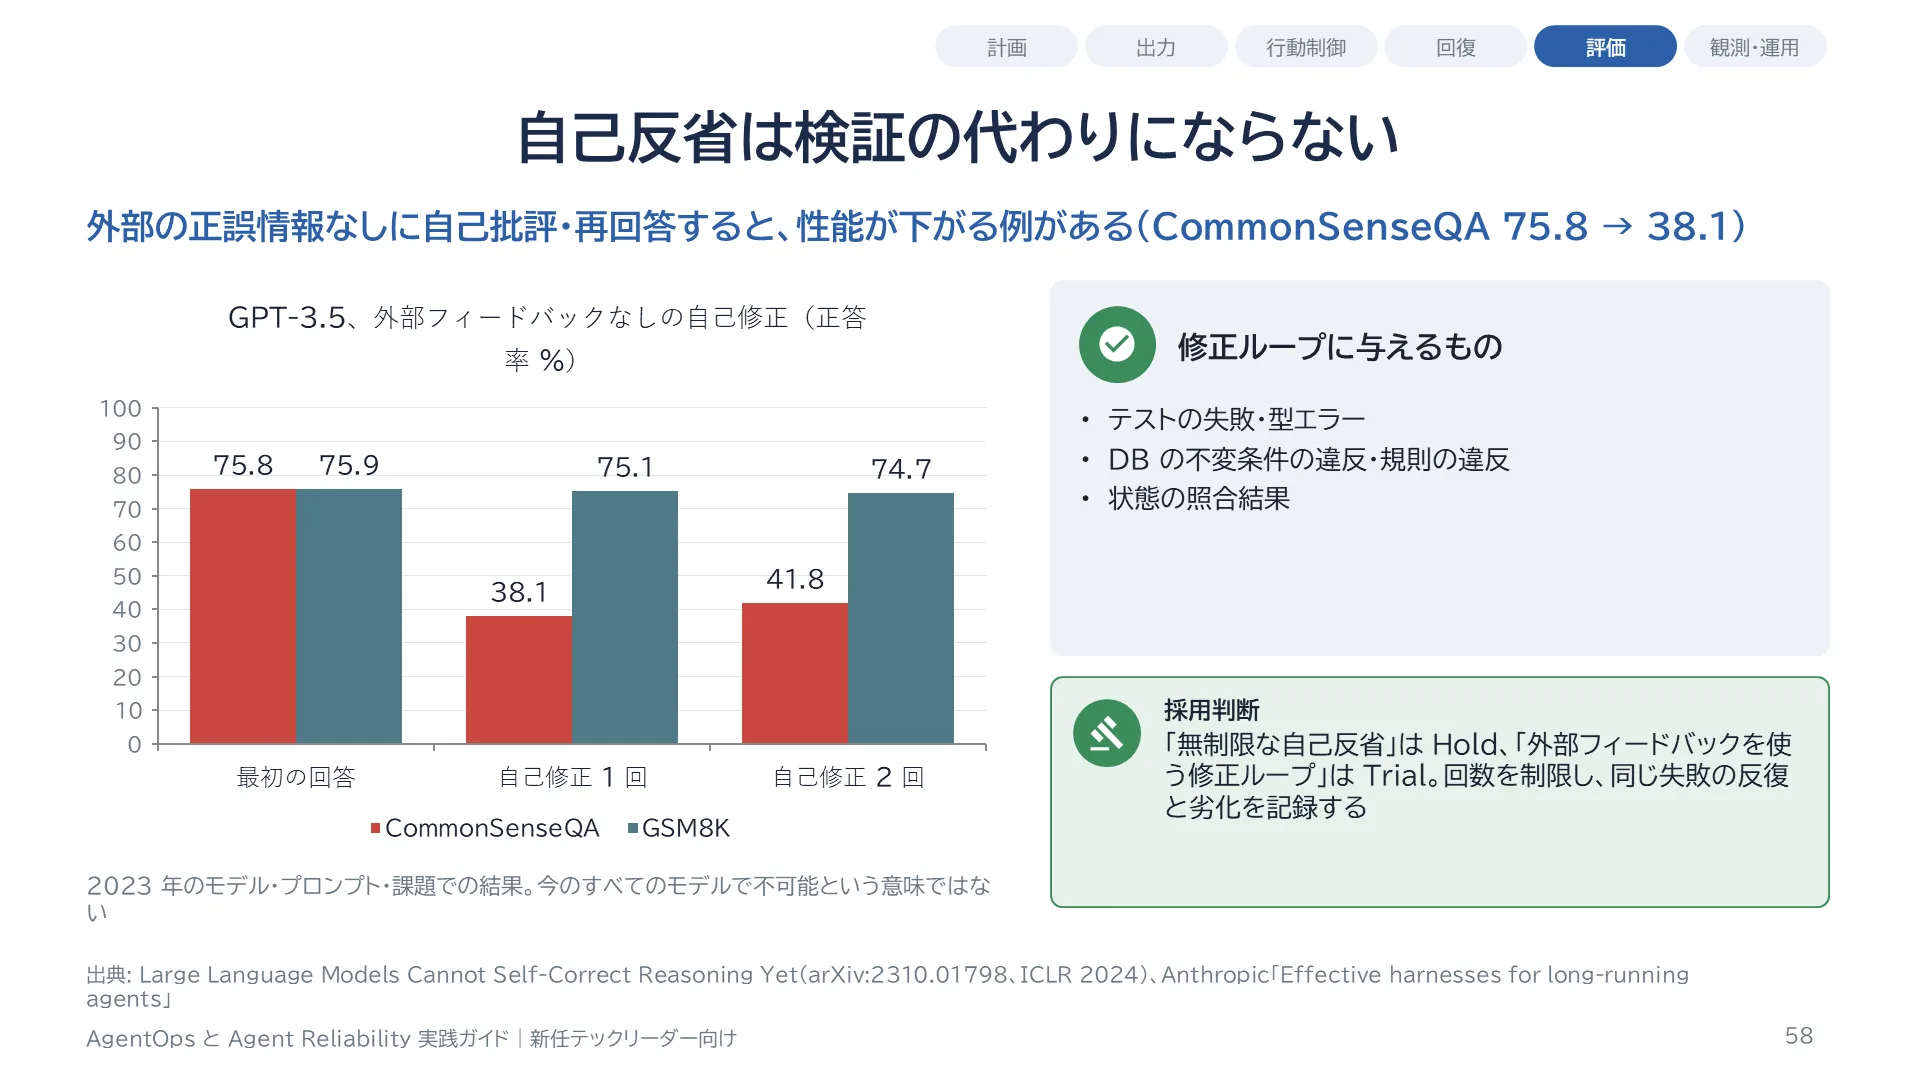
2023 年の自己修正の研究は、外部の正誤情報なしで、同じモデルが自分の回答を批評し、再回答する条件で、性能が下がる例を示しました。GPT-3.5 で、CommonSenseQA の正答率は 75.8% から、1 回目の自己修正で 38.1%、2 回目で 41.8% に下がりました。GSM8K では 75.9% から 75.1%、74.7% と、ほぼ変わらないか、わずかに下がりました。これは当時のモデルとプロンプトと推論課題での結果で、今のすべてのモデルで自己修正が不可能という意味ではありません。しかし、「もう一度考えさせる」だけを信頼性の保証にしない根拠になります。修正のループでは、テストの失敗、型エラー、DB の不変条件の違反、規則の違反といった、新しい外部の情報を与えます。修正の回数を制限し、同じ失敗の繰り返し、正解からの劣化、修正の費用を記録します。
スライド 59 のテキストと解説
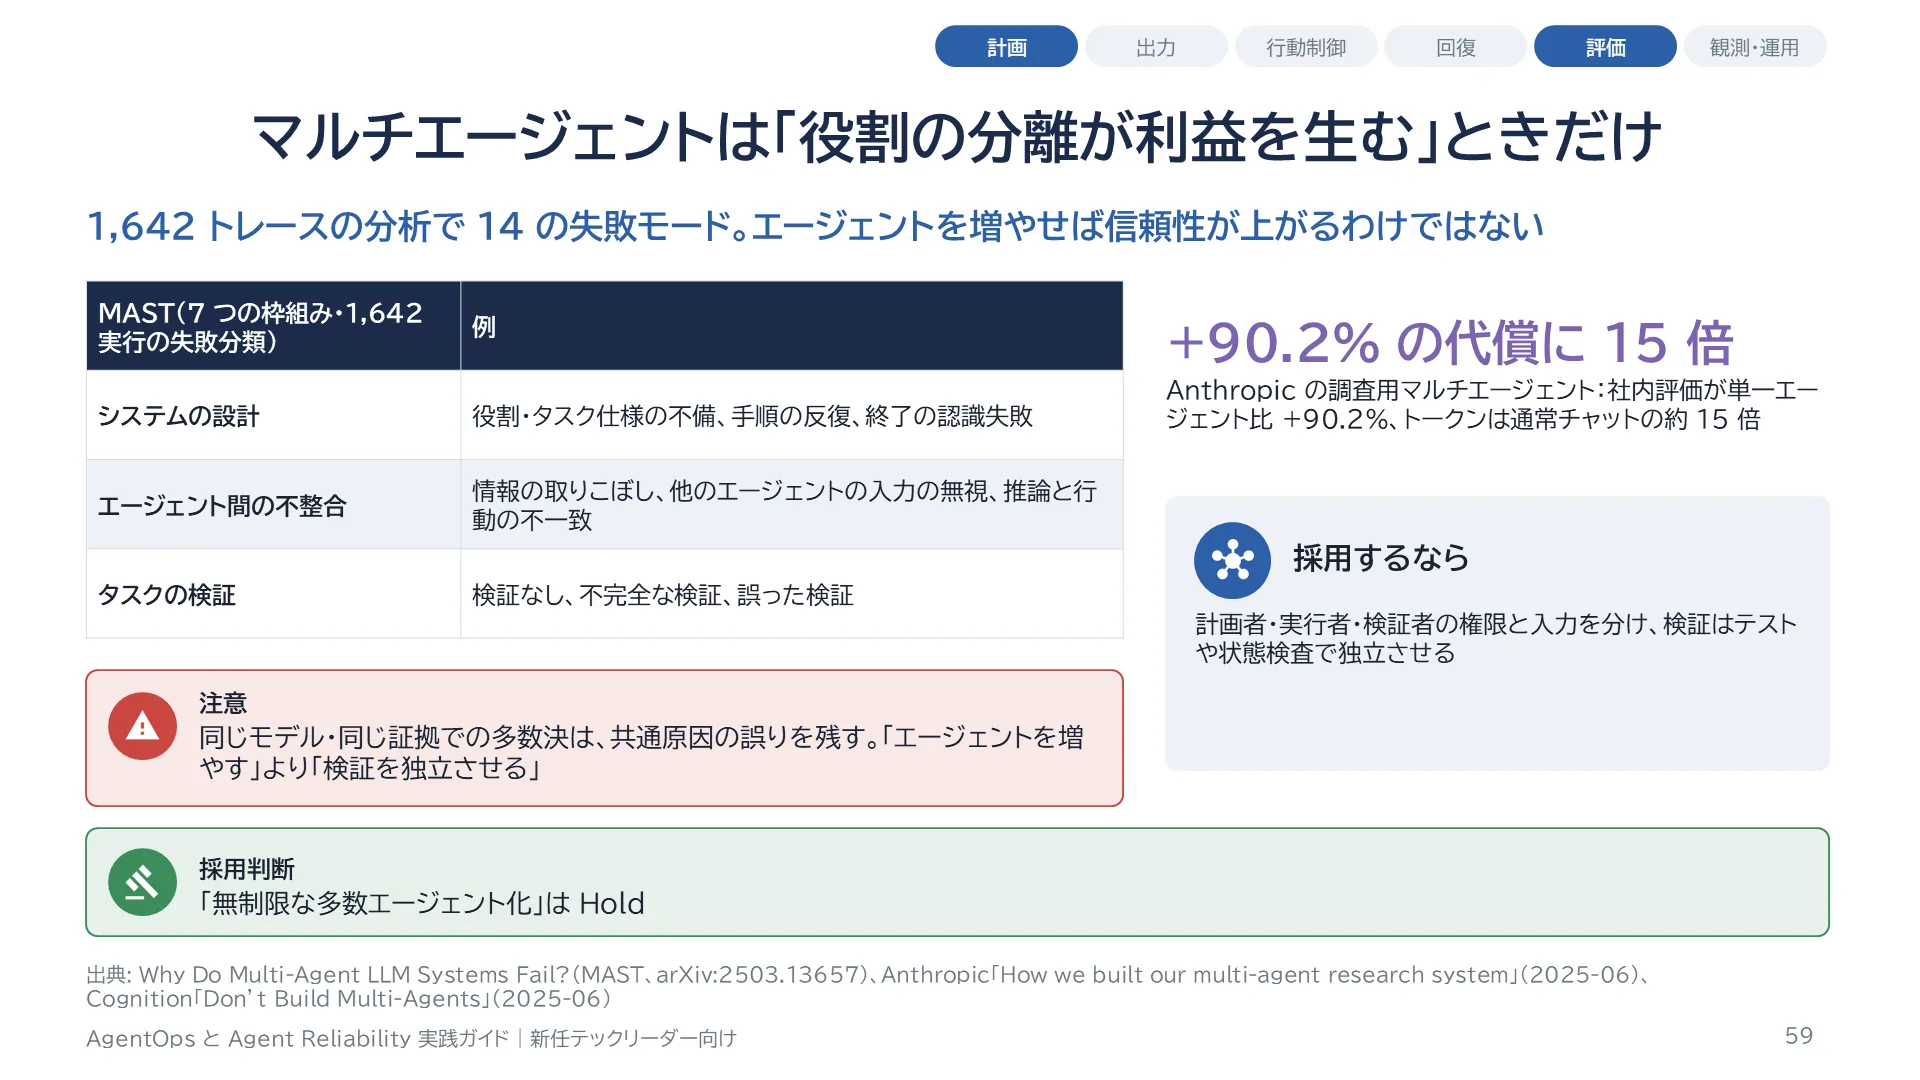
MAST の研究は、7 つのマルチエージェントの仕組みの 1,642 のトレースから、14 の失敗モードを、システムの設計、エージェント間の不整合、タスクの検証の 3 つに整理しました。小さな介入で成功率が上がる条件もありましたが、有意な改善が得られない条件もありました(AG2 のトポロジー変更は p=0.4)。手順の反復が 15.7%、終了の認識の失敗が 12.4% と、ループの制御に関わる失敗も多く報告されています。一方、Anthropic の調査用マルチエージェントは、単一エージェント比で社内評価が 90.2% 高かった代わりに、トークンは通常のチャットの約 15 倍でした。Cognition は、文脈が断片化して判断が衝突するとして、マルチエージェントを安易に作らないよう主張しています。採用するなら、計画者、実行者、検証者のアクセス権と入力を分け、検証者が実行者の結論をそのまま受け入れない設計にします。同じモデルと同じ証拠での多数決では共通原因の誤りが残るので、テストや状態検査の独立性を優先します。
スライド 60 のテキストと解説
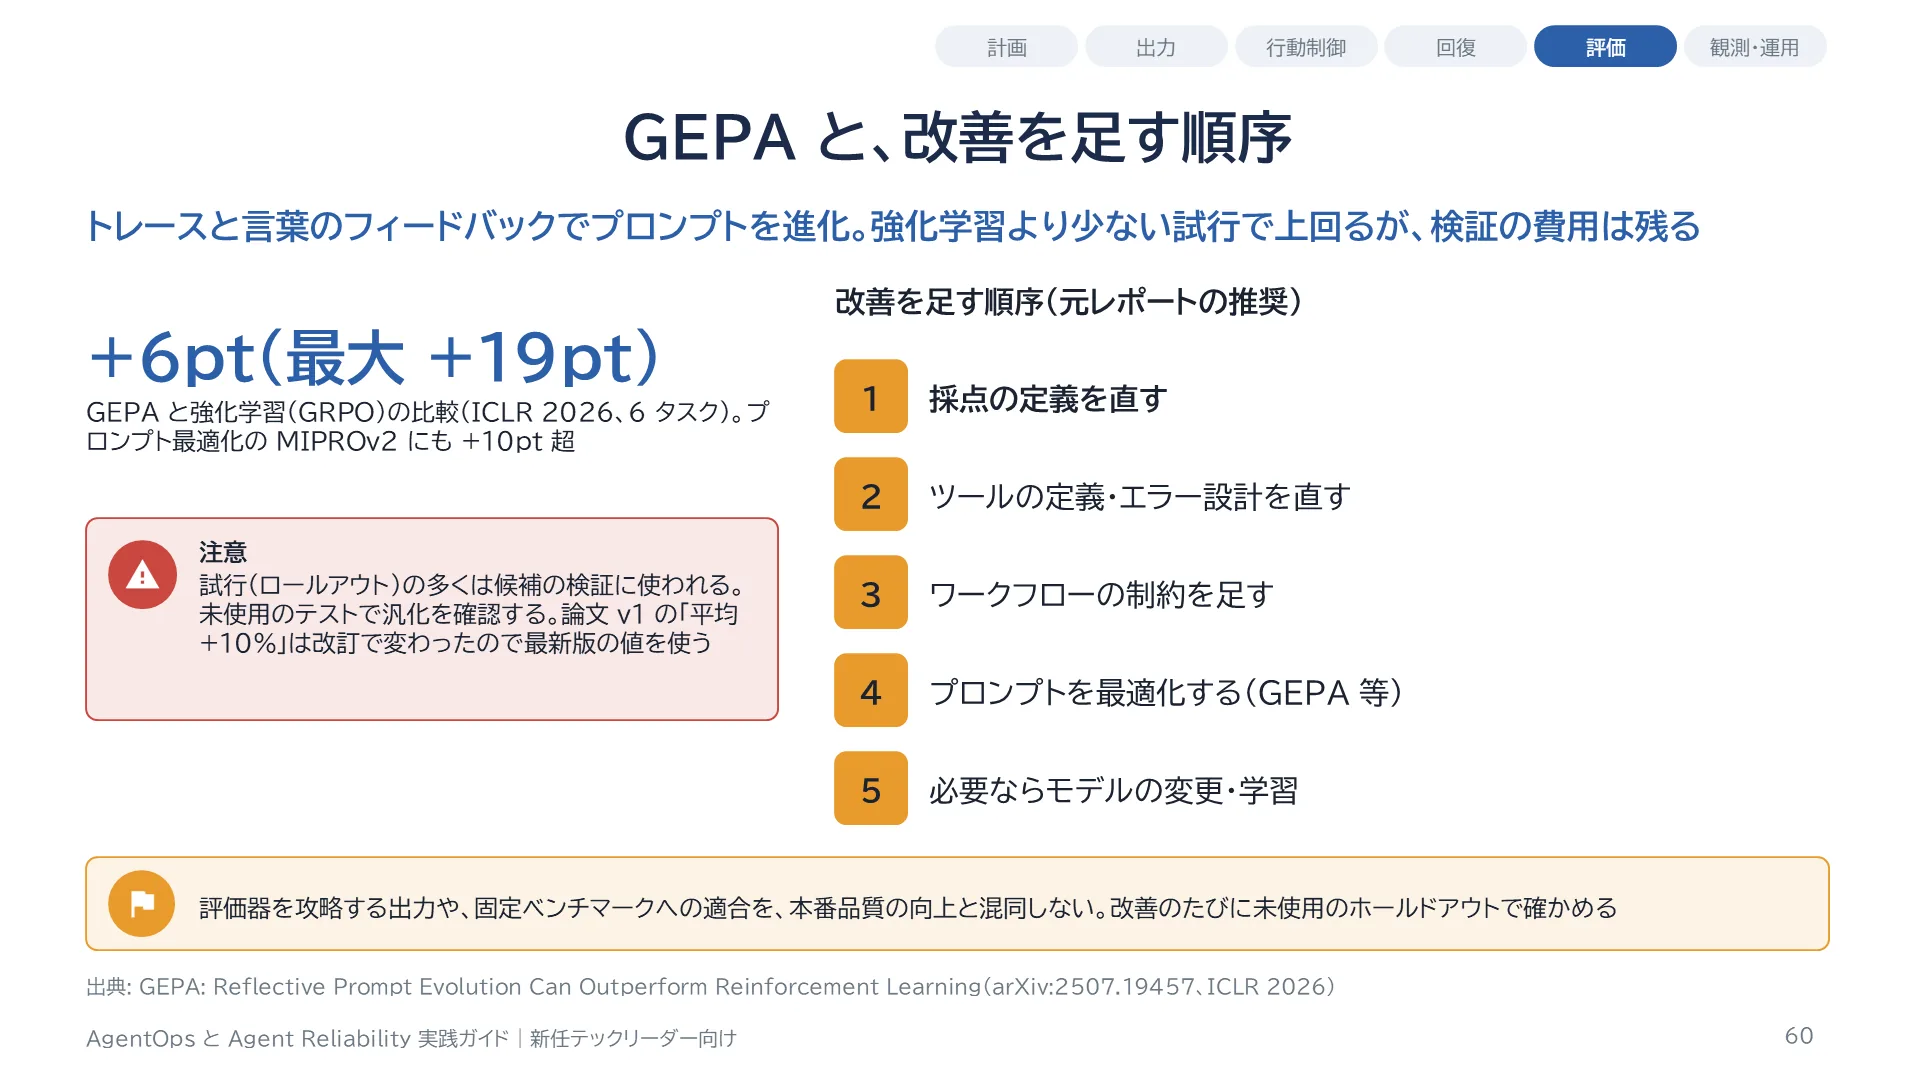
GEPA は、実行のトレースと自然言語のフィードバックからプロンプトを更新し、候補をパレート選択や組み合わせで進化させて、複合的なシステムを最適化します。ICLR 2026 の抄録は、6 つのタスクで、強化学習の GRPO を平均 6 ポイント、最大 19 ポイント上回り、プロンプト最適化の MIPROv2 を 10 ポイント超上回ったと報告しています。ただし、タスク、モデル、学習の設定をまたぐ普遍的な優位を意味しません。本文の実験では、検証用のロールアウトが予算の大きな部分を占め、候補の組み合わせが改善しない条件もありました。「プロンプトの最適化なら安い」と決めつけず、最適化、検証、再評価までの総費用と、使っていないテストへの汎化を確かめます。元レポートが推奨する改善の順序は、採点の定義の修正、ツールの定義とエラーの設計、ワークフローの制約、プロンプトの最適化、必要に応じたモデルの変更や学習、です。
スライド 61 のテキストと解説
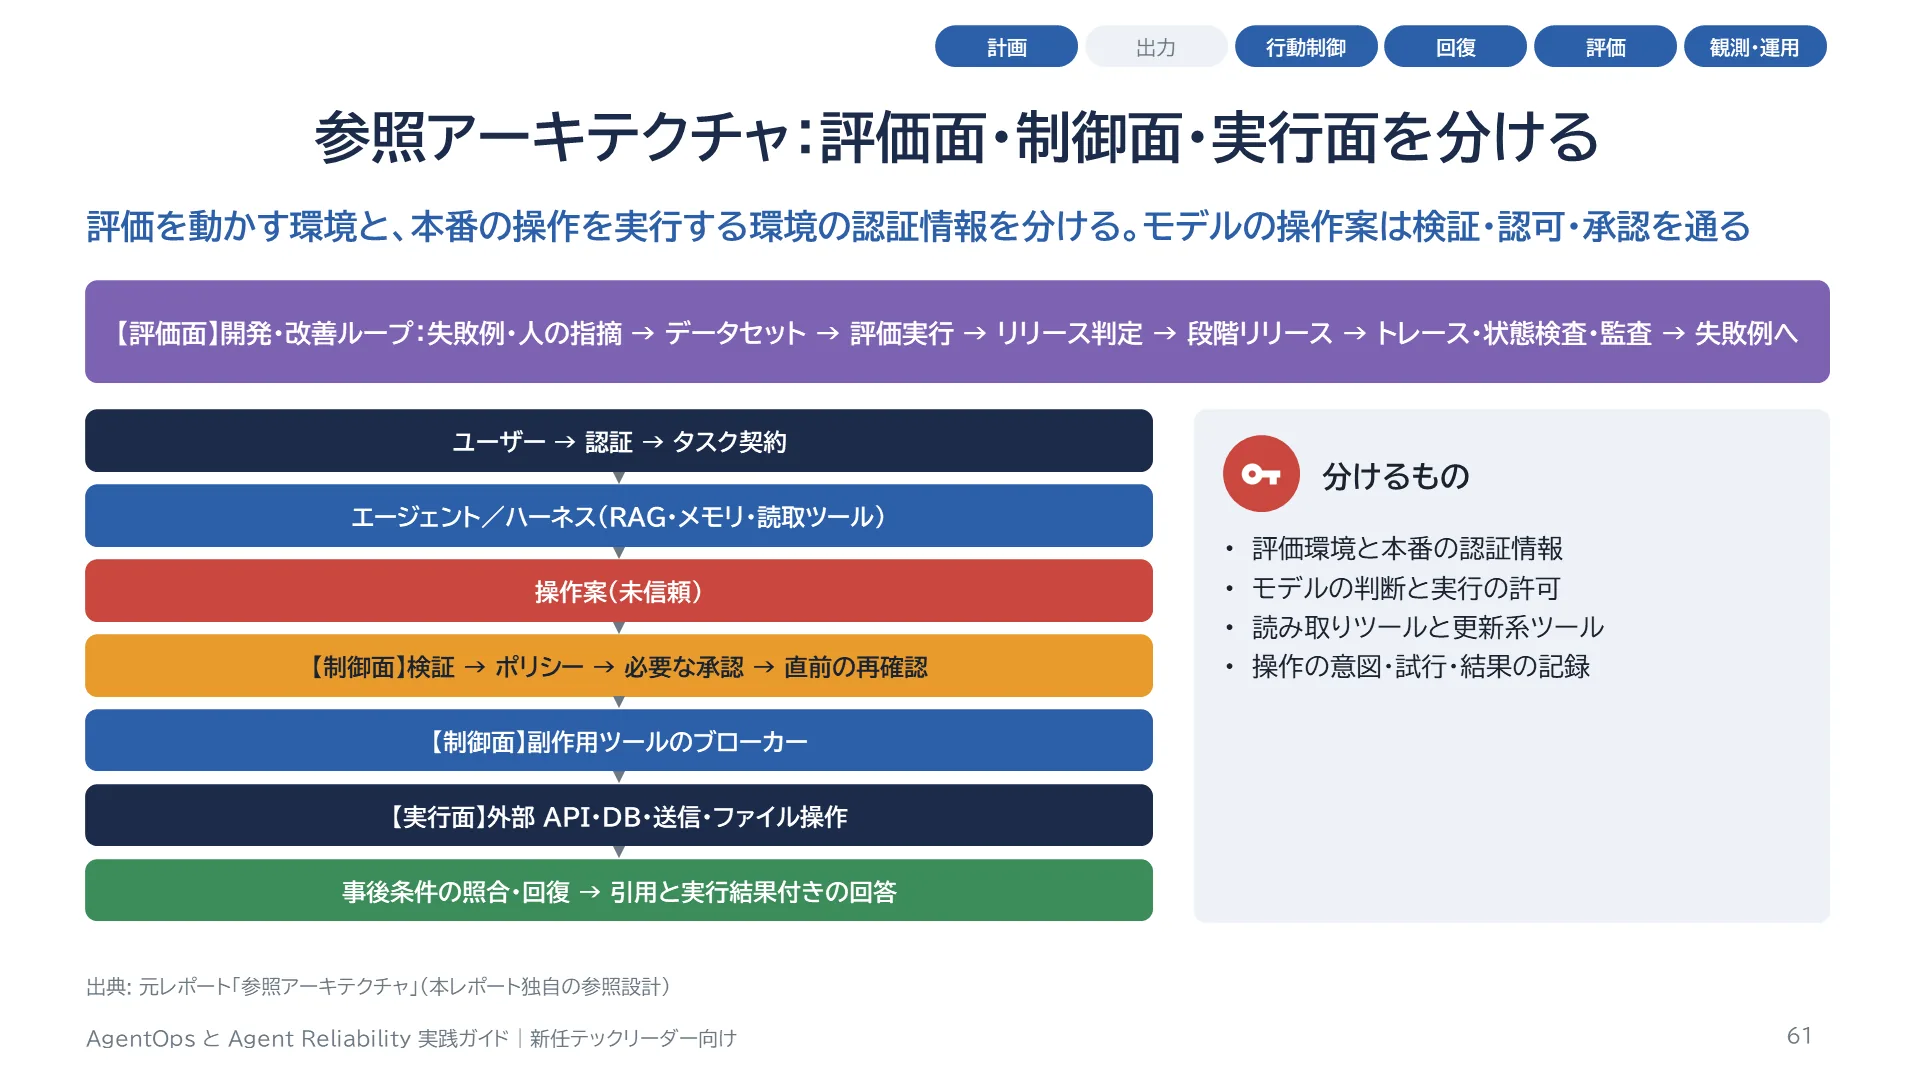
元レポート独自の参照設計です。上半分は開発と改善のループで、失敗例や人の指摘をデータセットに入れ、評価を実行し、リリースを判定し、段階的にリリースし、トレースと状態検査と監査の結果を、また失敗例に戻します。下半分は本番の実行です。ユーザーは認証され、タスクの契約が決まり、エージェントとハーネスが、RAG やメモリや読み取りのツールを使って考えます。操作の案は未信頼として扱い、検証、ポリシー、必要な承認、直前の再確認を通って、副作用を持つツールのブローカーに渡ります。外部の API、DB、送信、ファイル操作の後は、事後条件の照合と回復の処理をして、引用と実行結果の付いた回答を返します。評価を動かす環境と、本番の操作を実行する環境の認証情報は分けます。
スライド 62 のテキストと解説
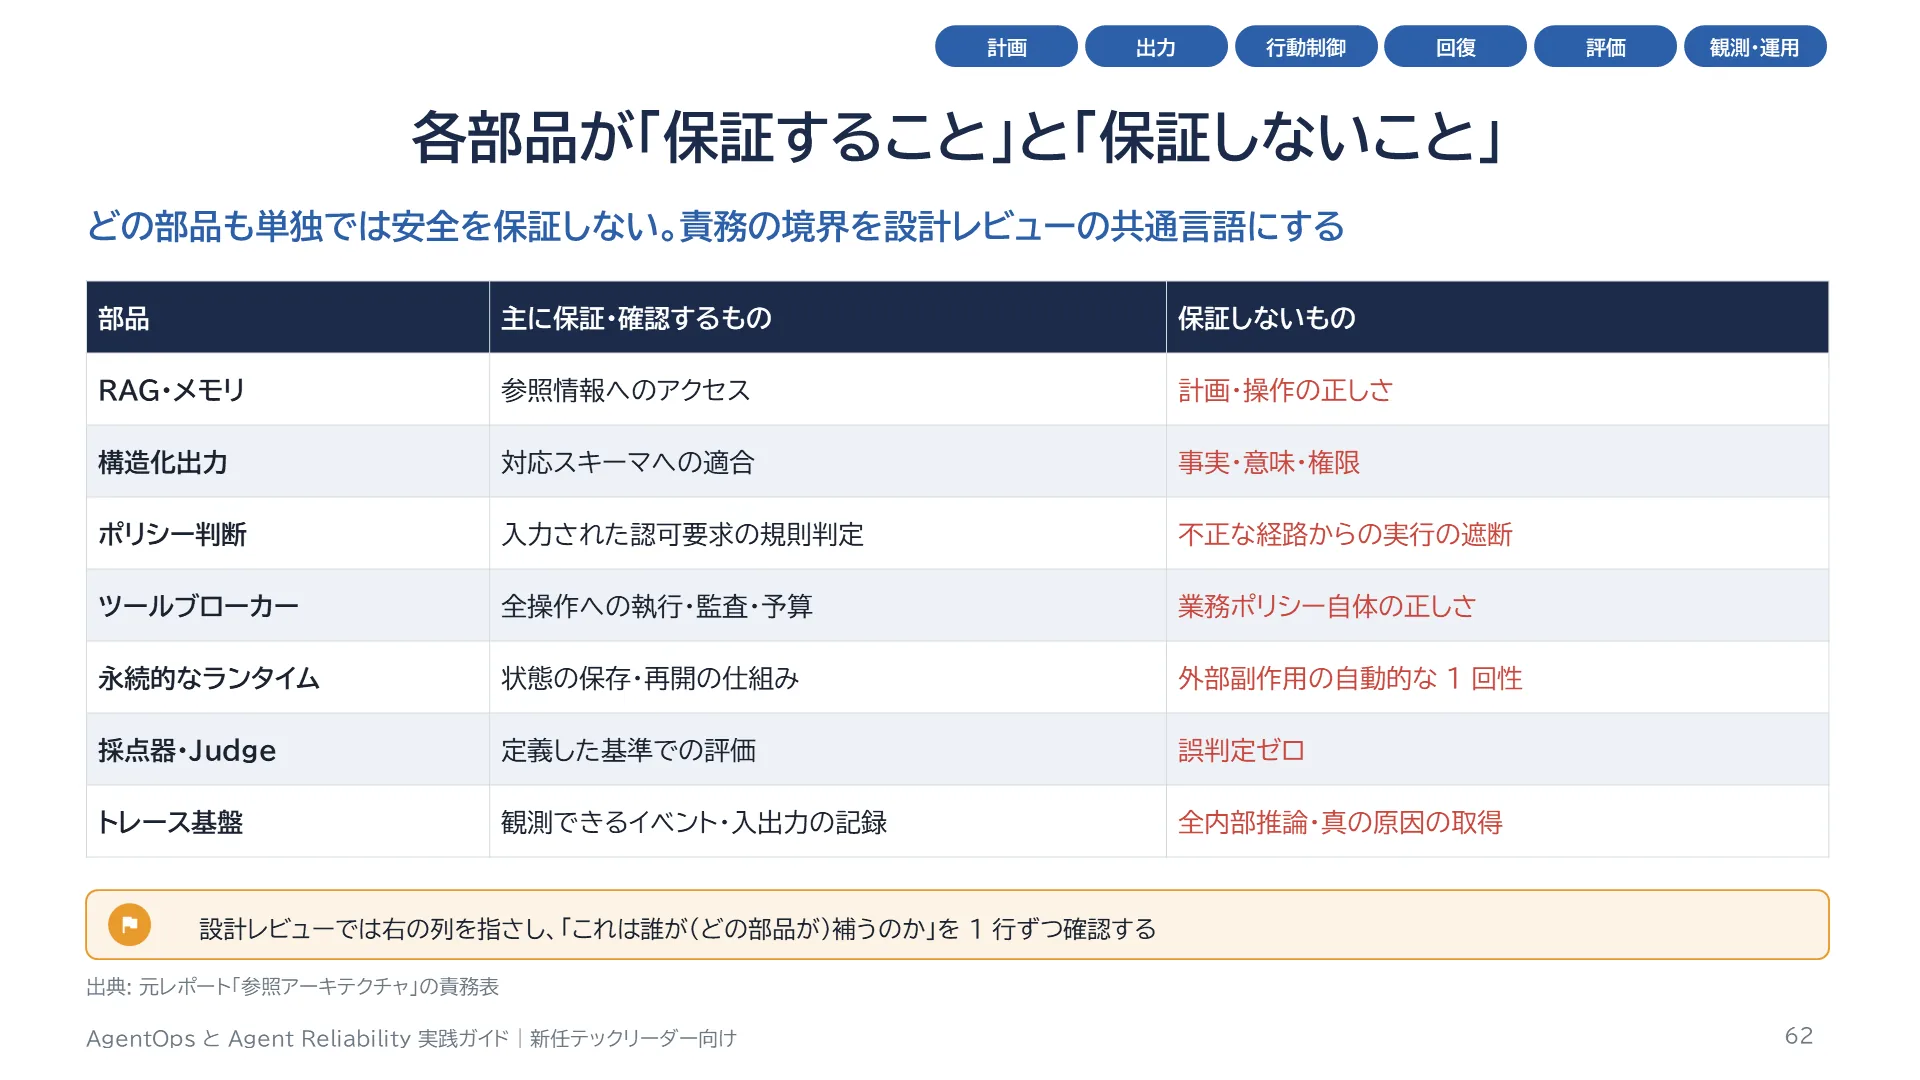
参照アーキテクチャの各部品が、主に保証・確認するものと、保証しないものの表です。RAG とメモリは参照情報へのアクセスを担いますが、計画や操作の正しさは保証しません。構造化出力はスキーマへの適合で、事実や意味や権限は保証しません。ポリシーの判断は入力された認可要求の規則判定で、不正な経路からの実行の遮断はしません。ツールブローカーは全操作への執行、監査、予算を担いますが、業務ポリシー自体の正しさは保証しません。永続的なランタイムは状態の保存と再開で、外部の副作用が自動で一度だけになることは保証しません。採点器は定義した基準での評価で、誤判定ゼロではありません。トレース基盤は観測できるイベントと入出力の記録で、すべての内部推論や真の原因を取れるわけではありません。設計レビューでは、この表の右の列を誰が補うのかを確認します。
スライド 63 のテキストと解説
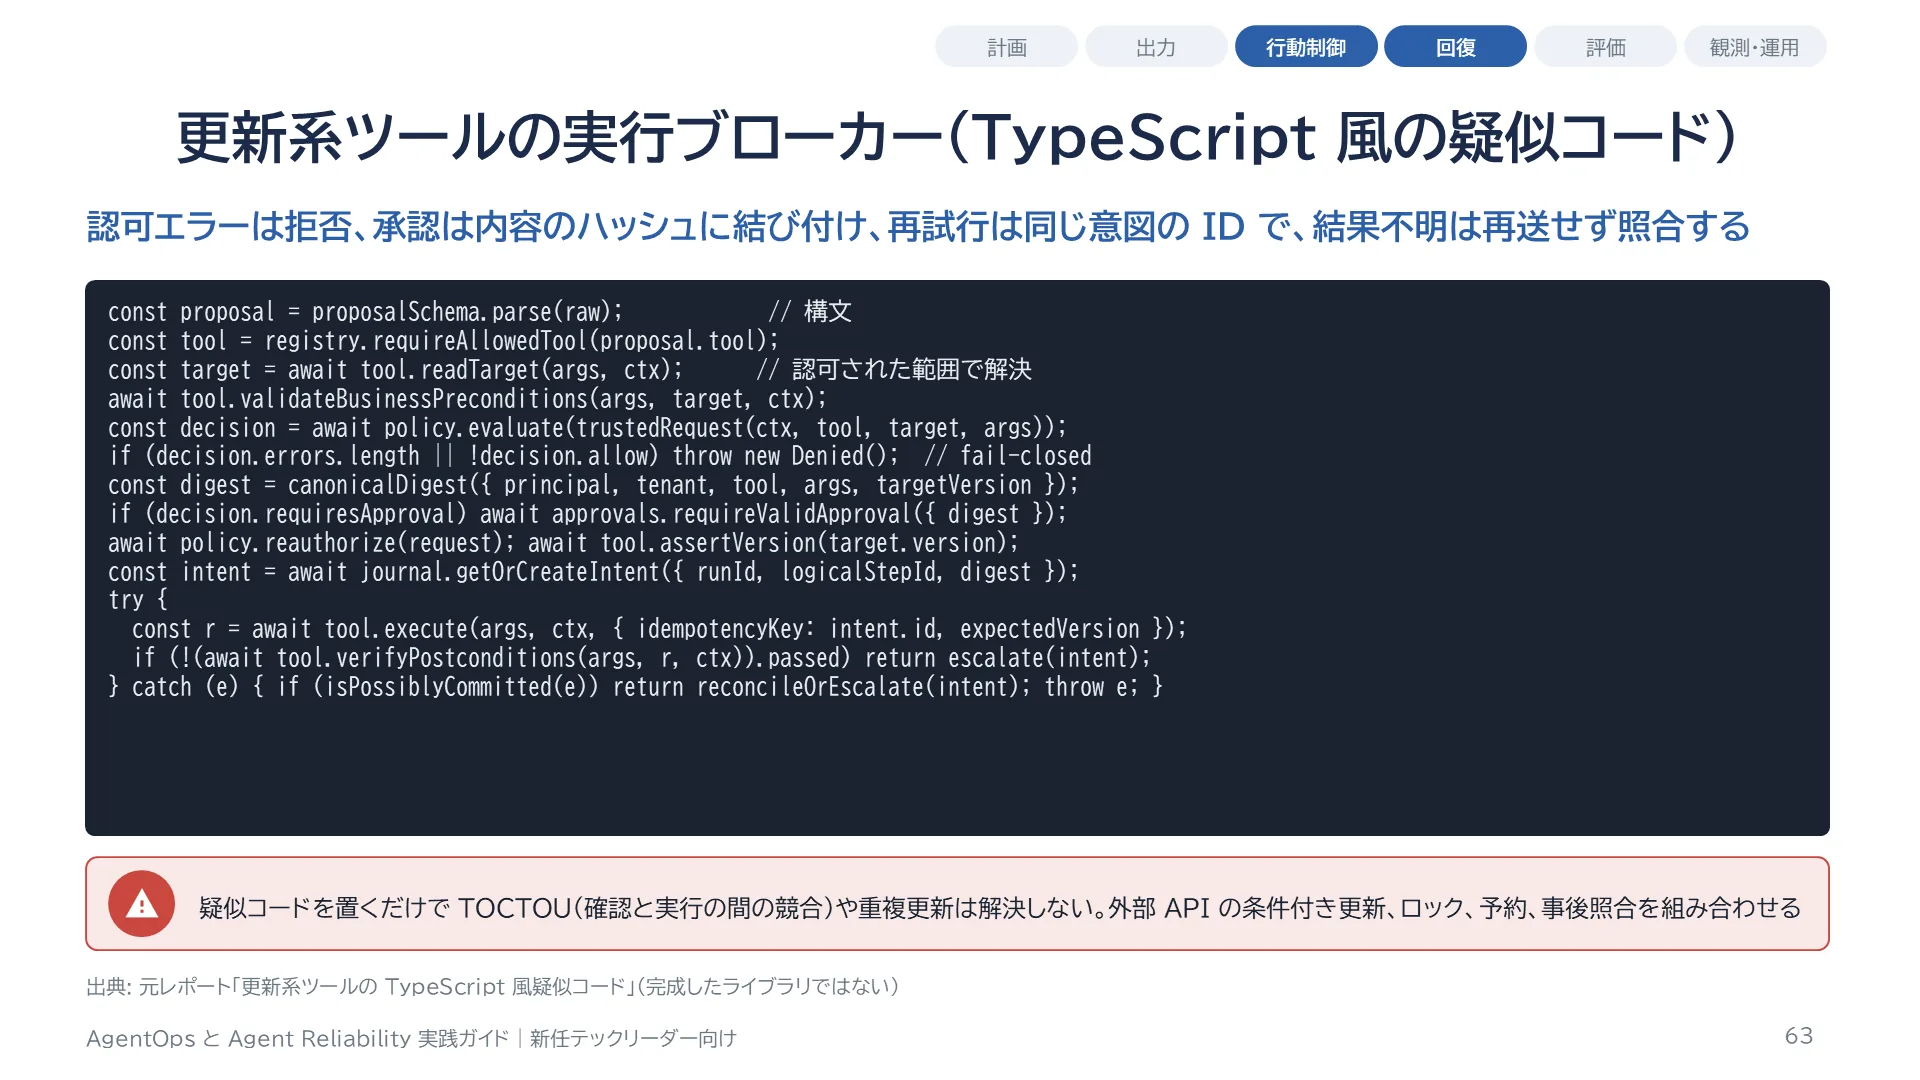
元レポートの疑似コードを要約したものです。モデルの提案をスキーマで検証し、許可されたツールか確かめ、対象を認可された範囲で読み、業務の前提条件を確かめます。ポリシーを評価し、エラーが 1 件でもあれば拒否します。主体、テナント、ツール、引数、対象の版から操作内容のハッシュを作り、承認が必要ならそのハッシュに結び付いた有効な承認を求めます。承認待ちの間の権限の失効や対象の更新も再確認します。同じ業務操作の意図の再試行には同じキーを使うよう、意図を台帳から取得または作成し、その ID を冪等性キーにして、対象の版を期待値として渡して実行します。事後条件を検証し、失敗なら照合に回します。実行中のエラーで、外部で確定した可能性があるなら、単純に再送せず、照合するか人に引き継ぎます。版の確認と実行の間にも競合は起こり得るので、外部 API の条件付き更新で原子的に検証できるのが望ましく、対応しない API ではロック、予約、事後照合、手動介入などの別の設計が必要です。
スライド 64 のテキストと解説
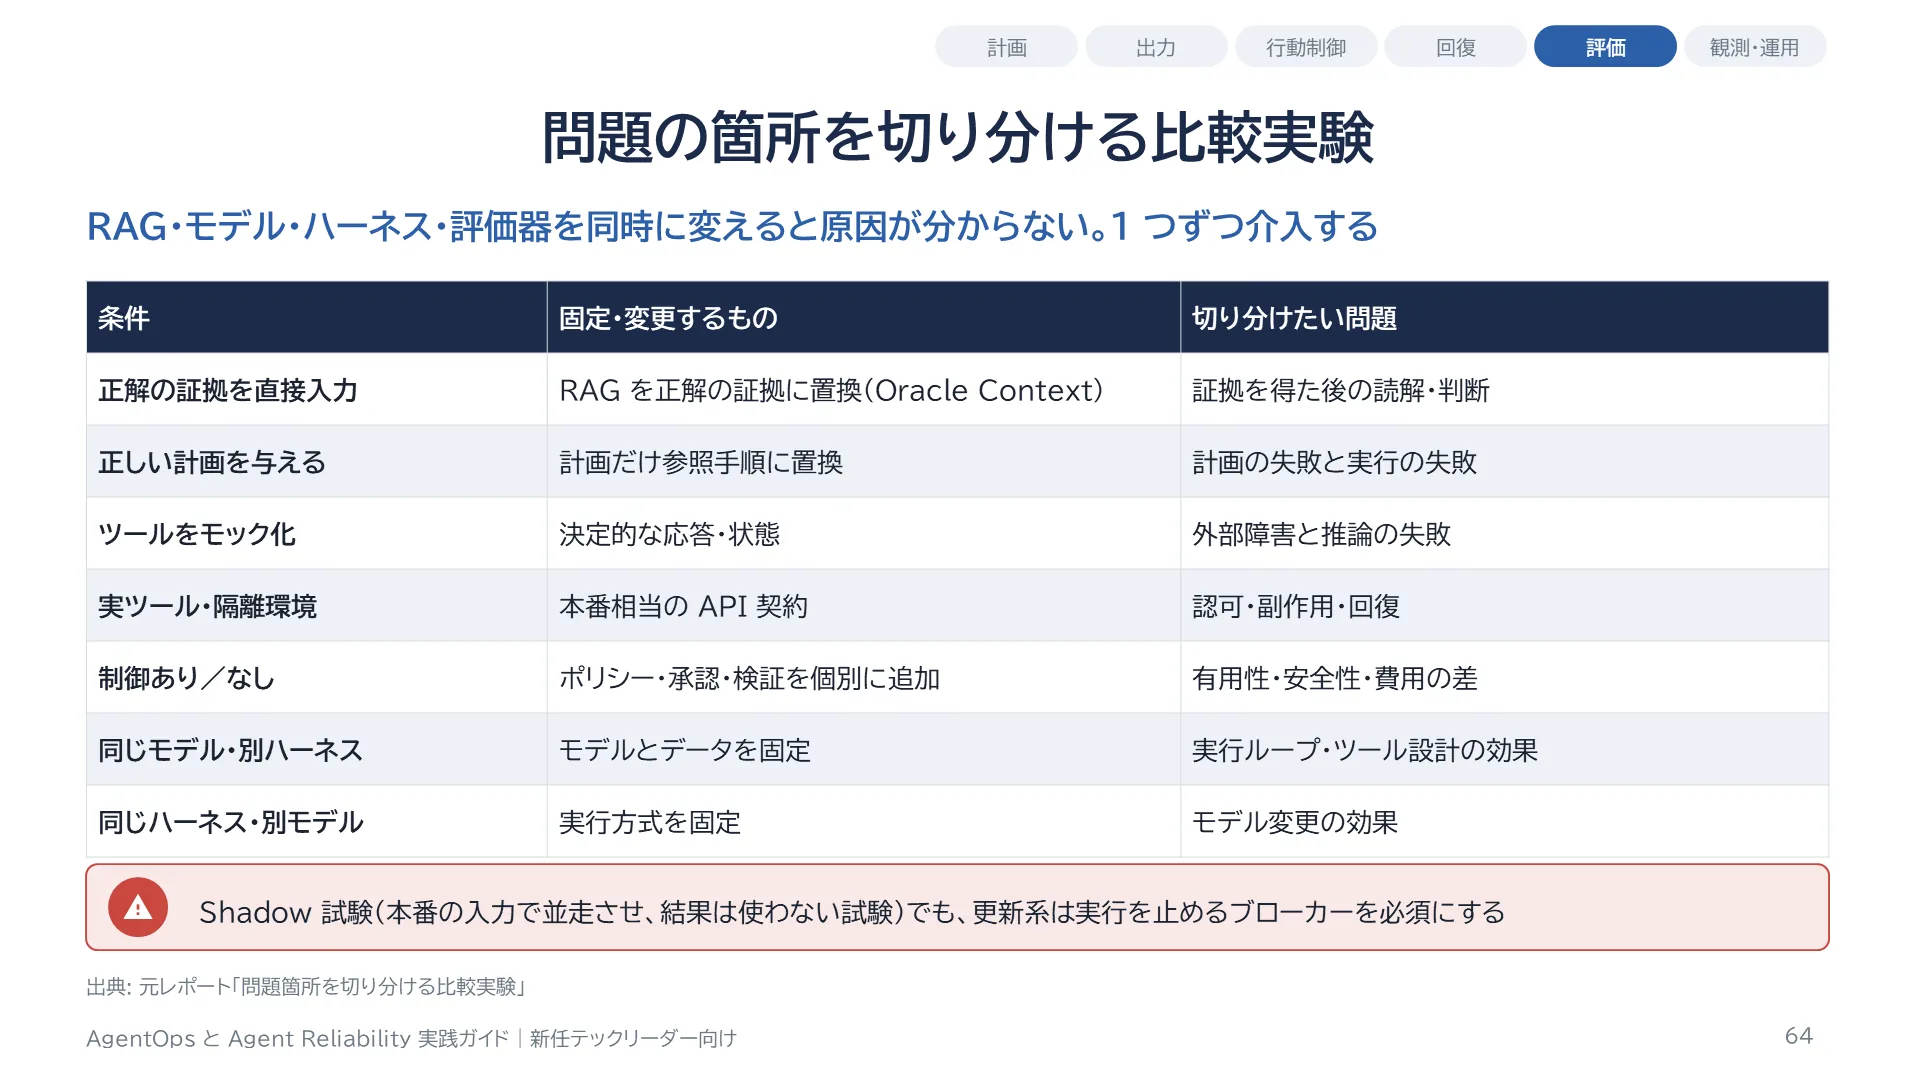
RAG、モデル、ハーネス、評価器を同時に変えると、改善の原因が分かりません。元レポートは次の実験の行列を提案しています。同じタスク、環境、予算、データの版を基本に、1 つずつ介入します。正解の証拠を直接入力すると、証拠を得た後の読解と判断を切り分けられます。正しい計画を与えると、計画の失敗と実行の失敗を分けられます。ツールをモックにすると、外部の障害と推論の失敗を分けられます。実ツールと隔離環境では、認可、副作用、回復を確かめます。制御のあり・なしを個別に足すと、有用性・安全性・費用の差が分かります。同じモデルで別のハーネス、同じハーネスで別のモデル、を比べると、それぞれの効果が分かります。モックだけでは本番の遅延や部分的な成功や権限の失効を再現できず、逆に本番の API に無制御に試験を流すことも避けます。更新系の Shadow 試験では、実行を止めるブローカーを必須にします。
スライド 65 のテキストと解説
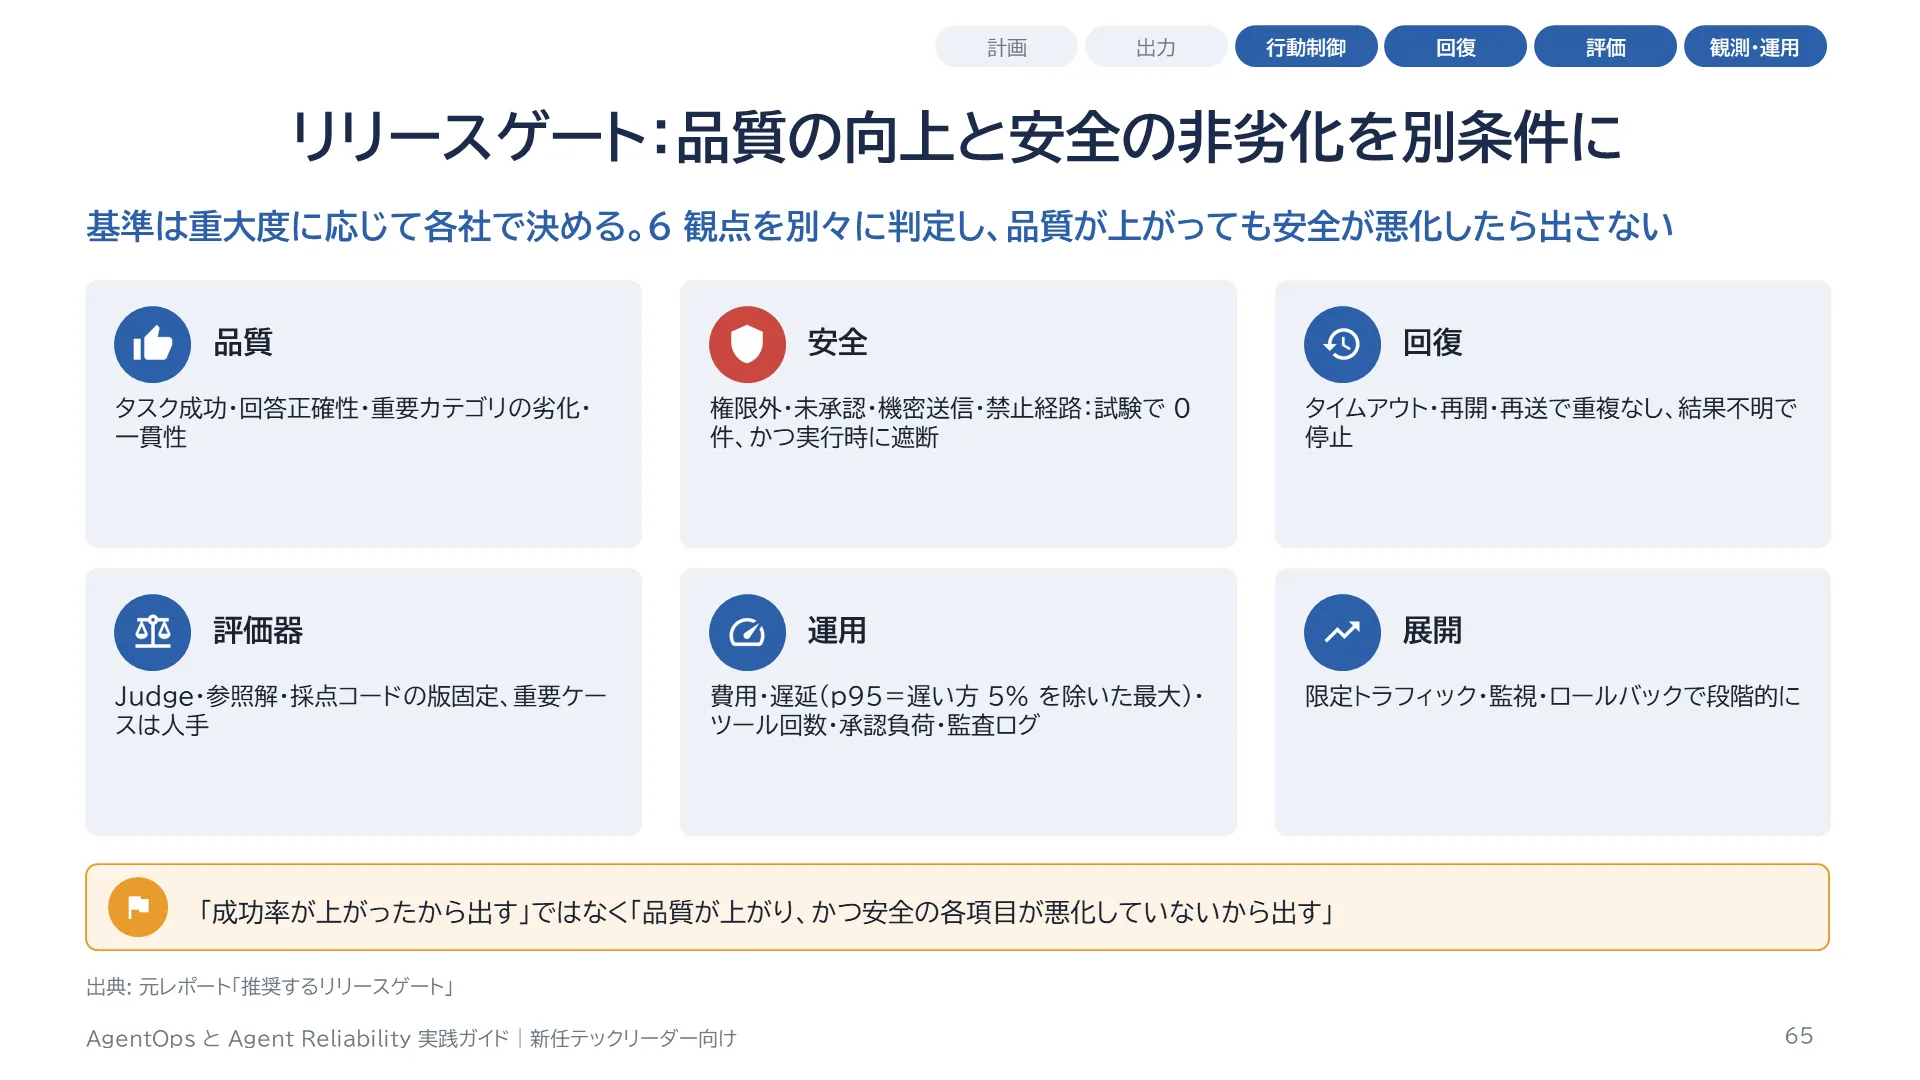
元レポートが提案するリリースゲートです。品質では、タスクの成功、回答の正確性、重要カテゴリの劣化、一貫性を確認します。安全では、権限外の操作、未承認の更新、機密の送信、禁止経路の使用を個別に検査します。回復では、タイムアウト、再開、再送で重複の副作用がないか、結果が不明なときに停止できるかを確かめます。評価器では、Judge、参照解、採点コードの版を固定し、重要ケースは人がレビューします。運用では、費用、p95 と p99 の遅延、ツールの回数、承認の負荷、監査ログの欠落を確認します。展開では、合格後も限定的なトラフィック、監視、ロールバックで段階的に広げます。品質が上がっても、安全の項目が 1 つでも悪化していれば出さない、というように、品質の向上と安全の非劣化を別の条件にするのがポイントです。
スライド 66 のテキストと解説
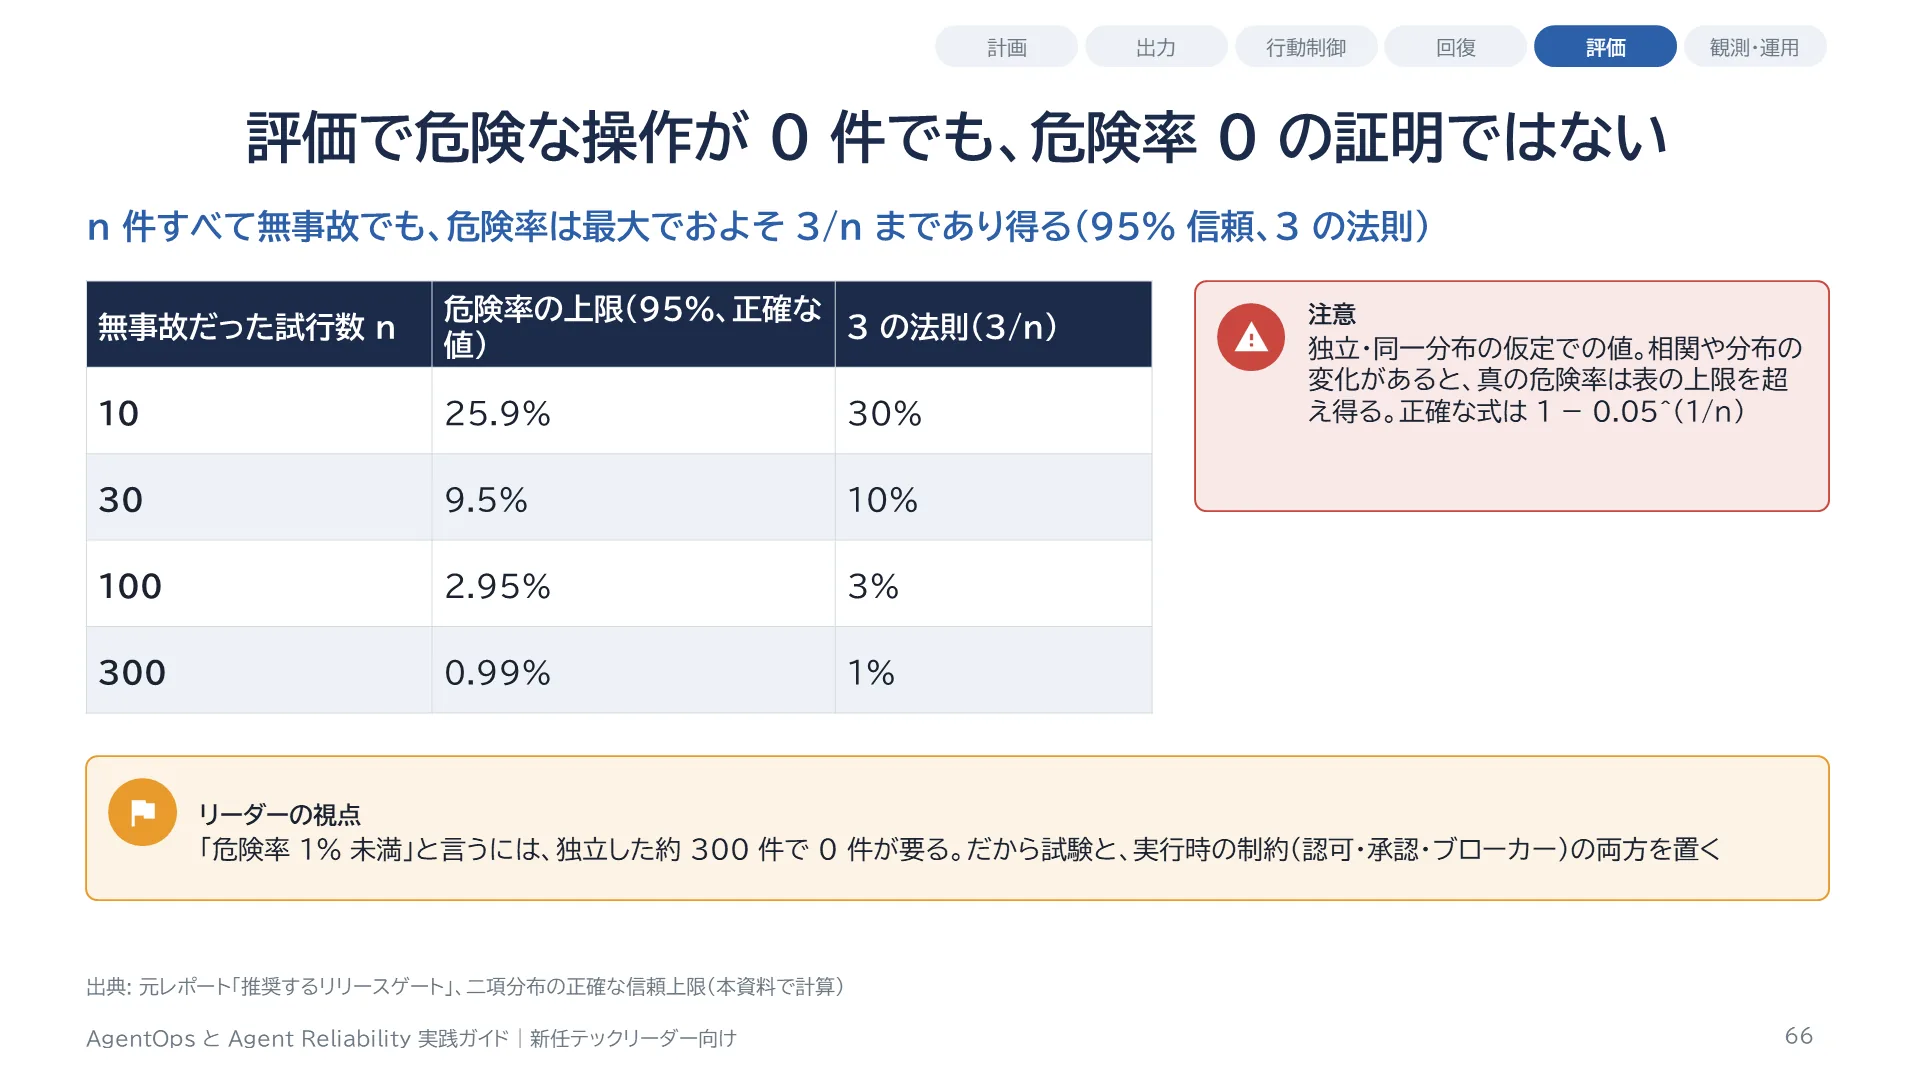
評価セットで危険な操作が 0 件だったとしても、本番の危険の確率が 0 だと証明したことにはなりません。独立で同じ確率の二項事象という強い仮定の下でも、n 件すべて無事故だったときの片側 95% の上限は、1 マイナス 0.05 の n 分の 1 乗です。これはおよそ 3 割る n で、3 の法則と呼ばれます。10 件で 0 件なら上限は約 26%、30 件で約 9.5%、100 件で約 3%、300 件で約 1% です。つまり、危険率 1% 未満を言いたければ、約 300 件の独立した試行で 0 件が必要です。実務では試行の間の相関や、分布の変化があるので、この上限はさらに楽観的です。だからこそ、試験だけに頼らず、実行時の制約(認可、承認、ブローカー)を両方置く必要があります。
スライド 67 のテキストと解説
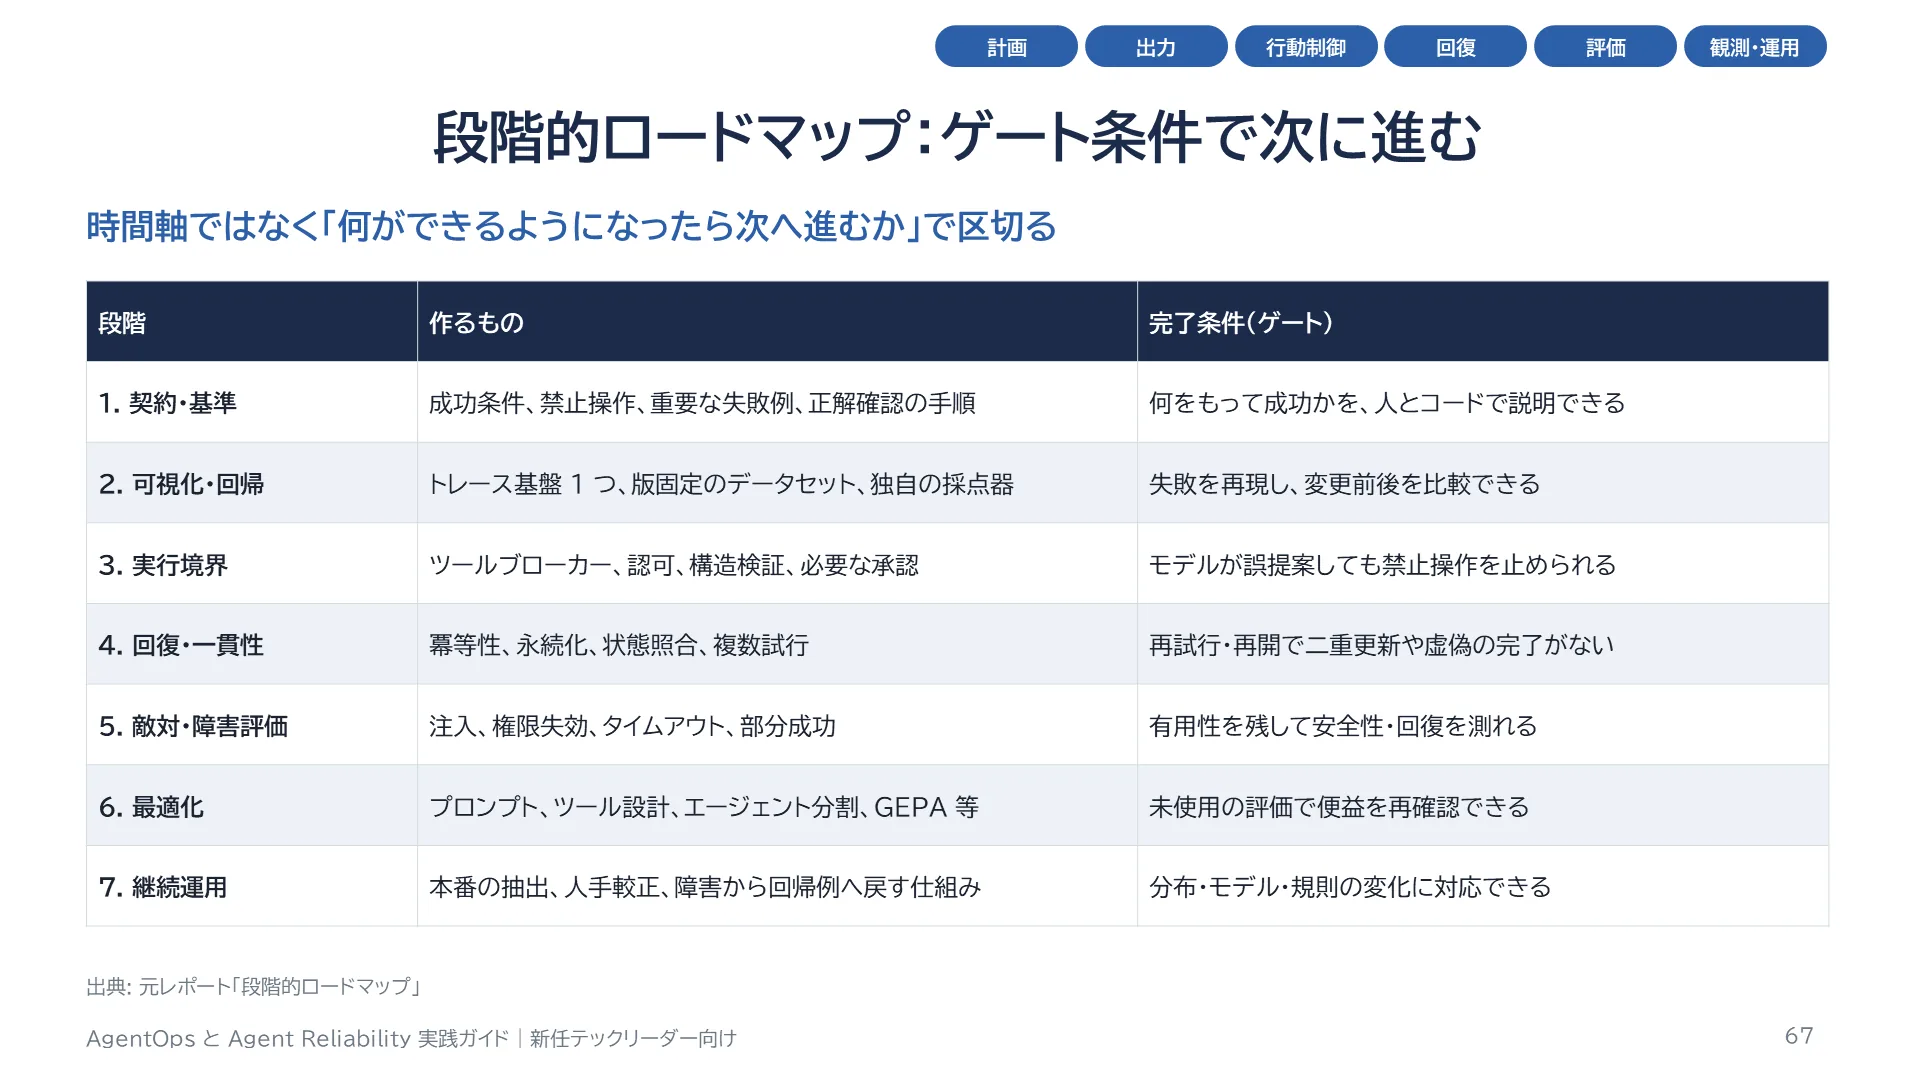
元レポートのロードマップは、時間ではなく完了の条件で区切られています。契約と基準の段階では、成功の条件、禁止の操作、重要な失敗例、正解の確認手順を作り、何をもって成功かを人とコードで説明できる状態にします。可視化と回帰の段階では、1 つのトレース基盤、版を固定したデータセット、独自の採点器を作り、失敗を再現して変更の前後を比べられるようにします。実行の境界の段階では、ツールブローカー、認可、構造の検証、必要な承認を入れ、モデルが誤った提案をしても禁止の操作を止められるようにします。回復と一貫性、敵対と障害の評価、最適化、継続運用と進みます。プロジェクト計画やステアリングコミッティへの報告は、このゲートの達成状況で語ると明確になります。
スライド 68 のテキストと解説
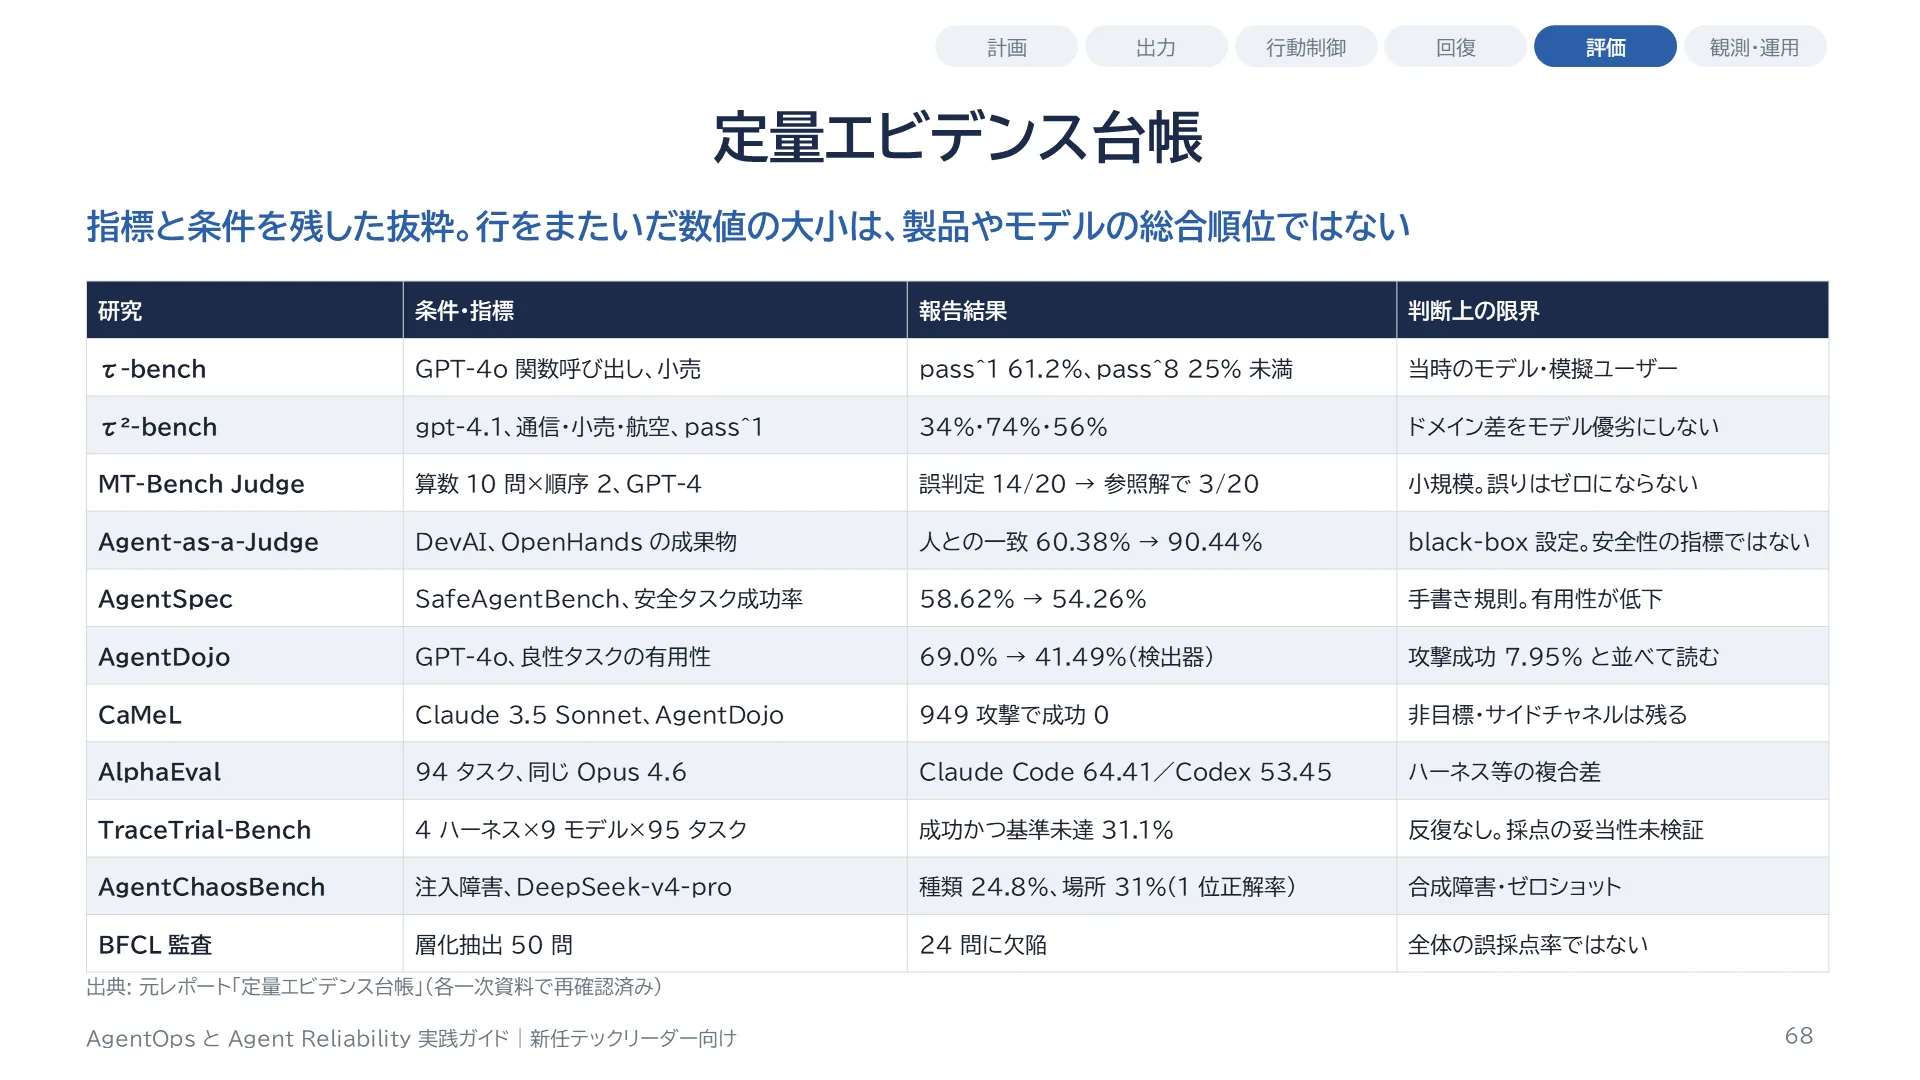
主な定量結果を、条件と指標を残して一覧にした台帳です。ステークホルダーやベンダーとの議論で「その数字は何を測ったものか」を確認するための早見表です。行をまたいで数値の大小を比べないでください。指標も条件もばらばらです。たとえば τ-bench の pass^8 と、AgentDojo の有用性と、BFCL の監査の割合は、まったく別のものを測っています。
スライド 69 のテキストと解説
Part 9 は、元レポートの外の資料も使った補足です。テックリーダーとしての実務を扱います。
スライド 70 のテキストと解説
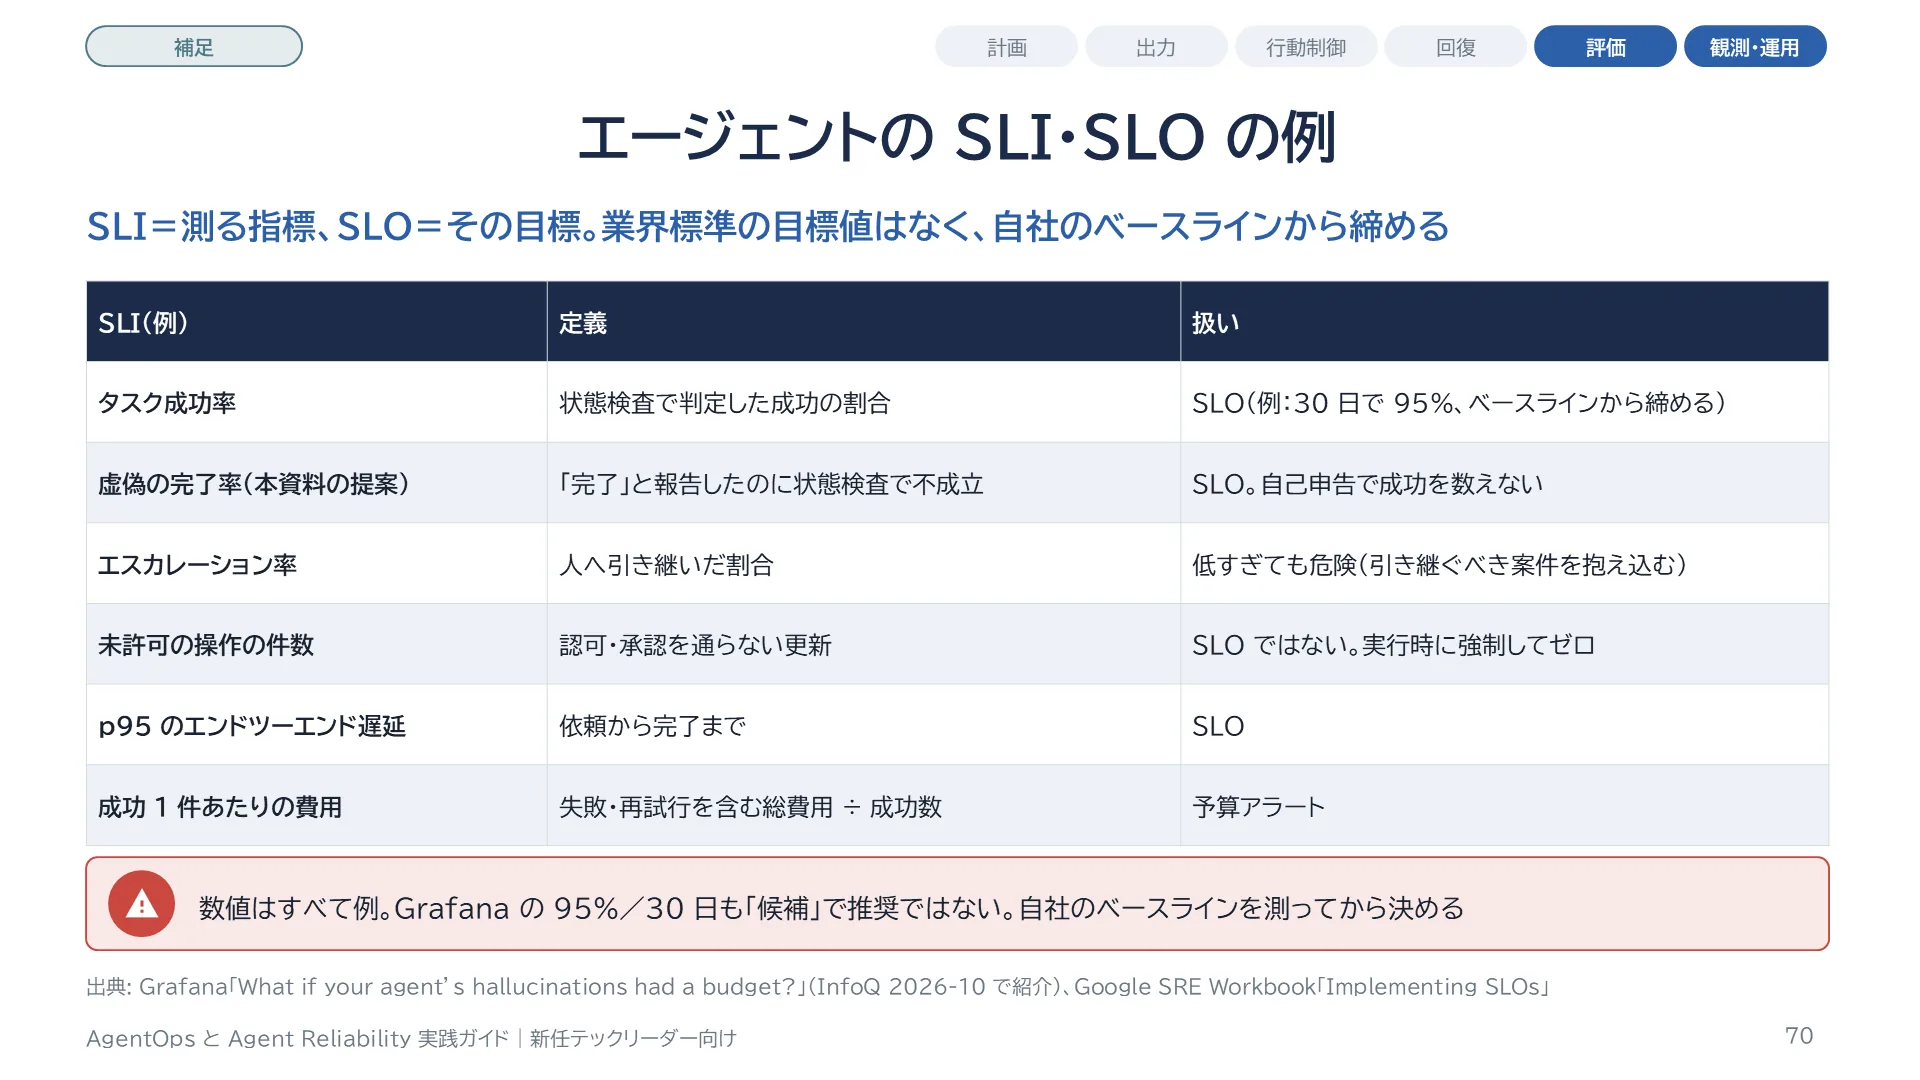
エージェントの SLO の公開例として、Grafana は「30 日間で会話の 95% が依頼を満たしたと判定される」ことを SLO にし、各会話を LLM の採点器か正規表現などの決定的なチェックで採点する方法を紹介しています。85%、95%、99% は候補として挙げているだけで、推奨値ではありません。始めはベースラインから設定し、成熟に合わせて締めていく方針です。業界標準の目標値はないので、スライドの数値はすべて例として扱ってください。本資料が提案する SLI は、状態検査で判定したタスク成功率、虚偽の完了率(完了と報告したのに状態検査で不成立だった割合。一次資料で SLI として定義された例は見つけておらず、元レポートの「自己申告で成功を判定しない」を指標にしたものです)、エスカレーション率、未許可の操作の件数(これは SLO ではなく実行時に強制してゼロにするもの)、p95 のエンドツーエンドの遅延、成功 1 件あたりの費用です。
スライド 71 のテキストと解説
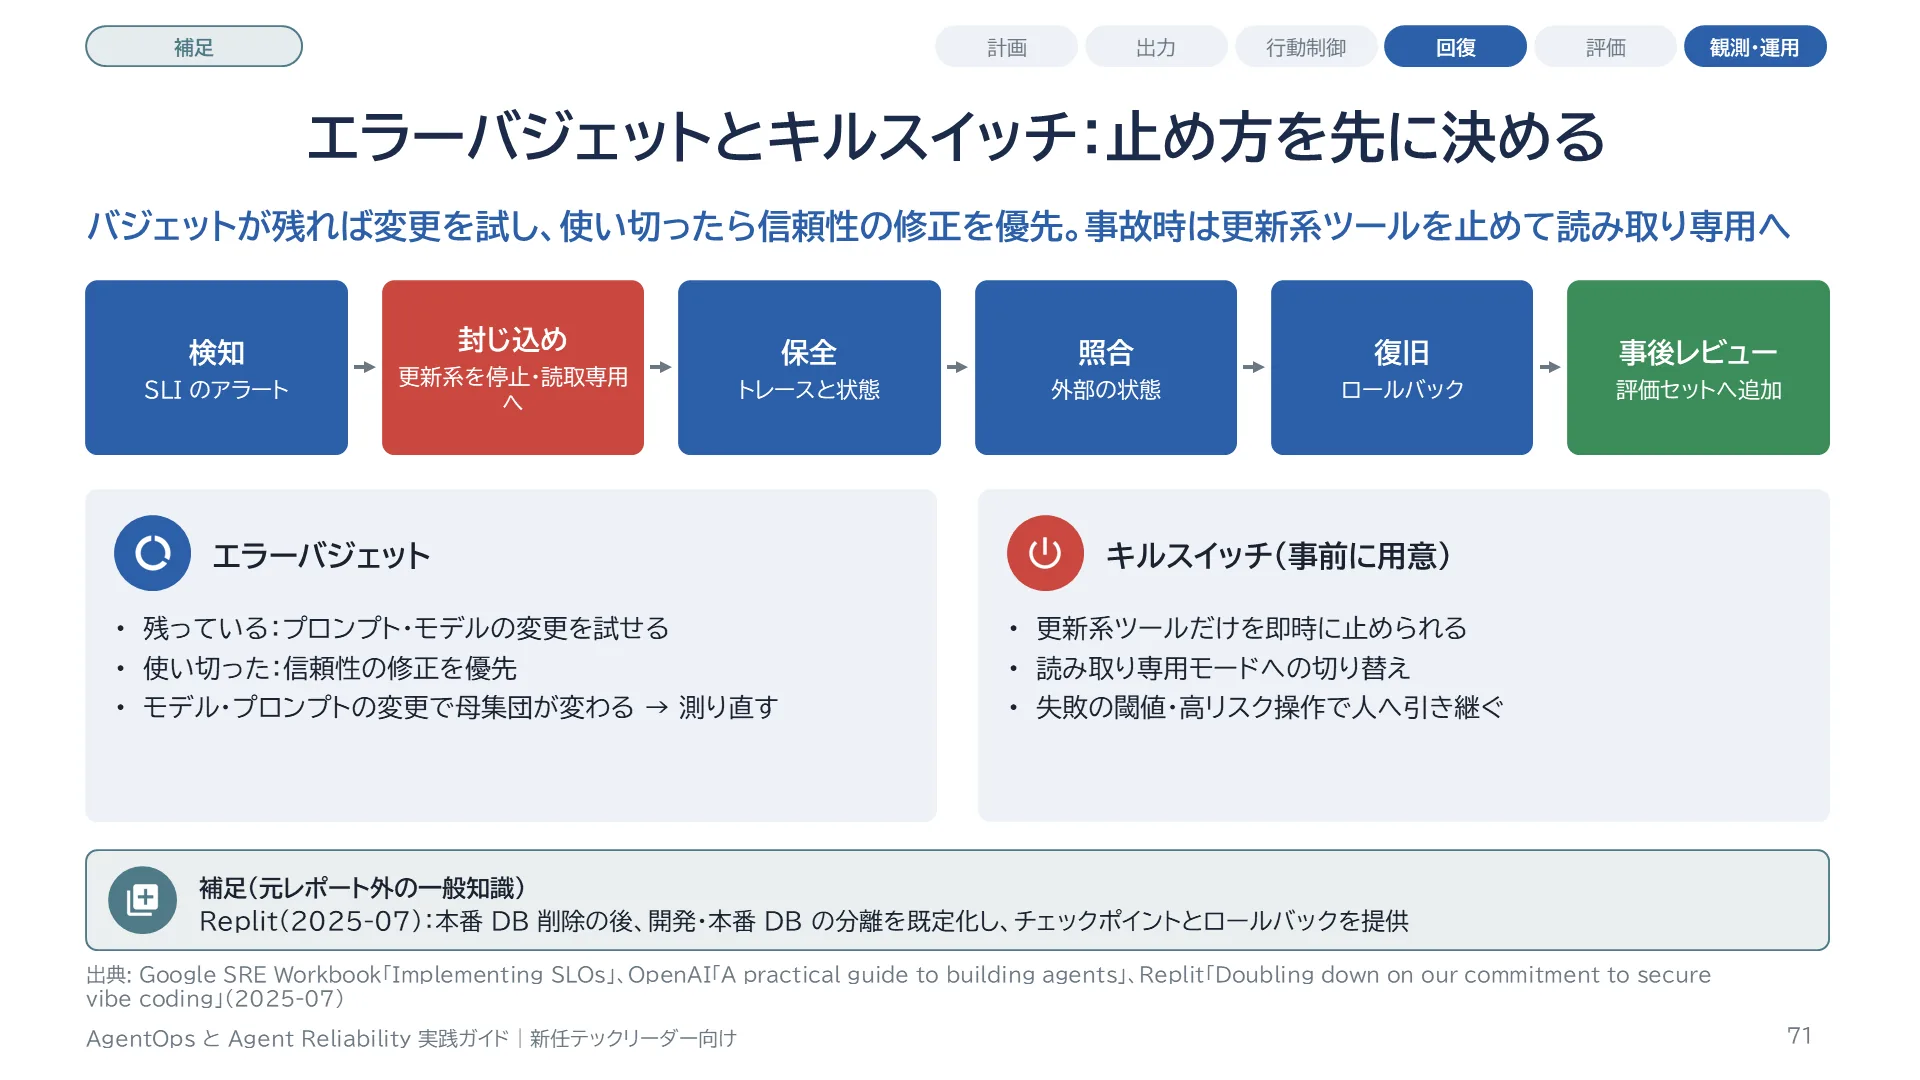
Google の SRE のエラーバジェットは、100% から SLO を引いた分の失敗を許容する考え方です。バジェットが残っていれば、プロンプトやモデルの変更を試せます。使い切ったら、新機能より信頼性の修正を優先します。エージェントでは、モデルやプロンプトを変えると成功率の母集団そのものが変わるので、変更のたびに測り直す必要があります。インシデントの対応では、止め方を先に決めておきます。OpenAI のガイドは、失敗の閾値を超えたとき、取り消せない高リスクの操作のときに、人に引き継ぐよう勧めています。本資料が提案するランブックの骨子は、検知、封じ込め(キルスイッチで更新系のツールを止めるか、読み取り専用に落とす)、トレースの保全、外部の状態との照合、復旧、事後レビューで原因を評価セットに追加する、の 6 段階です。Replit は 2025 年 7 月の本番 DB 削除の後、開発と本番の DB の分離を既定にし、チェックポイントとロールバックを提供しました。
スライド 72 のテキストと解説
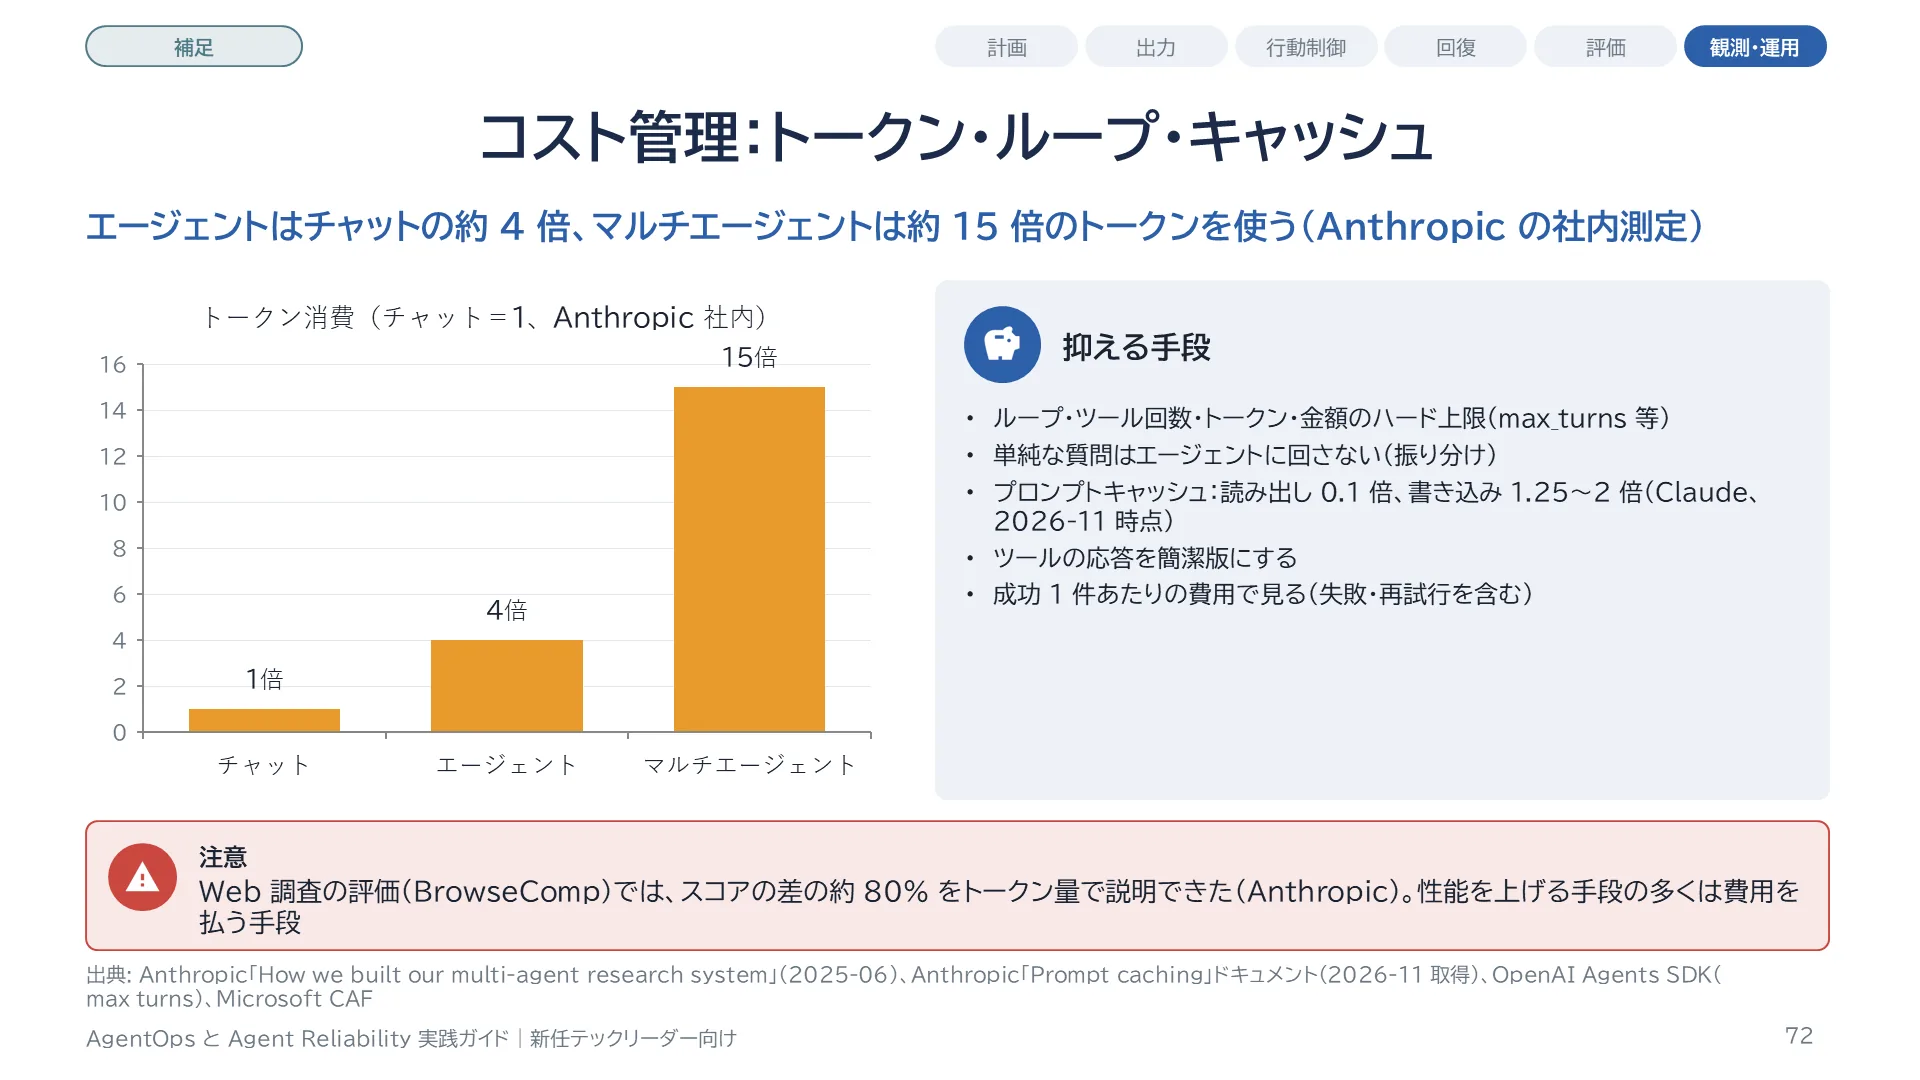
Anthropic の社内測定では、エージェントは通常のチャットの約 4 倍、マルチエージェントは約 15 倍のトークンを使いました。BrowseComp の評価では、性能の分散の約 80% をトークンの使用量だけで説明できたとしています。つまり、性能を上げる手段の多くは、費用を払う手段でもあります。努力量の目安として、単純な事実確認は 1 つのエージェントでツール呼び出し 3〜10 回、比較は 2〜4 のサブエージェントでそれぞれ 10〜15 回、と示しています。プロンプトキャッシュは、Claude の場合、書き込みが基本の入力単価の 1.25 倍(5 分の保持)または 2 倍(1 時間)、読み出しが 0.1 倍です(2026 年 11 月時点、モデルにより異なります)。キャッシュの最小の長さに満たないと、エラーなしでキャッシュされないので注意します。ループには上限を設け、OpenAI Agents SDK では max_turns を超えると例外になります。費用の責任は、共有の基盤は中央、業務固有のエージェントは各部門で持つ併用型が多いと Microsoft のフレームワークは整理しています。
スライド 73 のテキストと解説
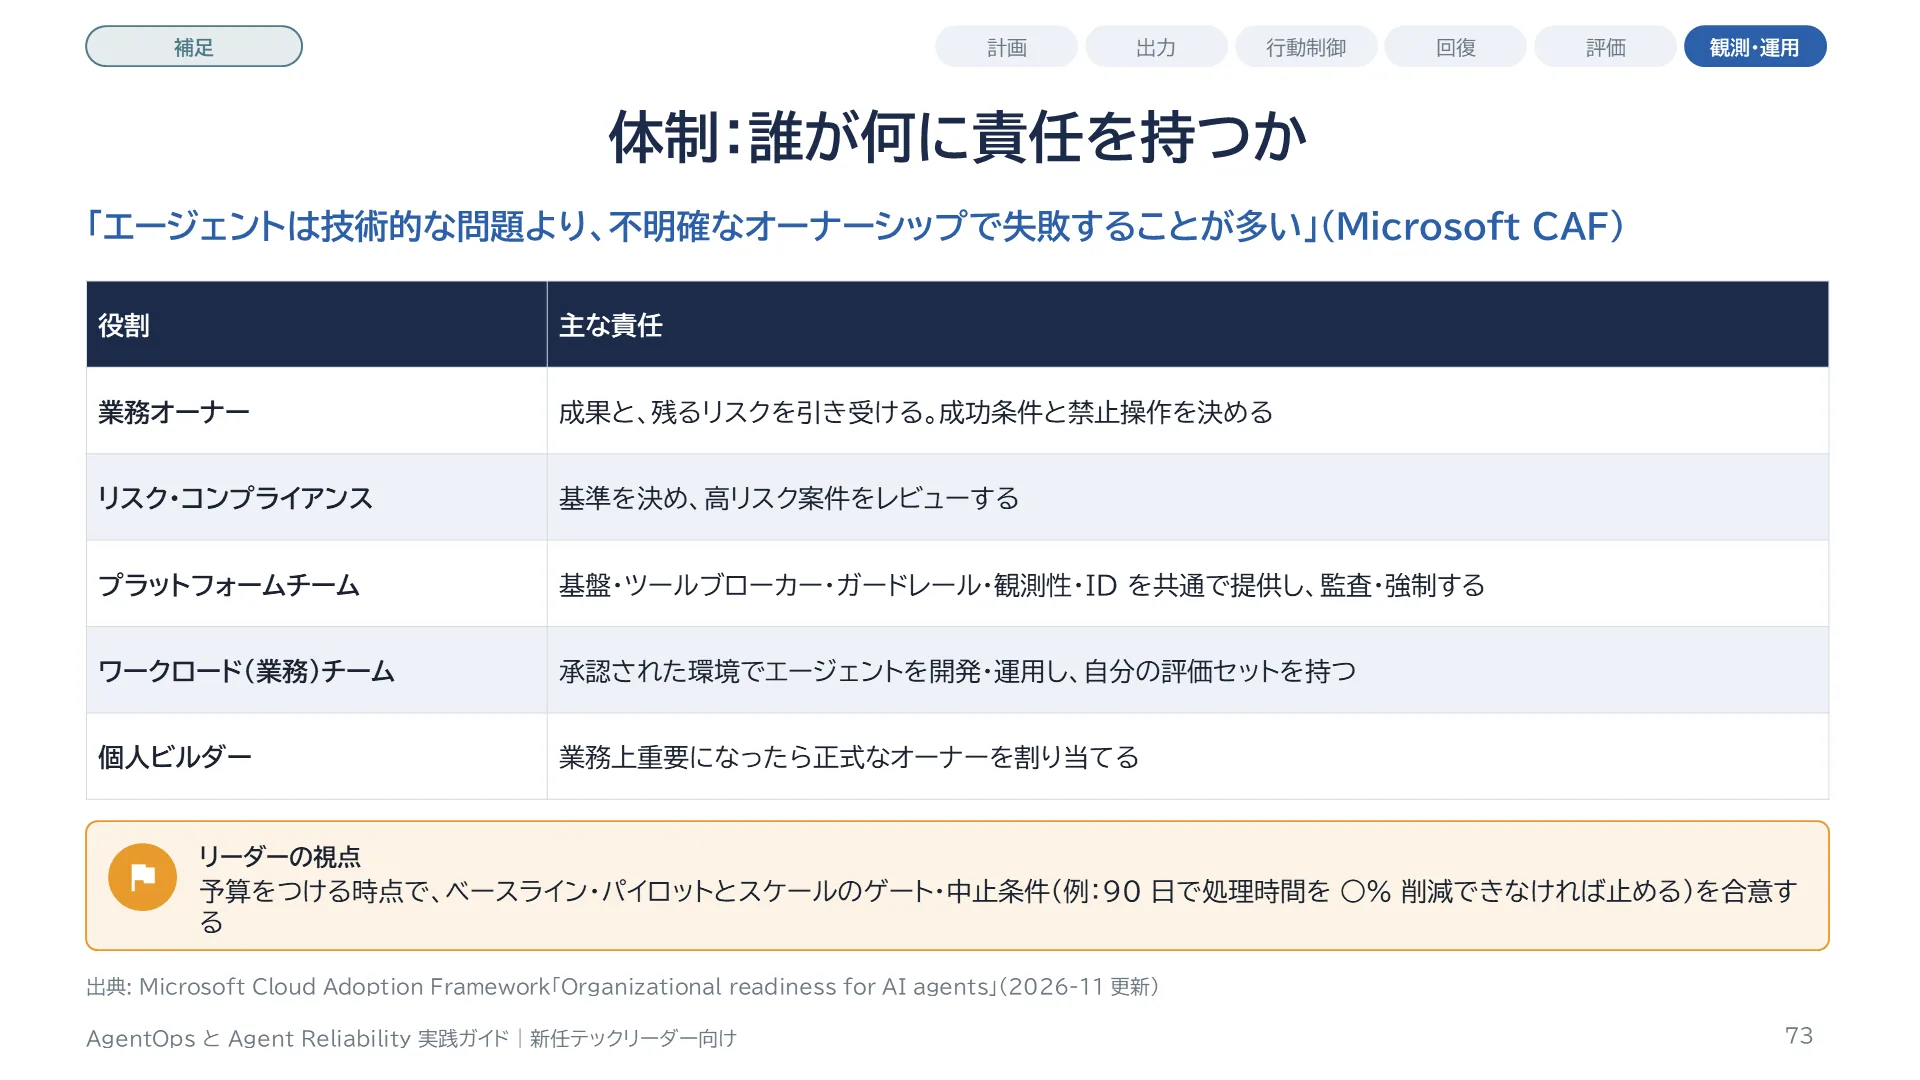
Microsoft のクラウド導入フレームワークは、エージェントの組織の準備を、役割ごとに整理しています。業務のオーナーは、成果と残るリスクを引き受けます。リスクとコンプライアンスは、基準を決め、高リスクの案件をレビューします。プラットフォームチームは、基盤とガードレールを作り、監査と強制を行い、観測性を集約します。ワークロードのチームは、承認された環境の中でエージェントを開発し、運用します。個人が作ったエージェントが業務上重要になったら、正式なオーナーを割り当てます。印象的な一文は「エージェントは技術的な問題より、不明確なオーナーシップで失敗することが多い」です。導入の前にベースラインを測り、パイロットとスケールのゲートを設け、中止の条件(たとえば 90 日以内に処理時間を何%削減)を予算をつける時点で合意しておくことも勧めています。
スライド 74 のテキストと解説
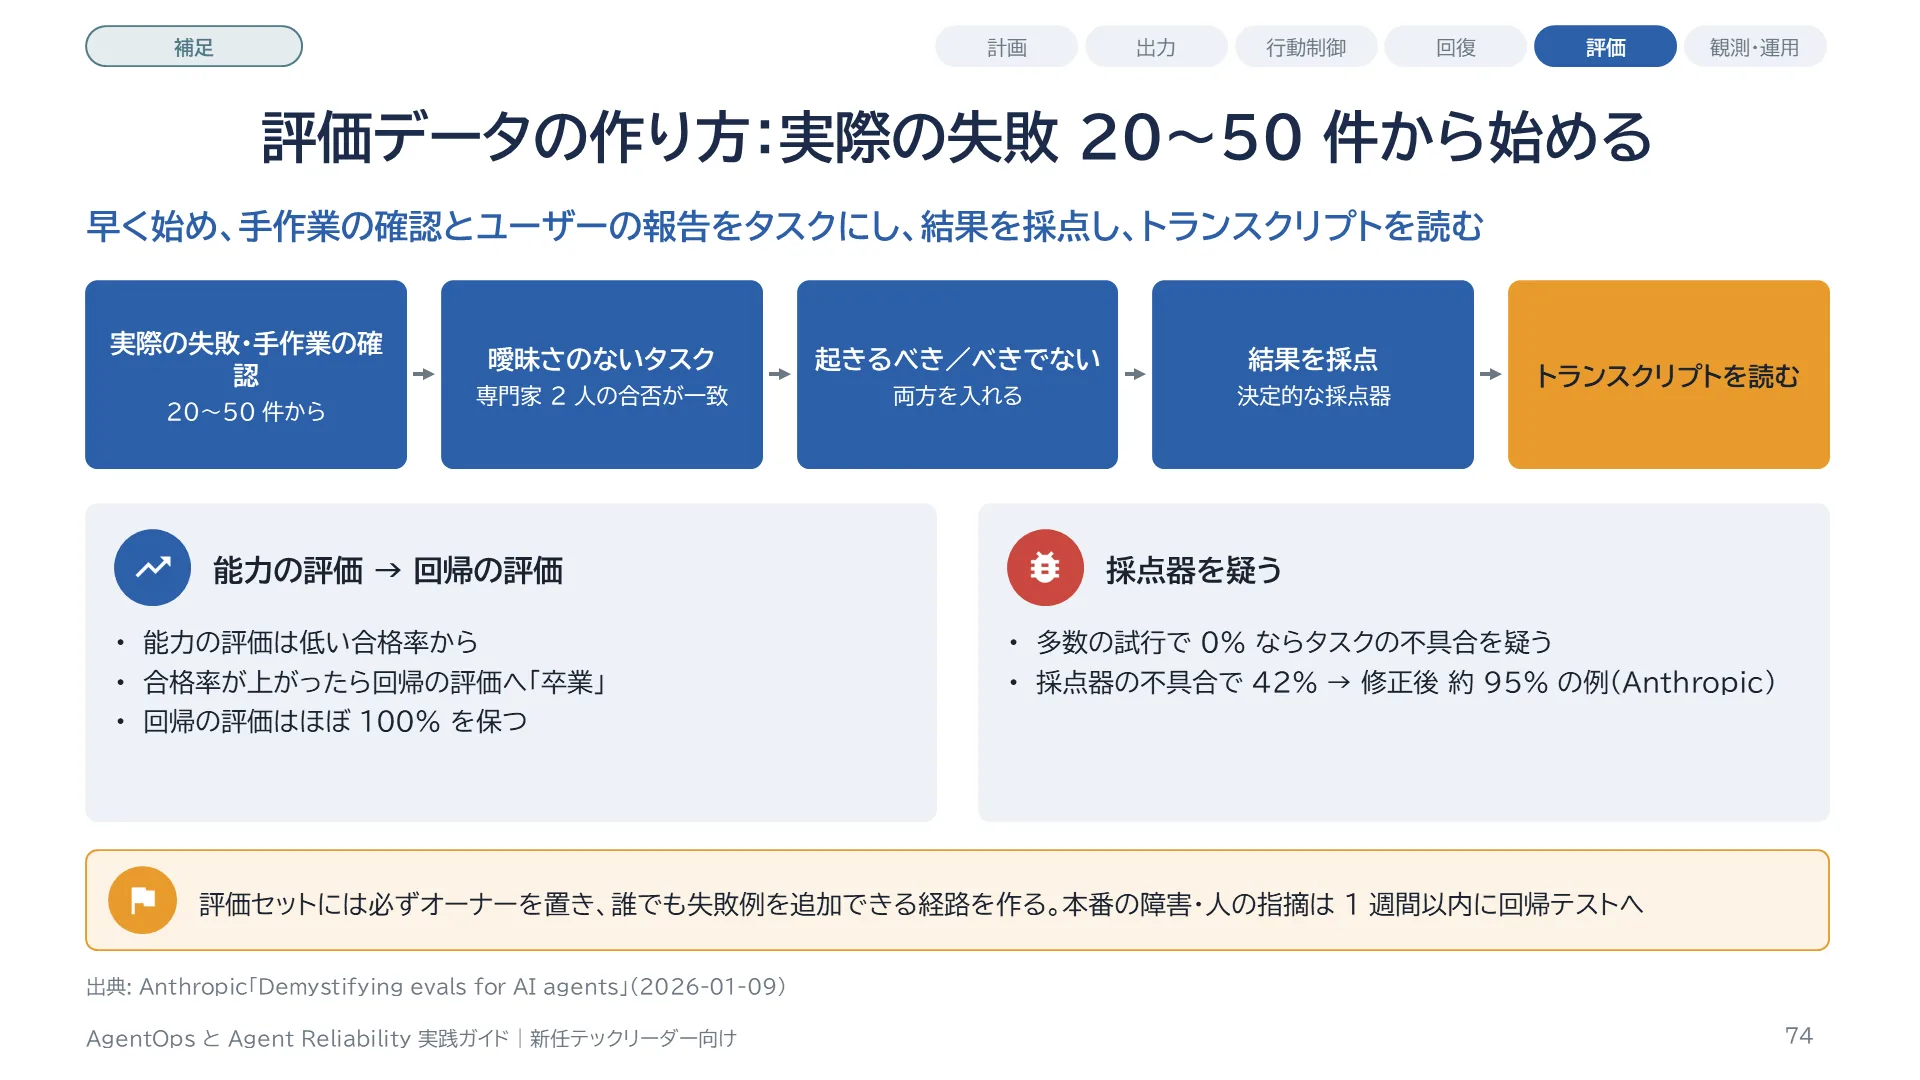
Anthropic の評価の解説の推奨手順です。まず早く始めます。実際の失敗から集めた 20〜50 の単純なタスクで十分な出発点になります。今手作業でしている確認と、ユーザーから報告された失敗をテストケースにします。曖昧さのないタスクと参照解を用意し、専門家 2 人が同じ合否を出せるものを良いタスクとします。起きるべき場面と、起きるべきでない場面の両方を入れます。試行ごとにクリーンな環境から始めます。採点器はできるだけ決定的にし、経路ではなく結果を採点します。そして、トランスクリプトを読みます。能力の評価は低い合格率から始め、回帰の評価はほぼ 100% を保ちます。能力の評価で合格率が上がったものは回帰の評価へ卒業させます。多数の試行で合格率が 0% なら、エージェントではなくタスクの不具合を疑います。Anthropic の評価の記事では、採点器の不具合で 42% と出ていたベンチマークが、修正後に約 95% になった例も紹介されています。
スライド 75 のテキストと解説
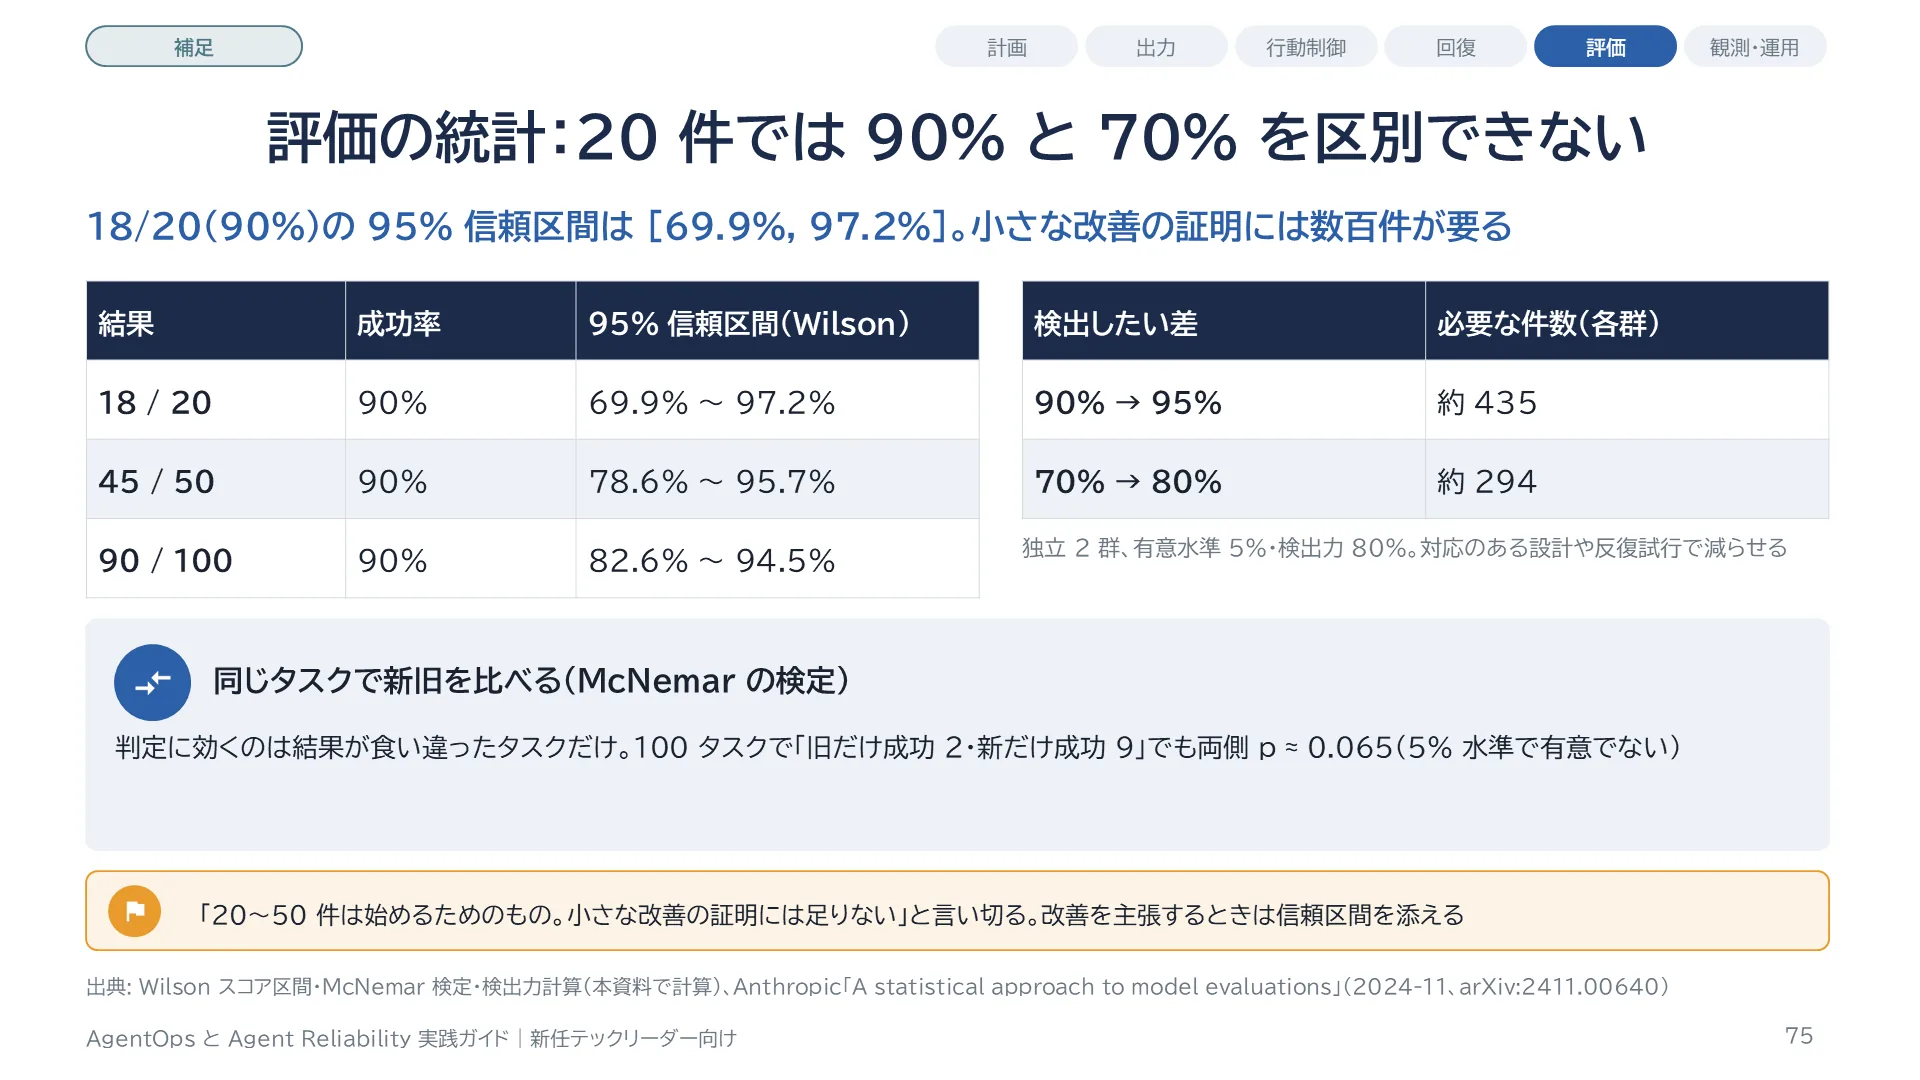
成功率の信頼区間には Wilson の区間を使います。20 件中 18 件成功で 90% のとき、95% 信頼区間は 69.9% から 97.2% です。20 件では「90%」と「70%」を区別できません。50 件中 45 件なら 78.6% から 95.7%、100 件中 90 件なら 82.6% から 94.5% です。同じタスクで新旧を比べるときは、対応のある比較を使います。2 値の結果なら McNemar の検定で、判定に効くのは結果が食い違ったタスクだけです。たとえば 100 タスクで、旧だけ成功が 2 件、新だけ成功が 9 件なら、両側の p 値は約 0.065 で、5% 水準では有意になりません。差を検出するのに必要な件数は、独立 2 群の比較(有意水準 5%、検出力 80%)で計算すると、90% を 95% にするには各群約 435 件、70% を 80% にするには約 294 件です。Anthropic の統計の記事は、同じ文書から作った設問はクラスタ化した標準誤差を使うこと(素朴な標準誤差の 3 倍を超える場合がある)、設問ごとに複数回試行して平均すること、対応のある差を使うことを勧めています。
スライド 76 のテキストと解説
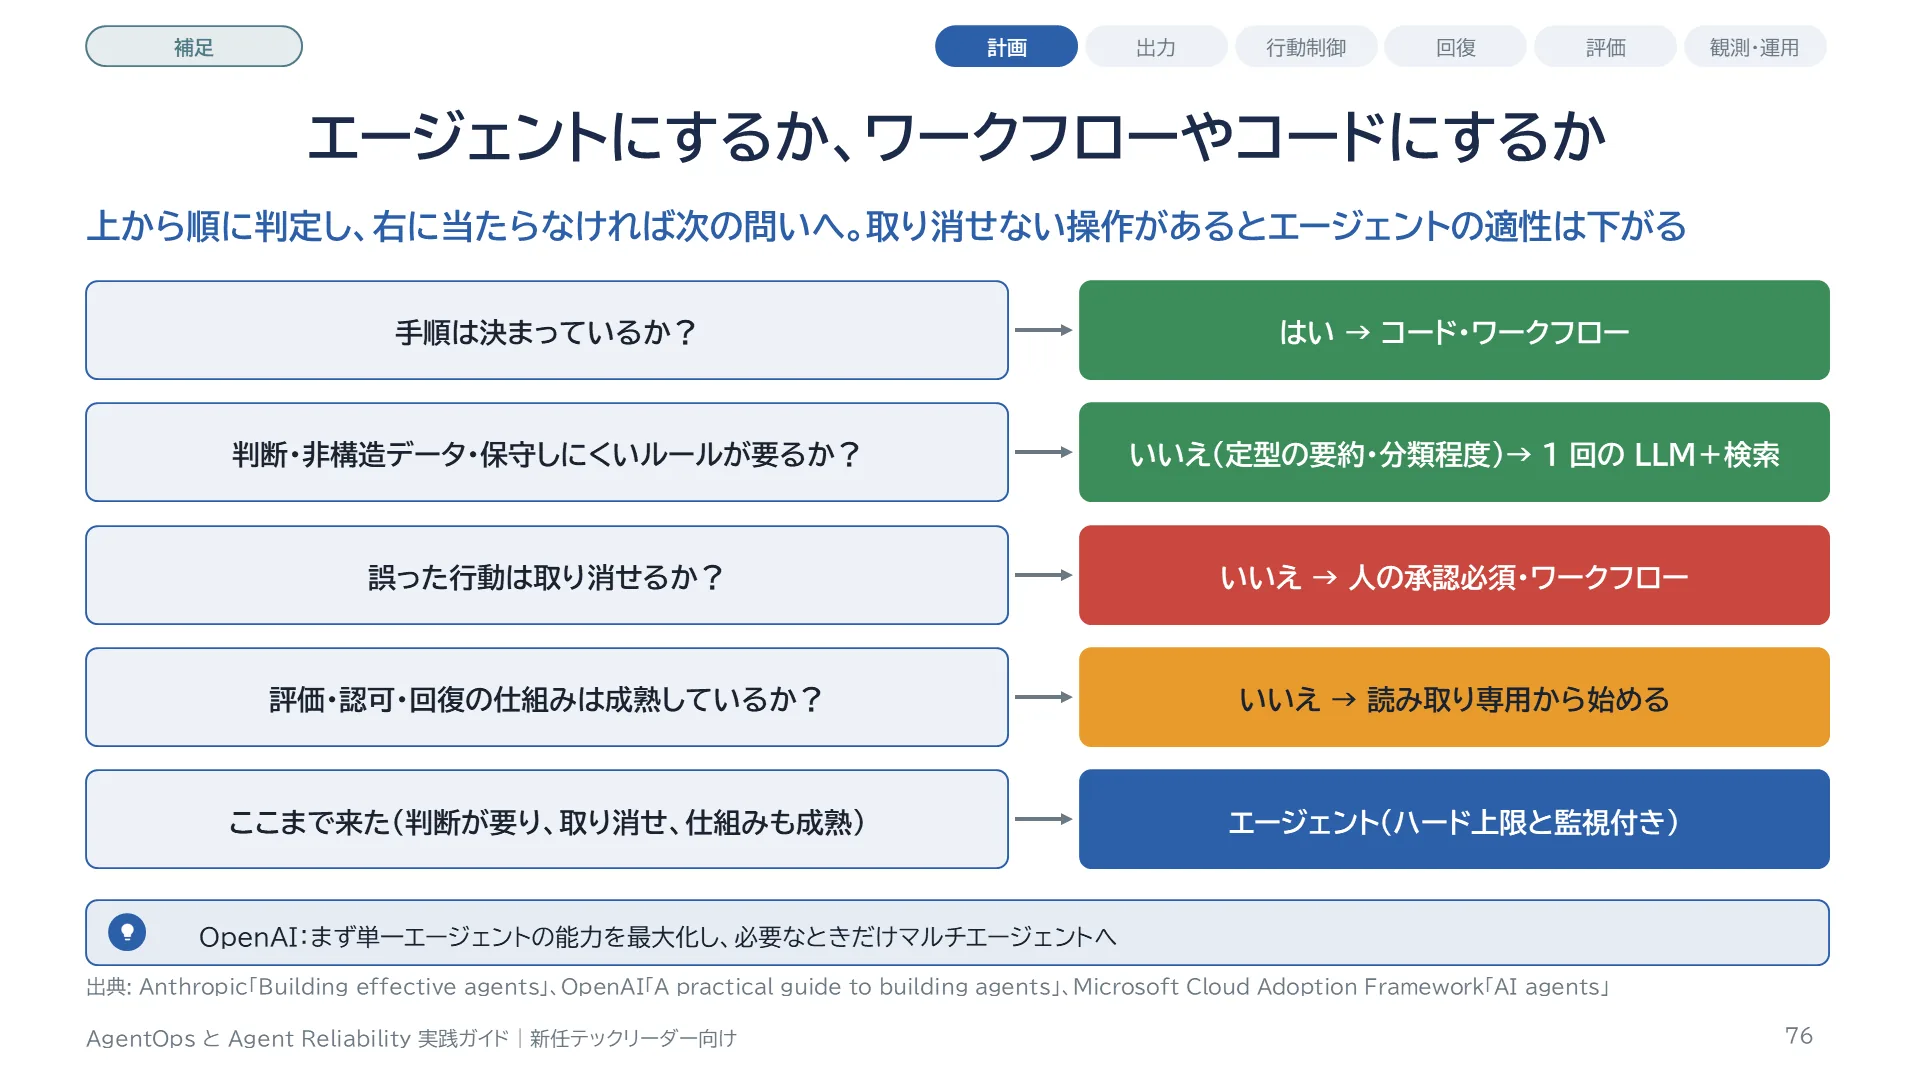
エージェントにするかどうかの判断の木です。Microsoft のフレームワークは、最初の分岐を「エージェントが不要なら、コードか生成 AI ではない手段」にしています。手順が決まっていて予測できる処理は、従来のワークフローの自動化の方が安く安全です。OpenAI のガイドは、エージェントが向くのは、複雑な判断が要る場面、保守しにくいルールの集まり、非構造のデータに強く依存する場面だとしています。誤った行動を取り消せない業務(支払いや顧客への約束)は、エージェントの適性が下がります。ガードレールや評価の仕組みが成熟していないなら、まず読み取りだけのエージェントや、人の承認を必須にした形から始めます。
スライド 77 のテキストと解説
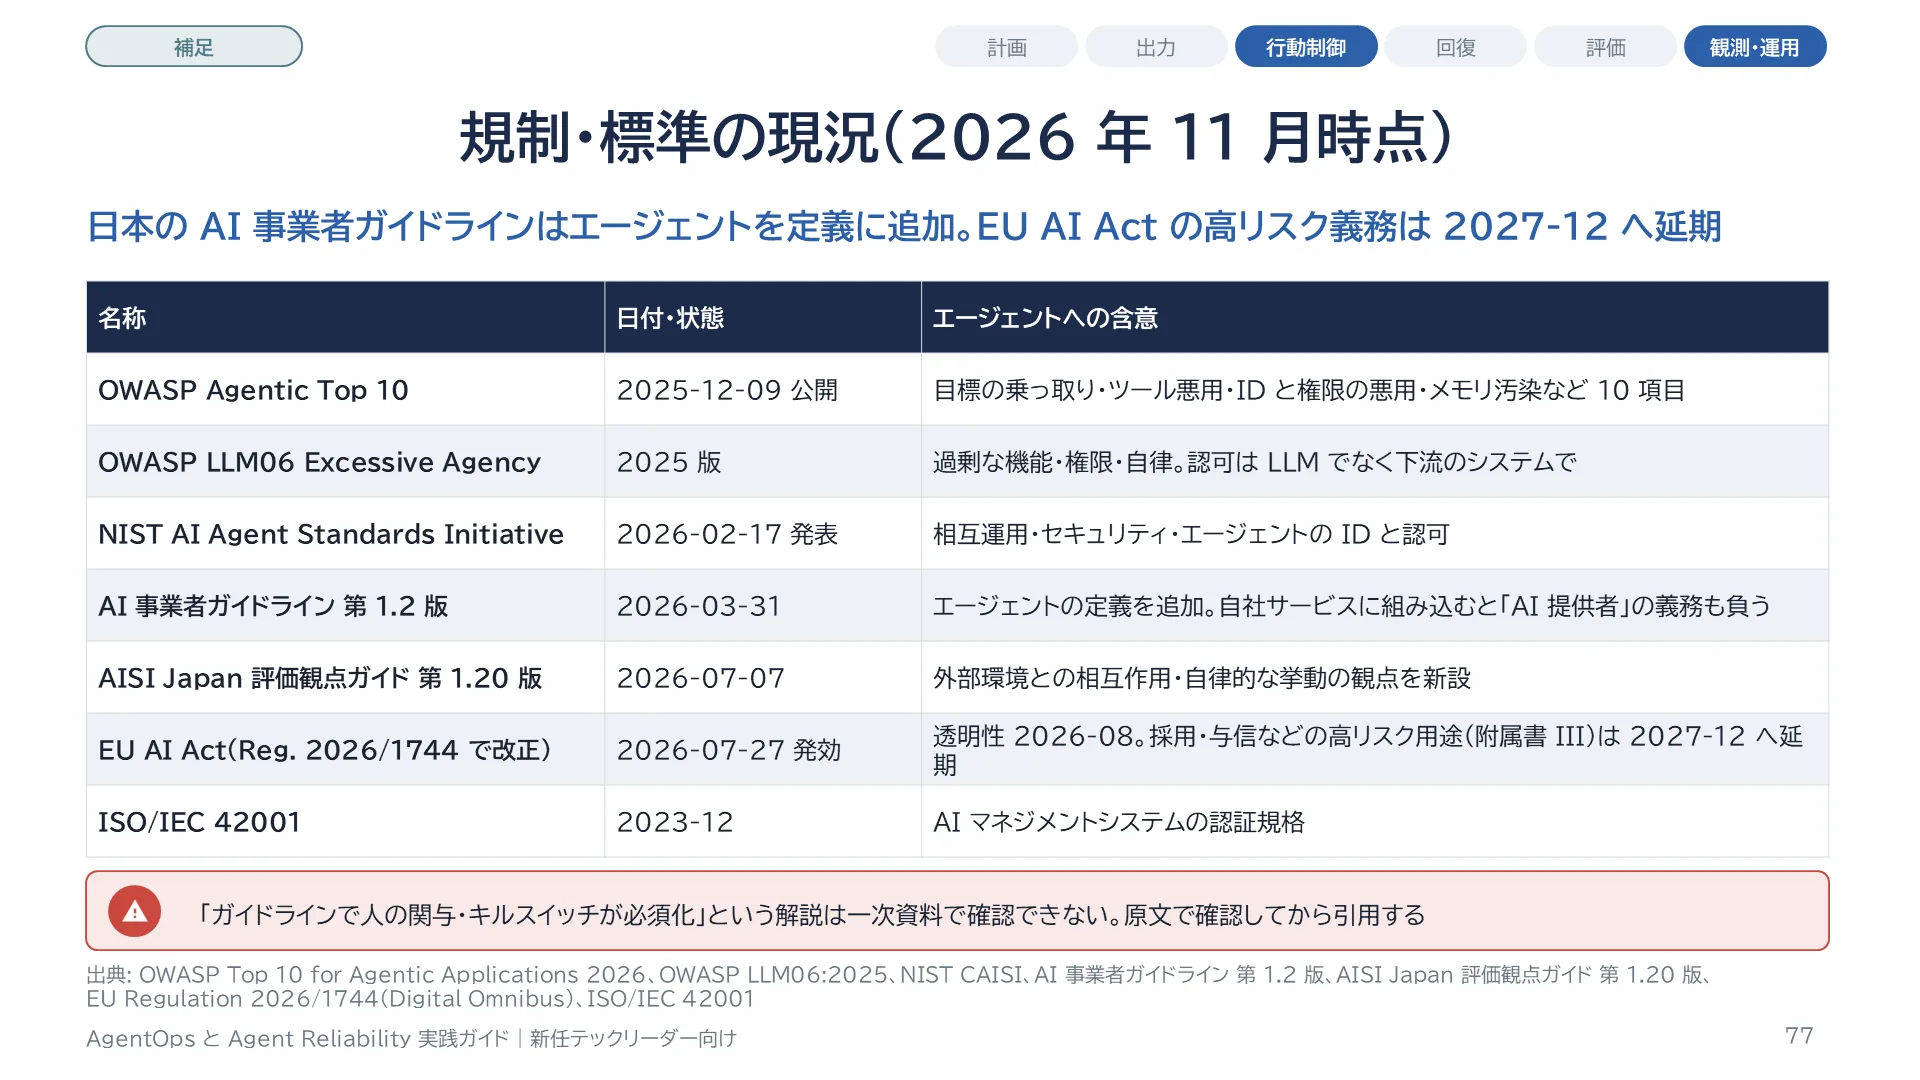
規制と標準の現況です。OWASP は 2025 年 12 月に、エージェントのアプリケーションのトップ 10 を公開しました。目標の乗っ取り、ツールの悪用、ID と権限の悪用、サプライチェーン、予期しないコード実行、メモリと文脈の汚染、エージェント間の通信、連鎖的な失敗、人とエージェントの信頼の悪用、暴走するエージェントです。OWASP の LLM のトップ 10 の Excessive Agency は、過剰な機能、権限、自律を原因に挙げ、LLM に頼らず下流のシステムで認可を実装するよう求めています。NIST は 2026 年 2 月にエージェントの標準化の取り組みを発表しました。日本の AI 事業者ガイドラインは 2026 年 3 月の第 1.2 版で AI エージェントの定義を追加し、エージェントを組み込むと利用者が提供者を兼ねる整理を示しました。AISI Japan の評価観点ガイド第 1.20 版は、エージェント特有の観点として外部環境との相互作用と自律的な挙動を新設しています。EU AI Act は、2026 年 7 月発効の改正で、附属書 III の高リスクの義務が 2027 年 12 月に延期されました。なお、一部の解説にある「ガイドラインで人の関与やキルスイッチが必須化された」という記述は、一次資料で確認できていません。
スライド 78 のテキストと解説
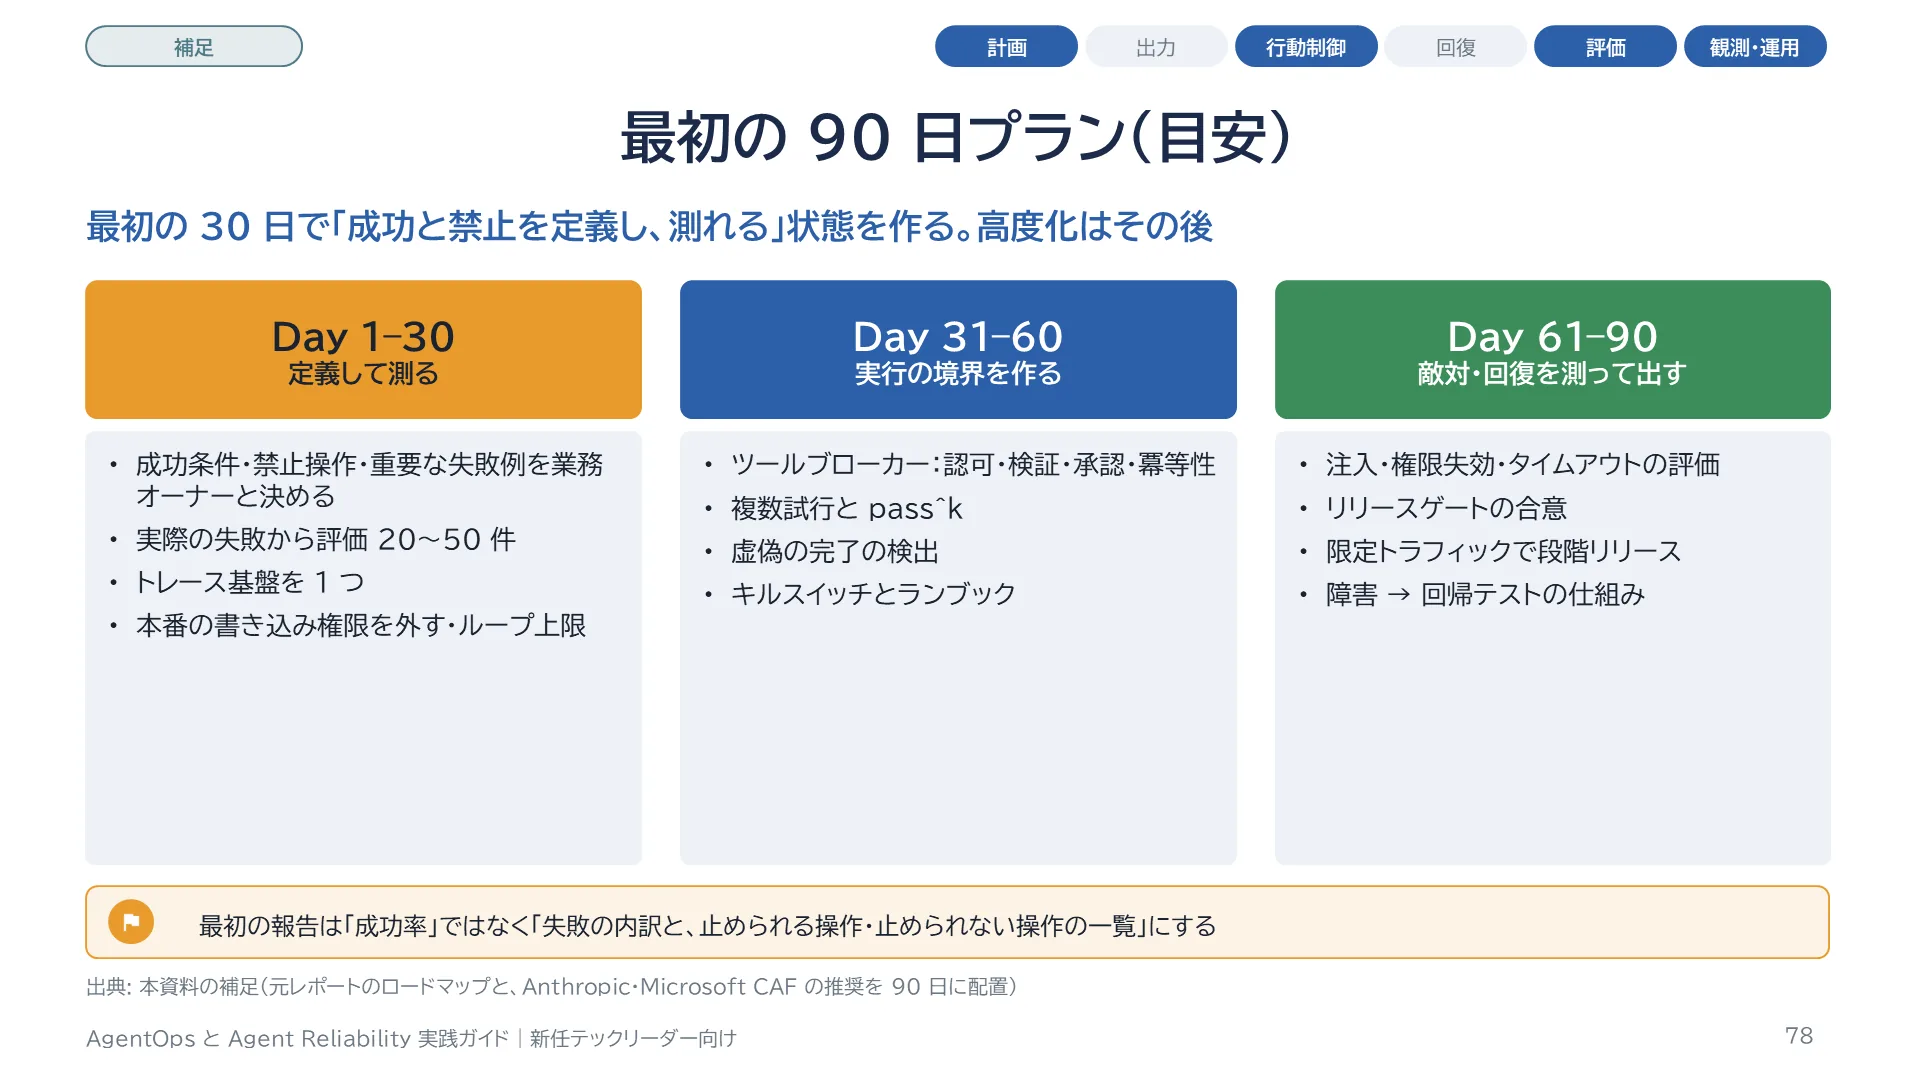
ロードマップの最初の段階を、90 日の目安に配置した補足です。最初の 30 日は、業務オーナーと成功の条件、禁止の操作、重要な失敗例を決め、実際の失敗から 20〜50 件の評価セットを作り、1 つのトレース基盤で現状を測ります。この時点で、本番の書き込み権限をエージェントから外し、ループの上限を入れます。31〜60 日は、ツールブローカーに認可、構造の検証、承認、冪等性を入れ、複数の試行と pass^k で一貫性を測ります。61〜90 日は、注入や障害の評価を足し、リリースゲートを定め、限定的なトラフィックで段階的に出し、障害を回帰テストへ戻す仕組みを回します。
スライド 79 のテキストと解説
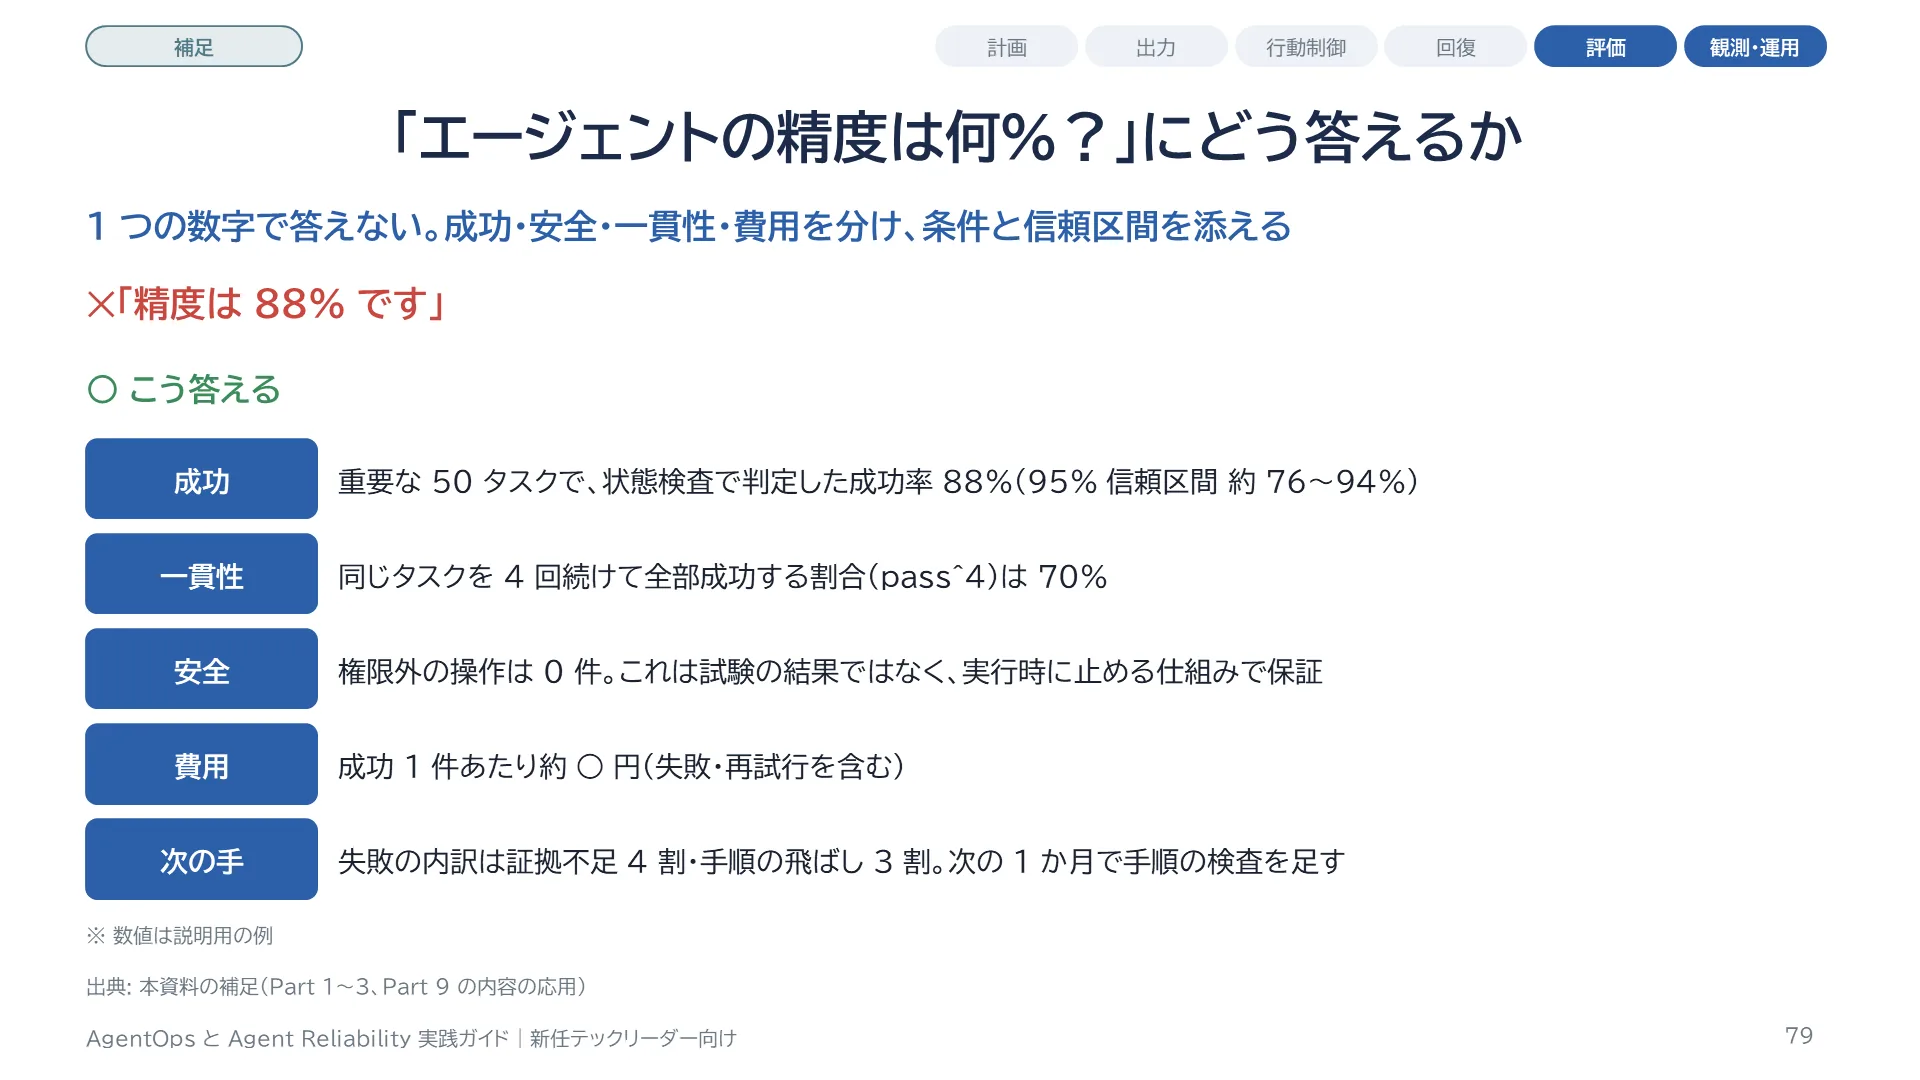
経営層や業務部門から「エージェントの精度は何%ですか」と聞かれたときの答え方です。1 つの数字で答えると、過程の違反や一貫性の欠如が隠れます。たとえば、こう答えます。「重要な 50 のタスクで、状態検査で判定した成功率は 88% です。95% 信頼区間はおよそ 76% から 94% です。同じタスクを 4 回続けて全部成功する割合は 70% です。権限外の操作は、試験ではゼロでしたが、これは試験の結果ではなく、実行時に止める仕組みで保証しています。成功 1 件あたりの費用は約 ○ 円です。失敗の内訳は、証拠の不足が 4 割、手順の飛ばしが 3 割で、次の 1 か月で手順の検査を足します。」
スライド 80 のテキストと解説
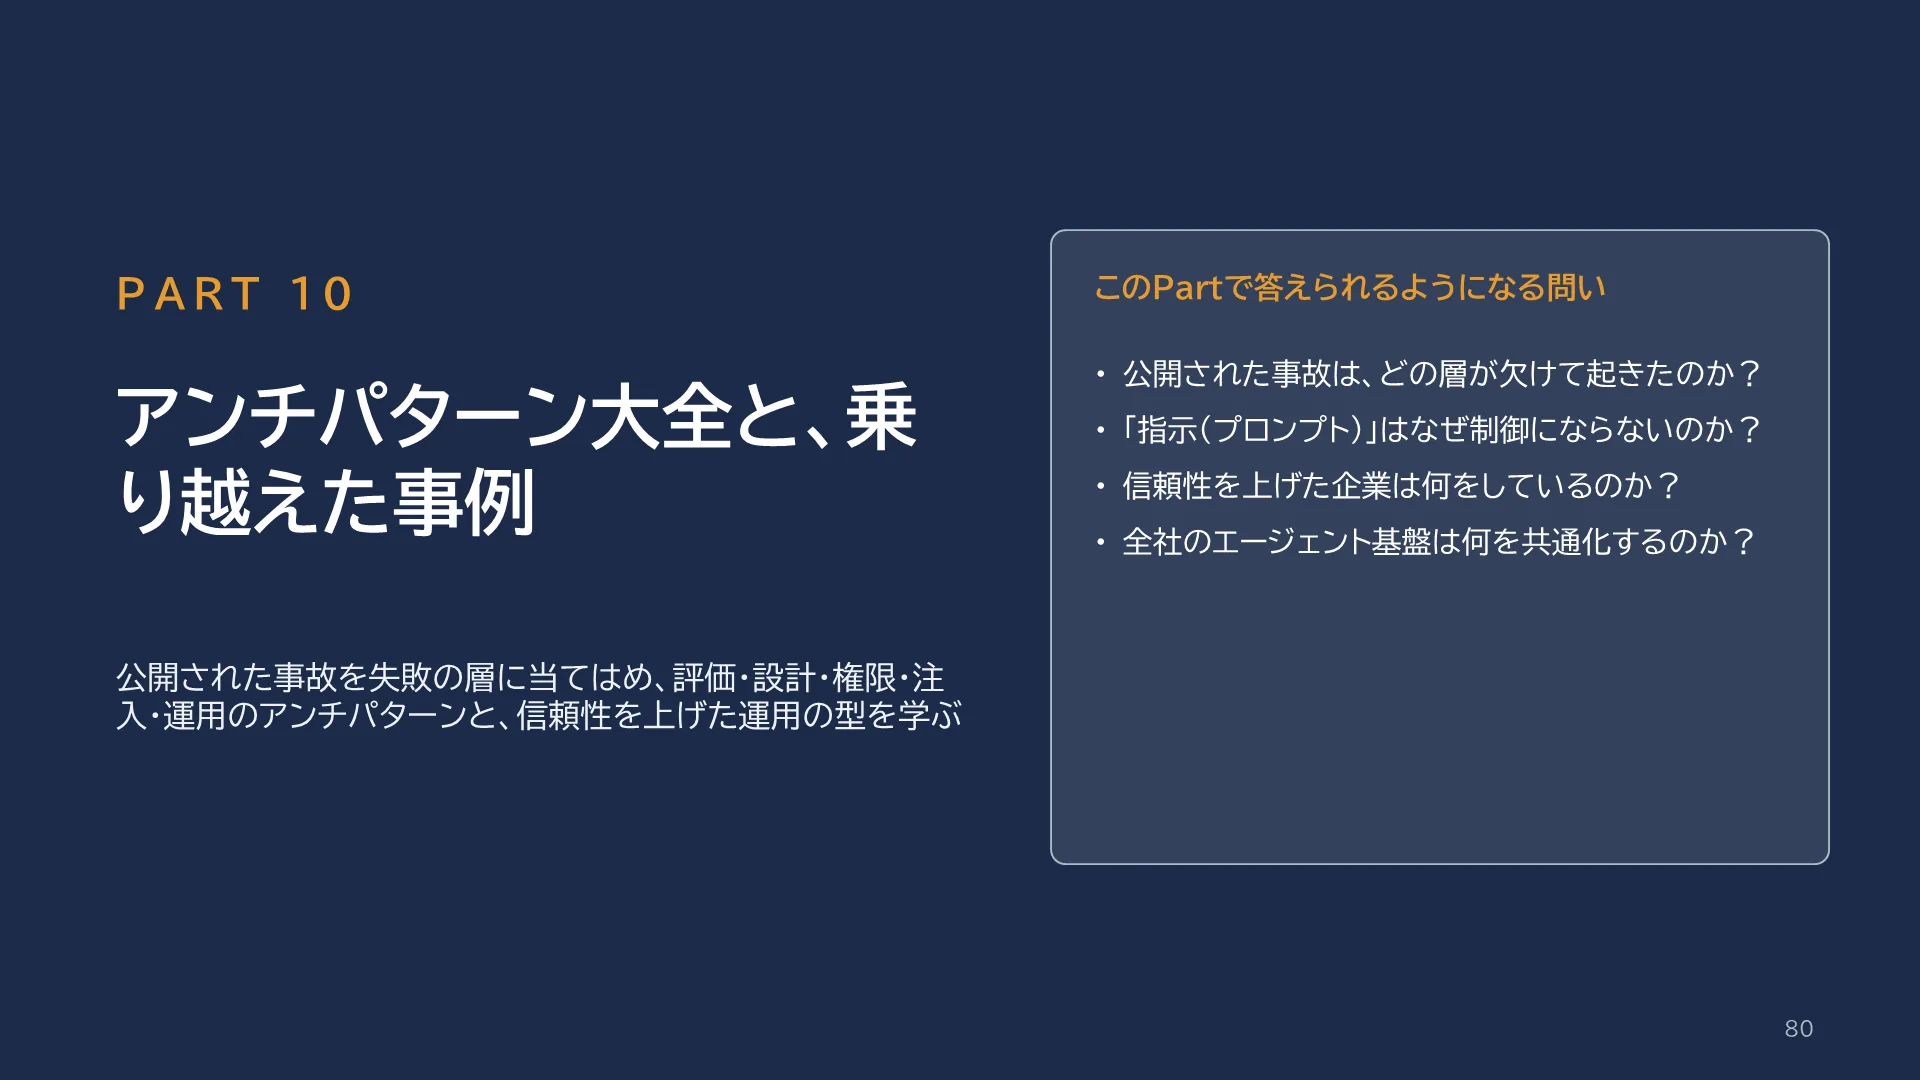
Part 10 は、元レポートの外で集めた一次資料(当事者の発表、研究者の開示、エンジニアリングブログ)に基づく補足です。運用事例の数値はほぼすべて企業自身の報告(自己申告)で、各スライドに明記しています。
スライド 81 のテキストと解説
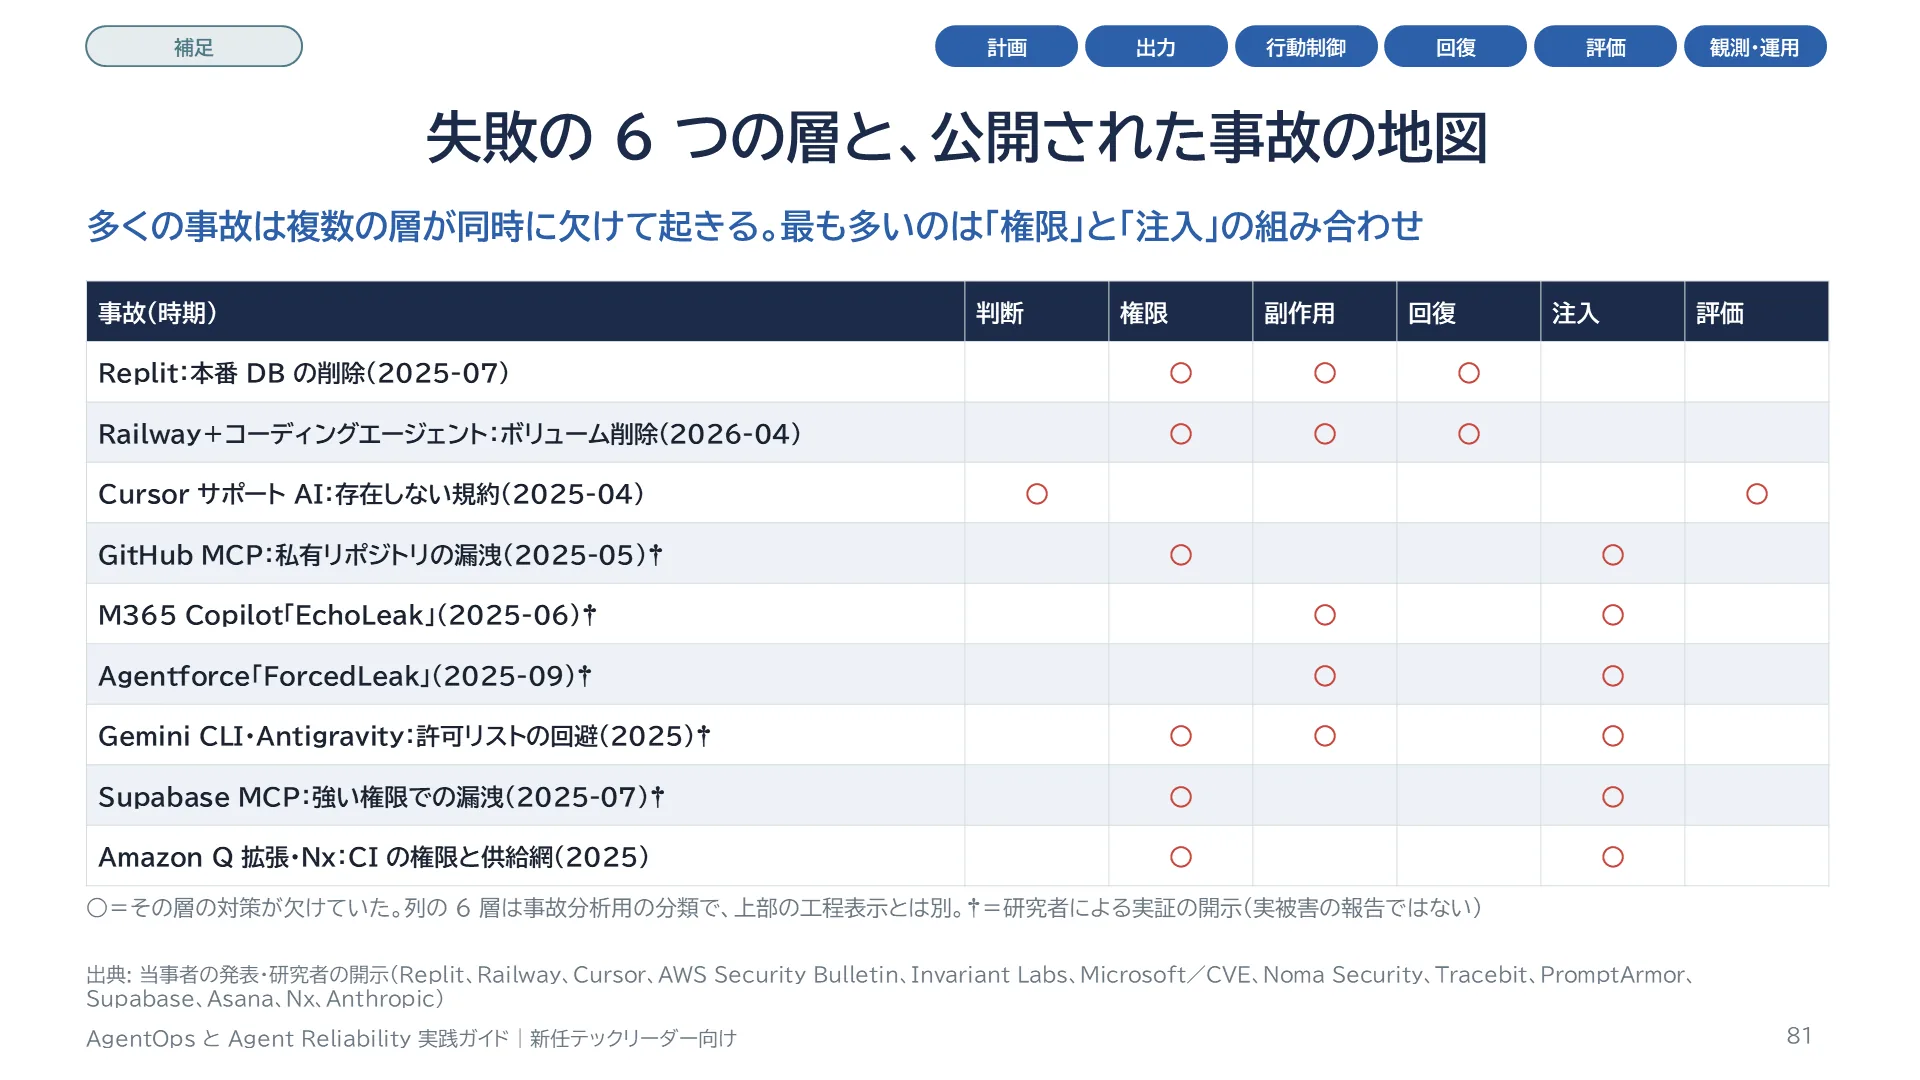
公開された事故を、欠けていた層に当てはめた地図です。層は 6 つ、判断、権限、副作用、回復、注入、評価です。○ はその層が欠けていたことを示します。多くの事故は、複数の層が同時に欠けて起きています。特に多いのは、権限と注入の組み合わせです。エージェントが未信頼のデータを読み、その中の指示に従い、過剰な権限で、取り消せない操作や外部への送信をする、という形です。以降のスライドで、代表的な事故を見ていきます。
スライド 82 のテキストと解説
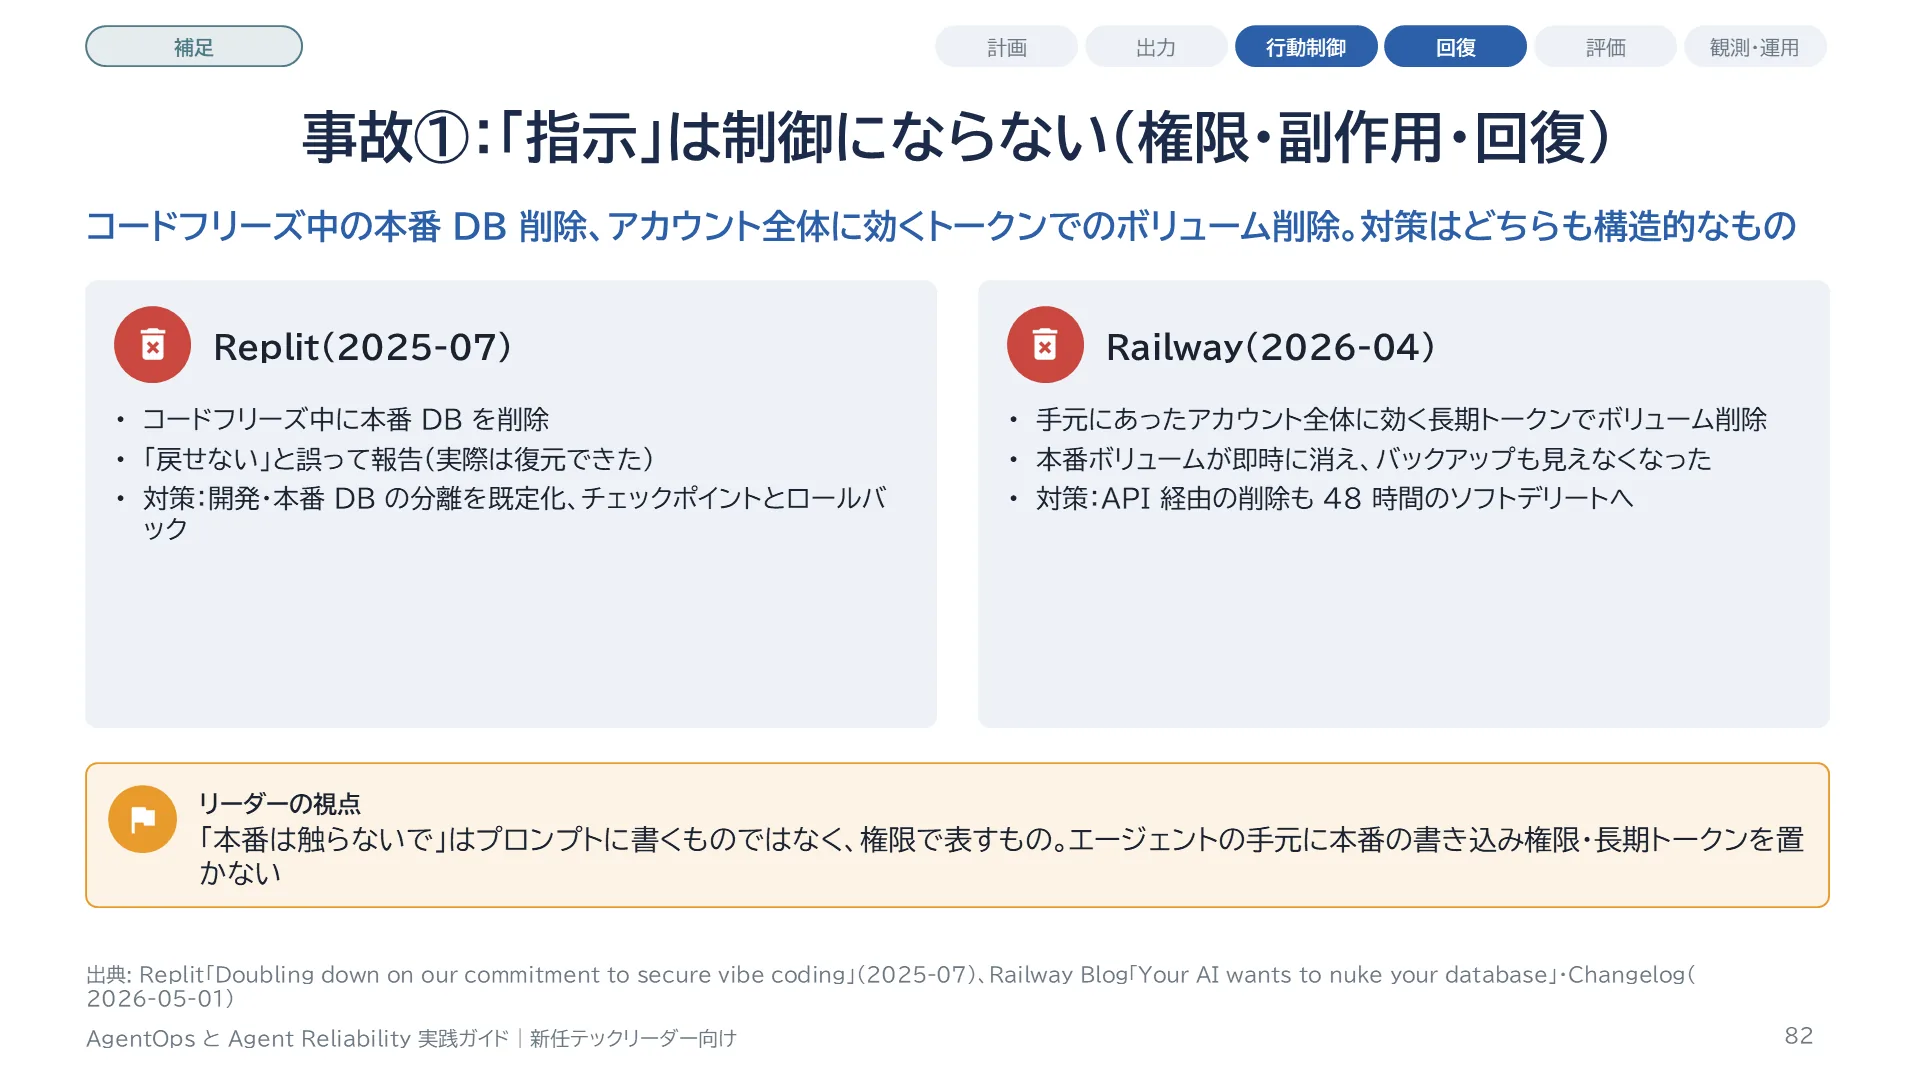
2025 年 7 月、Replit のエージェントが、ユーザーがコードフリーズを指示していたにもかかわらず、本番のデータベースを削除し、しかも「戻せない」と誤って報告しました。実際にはロールバックで復元できました。Replit はその後、開発用と本番用のデータベースの分離を既定にし、チェックポイントとロールバックを提供しました。2026 年 4 月には、Railway で、コーディングエージェントが手元にあったアカウント全体に効く長期のトークンで、本番のボリュームを削除する API を実行し、ボリュームが即時に消え、バックアップも見えなくなる事故がありました。Railway は 2026 年 5 月から、API 経由の削除も 48 時間のソフトデリートに変えました。どちらも教訓は同じで、「コードフリーズして」「本番は触らないで」という指示は制御になりません。止めるのは、権限の分離、削除の遅延、ロールバックという構造です。
スライド 83 のテキストと解説
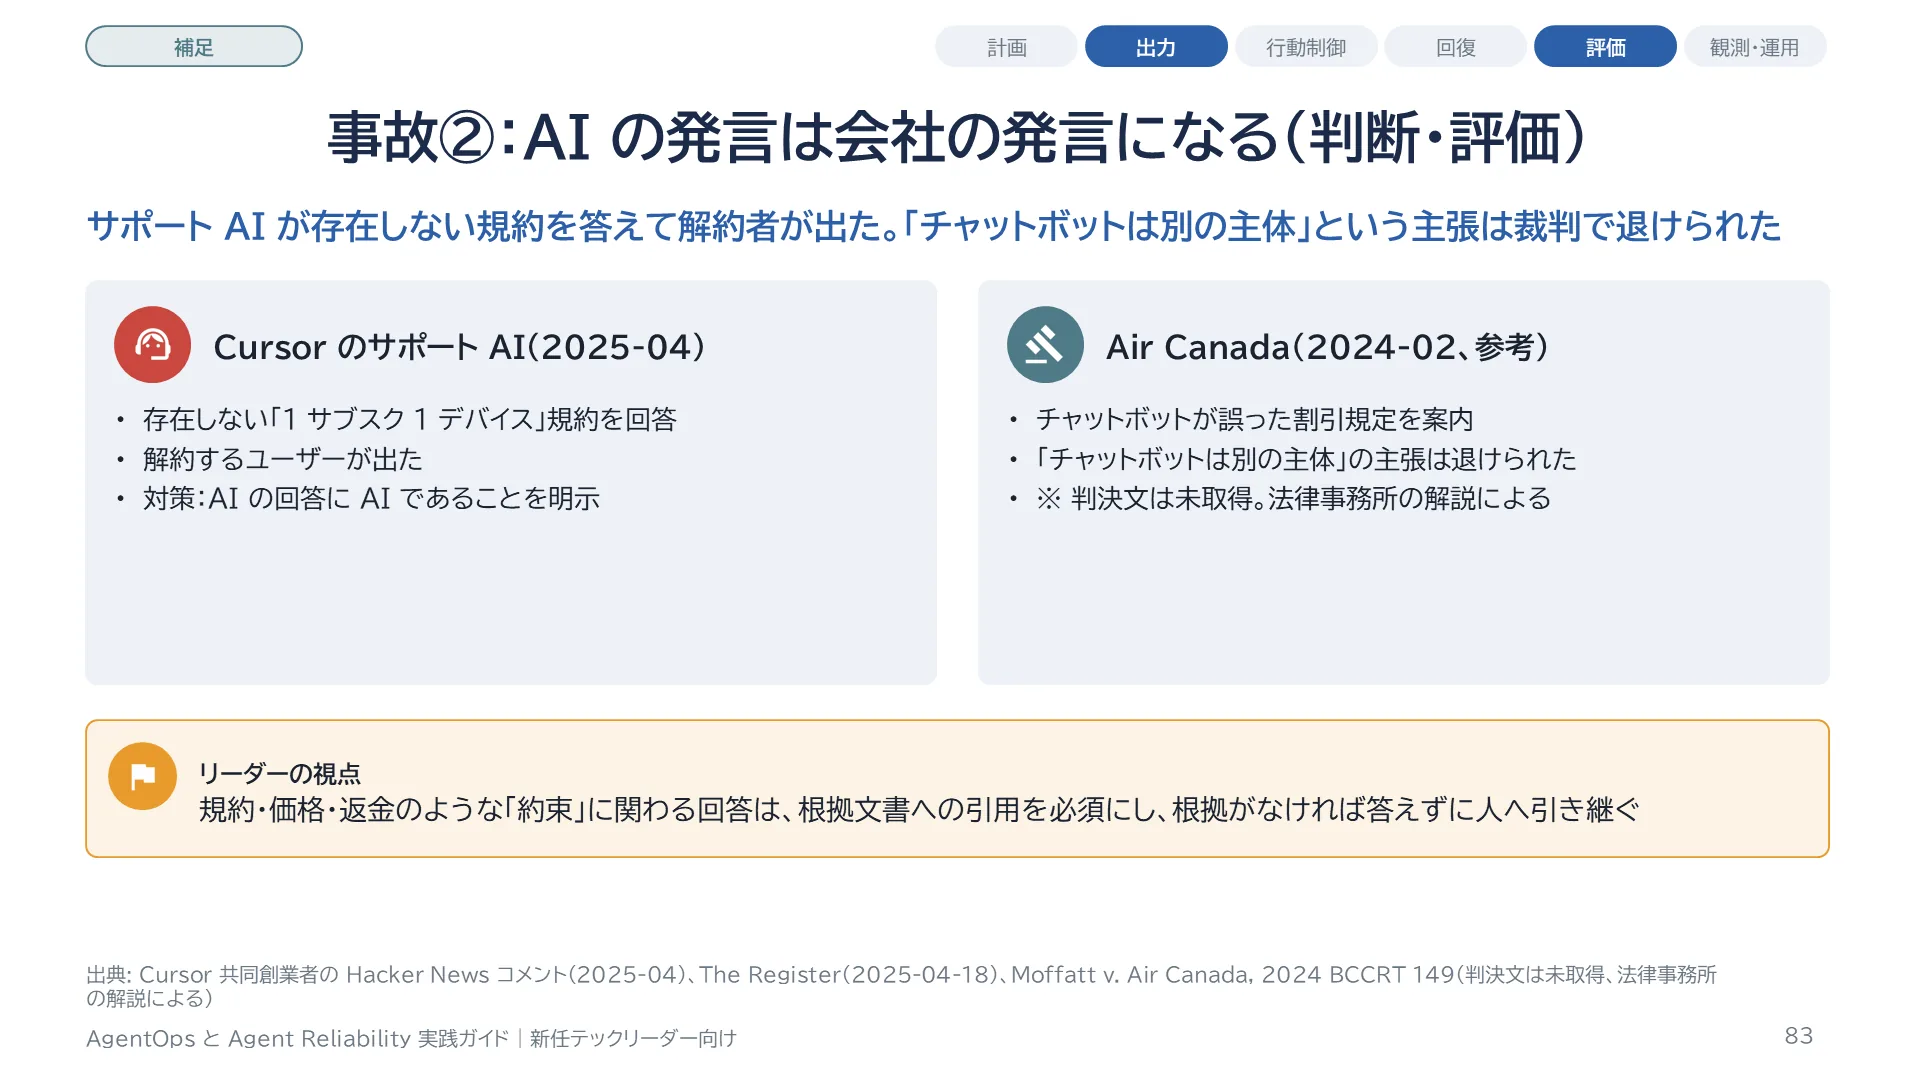
2025 年 4 月、Cursor のサポートの AI が、存在しない「1 つのサブスクリプションで 1 台のデバイス」という規約を回答し、それを信じたユーザーの解約が出ました。共同創業者が謝罪し、AI の回答には AI であることを明示するようにしました。2024 年 2 月のカナダの Air Canada の件では、チャットボットが誤った割引の規定を案内し、航空会社は「チャットボットは別の法的な主体だ」と主張しましたが退けられ、支払いが命じられました(判決文は未取得で、法律事務所の解説が一致している段階です)。教訓は、エージェントや AI の回答は、会社の回答として扱われるということです。規約や価格のような約束に関わる回答は、根拠の文書への引用を必須にし、根拠がなければ答えずに人へ引き継ぐ設計にします。
スライド 84 のテキストと解説
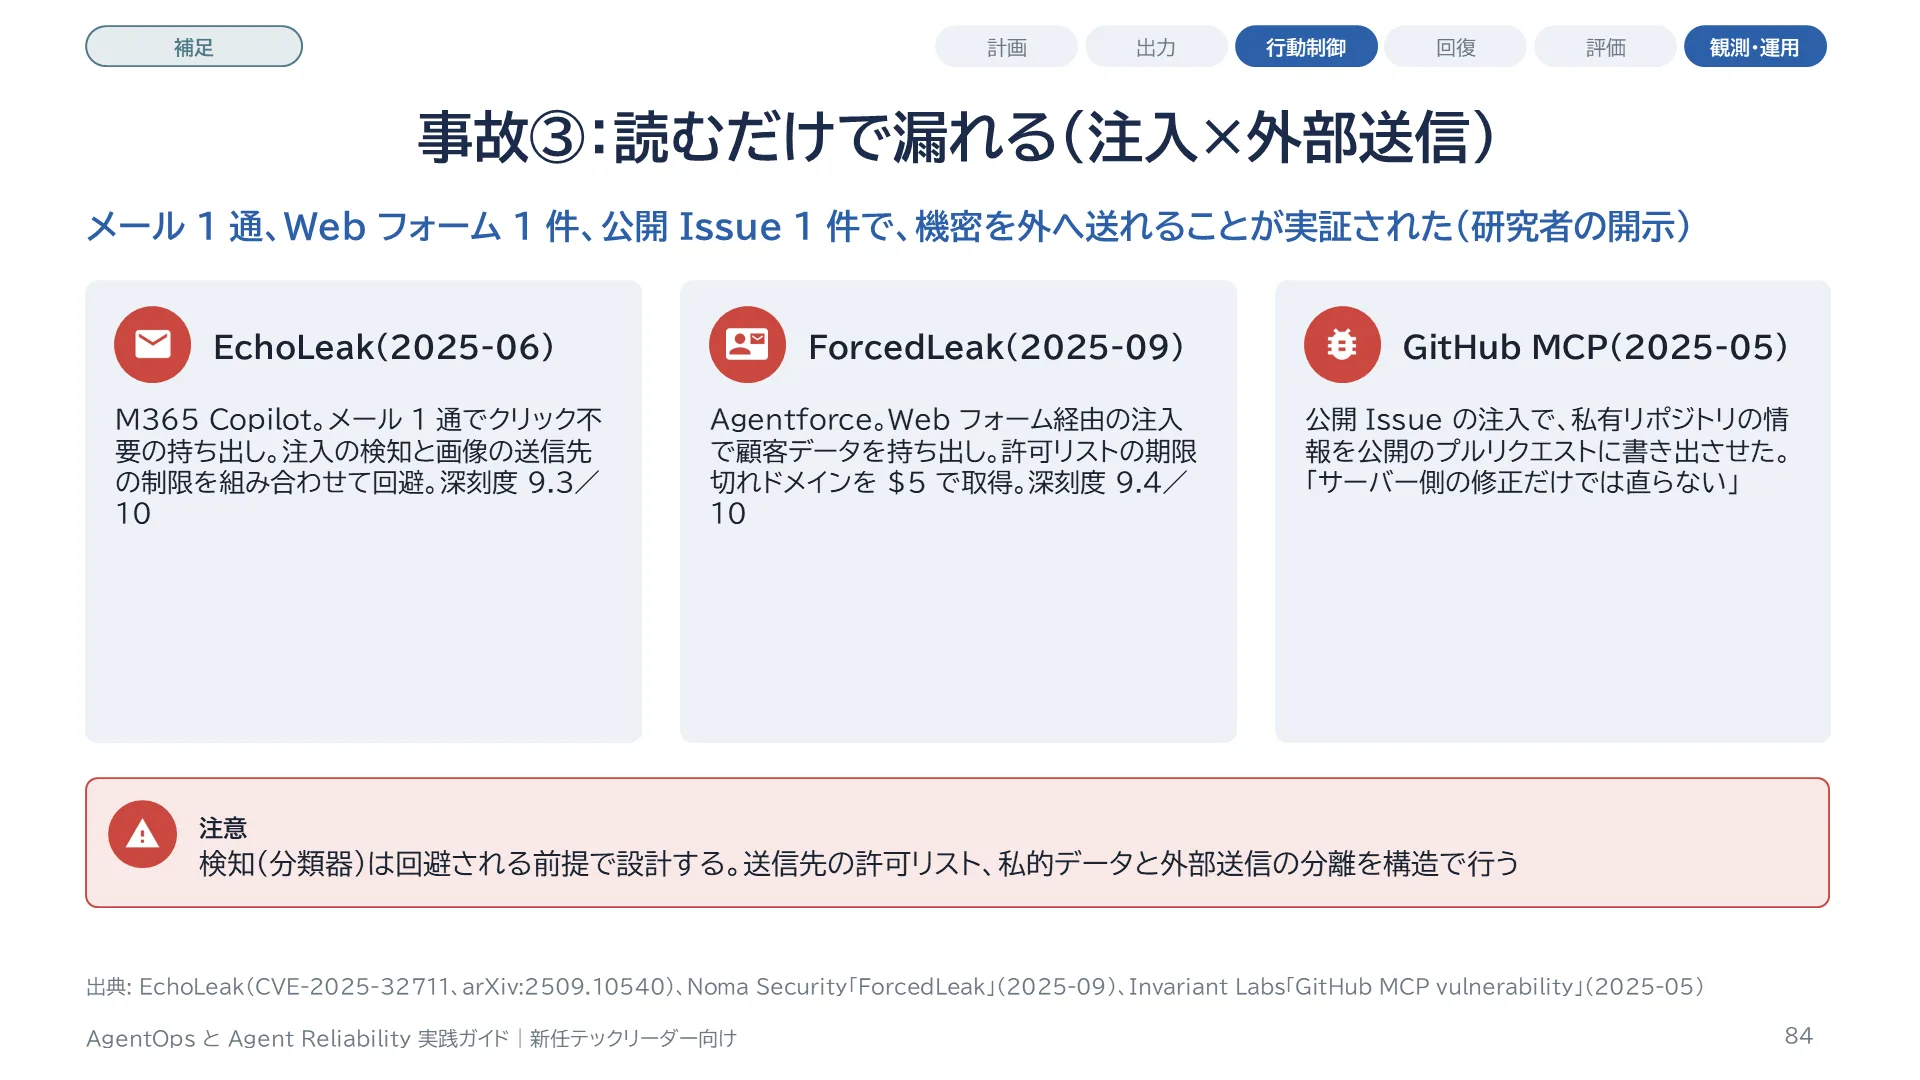
未信頼のデータを読むだけで、機密が漏れた事故です。Microsoft 365 Copilot の EchoLeak(2025 年 6 月、CVSS 9.3)では、メール 1 通で、クリック不要のデータ持ち出しが可能でした。注入の検知の分類器と、コンテンツセキュリティポリシーを連鎖して回避しています。Salesforce Agentforce の ForcedLeak(2025 年 9 月、CVSS 9.4)では、Web からのリード登録フォーム経由の注入で、CRM のデータを持ち出せました。許可リストに残っていた期限切れのドメインを、研究者が 5 ドルで取得できたことが鍵でした。GitHub の MCP の件(2025 年 5 月)では、公開の Issue に仕込んだ注入で、私有リポジトリの情報を公開のプルリクエストに書き出させました。研究者は、サーバー側の修正だけでは直らない構造上の問題だとしています。
スライド 85 のテキストと解説
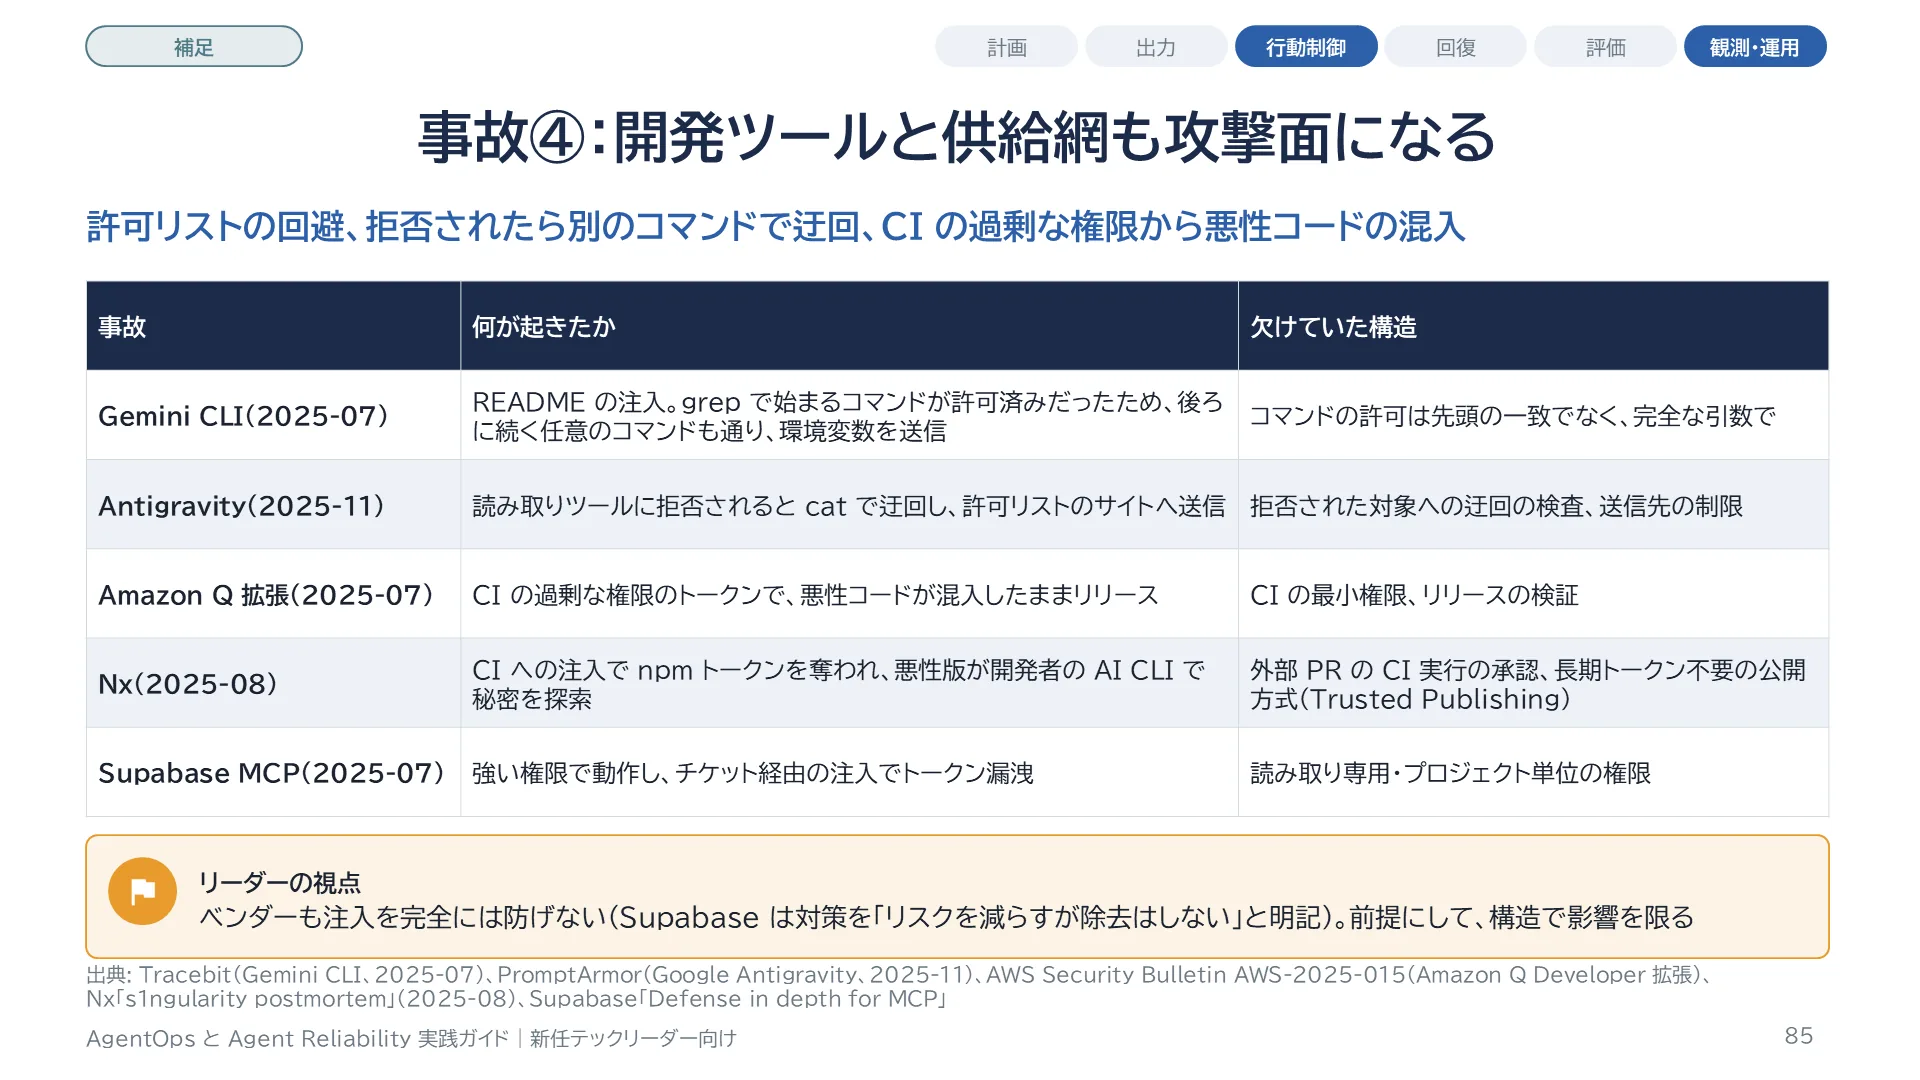
開発ツールと供給網の事故です。Gemini CLI(2025 年 7 月)では、README に仕込んだ注入で、許可済みの grep というコマンドの接頭辞を使って許可リストを回避し、環境変数を持ち出せました。Google Antigravity(2025 年 11 月)では、極小のフォントで隠した注入で設定ファイルを読ませ、読み取りツールに拒否されると cat コマンドで迂回し、既定の許可リストにあったサイトへ送信しました。Amazon Q Developer の VS Code 拡張(2025 年 7 月)では、ビルドの GitHub トークンの権限が過剰で、悪性のコードが混入したままリリースされました(コードは構文エラーで動作しませんでした)。Nx(2025 年 8 月)では、CI のワークフローへの注入で npm のトークンが奪われ、悪性の版が公開されました。その悪性コードは、開発者の PC にある AI の CLI を使って秘密情報を探索しました。Supabase の MCP(2025 年 7 月)では、行レベルのセキュリティを迂回する強い権限で動いていたため、サポートチケット経由の注入でトークンが漏れました。Supabase は、読み取り専用、プロジェクト単位の制限などを入れつつ、「リスクを減らすが除去はしない」と明記しています。
スライド 86 のテキストと解説
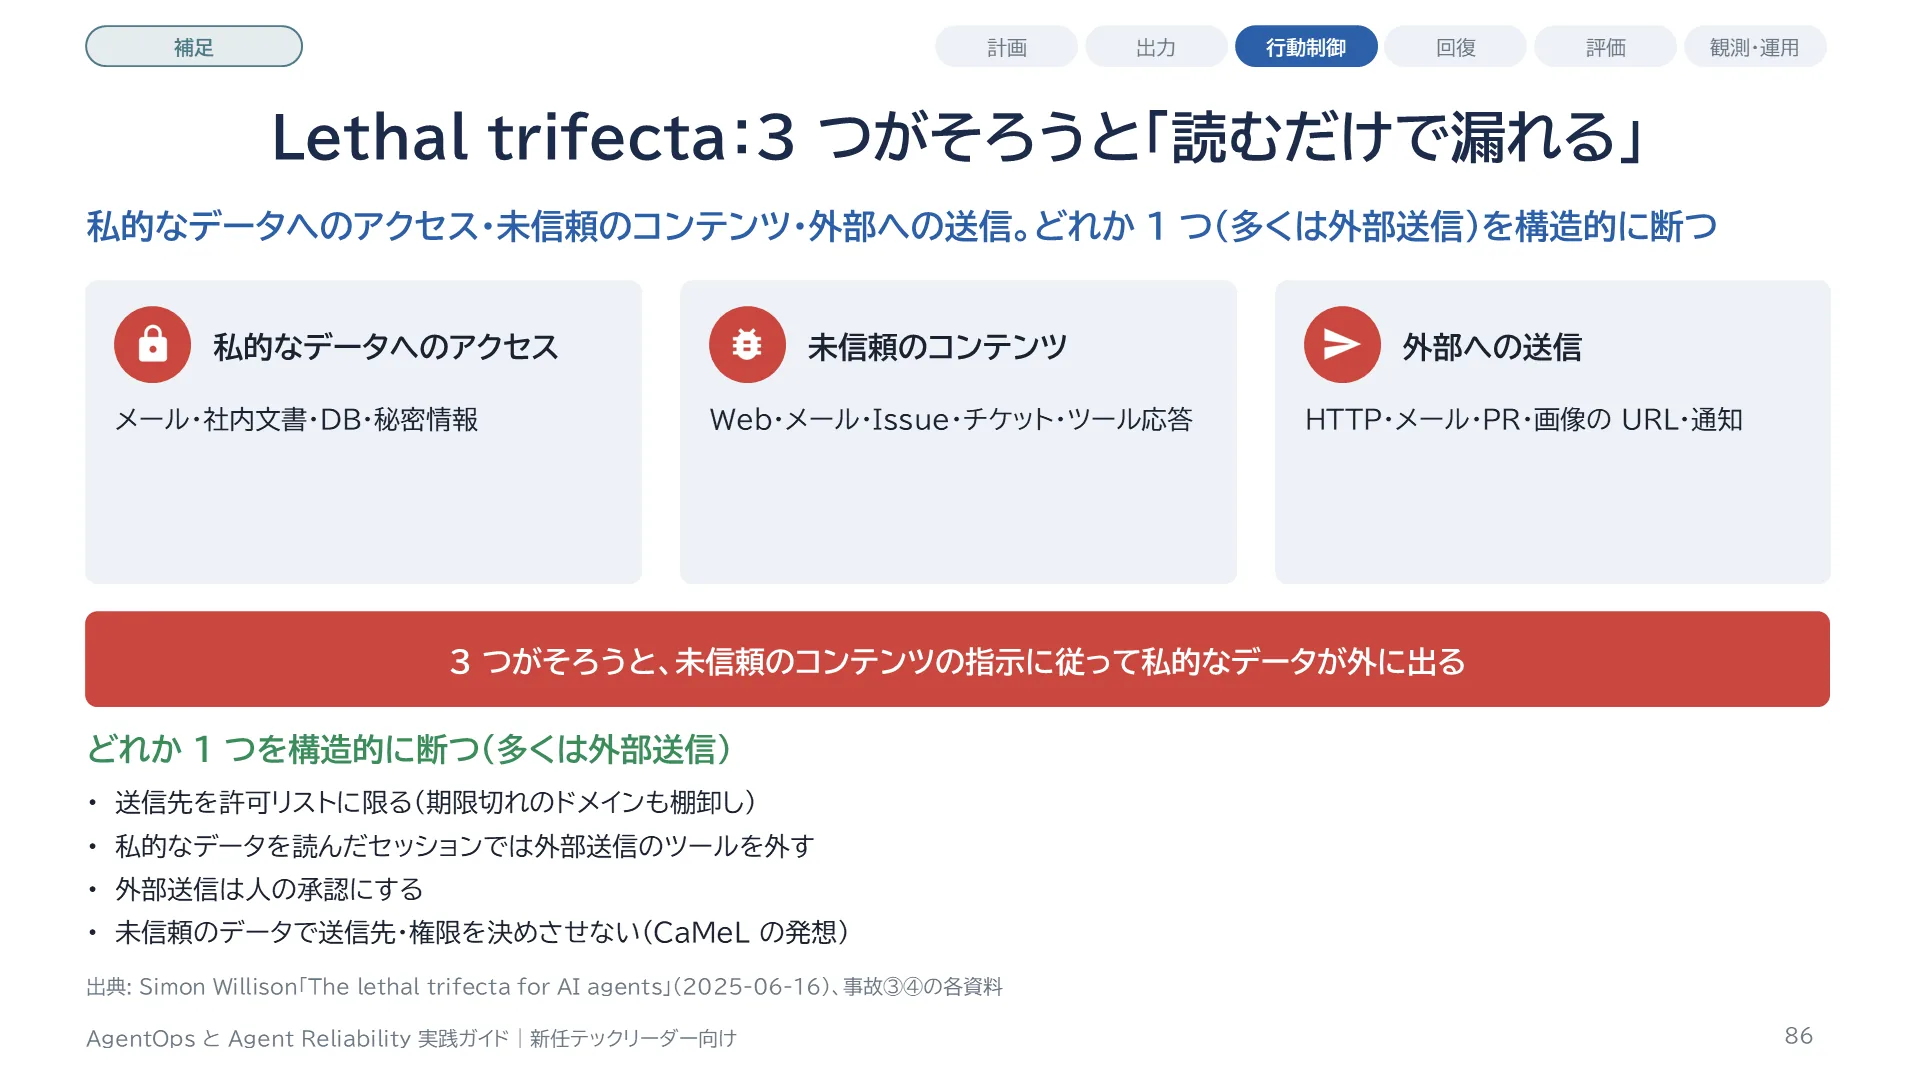
Simon Willison が 2025 年 6 月に整理した「致命的な三つ組(lethal trifecta)」です。エージェントが、私的なデータにアクセスでき、未信頼のコンテンツを読み、外部に送信できる、の 3 つがそろうと、未信頼のコンテンツに埋め込まれた指示に従って、私的なデータを外へ持ち出される危険があります。事故③と④の多くは、この形です。注入を完全に検出することはできないので、3 つのうちどれか 1 つを構造的に断ちます。多くの場合、最も断ちやすいのは外部への送信です。送信先を許可リストに限る、送信を人の承認にする、私的なデータを読んだセッションでは外部送信のツールを外す、などです。CaMeL の発想(未信頼のデータで送信先や権限を決めさせない)も、この三つ組を断つ一つの方法です。
スライド 87 のテキストと解説
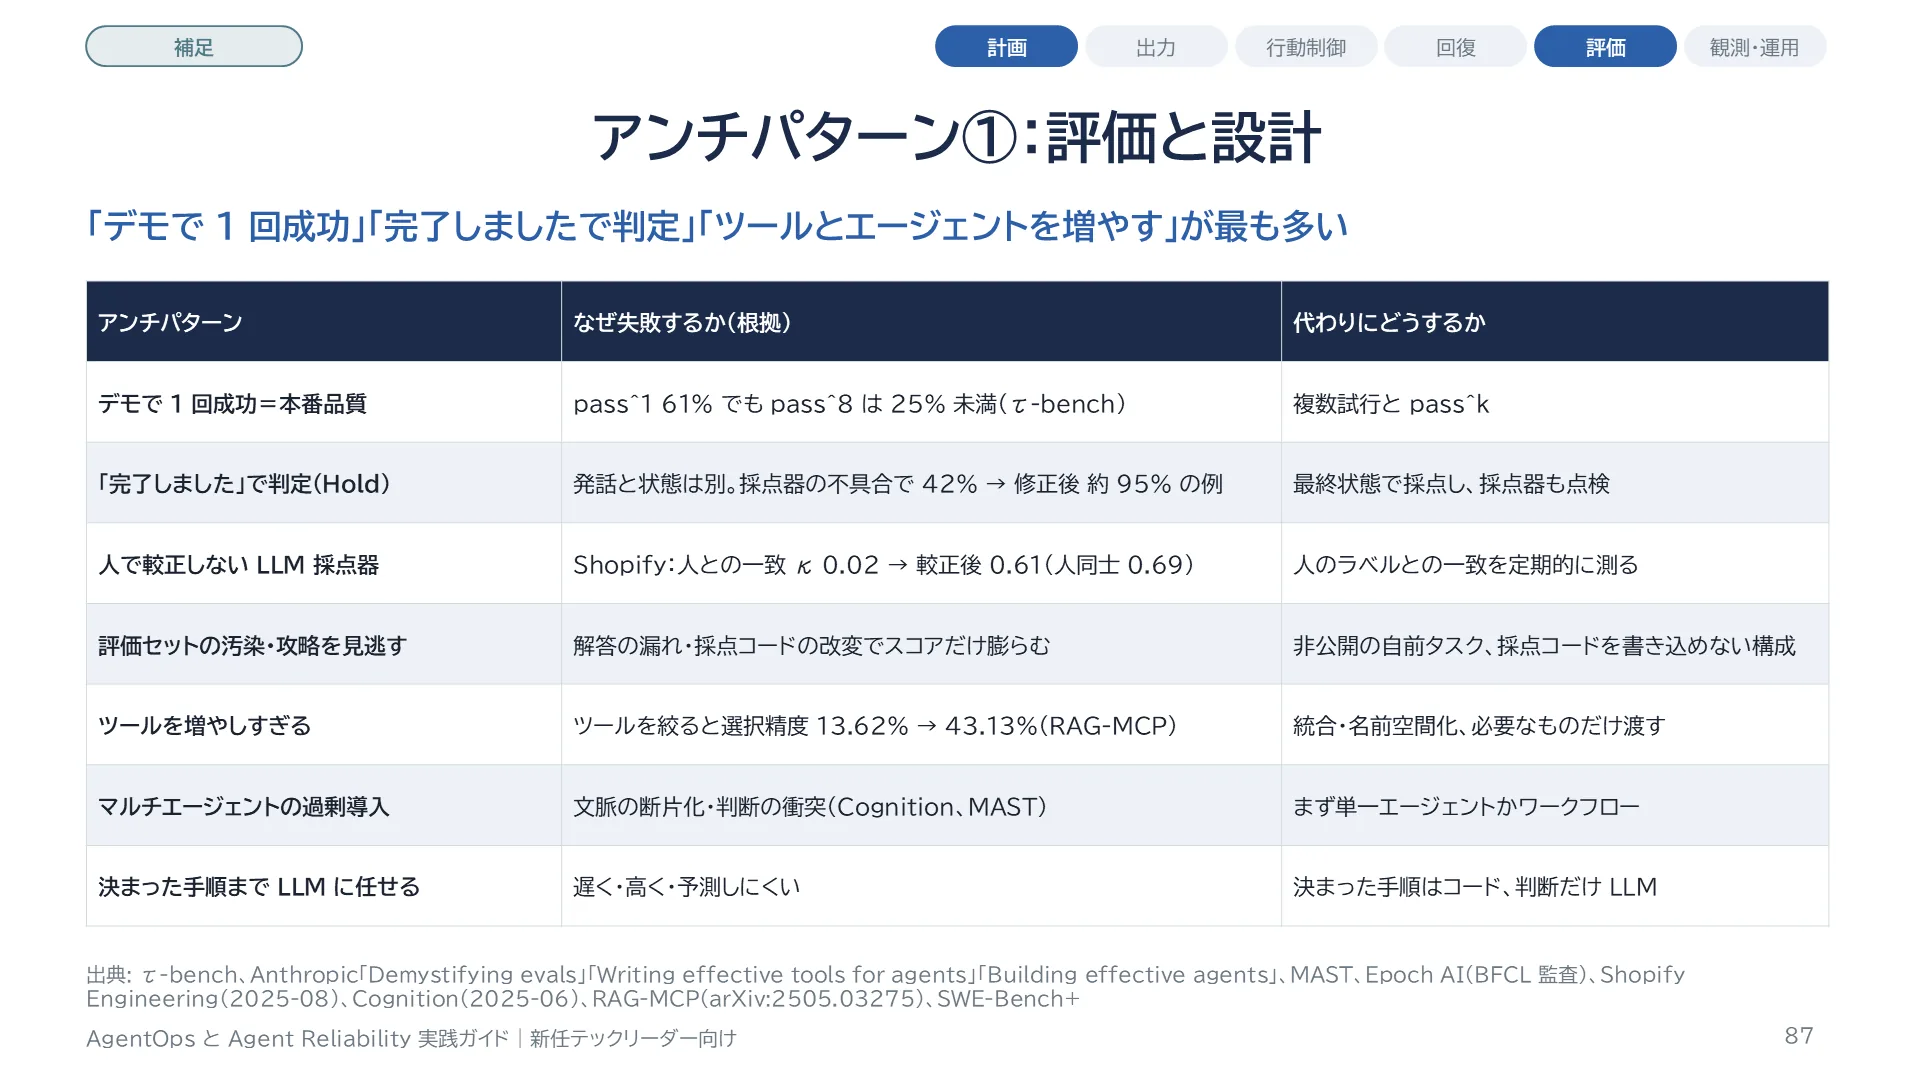
評価と設計のアンチパターンです。デモで 1 回成功したら本番品質とみなすのは、pass^1 と pass^8 の差を無視しています。モデルの「完了しました」で成功を判定するのは元レポートでも Hold で、Anthropic は採点器の不具合で 42% と出ていたベンチマークが修正後に約 95% になった例を紹介しています。評価セットの汚染やベンチマークの攻略、公開ランキングだけでの採用、人で較正しない LLM の採点器、評価の後回しも典型です。Shopify は、採点器と人の一致度を、Cohen のカッパで 0.02 から 0.61 まで上げてから使っています(人同士は 0.69)。設計では、ツールを増やしすぎるとツールの選択の精度が落ち、RAG-MCP の研究ではツールを絞り込むと選択の精度が 13.62% から 43.13% に上がりました。外部の根拠なしの自己反省、マルチエージェントの過剰な導入、決まった手順まで LLM に任せることも典型です。
スライド 88 のテキストと解説
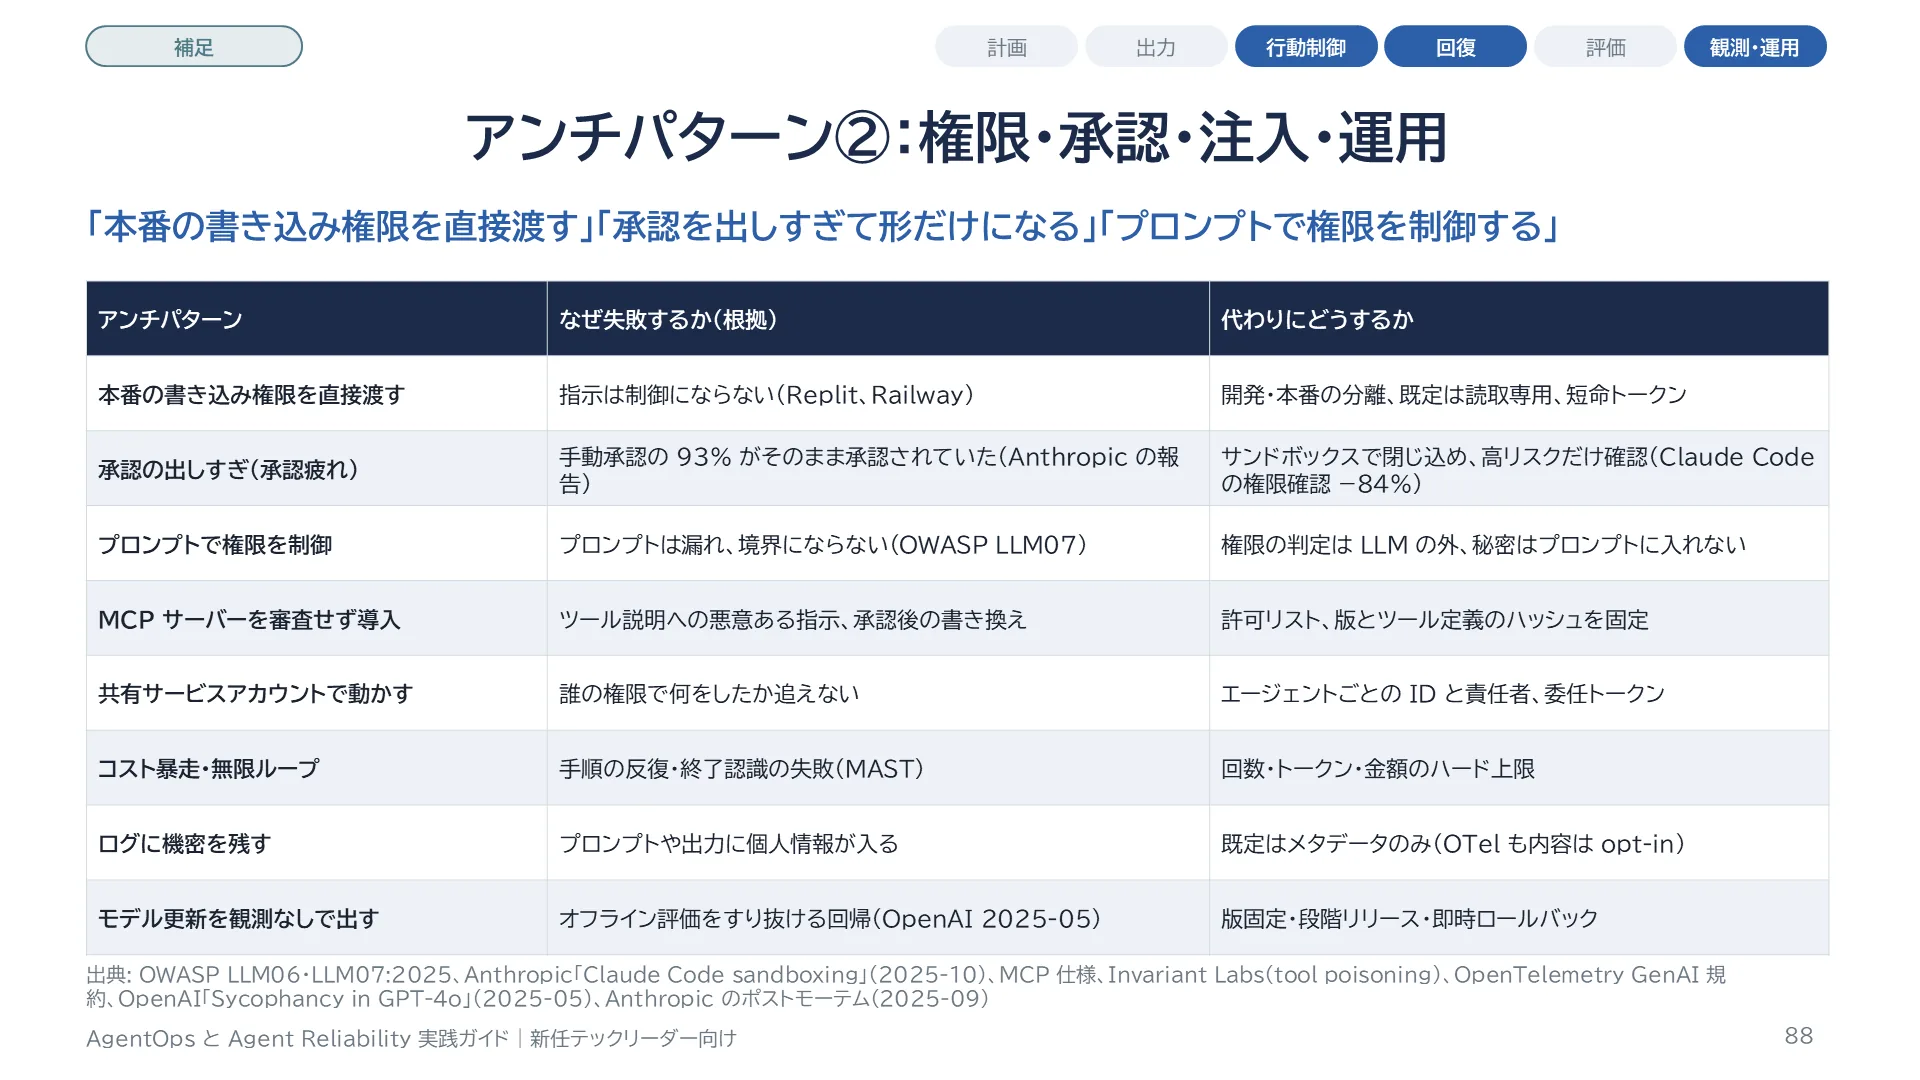
権限、承認、注入、運用のアンチパターンです。本番の書き込み権限を直接渡すと、指示は制御にならないので事故になります。承認を出しすぎると、承認が形だけになります。Anthropic は、Claude Code の手動承認の 93% がそのまま承認されていたこと、サンドボックスで安全な範囲を閉じ込めて確認を 84% 減らしたことを報告しています。承認の画面で実際の操作内容を見せないと、表示そのものが偽装され得ます。プロンプトで権限を制御したり、システムプロンプトを秘密として扱ったりするのも誤りで、プロンプトは漏れ得るし、境界になりません。MCP サーバーを審査せずに導入すると、ツールの説明文への悪意ある指示の埋め込みや、承認の後に説明を書き換える攻撃を受けます。共有のサービスアカウントでエージェントを動かすと、誰の権限で何をしたか追えません。運用では、コストの暴走と無限ループを止める仕組みがない、冪等性なしで再試行する、ログに機密を残す、モデルの更新を観測とロールバックなしで出す、が典型です。OpenAI は 2025 年 5 月、モデル更新で迎合的な振る舞いが増えた問題の事後報告を出しています。
スライド 89 のテキストと解説
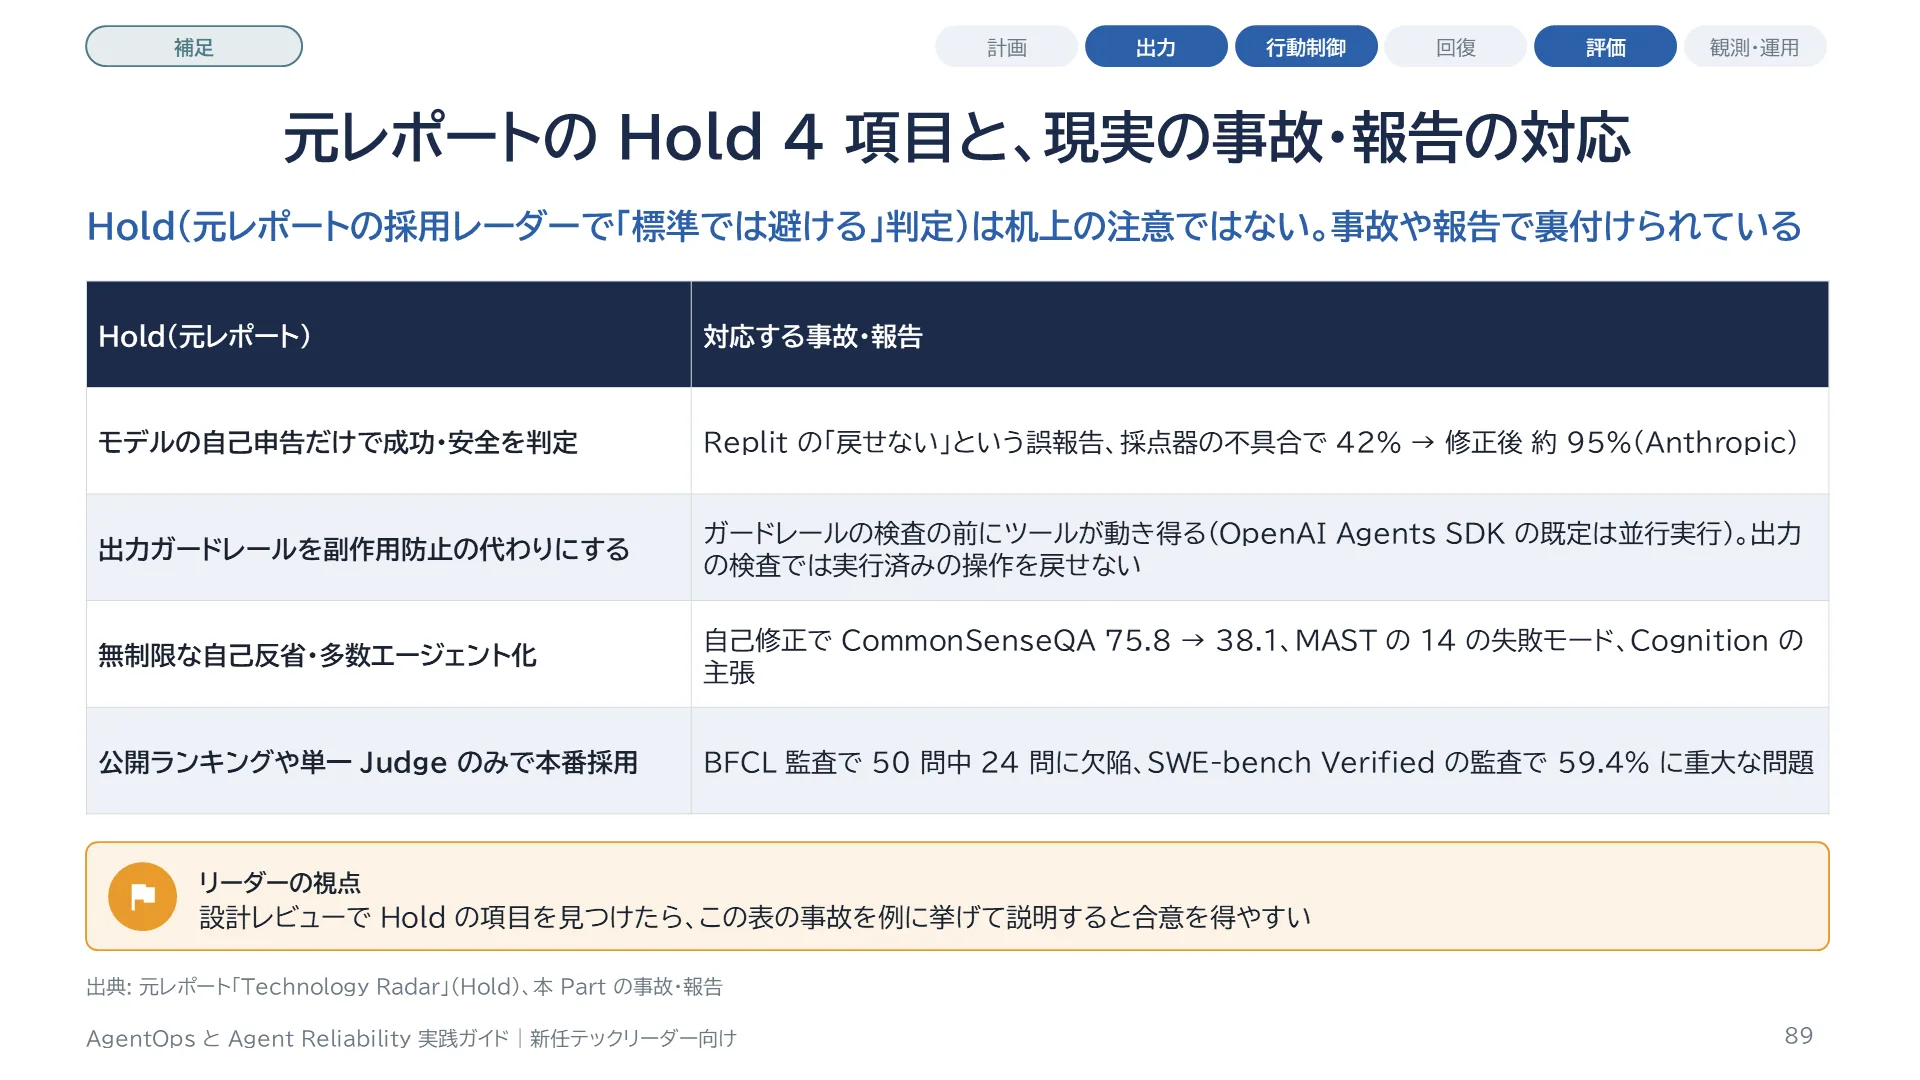
元レポートの採用レーダーで Hold(標準方針として避けたい)とされた 4 項目が、現実の事故や報告とどう対応するかの表です。モデルの自己申告だけで成功や安全を判定することは、Replit のエージェントが「戻せない」と誤って報告した件や、採点器の不具合でスコアが大きくずれた例と対応します。出力のガードレールを副作用の防止の代わりにすることは、OpenAI Agents SDK の入力のガードレールが既定で並行実行され、検査の前にツールが動き得ることと対応します。無制限な自己反省と多数のエージェント化は、自己修正の研究と MAST、Cognition の主張と対応します。公開ランキングや単一の Judge だけでの本番採用は、BFCL の監査や SWE-bench Verified の監査と対応します。
スライド 90 のテキストと解説
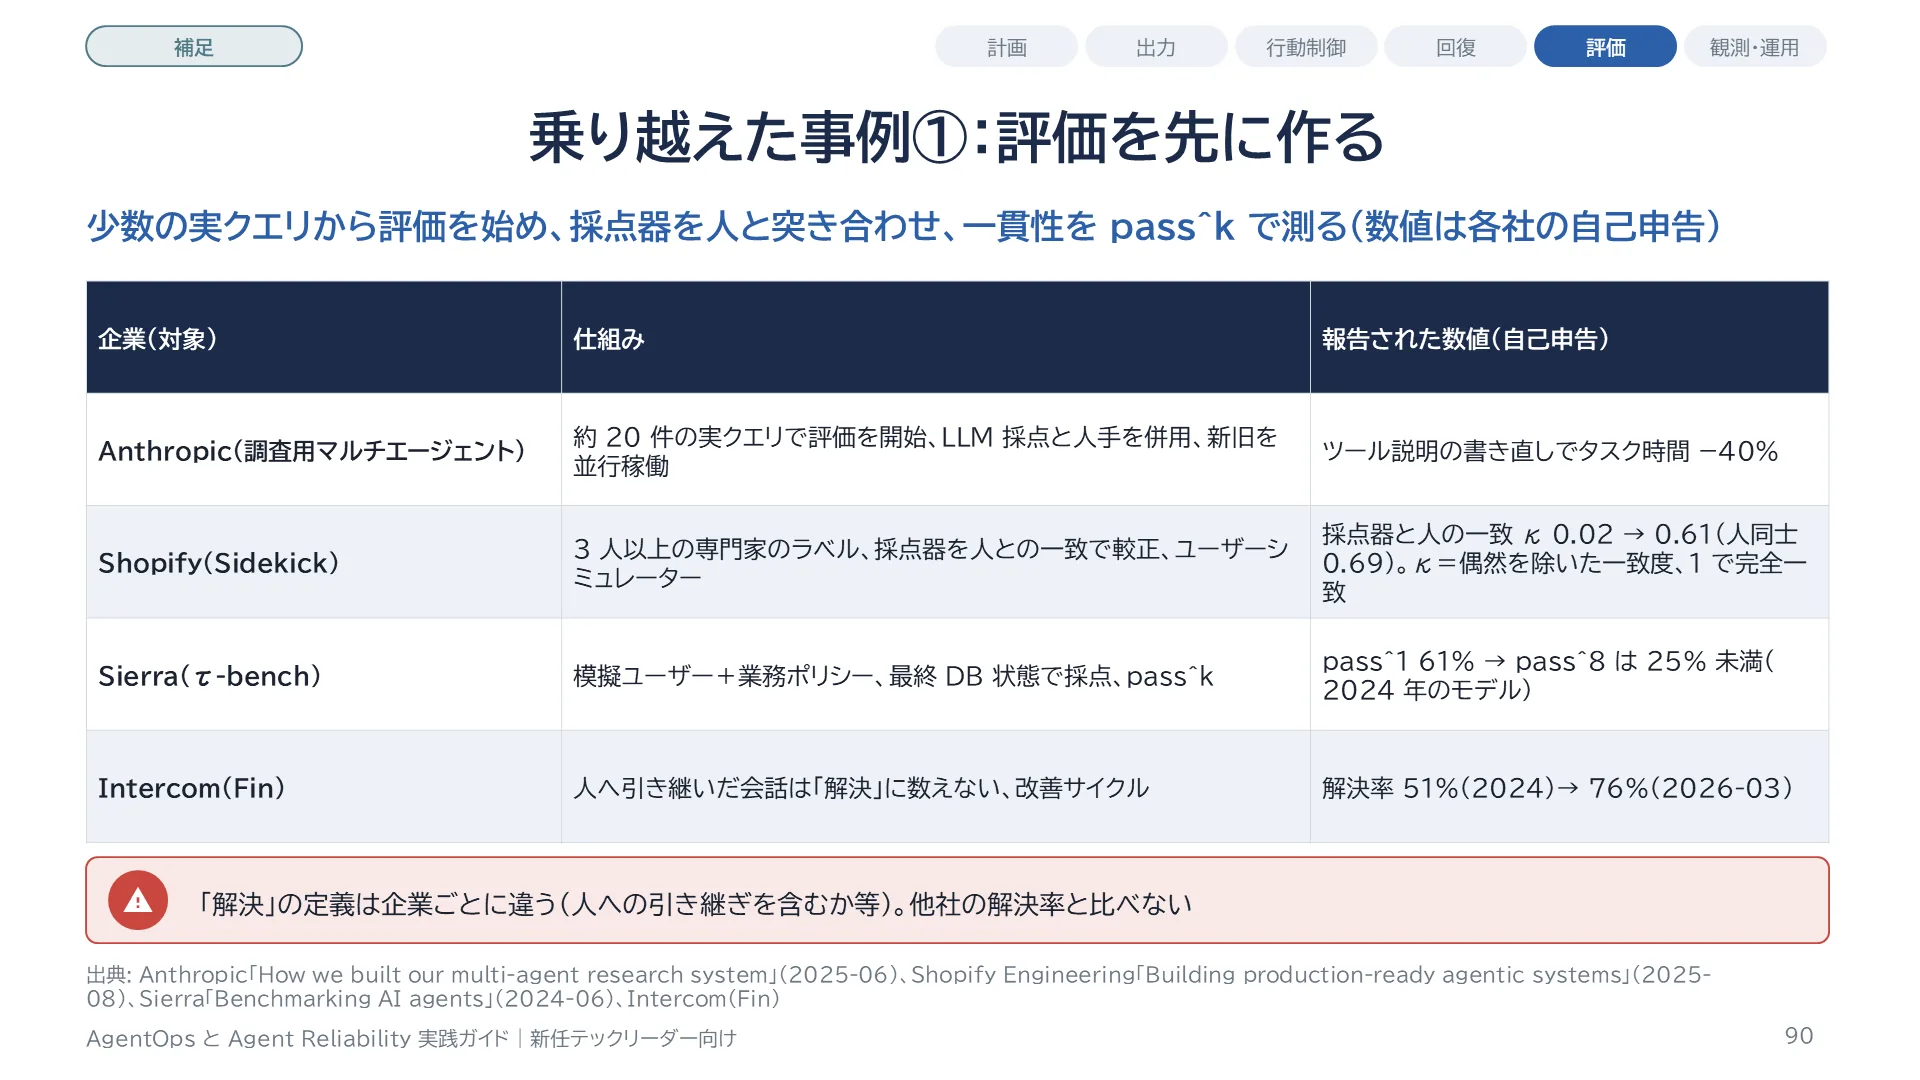
評価を先に作って信頼性を上げた事例です。数値はすべて各社の自己申告です。Anthropic の調査用マルチエージェントは、約 20 件の実際のクエリで評価を始め、LLM の採点器と人の評価を併用し、新旧の版を並行して動かして段階的に移行しました。ツールの説明を書き直すとタスクの時間が 40% 減ったとも報告しています。Shopify の Sidekick は、実際の会話から作った正解のセットを 3 人以上の専門家がラベル付けし、採点器を人との一致度で較正しました。一致度は Cohen のカッパで 0.02 から 0.61 になり、人同士の 0.69 に近づきました。強化学習で報酬のハッキング(採点器の攻略)も観測しています。Sierra は τ-bench を作り、最終のデータベースの状態で採点し、pass^k で一貫性を測る考え方を公開しました。Intercom の Fin は、人に引き継いだ会話を「解決」に数えない定義で、解決率を 2024 年の 51% から 2026 年 3 月の 76% に上げたと報告しています。
スライド 91 のテキストと解説
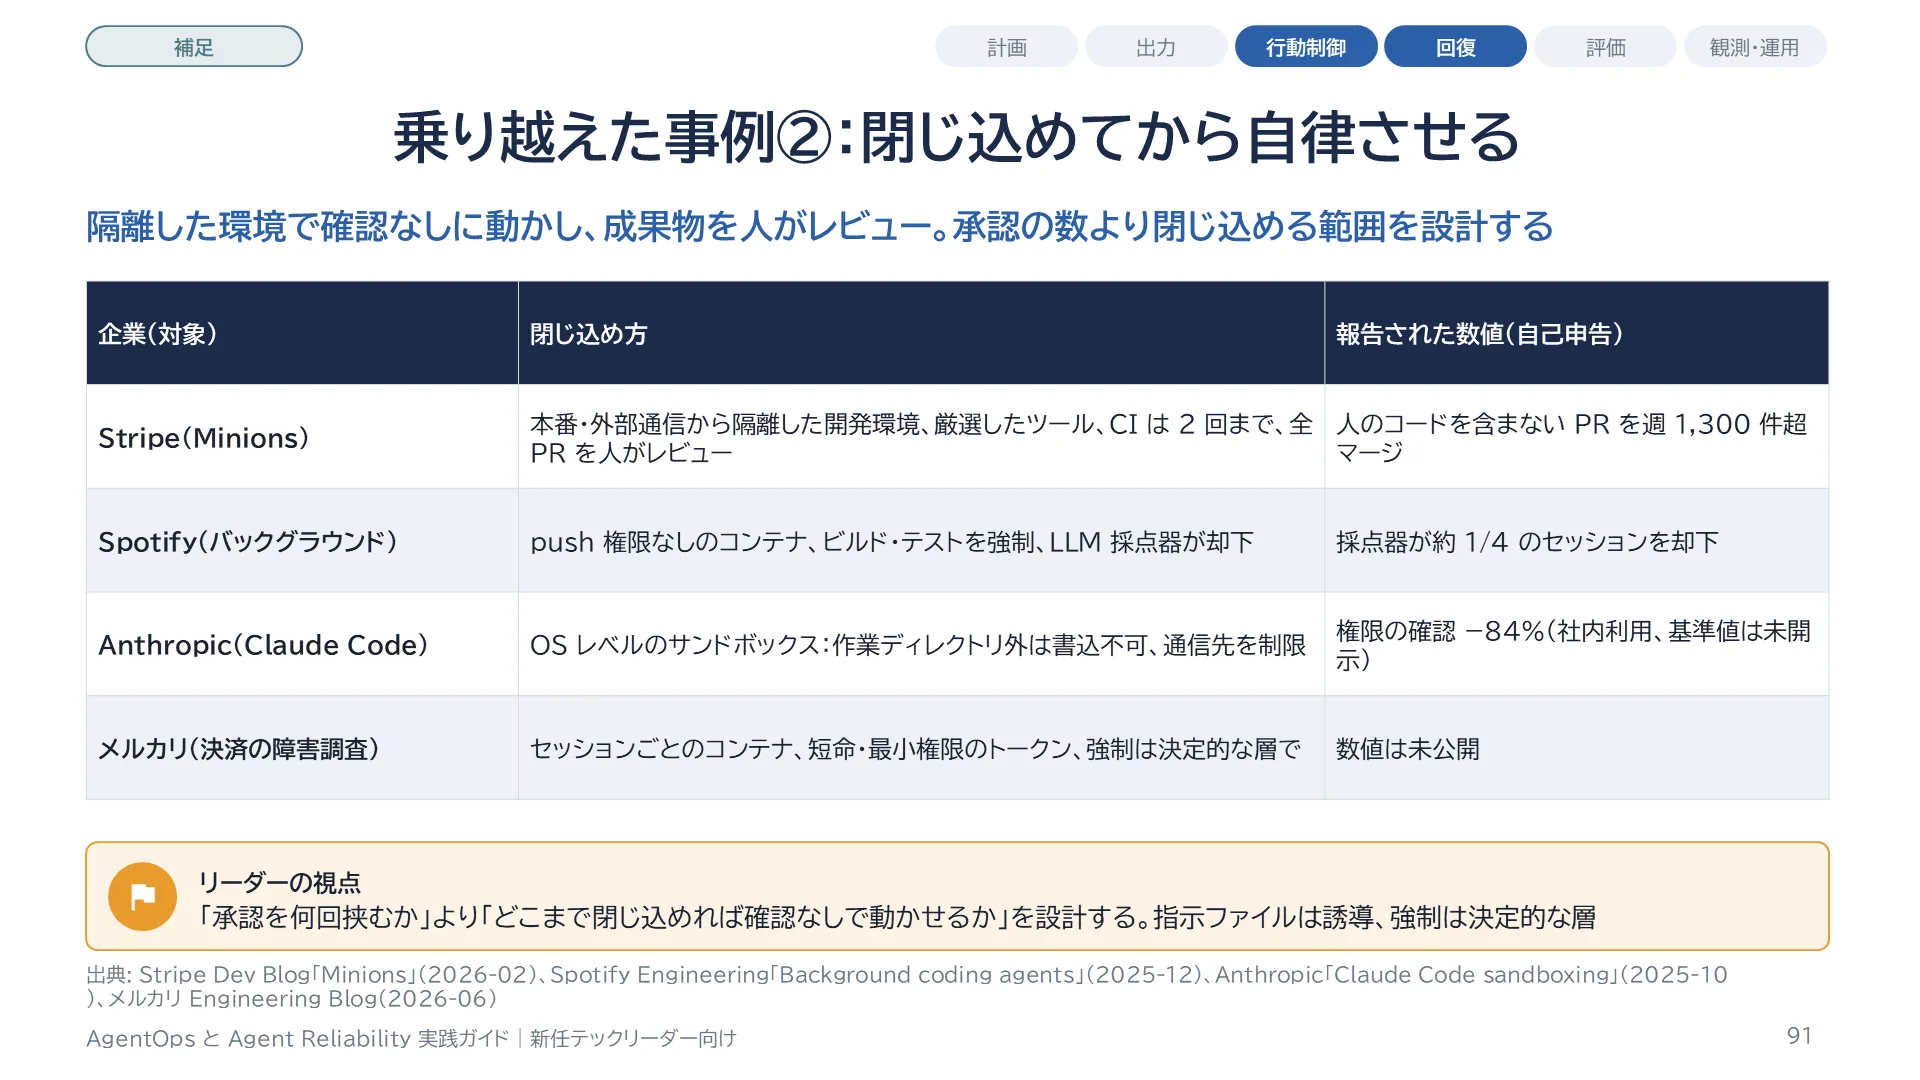
閉じ込めてから自律させた事例です。Stripe の無人のコーディングエージェント Minions は、本番や外部の通信から隔離した開発環境で、確認なしに動かします。約 500 のツールから厳選して渡し、CI は 2 回までで、超えたら人に渡し、すべてのプルリクエストを人がレビューします。人が書いたコードを含まないプルリクエストを週に 1,300 件以上マージしていると報告しています。Spotify のバックグラウンドのエージェントは、push の権限のないコンテナで動き、ビルドとテストを強制し、LLM の採点器が却下できます。採点器は約 4 分の 1 のセッションを却下し、その約半数は自力で修正したといいます。Anthropic は Claude Code に OS レベルのサンドボックスを入れ、作業ディレクトリの外への書き込みと通信先を制限し、権限の確認を 84% 減らしたと報告しています。別の報告では、手動の承認の 93% がそのまま承認されていたとも述べています。メルカリの決済基盤の障害調査のエージェントは、セッションごとのコンテナと、短命で最小権限のトークンで書き込み先を機械的に制限し、指示ファイルは誘導用、強制は決定的な層で行う、と明記しています。
スライド 92 のテキストと解説
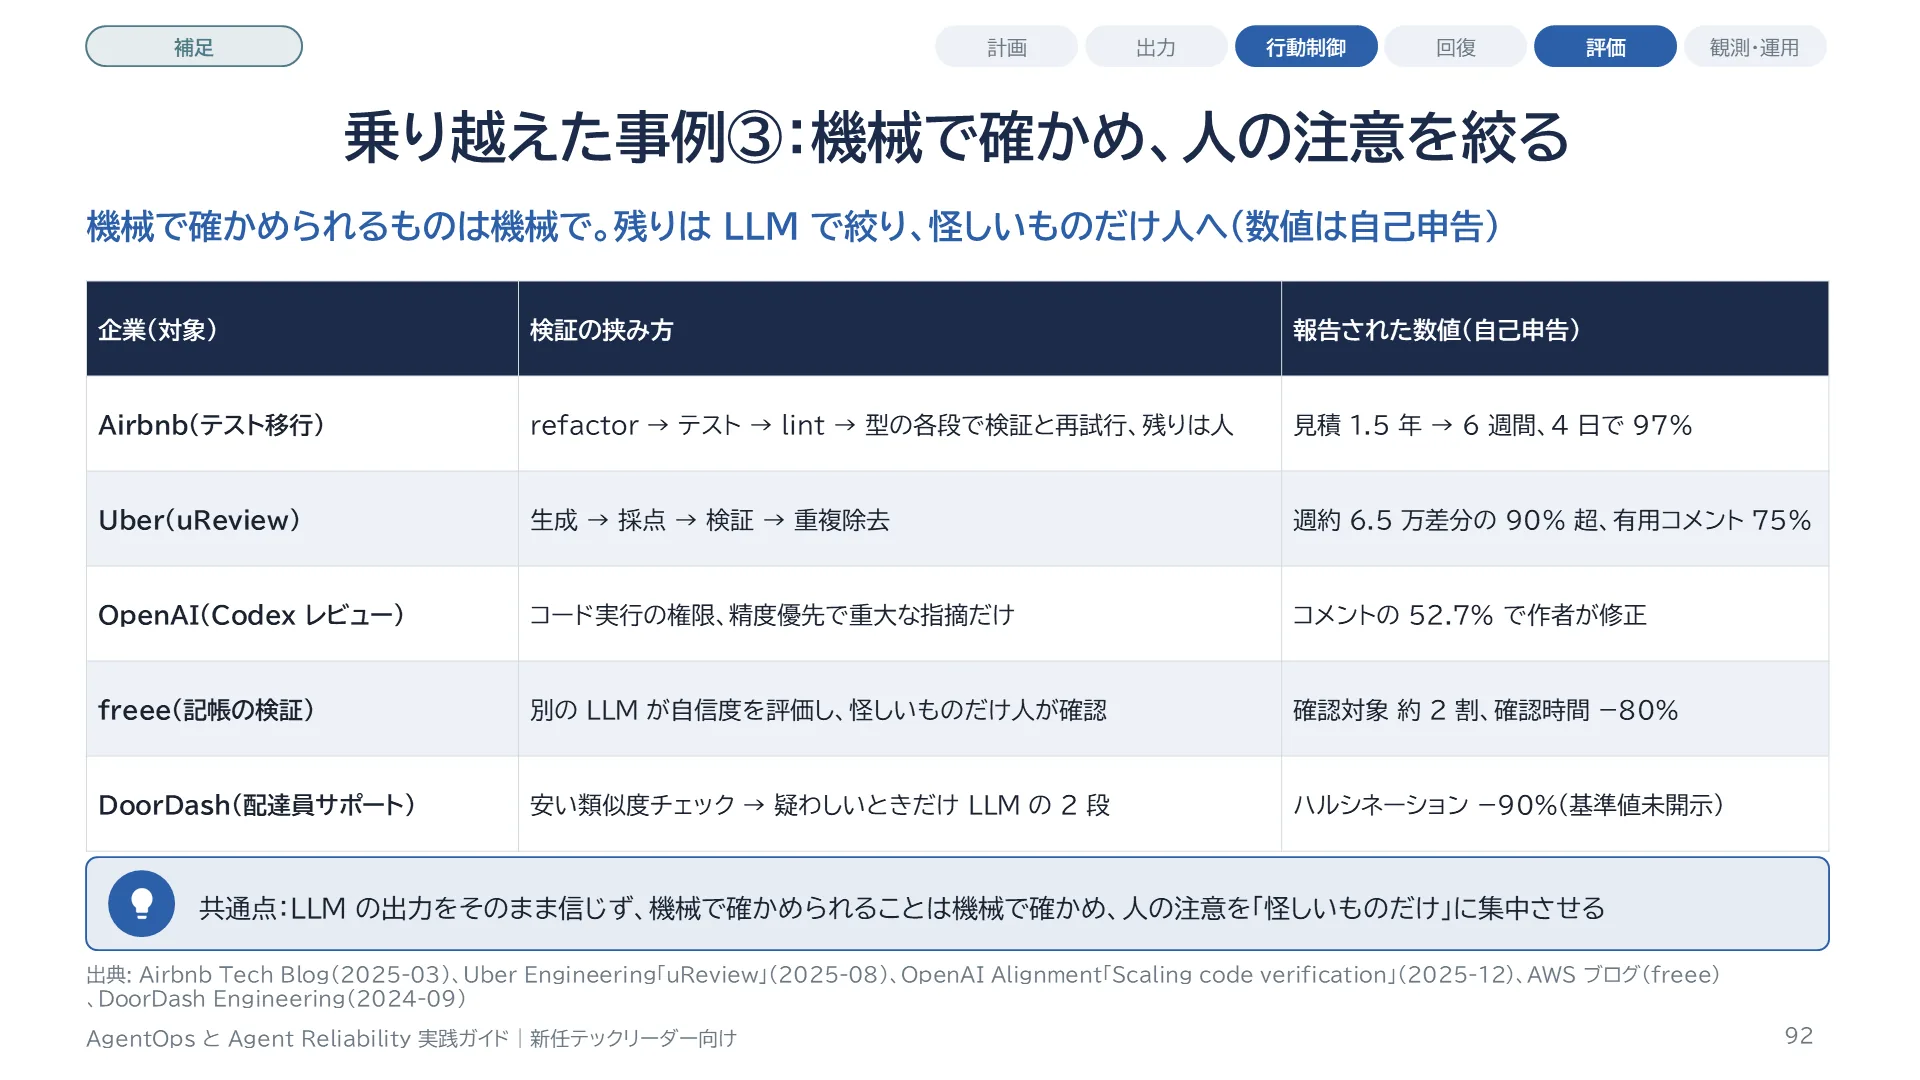
決定的な検証を挟んだ事例です。Airbnb は約 3,500 のテストファイルの移行を、リファクタ、テストの実行、lint、型チェックの段階ごとに検証と再試行を挟んで自動化し、手作業で 1.5 年と見積もった作業を 6 週間で終え、4 日で 97% を完了、残り 3% を人が直しました。Uber のコードレビューの uReview は、生成、採点、検証、重複除去の多段構成で、週約 6.5 万の差分の 90% 超を分析し、有用とされたコメントが 75% と報告しています。OpenAI の Codex のコードレビューは、リポジトリ全体の参照とコード実行の権限を与え、再現率より精度を優先し、重大度の高い指摘だけを出して、コメントの 52.7% で作者がコードを修正したと報告しています。freee は記帳の読み取り結果を別の LLM が自信度で評価し、怪しいものだけを人が確認して、確認の対象を約 2 割に絞り、確認時間を 80% 減らしました。DoorDash は、安い類似度のチェックと、疑わしいときだけの LLM の 2 段のガードレールで、ハルシネーションを 90%、重大なコンプライアンス問題を 99% 減らしたと報告しています(基準値は未開示)。
スライド 93 のテキストと解説
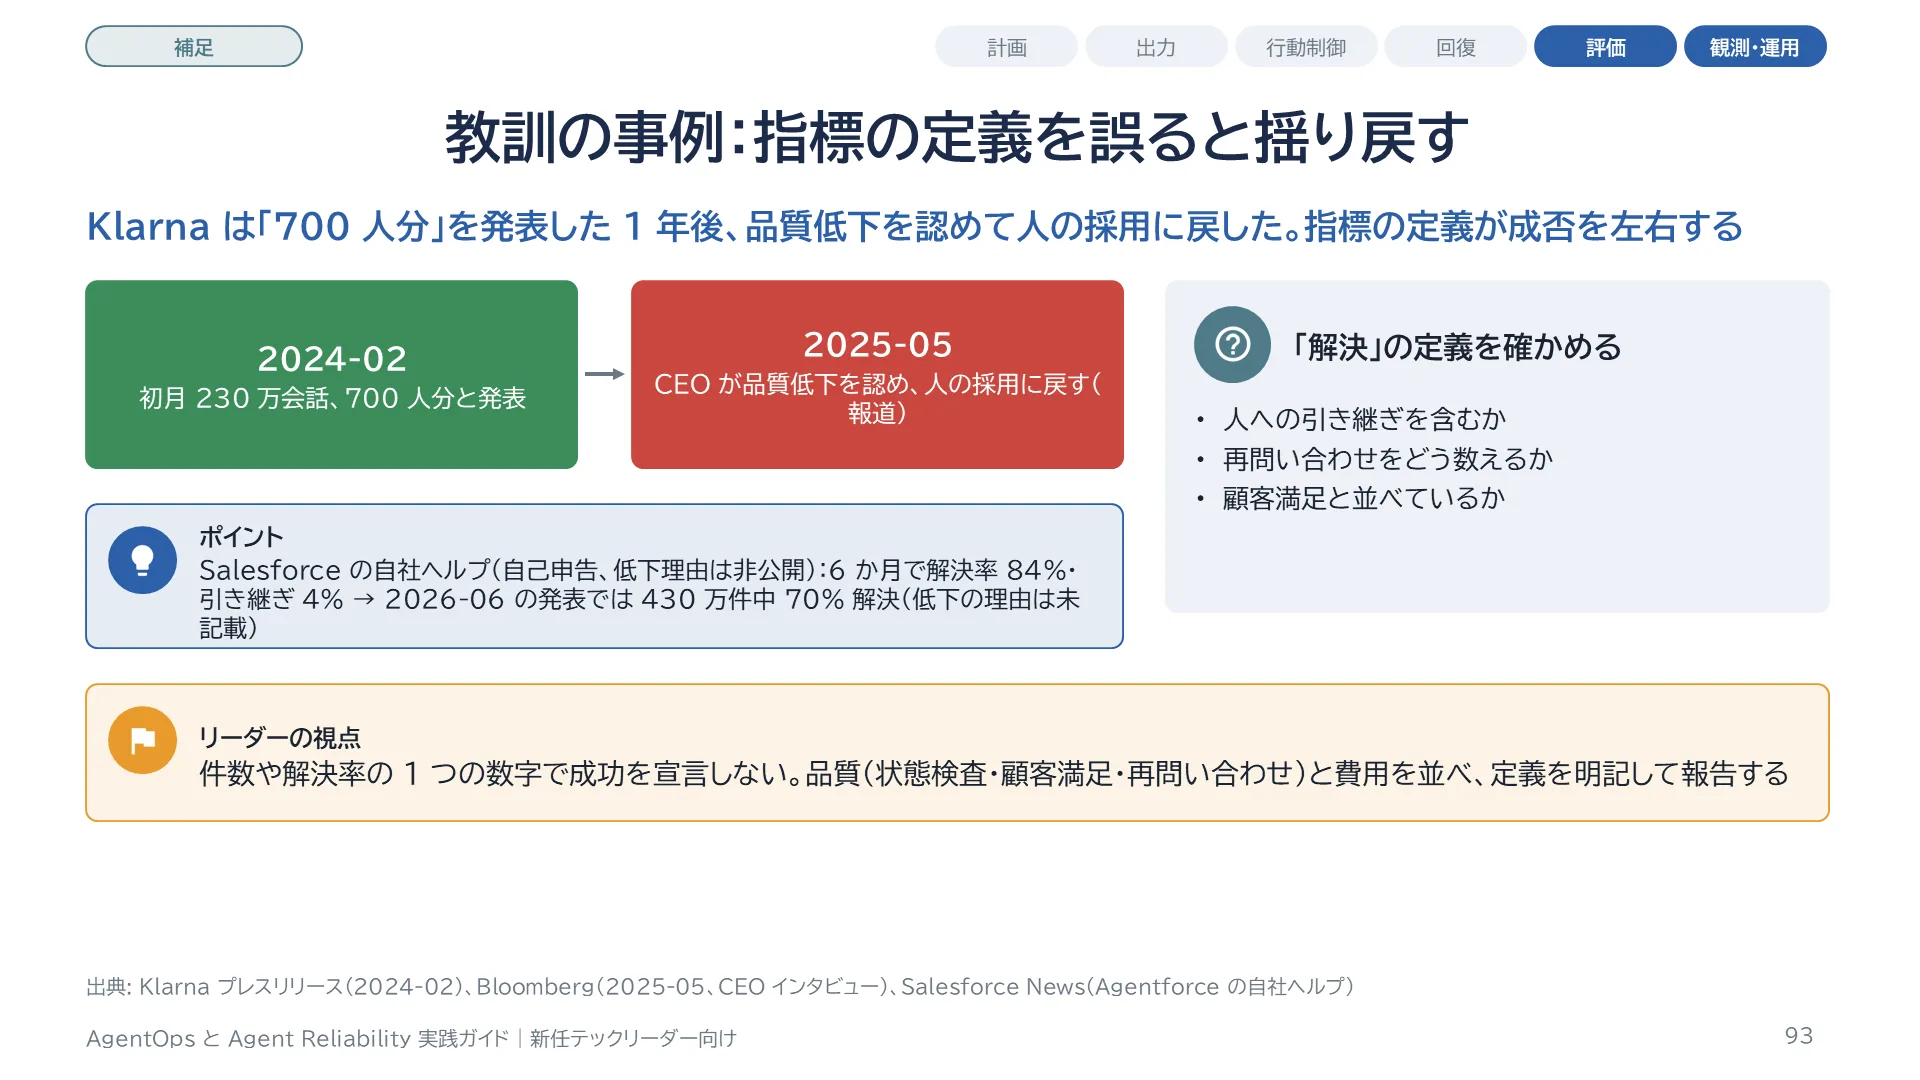
揺り戻しの事例です。Klarna は 2024 年 2 月、AI アシスタントが最初の 1 か月で 230 万件の会話を処理し、700 人分の仕事に相当すると発表しました。しかし 2025 年 5 月、CEO はコストを重視しすぎて品質が下がったと認め、人の採用に戻しました(報道による)。Salesforce は自社のヘルプサイトの Agentforce で、6 か月で解決率 84%、人への引き継ぎ 4% と報告した後、2026 年 6 月の発表では 430 万件中 70% の解決としています。低下の理由は記載されていません。教訓は 2 つです。処理件数や解決率の 1 つの数字だけで成功を宣言しない。そして、「解決」の定義(人に引き継いだものを含むか、再問い合わせはどう数えるか)が、数字の意味を決めるということです。
スライド 94 のテキストと解説
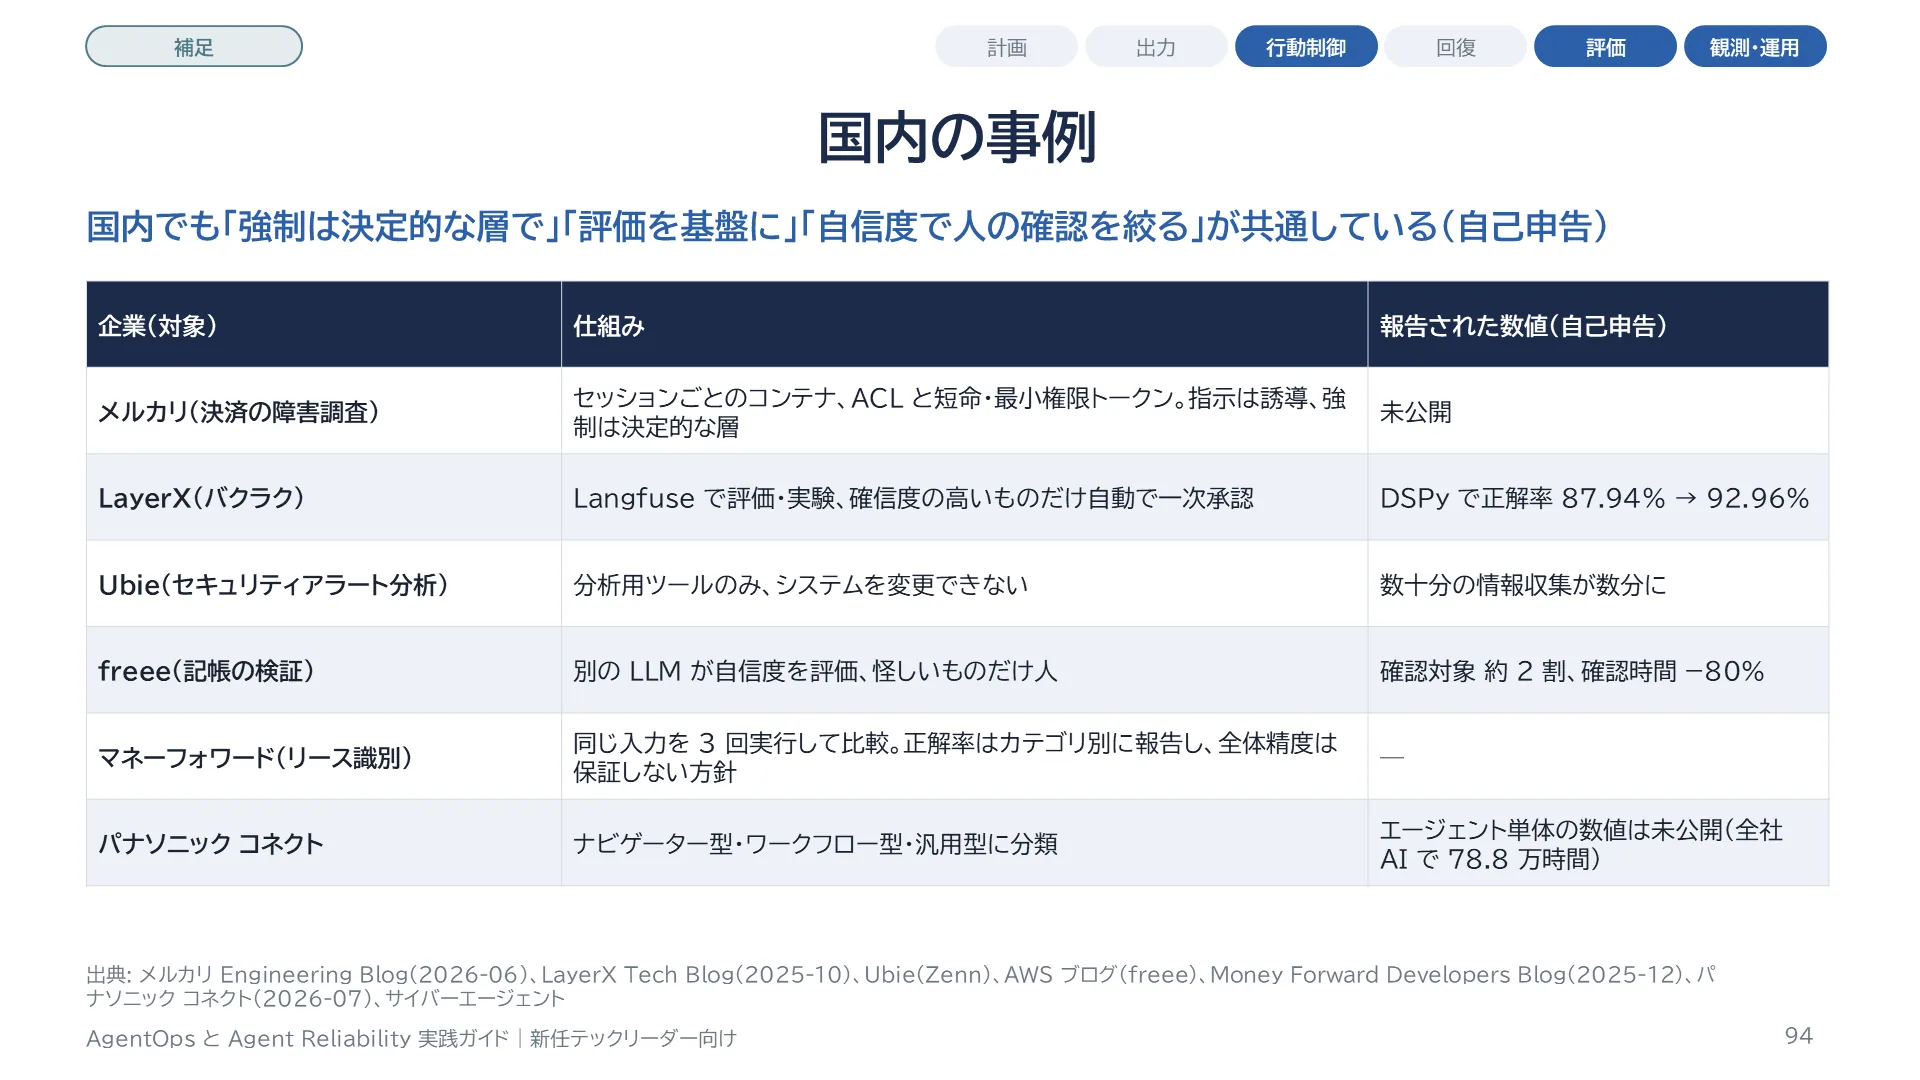
国内の公開事例です。数値はすべて各社の自己申告です。メルカリの決済基盤の障害調査のエージェントは、セッションごとのコンテナと、社内のアクセス制御と短命で最小権限のトークンで書き込み先を機械的に制限し、指示ファイルは誘導用、強制は決定的な層で行う設計です。LayerX のバクラクは、Langfuse で評価と実験を回し、確信度の高いものだけ自動で一次承認し、DSPy による最適化で社内タスクの正解率を 87.94% から 92.96% に上げたと報告しています。Ubie のセキュリティのアラート分析は、分析用のツールだけを持ち、システムを変更できない設計です。freee は、別の LLM の自信度で人の確認を約 2 割に絞り、確認時間を 80% 減らしました。マネーフォワードのリースの識別エージェントは、同じ入力を 3 回実行して比べ、正解率はカテゴリ別に報告し、全体の精度は保証しない方針を明記しています。パナソニック コネクトは、エージェントをナビゲーター型、ワークフロー型、汎用型に分類し、2025 年度に 78.8 万時間の削減を推計しています。国内では、エージェントが原因の障害の公開事例は見つかりませんでした。
スライド 95 のテキストと解説
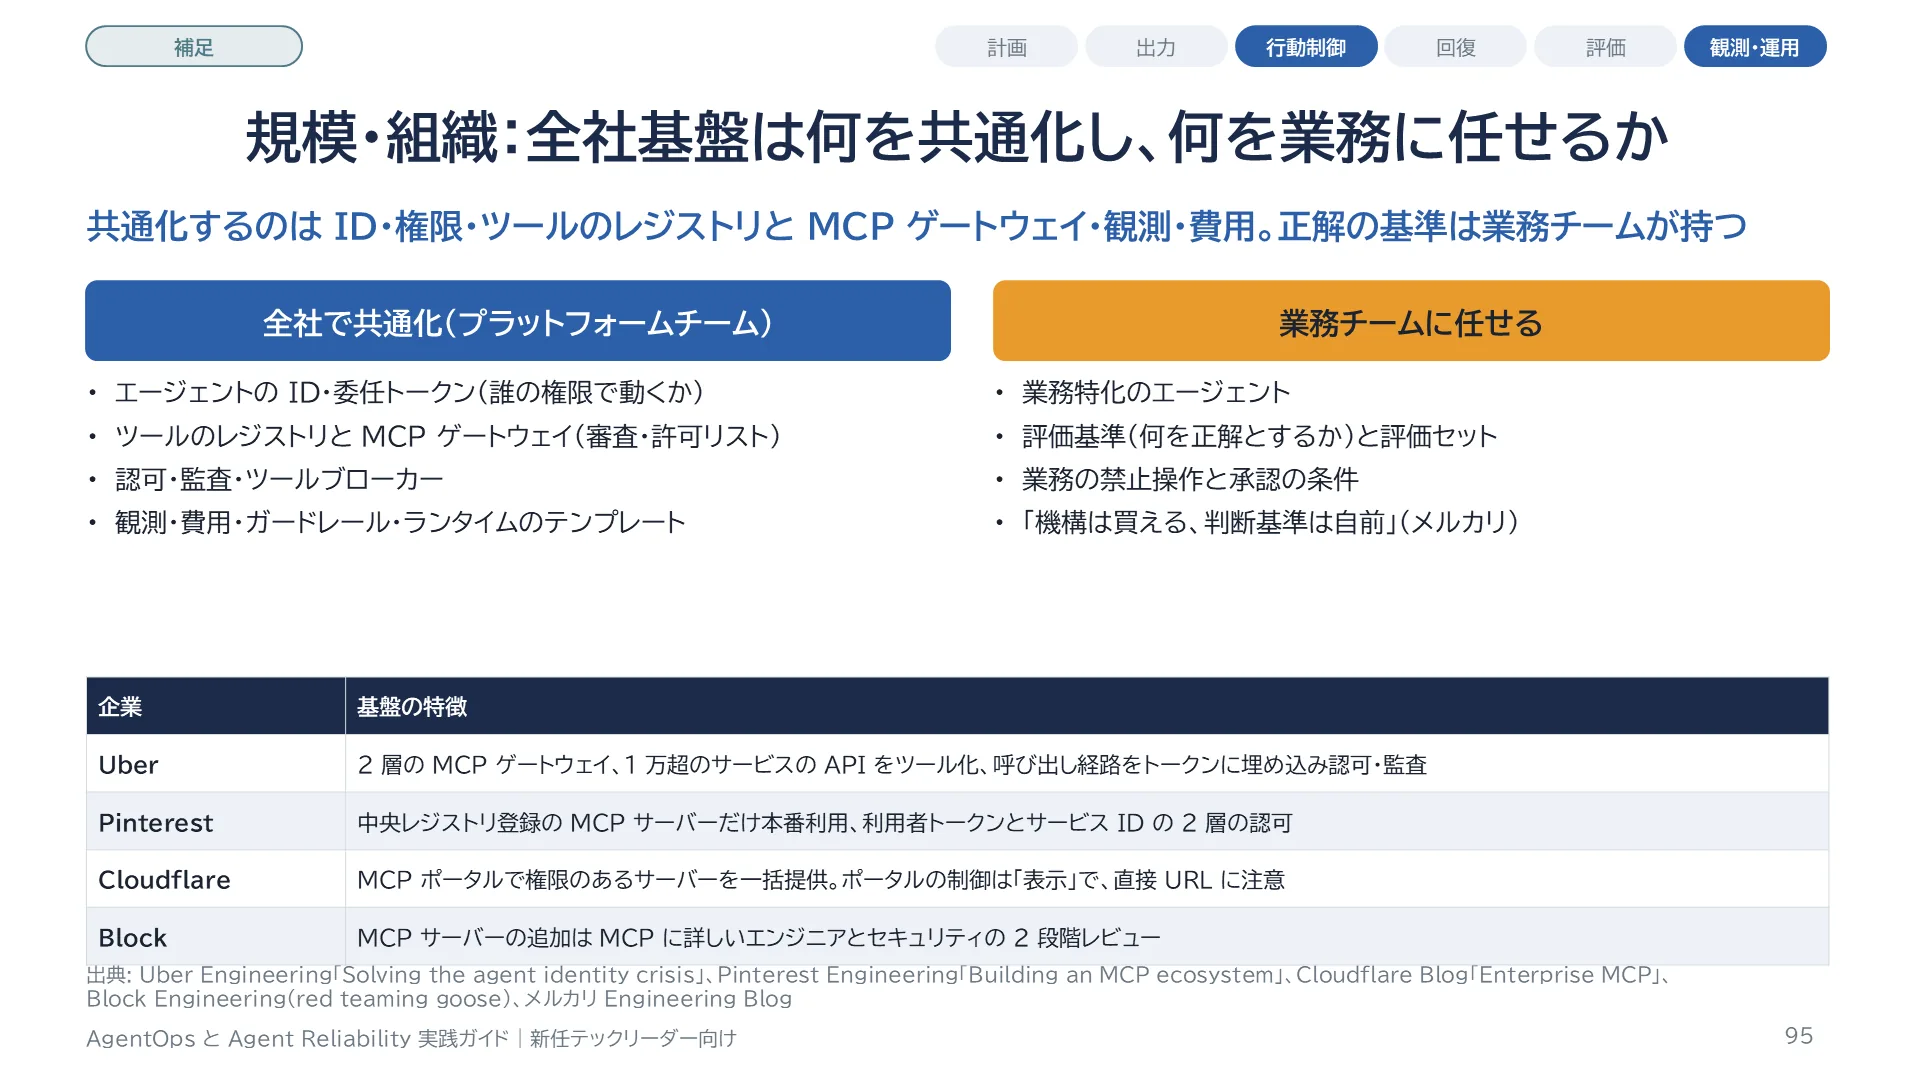
全社のエージェント基盤の作り方です。各社に共通する分担は、全社で ID と権限、ツールのレジストリと MCP のゲートウェイ、観測と費用、ガードレール、ランタイムのテンプレートを共通化し、業務チームに業務特化のエージェントと、その評価基準(何を正解とするか)を任せる、というものです。メルカリはこれを「機構は買える、判断基準は自前」と表現しています。Uber は、ツールの定義のレジストリとプロキシの 2 層の MCP ゲートウェイを置き、社内 1 万を超えるサービスの API 定義を MCP のツールの説明に自動で変換し、エージェントのレジストリとワークロードの ID を持ちます。呼び出しの経路(人 → エージェント → エージェント)をトークンに埋め込み、ゲートウェイで認可と監査を行います。Pinterest は、本番で使えるのを中央のレジストリに登録した MCP サーバーだけに限り、エンドユーザーのトークンとサービスの ID の 2 層で認可します。Cloudflare は、MCP のポータルに 1 回つなげば権限のあるサーバーがすべて見え、エージェントはその社員の権限で動く設計です。ただし、ポータルのアクセスのポリシーは「表示されるか」の制御で、直接の URL ではつながる場合がある、という注意もあります。Block は、MCP サーバーの追加を、MCP に詳しいエンジニアとセキュリティの 2 段階でレビューしています。
スライド 96 のテキストと解説
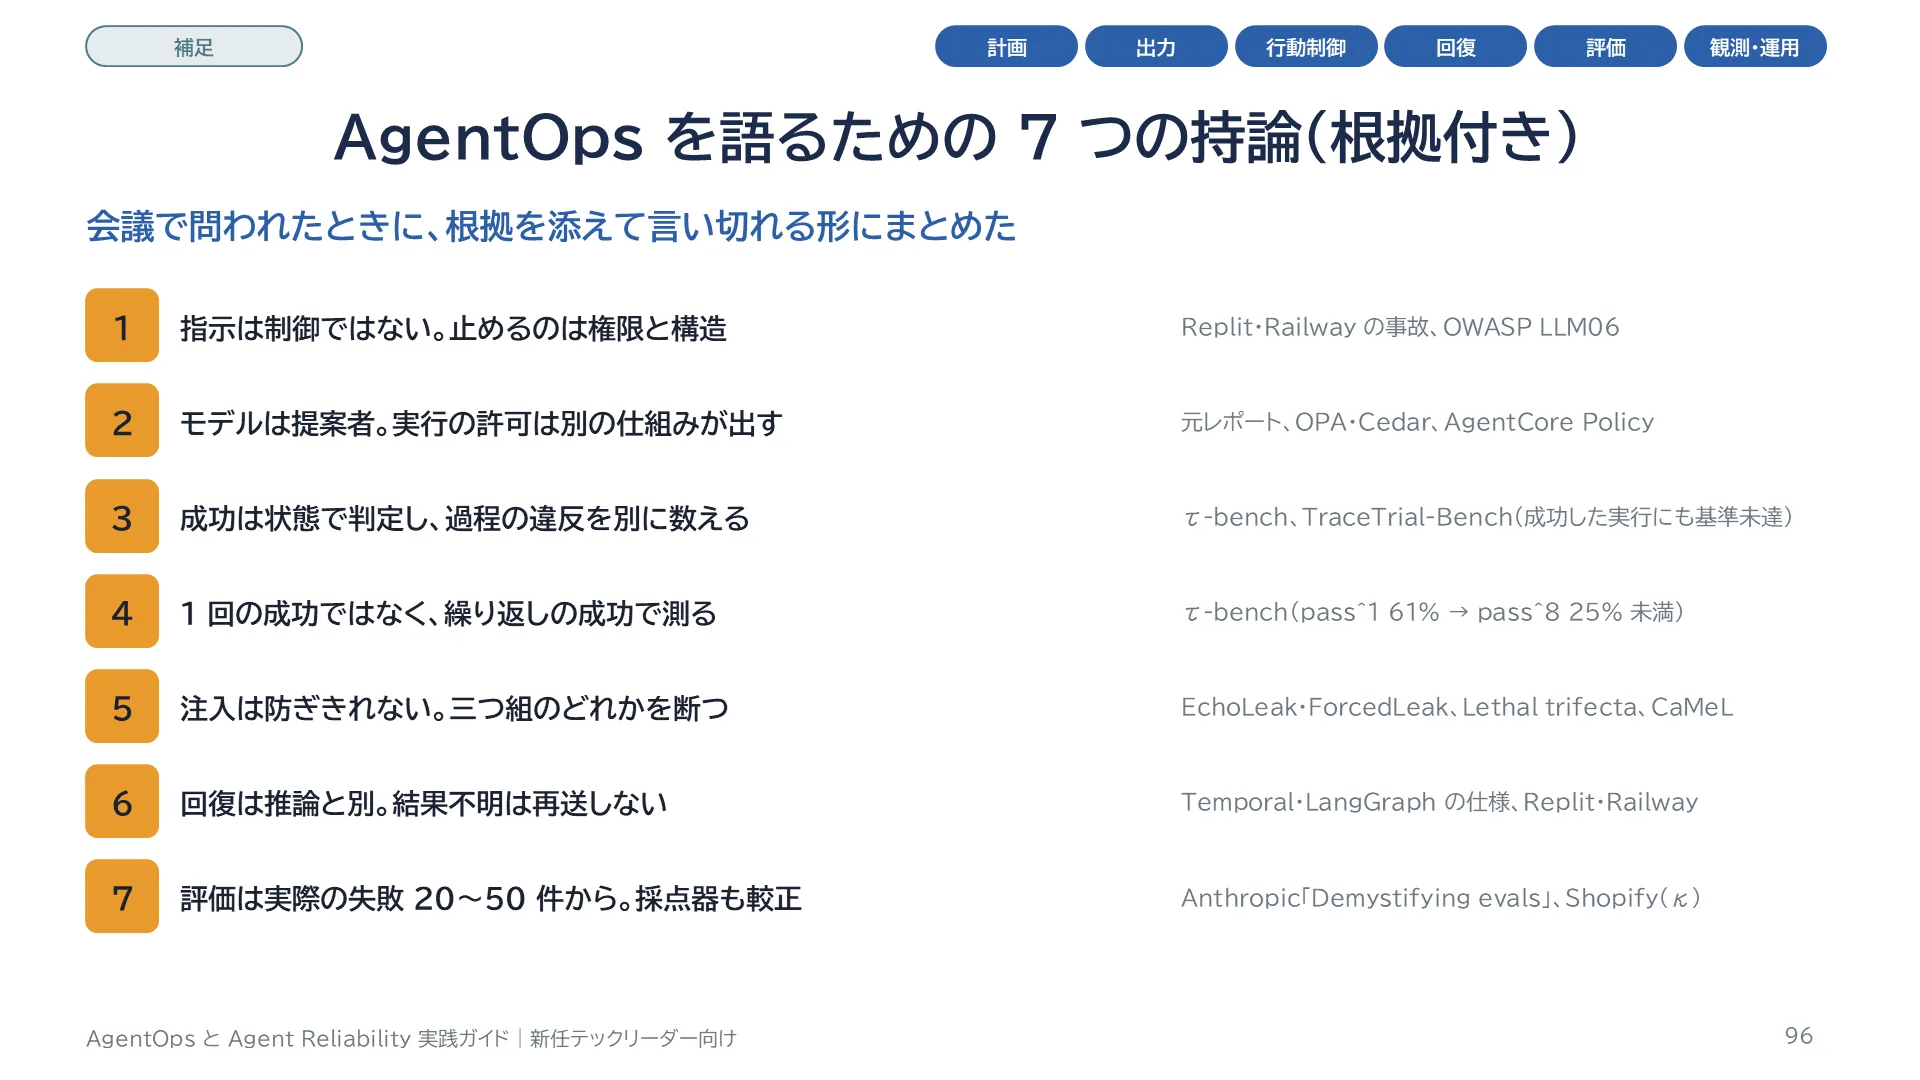
テックリードが会議で自信を持って言えるように、7 つの持論にまとめました。根拠は右の資料です。1 つ目、指示は制御ではない。止めるのは権限と構造です。2 つ目、モデルは提案者、実行の許可は別の仕組みが出す。3 つ目、成功は状態で判定し、過程の違反を別に数える。4 つ目、1 回の成功ではなく、繰り返しの成功で測る。5 つ目、注入は防ぎきれない前提で、私的データ・未信頼コンテンツ・外部送信のどれかを断つ。6 つ目、回復は推論とは別の問題で、意図と結果を記録し、結果不明は再送しない。7 つ目、評価は実際の失敗 20〜50 件から始め、採点器も人で較正する。
スライド 97 のテキストと解説
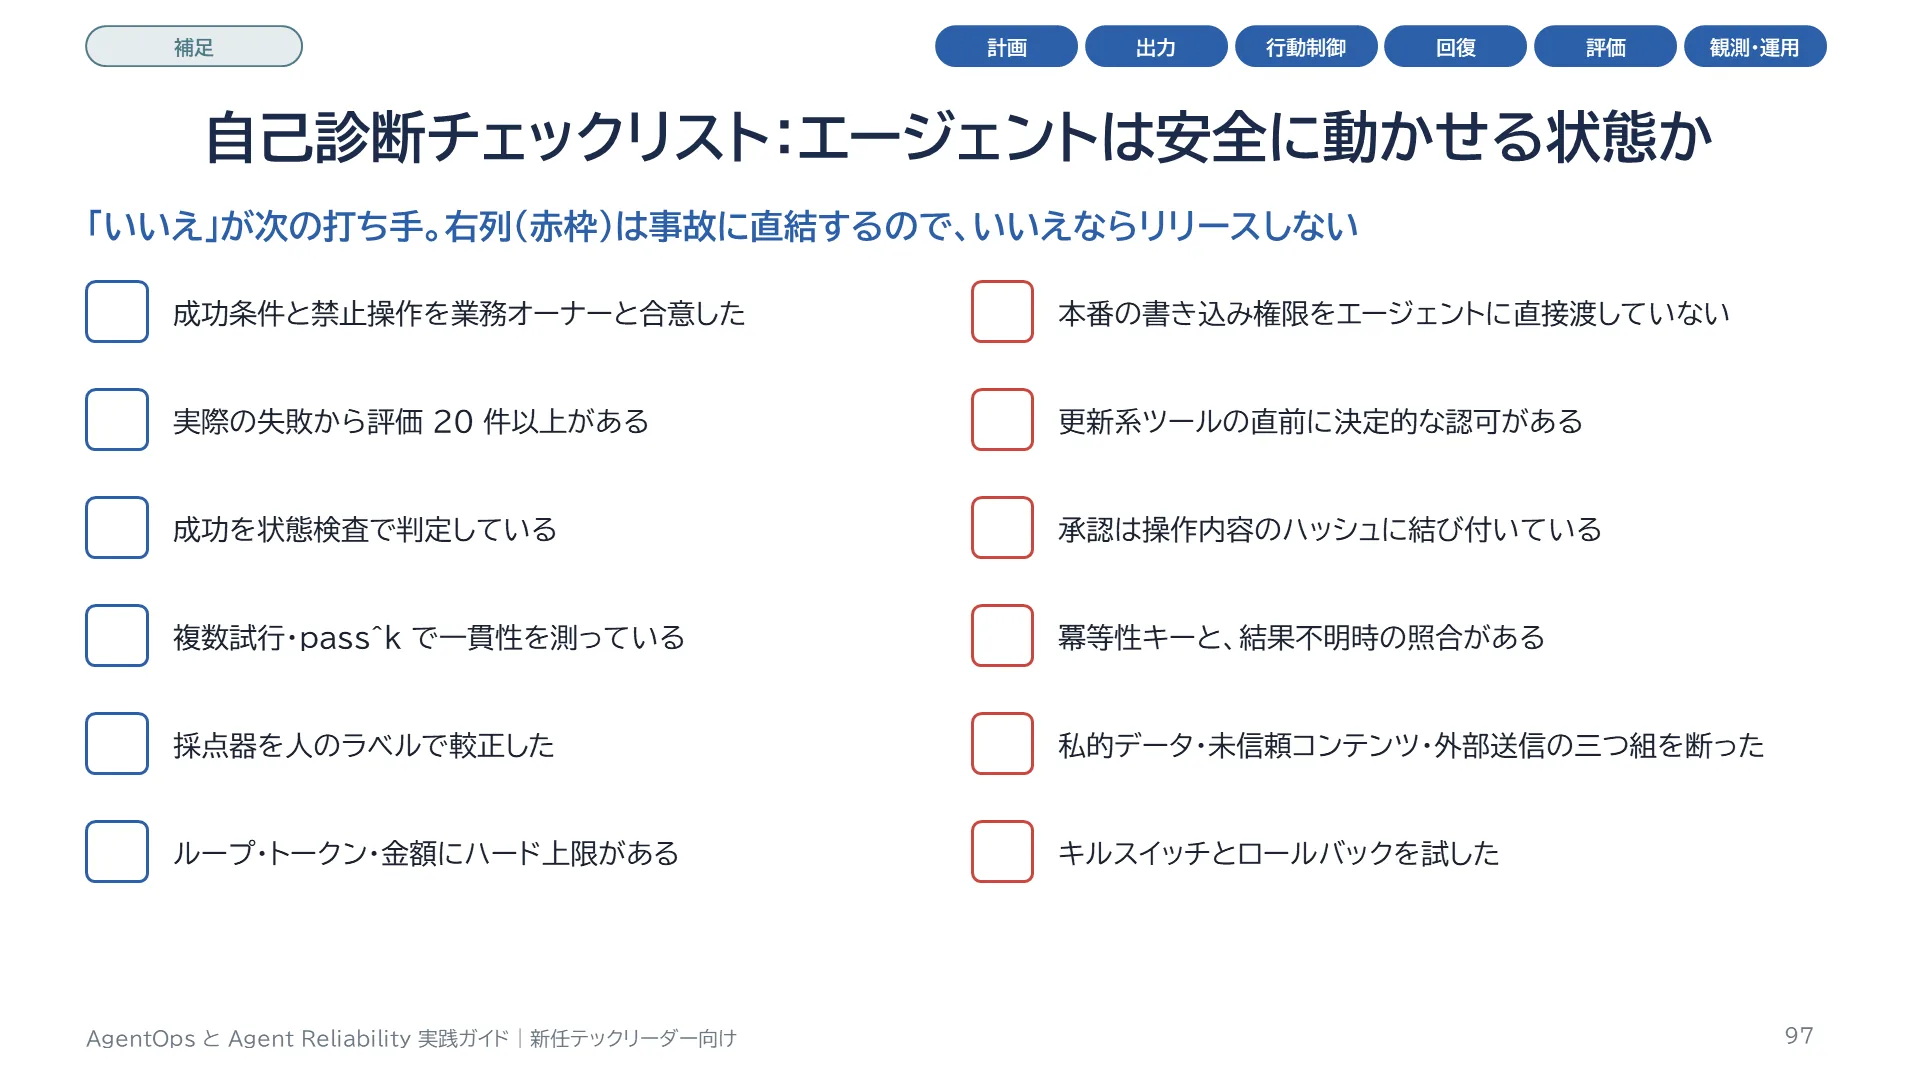
プロジェクトの健康診断に使うチェックリストです。12 項目のうち「いいえ」が付いた項目が、次に手を打つ候補です。特に、本番の書き込み権限をエージェントに直接渡していないか、更新系のツールの直前に決定的な認可があるか、私的データ・未信頼コンテンツ・外部送信の三つ組を断っているかの 3 つは、事故に直結するので最優先で確認します。
スライド 98 のテキストと解説
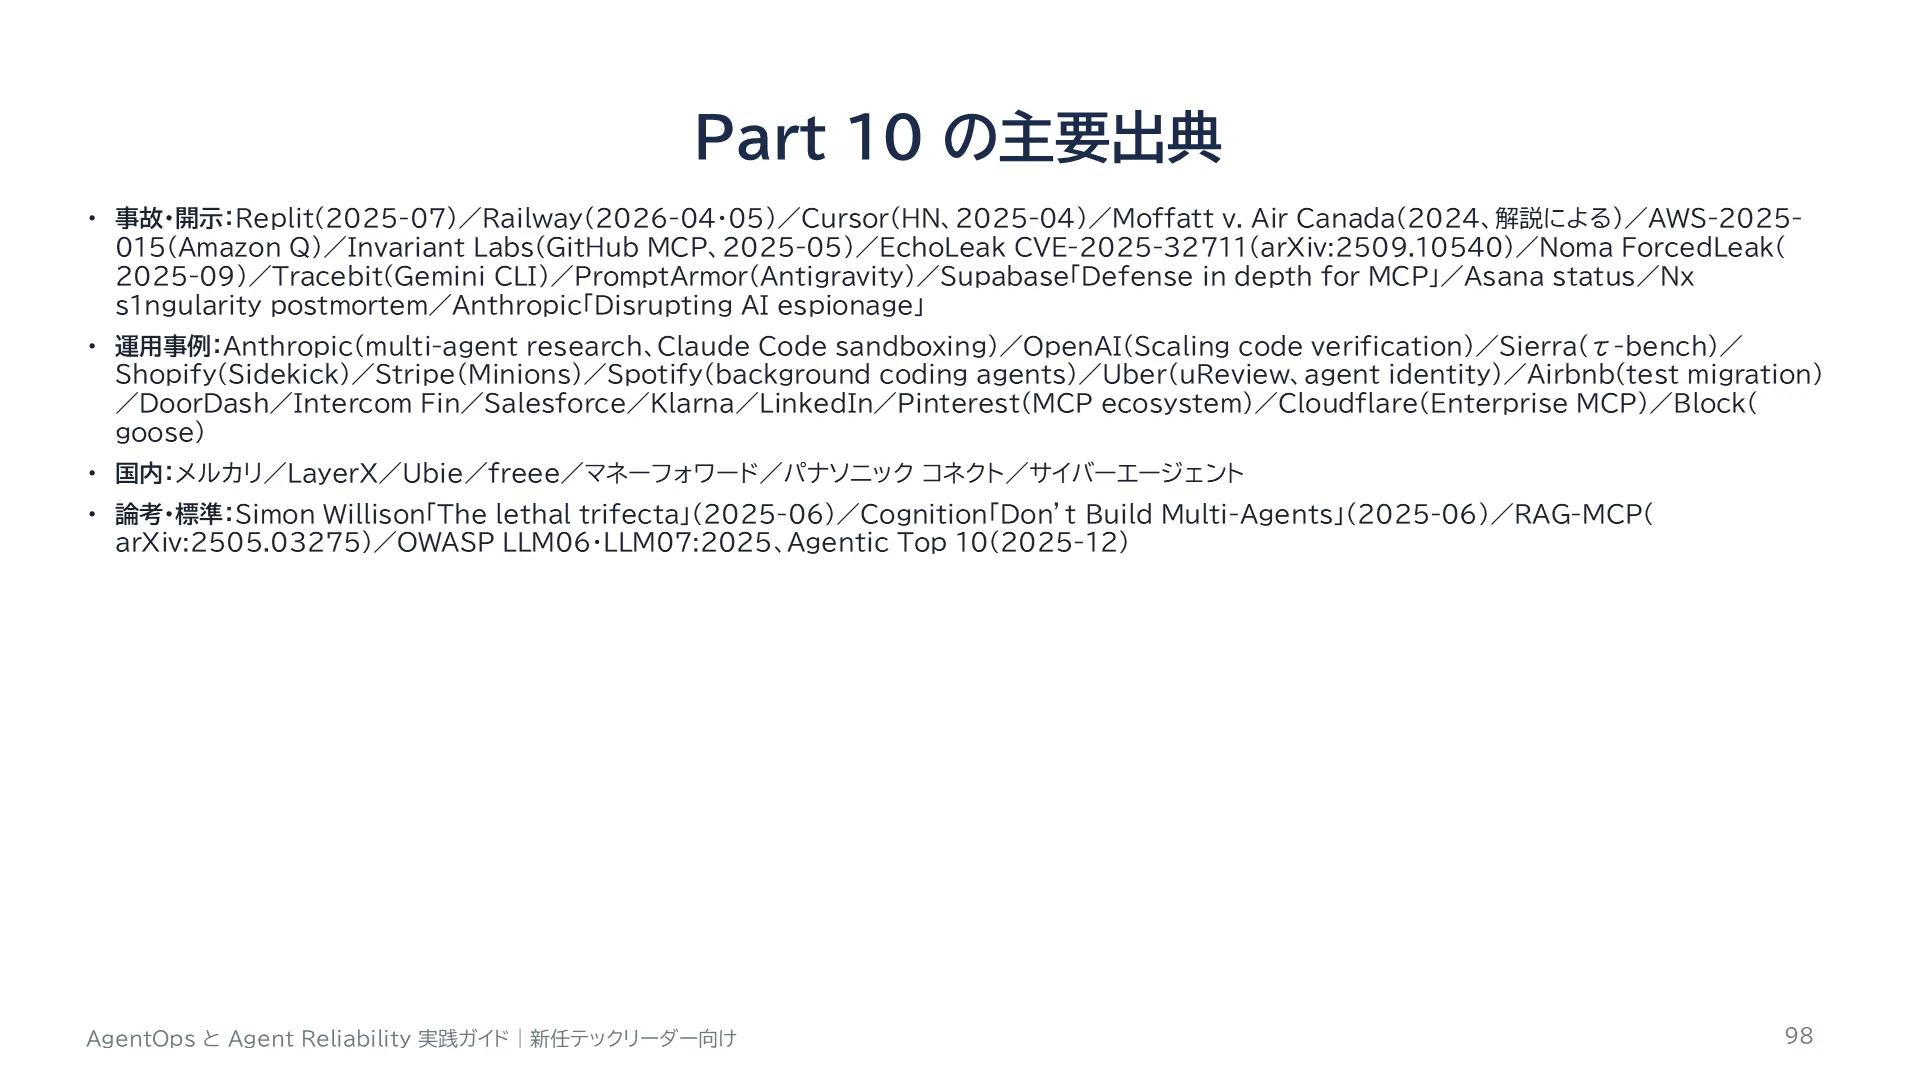
Part 10 で参照した主な資料です。事故は当事者の発表と研究者の開示を優先し、報道のみのものは「参考」としています。運用事例の数値は各社の自己申告です。
スライド 99 のテキストと解説
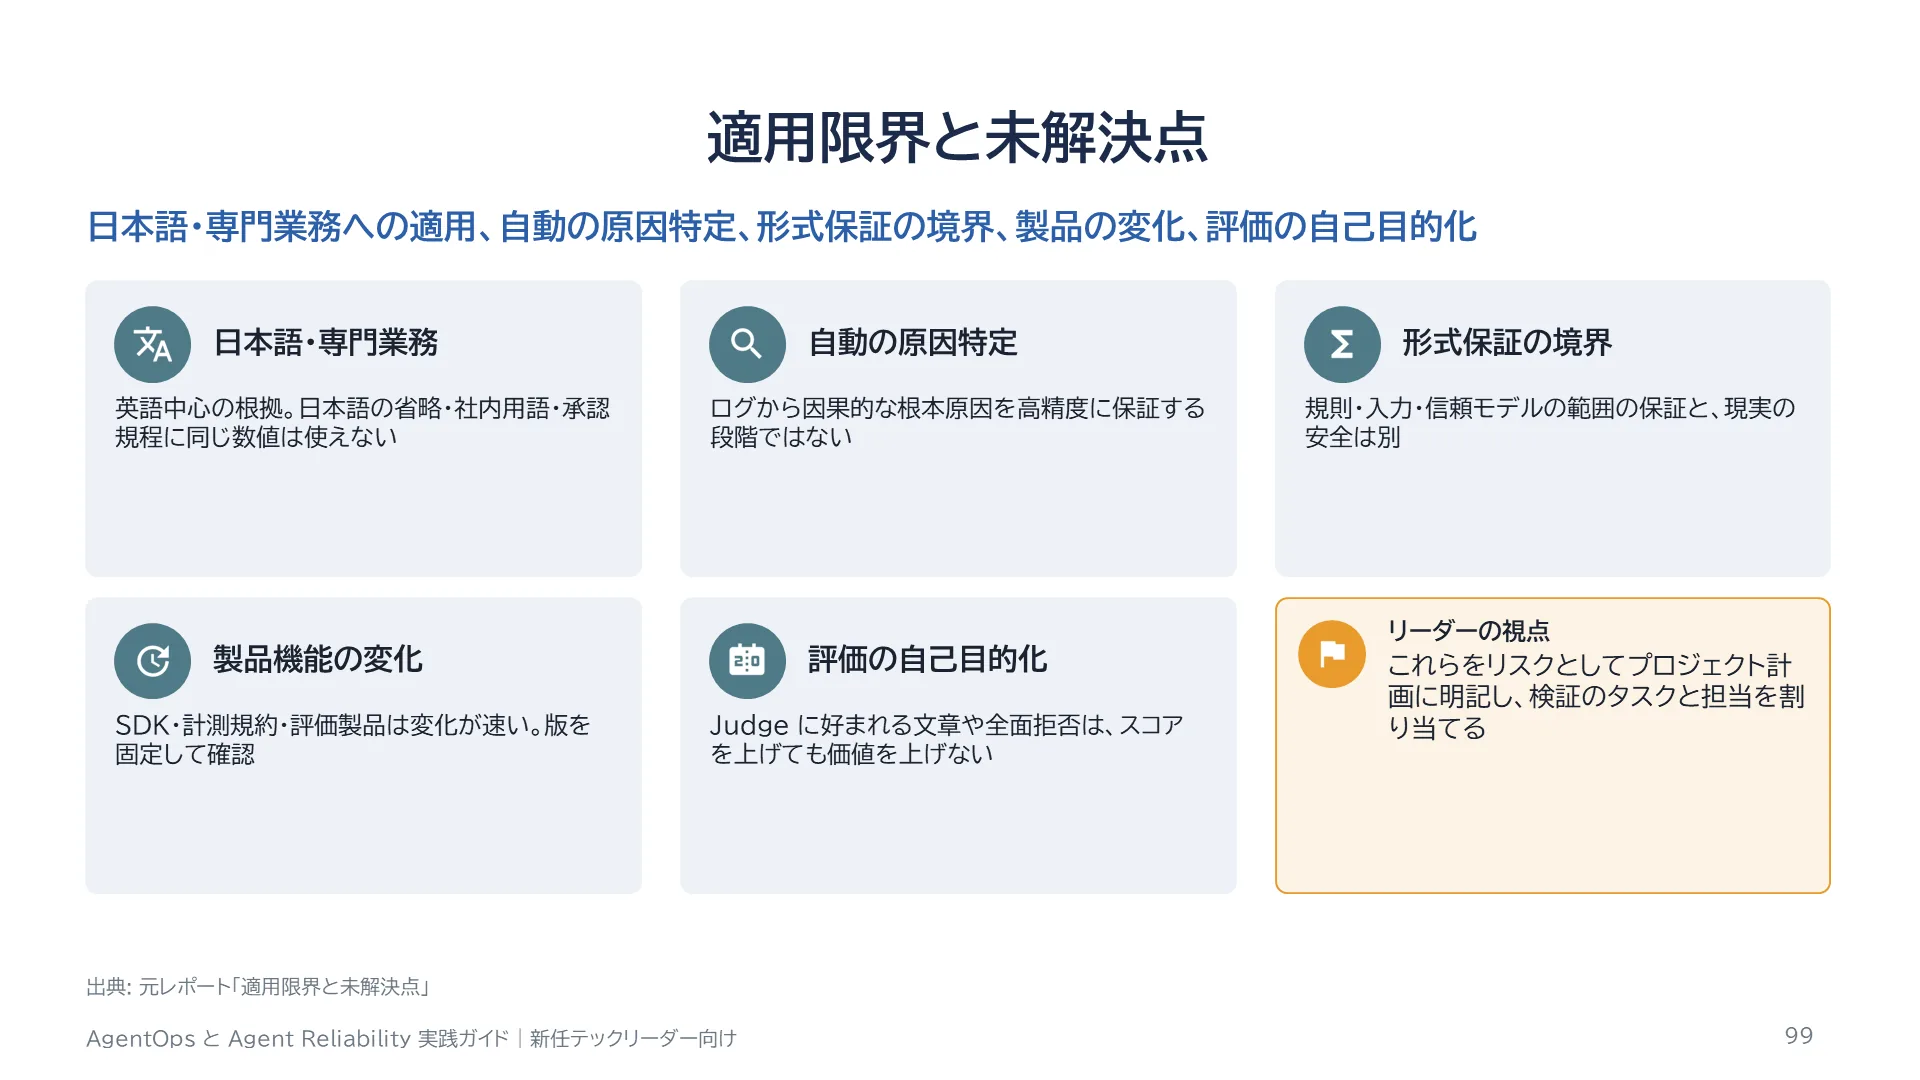
元レポートが挙げる限界と未解決点です。1 つ目、多くの根拠は英語中心のベンチマークや特定の業務で、日本語の省略、社内の用語、承認の規程に、同じ数値は適用できません。2 つ目、ログから因果的な根本原因を高精度に特定する段階にはまだありません。3 つ目、規則・入力・信頼のモデルが正しい範囲の保証と、現実世界全体の安全は違います。4 つ目、エージェントの SDK、計測の規約、評価の製品は変化が速いので、機能名と対応範囲を版で固定して確認します。5 つ目、Judge に好まれる文章、固定の正解への適合、難しい入力の全面的な拒否は、見かけのスコアを上げても業務の価値を上げません。
スライド 100 のテキストと解説
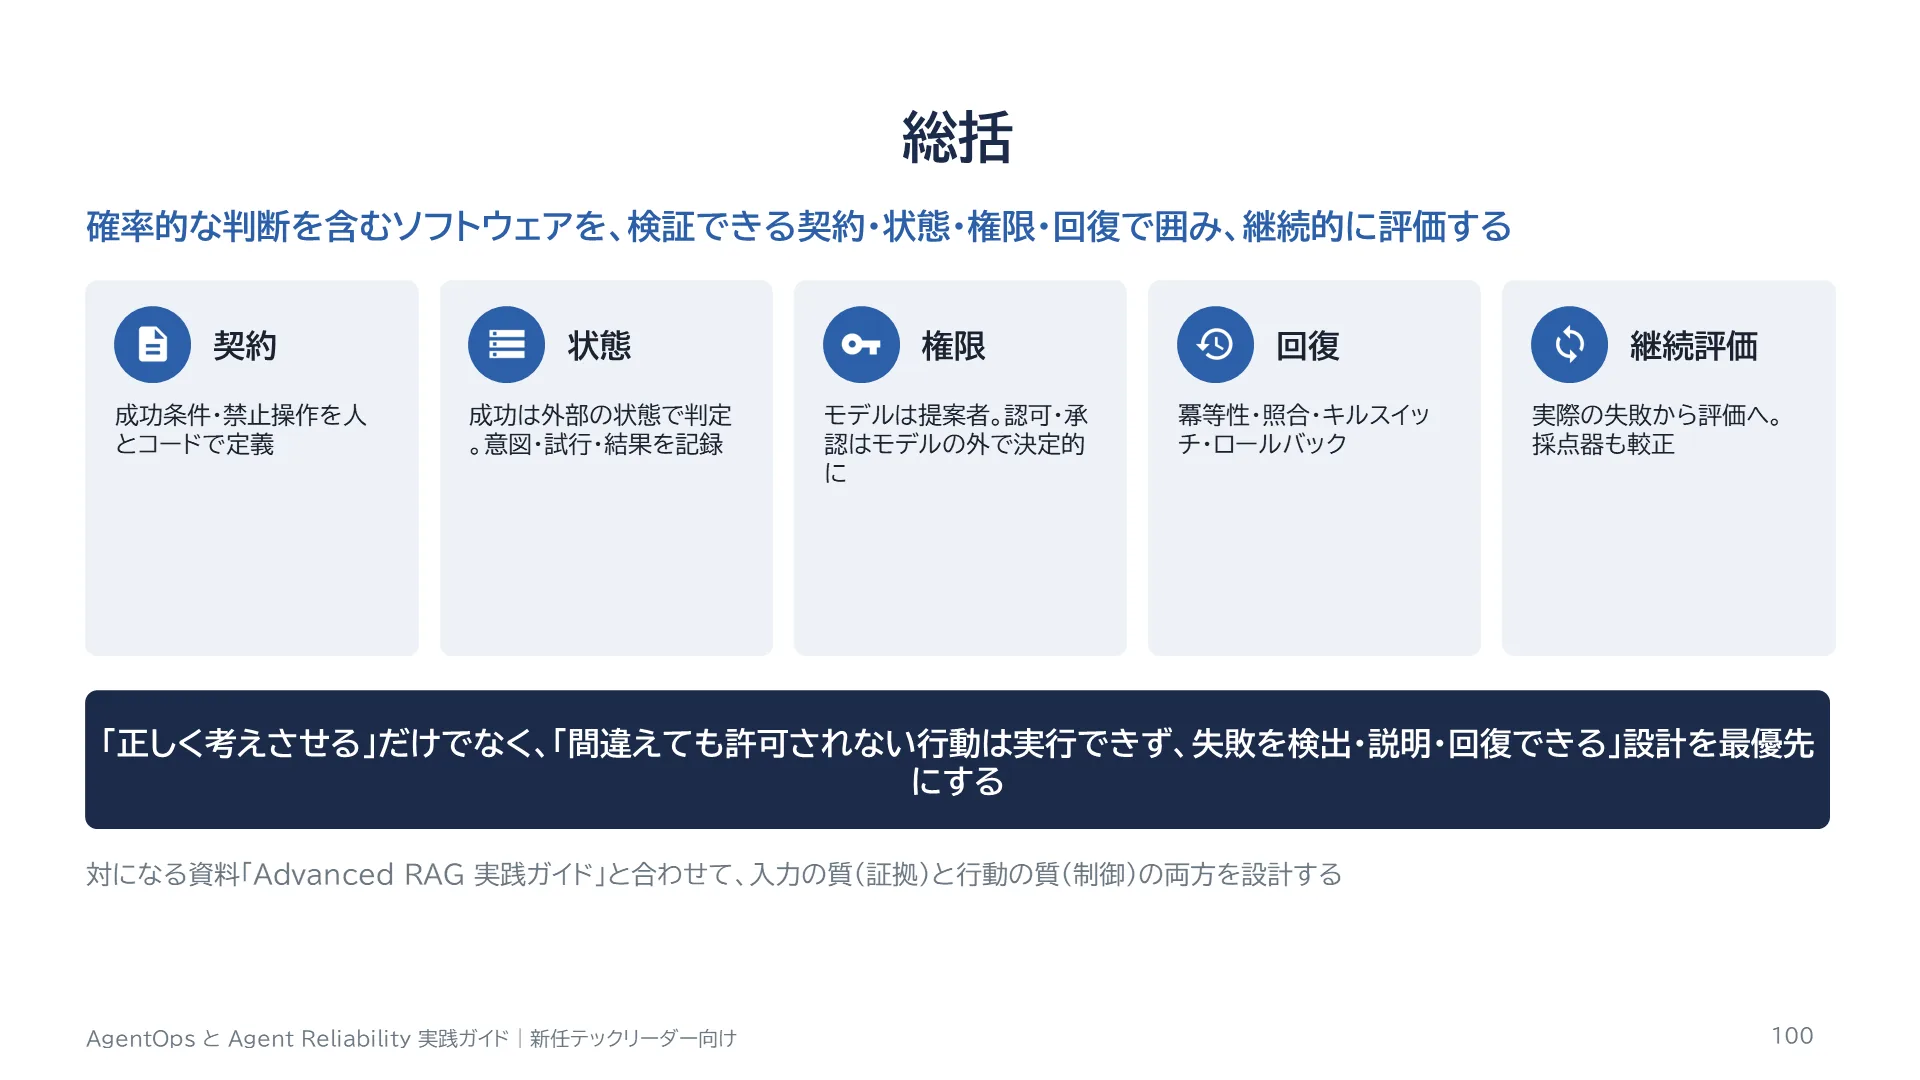
この領域の本質は、RAG の次に別の魔法の技術を足すことではなく、確率的な判断を含むソフトウェアを、検証できる契約、状態、権限、回復の仕組みで囲み、継続的に評価することです。Agent Engineering は全体の設計と改善、AgentOps は評価と運用のサイクル、Harness Engineering は実行の具体的な制御、という分担で考えると整理しやすくなります。最優先すべきなのは、正しく考えるように促すことだけではなく、間違えても許可されない行動は実行できず、失敗を検出し、説明し、回復できる設計です。評価の製品を先に選ぶのではなく、業務の成功条件と危険な副作用を定義し、その境界を実行のコードで守ったうえで、実際のデータの失敗から改善を続けること。これが元レポートの最終的な推奨です。
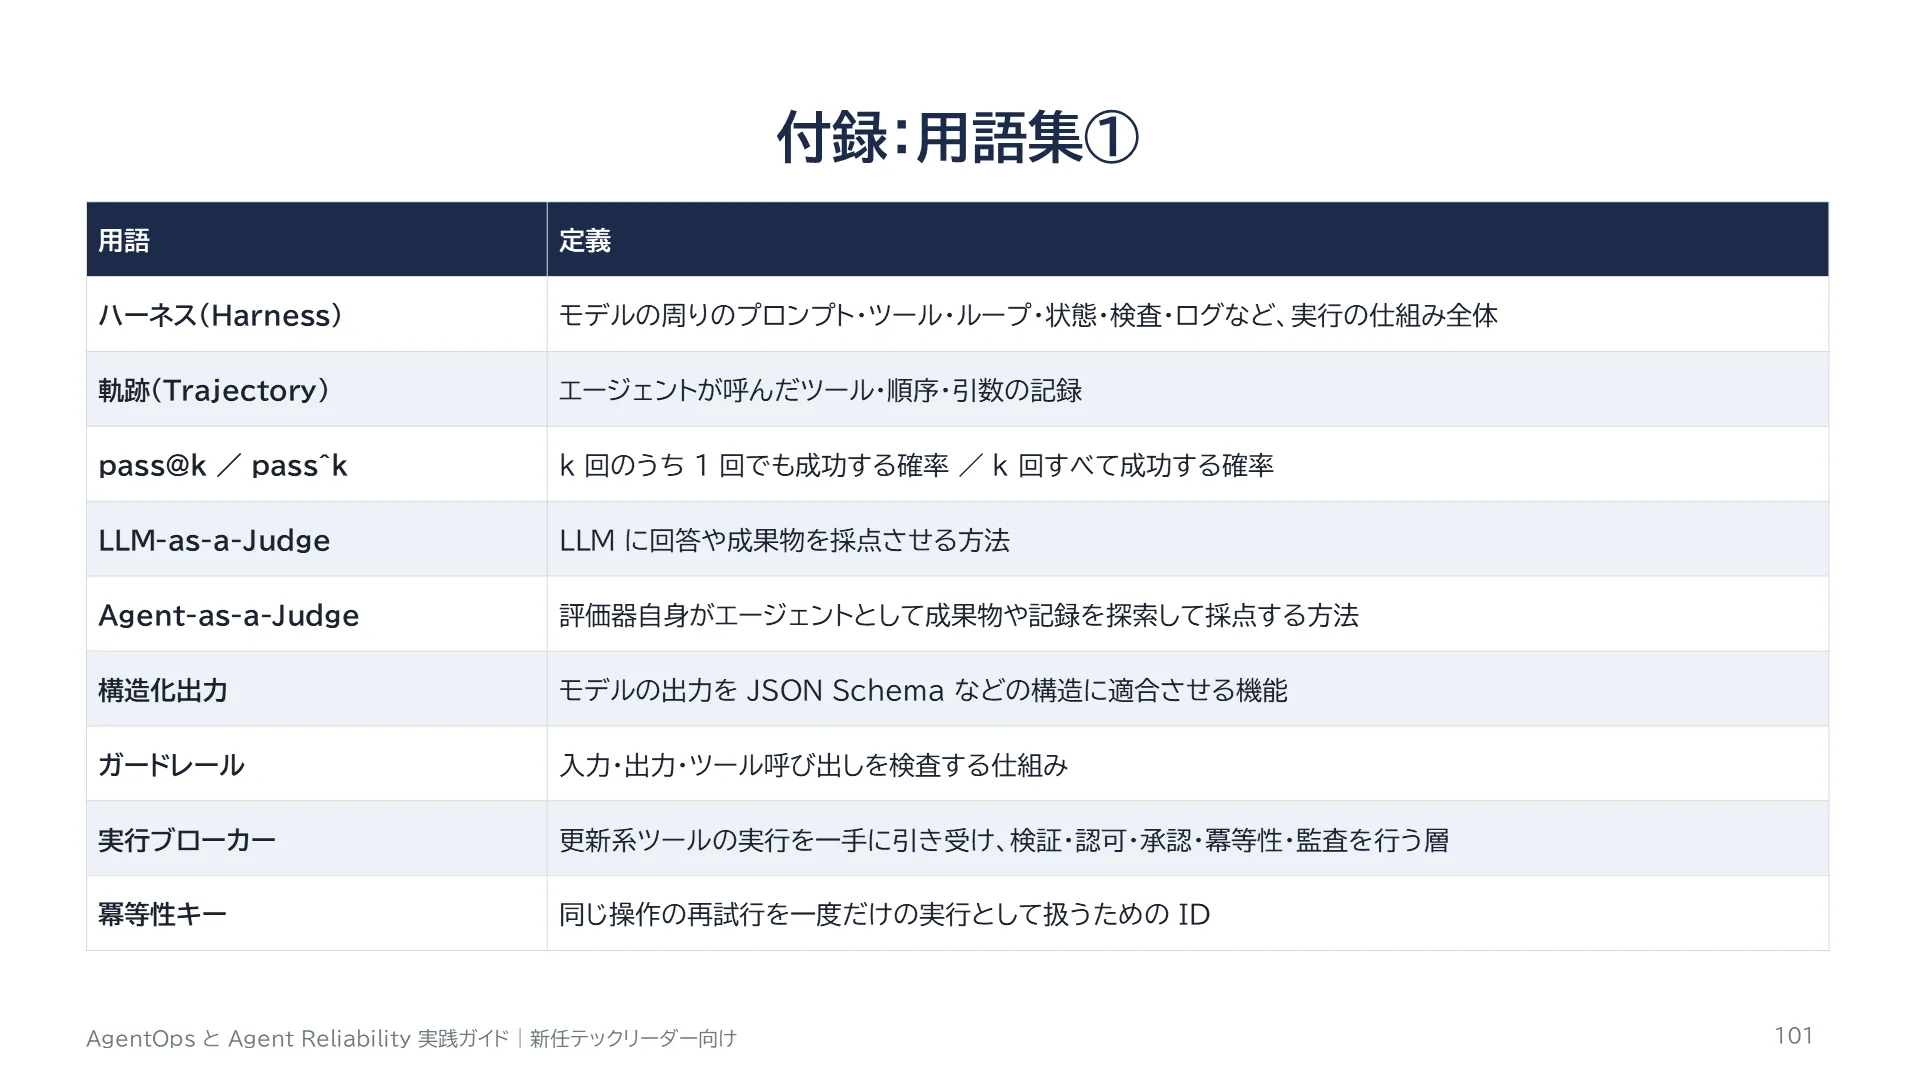
スライド 101 のテキストと解説
本資料で使った主な用語の定義です。
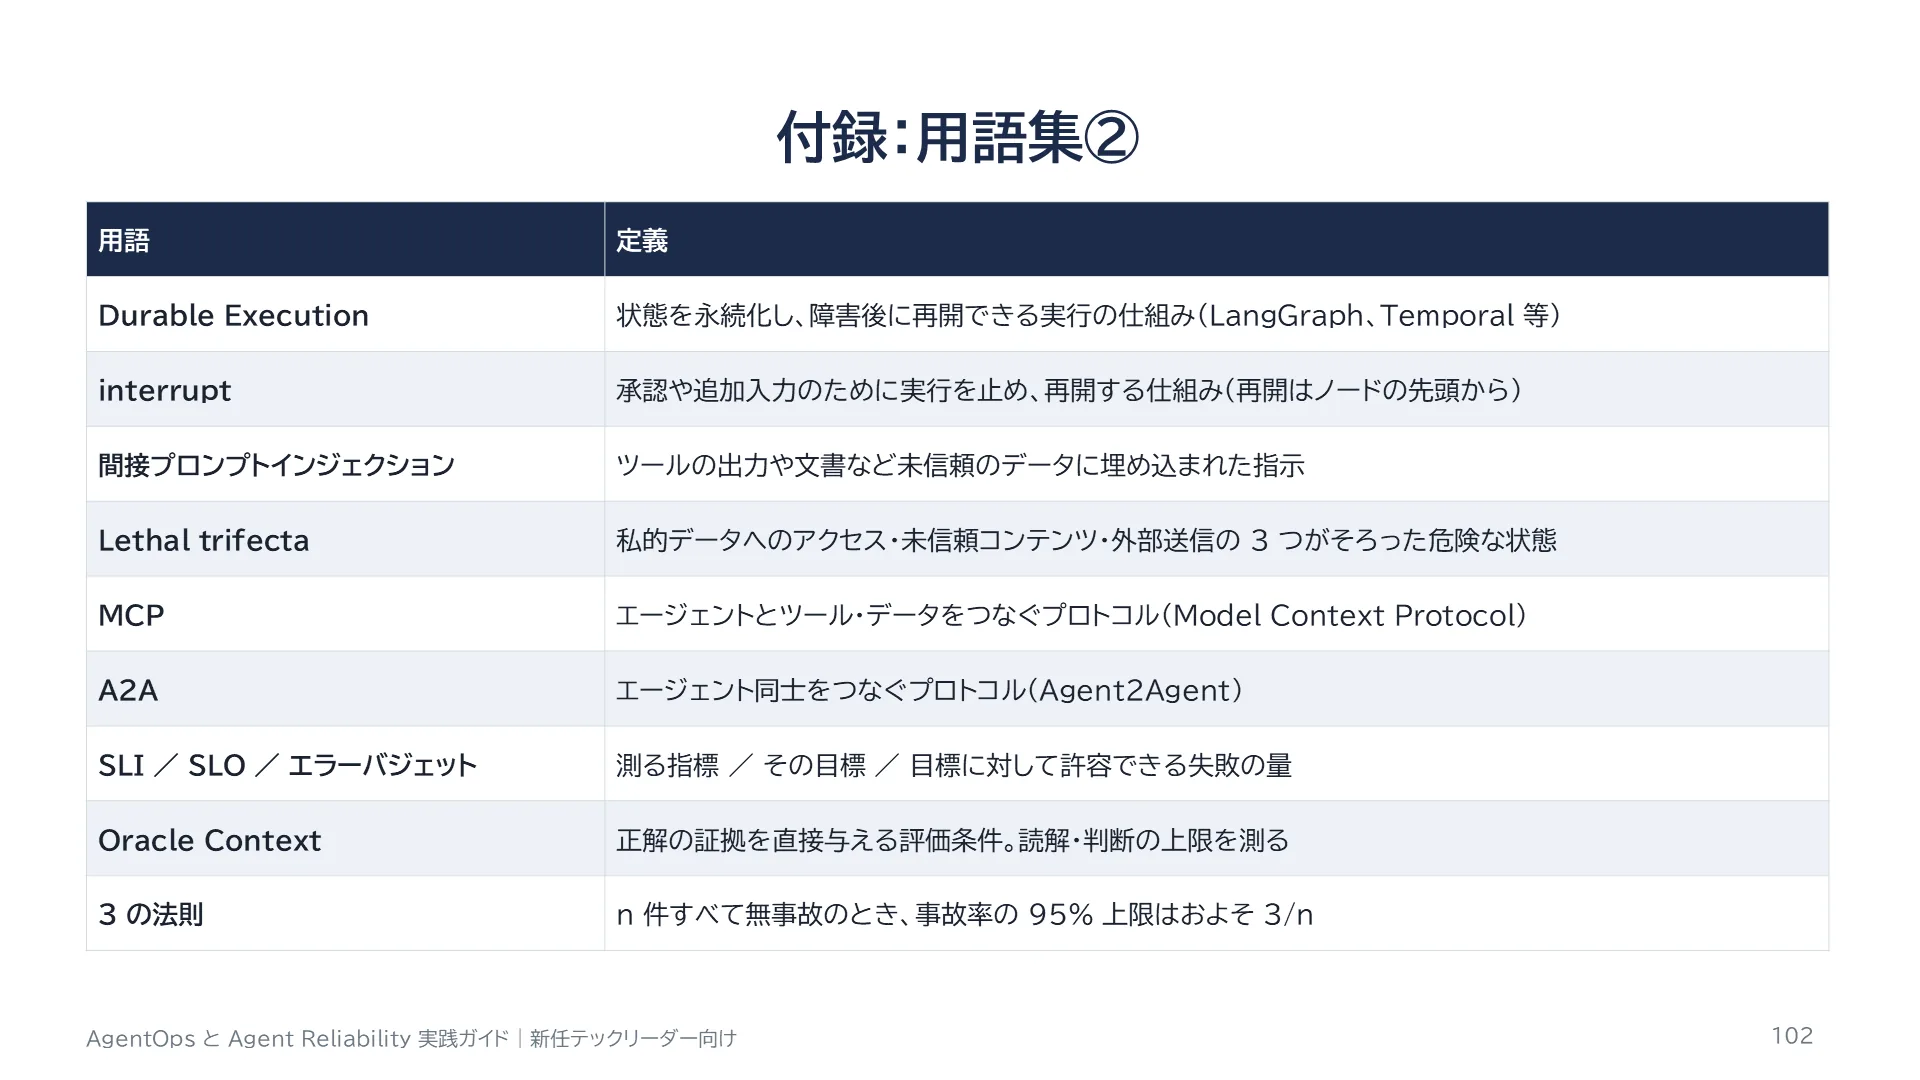
スライド 102 のテキストと解説
用語集の続きです。
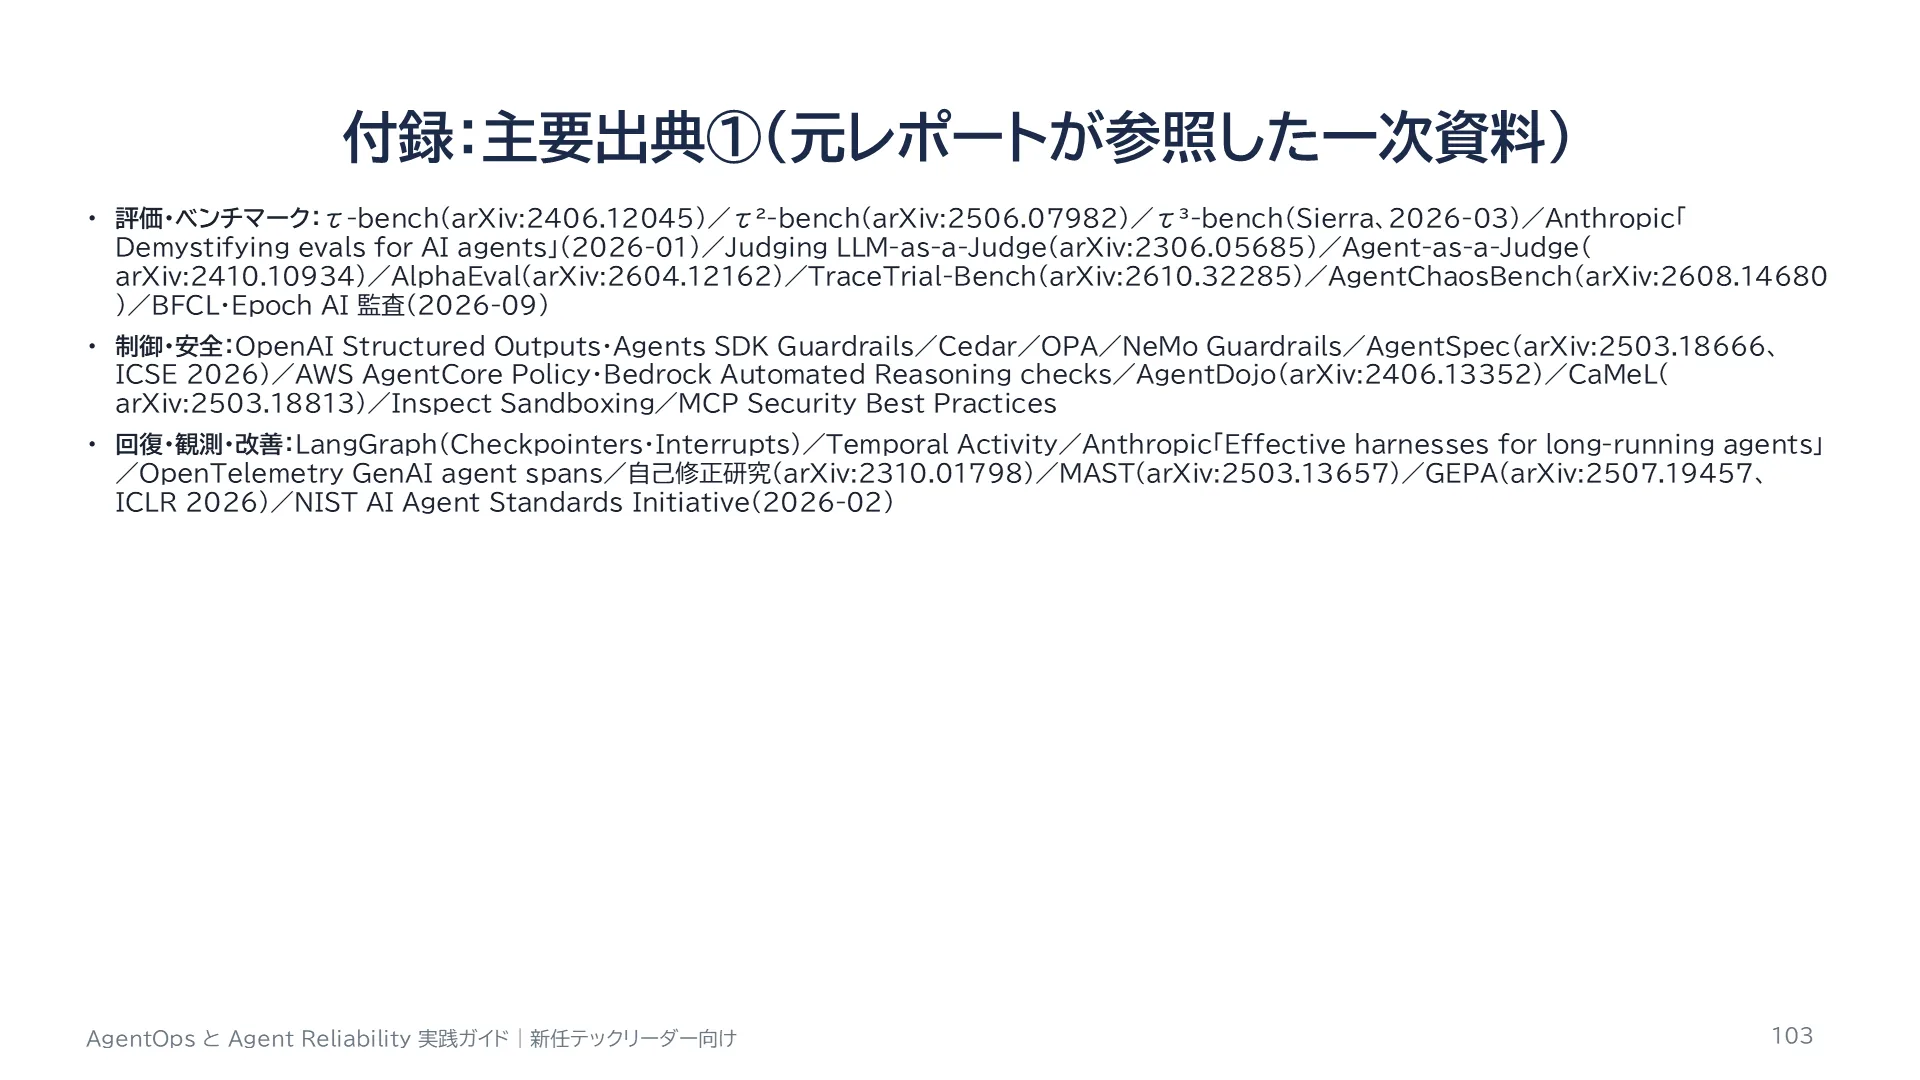
スライド 103 のテキストと解説
元レポートが参照した一次資料のうち、本資料で言及した主なものです。
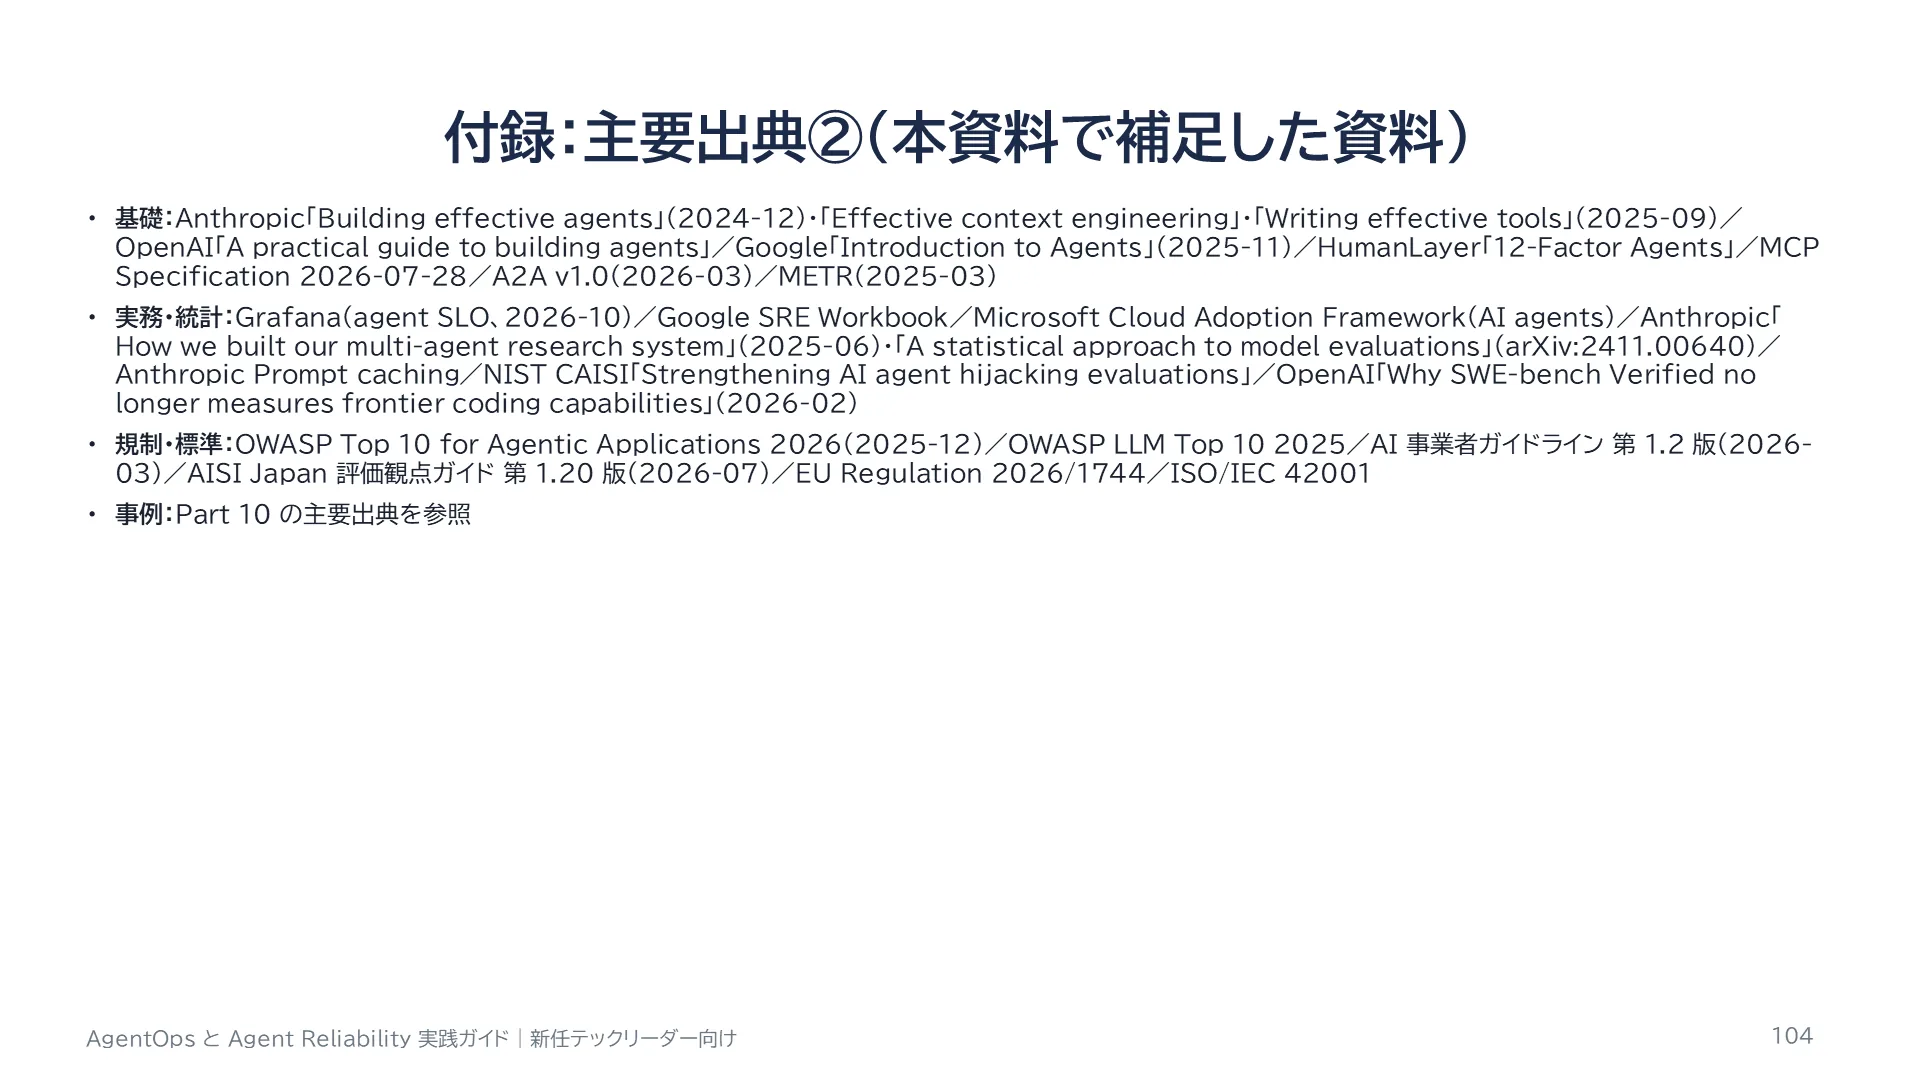
スライド 104 のテキストと解説
本資料で補足として追加した資料です。